
Modele și platforme AI
TensorRT-LLM: Ghid cuprinzător pentru optimizarea inferenței modelului de limbaj mare pentru performanță maximă

 Adaugă Unite.AI la sursele tale preferate pe Google
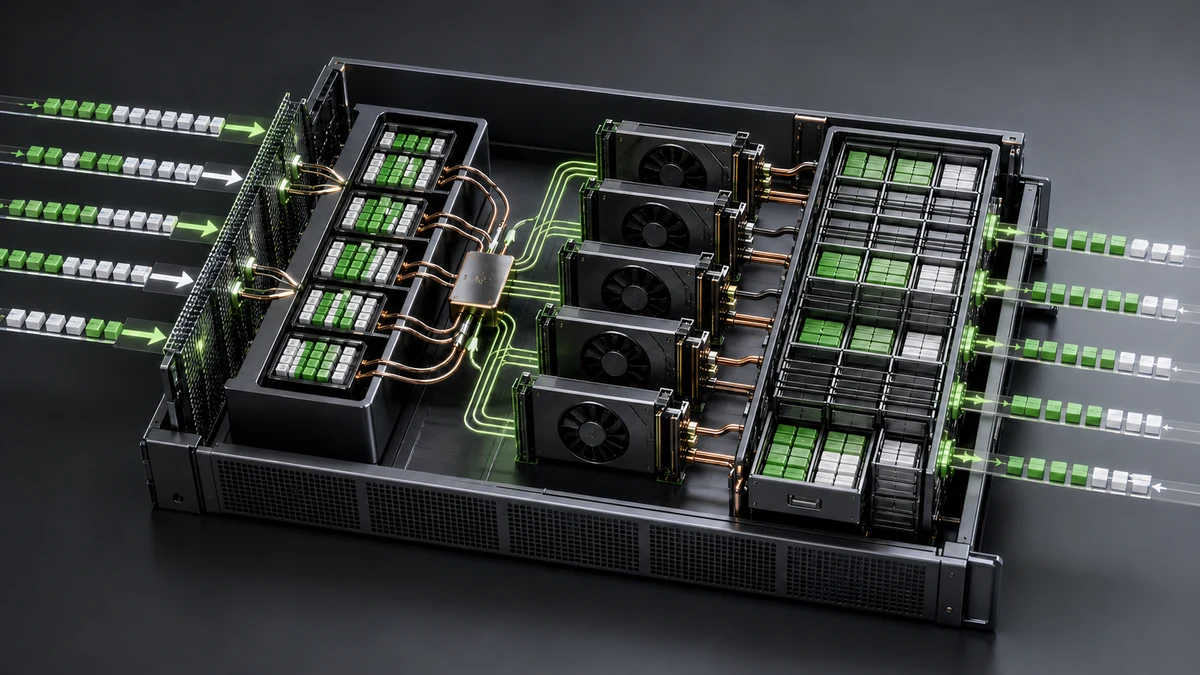
Pe măsură ce cererea de modele de limbaj mare (LLM) continuă să crească, asigurarea inferenței rapide, eficiente și scalabile a devenit mai crucială ca niciodată. NVIDIA’s (NVDA ) TensorRT-LLM vine să abordeze această provocare, oferind un set de instrumente și optimizări puternice, special concepute pentru inferența LLM. TensorRT-LLM oferă o gamă impresionantă de îmbunătățiri ale performanței, cum ar fi cuantificarea, fuziunea kernelului, batch-ul în zbor și suportul multi-GPU. Aceste avansări fac posibilă atingerea unor viteze de inferență de până la 8 ori mai rapide decât metodele tradiționale bazate pe CPU, transformând modul în care implementăm LLM-urile în producție.
Acest ghid cuprinzător va explora toate aspectele TensorRT-LLM, de la arhitectura și caracteristicile sale cheie la exemple practice pentru implementarea modelelor. Indiferent dacă sunteți inginer de inteligență artificială, dezvoltator de software sau cercetător, acest ghid vă va oferi cunoștințele necesare pentru a utiliza TensorRT-LLM pentru optimizarea inferenței LLM pe GPU-urile NVIDIA.
Accelerarea inferenței LLM cu TensorRT-LLM
TensorRT-LLM oferă îmbunătățiri dramatice ale performanței inferenței LLM. Conform testelor NVIDIA, aplicațiile bazate pe TensorRT arată viteze de inferență de până la 8 ori mai rapide în comparație cu platformele bazate exclusiv pe CPU. Acesta este un avans crucial în aplicațiile în timp real, cum ar fi chatbot-urile, sistemele de recomandare și sistemele autonome care necesită răspunsuri rapide.
Cum funcționează
TensorRT-LLM accelerează inferența prin optimizarea rețelelor neuronale în timpul implementării, utilizând tehnici precum:
- Cuantificarea: Reduce precizia greutăților și activărilor, micșorând dimensiunea modelului și îmbunătățind viteza de inferență.
- Fuziunea stratului și a tensorului: Combină operații precum funcțiile de activare și multiplicarea matricelor într-o singură operație.
- Reglarea kernelului: Selectează kernelurile CUDA optime pentru computația pe GPU, reducând timpul de execuție.
Aceste optimizări asigură că modelele dvs. LLM funcționează eficient pe o gamă largă de platforme de implementare, de la centrele de date hyperscale la sistemele înglobate.
Optimizarea performanței inferenței cu TensorRT
Construit pe modelul de programare paralelă CUDA al NVIDIA, TensorRT oferă optimizări foarte specializate pentru inferență pe GPU-urile NVIDIA. Prin optimizarea proceselor precum cuantificarea, reglarea kernelului și fuziunea operațiilor tensoriale, TensorRT asigură că LLM-urile pot rula cu latență minimă.
Unele dintre cele mai eficiente tehnici includ:
- Cuantificarea: Aceasta reduce precizia numerică a parametrilor modelului, îmbunătățind viteza de inferență.
- Fuziunea tensorială: Prin fuziunea mai multor operații într-un singur kernel CUDA, TensorRT minimizează suprasarcina de memorie și crește debitul.
- Reglarea automată a kernelului: TensorRT selectează automat cel mai bun kernel pentru fiecare operație, optimizând inferența pentru un anumit GPU.
Aceste tehnici permit TensorRT-LLM să optimizeze performanța inferenței pentru sarcini de învățare automată, cum ar fi prelucrarea limbajului natural, motoarele de recomandare și analiza video în timp real.
Accelerarea sarcinilor de inteligență artificială cu TensorRT
TensorRT accelerează sarcinile de învățare automată prin încorporarea optimizărilor de precizie, cum ar fi INT8 și FP16. Aceste formate cu precizie redusă permit inferențe semnificativ mai rapide, menținând în același timp acuratețea. Acest lucru este deosebit de valoros în aplicațiile în timp real, unde latența scăzută este o cerință critică.
INT8 și FP16 sunt deosebit de eficiente în:
- Transmisia video: Sarcinile de procesare video bazate pe IA, cum ar fi detectarea obiectelor, beneficiază de aceste optimizări prin reducerea timpului necesar pentru procesarea cadrelor.
- Sisteme de recomandare: Prin accelerarea inferenței pentru modele care procesează cantități mari de date ale utilizatorilor, TensorRT permite personalizarea în timp real la scară.
- Prelucrarea limbajului natural (NLP): TensorRT îmbunătățește viteza sarcinilor NLP, cum ar fi generarea textului, traducerea și rezumarea, făcându-le potrivite pentru aplicații în timp real.
Implementarea, rularea și scalarea cu NVIDIA Triton
Odată ce modelul dvs. a fost optimizat cu TensorRT-LLM, îl puteți implementa, rula și scala cu ușurință, utilizând NVIDIA Triton Inference Server. Triton este un software open-source care susține batch-uri dinamice, ansambluri de modele și un debit ridicat. Oferește un mediu flexibil pentru gestionarea modelelor IA la scară.
Unele dintre caracteristicile sale cheie includ:
- Execuția concurentă a modelelor: Rulați mai multe modele simultan, maximizând utilizarea GPU-ului.
- Batch-uri dinamice: Combinați mai multe cereri de inferență într-un singur batch, reducând latența și creșterea debitului.
- Intrări de audio/video în flux: Susține fluxurile de intrare în timp real, cum ar fi analiza video live sau serviciile de vorbire-la-text.
Acest lucru face ca Triton să fie un instrument valoros pentru implementarea modelelor optimizate TensorRT-LLM în medii de producție, asigurând scalabilitate și eficiență ridicată.
Caracteristici cheie ale TensorRT-LLM pentru inferența LLM
API Python open-source
TensorRT-LLM oferă un API Python foarte modular și open-source, simplificând procesul de definire, optimizare și executare a LLM-urilor. API-ul permite dezvoltatorilor să creeze LLM-uri personalizate sau să modifice cele preconstruite, fără a necesita cunoștințe aprofundate despre CUDA sau cadre de învățare automată.
Batch-ul în zbor și atenția paginată
Una dintre caracteristicile deosebite ale TensorRT-LLM este batch-ul în zbor, care optimizează generarea textului prin procesarea mai multor cereri simultan. Această caracteristică minimizează timpul de așteptare și îmbunătățește utilizarea GPU-ului, prin batch-uri dinamice de secvențe.
În plus, atenția paginată asigură că utilizarea memoriei rămâne scăzută, chiar și atunci când se procesează secvențe de intrare lungi. În loc de a aloca memorie contiguă pentru toți tokenii, atenția paginată împarte memoria în “pagini” care pot fi reutilizate dinamic, prevenind fragmentarea memoriei și îmbunătățind eficiența.
Inferența multi-GPU și multi-nod
Pentru modele mai mari sau sarcini de lucru mai complexe, TensorRT-LLM susține infernța multi-GPU și multi-nod. Această capacitate permite distribuirea calculului modelului pe mai multe GPU-uri sau noduri, îmbunătățind debitul și reducând timpul total de inferență.
Suport FP8
Cu apariția FP8 (punct plutitor cu 8 biți), TensorRT-LLM utilizează GPU-urile H100 ale NVIDIA pentru a converti greutățile modelului în acest format pentru inferență optimizată. FP8 permite o reducere a consumului de memorie și o calculare mai rapidă, fiind deosebit de utilă în implementări la scară largă.
Arhitectura și componente ale TensorRT-LLM
Înțelegerea arhitecturii TensorRT-LLM vă va ajuta să utilizați mai bine capacitățile sale pentru inferența LLM. Să descompunem componentele sale cheie:
Definirea modelului
TensorRT-LLM vă permite să definiți LLM-uri utilizând un API Python simplu. API-ul construiește o reprezentare grafică a modelului, facilitând gestionarea straturilor complexe implicate în arhitecturile LLM, cum ar fi GPT sau BERT.
Legarea greutăților
Înainte de a compila modelul, greutățile (sau parametrii) trebuie legate de rețea. Acest pas asigură că greutățile sunt încorporate în motorul TensorRT, permițând o inferență rapidă și eficientă. TensorRT-LLM permite, de asemenea, actualizarea greutăților după compilare, adăugând flexibilitate pentru modelele care necesită actualizări frecvente.
Asocierea șablonului și fuziunea
Fuziunea operațiunilor este o altă caracteristică puternică a TensorRT-LLM. Prin fuziunea mai multor operații (de exemplu, multiplicări matriciale cu funcții de activare) într-un singur kernel CUDA, TensorRT minimizează suprasarcina asociată cu lansarea mai multor kerneluri. Acest lucru reduce transferurile de memorie și accelerează inferența.
Module suplimentare
Pentru a extinde capacitățile TensorRT, dezvoltatorii pot crea module suplimentare – kerneluri personalizate care efectuează operații specifice, cum ar fi optimizarea blocurilor de atenție multi-cap. De exemplu, modulul Flash-Attention îmbunătățește semnificativ performanța straturilor de atenție din modelele bazate pe Transformer.
Benchmark-uri: câștiguri de performanță ale TensorRT-LLM
TensorRT-LLM demonstrează câștiguri semnificative de performanță pentru inferența LLM pe diverse GPU-uri NVIDIA. Iată o comparație a vitezei de inferență (măsurată în tokeni pe secundă) utilizând TensorRT-LLM pe diferite GPU-uri NVIDIA:
| Model | Precizie | Lungime intrare/ieșire | H100 (80GB) | A100 (80GB) | L40S FP8 |
|---|---|---|---|---|---|
| GPTJ 6B | FP8 | 128/128 | 34,955 | 11,206 | 6,998 |
| GPTJ 6B | FP8 | 2048/128 | 2,800 | 1,354 | 747 |
| LLaMA v2 7B | FP8 | 128/128 | 16,985 | 10,725 | 6,121 |
| LLaMA v3 8B | FP8 | 128/128 | 16,708 | 12,085 | 8,273 |
Aceste benchmark-uri arată că TensorRT-LLM oferă îmbunătățiri substanțiale ale performanței, în special pentru secvențe mai lungi.
Îndrumar practic: Instalarea și construirea TensorRT-LLM
Pașul 1: Crearea unui mediu de container
Pentru a facilita utilizarea, TensorRT-LLM oferă imagini Docker pentru a crea un mediu controlat pentru construirea și rularea modelelor.
docker build --pull \
--target devel \
--file docker/Dockerfile.multi \
--tag tensorrt_llm/devel:latest .
docker run --rm -it \
--ipc=host --ulimit memlock=-1 --ulimit stack=67108864 --gpus=all \
--volume ${PWD}:/code/tensorrt_llm \
--workdir /code/tensorrt_llm \
tensorrt_llm/devel:latest
Pașul 3: Construirea TensorRT-LLM din sursă
În interiorul containerului, compilați TensorRT-LLM cu următoarea comandă:
python3 ./scripts/build_wheel.py --trt_root /usr/local/tensorrt
pip install ./build/tensorrt_llm*.whl
Pașul 4: Legarea runtime-ului C++ TensorRT-LLM
Atunci când integrați TensorRT-LLM în proiectele dvs. C++, asigurați-vă că calea de includere a proiectului dvs. indică spre directorul cpp/include. Acesta conține header-urile API-ului stabil și suportat. Bibliotecile TensorRT-LLM sunt legate ca parte a procesului de compilare C++.
De exemplu, configurația CMake a proiectului dvs. ar putea include:
include_directories(${TENSORRT_LLM_PATH}/cpp/include)
link_directories(${TENSORRT_LLM_PATH}/cpp/build/tensorrt_llm)
target_link_libraries(your_project tensorrt_llm)
Această integrare vă permite să profitați de optimizările TensorRT-LLM în proiectele dvs. C++ personalizate, asigurând inferență eficientă chiar și în medii de nivel scăzut sau de înaltă performanță.
Caracteristici avansate ale TensorRT-LLM
TensorRT-LLM este mai mult decât o bibliotecă de optimizare; include mai multe caracteristici avansate care ajută la implementarea LLM-urilor la scară largă. Mai jos, explorăm unele dintre aceste caracteristici în detaliu:
1. Batch-ul în zbor
Batch-ul tradițional implică așteptarea până când un batch este complet colectat înainte de a fi procesat, ceea ce poate cauza întârzieri. Batch-ul în zbor schimbă acest lucru, începând inferența dinamic pe cererile completate dintr-un batch, în timp ce se colectează și alte cereri. Această caracteristică îmbunătățește debitul general prin minimizarea timpului de așteptare și îmbunătățirea utilizării GPU-ului.
Această caracteristică este deosebit de valoroasă în aplicațiile în timp real, cum ar fi chatbot-urile sau asistenții vocali, unde timpul de răspuns este critic.
2. Atenția paginată
Atenția paginată este o tehnică de optimizare a memoriei pentru gestionarea secvențelor de intrare lungi. În loc de a necesita memorie contiguă pentru toți tokenii dintr-o secvență (ceea ce poate duce la fragmentarea memoriei), atenția paginată permite modelului să împartă datele cheie și valorile cache în “pagini” de memorie. Aceste pagini sunt alocate și eliberate dinamic, optimizând utilizarea memoriei.
Atenția paginată este critică pentru gestionarea lungimilor de secvență mari și reducerea suprasarcinii de memorie, în special în modele generative cum ar fi GPT și LLaMA.
3. Module suplimentare personalizate
TensorRT-LLM vă permite să extindeți funcționalitatea sa cu module suplimentare personalizate. Modulele suplimentare sunt kerneluri definite de utilizator care permit anumite optimizări sau operații care nu sunt acoperite de biblioteca standard TensorRT.
De exemplu, modulul Flash-Attention este un kernel personalizat bine cunoscut care optimizează straturile de atenție multi-cap din modelele bazate pe Transformer. Prin utilizarea acestui modul, dezvoltatorii pot obține accelerări substanțiale ale calculelor de atenție – una dintre componentele cele mai solicitante de resurse ale LLM-urilor.
Pentru a integra un modul suplimentar personalizat în modelul dvs. TensorRT-LLM, puteți scrie un kernel CUDA personalizat și înregistra-l cu TensorRT. Modulul va fi invocat în timpul executării modelului, oferind îmbunătățiri personalizate ale performanței.
4. Precizia FP8 pe NVIDIA H100
Cu precizia FP8, TensorRT-LLM utilizează inovațiile de ultimă generație ale NVIDIA în arhitectura H100 Hopper. FP8 reduce amprenta de memorie a LLM-urilor prin stocarea greutăților și activărilor într-un format de punct plutitor cu 8 biți, rezultând calcule mai rapide fără a sacrifica prea multă acuratețe. TensorRT-LLM compilează automat modelele pentru a utiliza kerneluri FP8 optimizate, accelerând și mai mult timpii de inferență.
Acest lucru face ca TensorRT-LLM să fie o alegere ideală pentru implementări la scară largă care necesită performanță de top și eficiență energetică.
Exemplu: Implementarea TensorRT-LLM cu Triton Inference Server
Pentru implementări de producție, Triton Inference Server al NVIDIA oferă o platformă robustă pentru gestionarea modelelor la scară. În acest exemplu, vom demonstra cum să implementați un model optimizat TensorRT-LLM utilizând Triton.
Pașul 1: Configurarea depozitului de modele
Creați un depozit de modele pentru Triton, care va stoca fișierele modelului TensorRT-LLM. De exemplu, dacă ați compilat un model GPT2, structura dvs. de directoare ar putea arăta astfel:
mkdir -p model_repository/gpt2/1
cp ./trt_engine/gpt2_fp16.engine model_repository/gpt2/1/
Pașul 2: Crearea fișierului de configurare Triton
În același director model_repository/gpt2/, creați un fișier de configurare numit config.pbtxt care informează Triton cum să încarce și să ruleze modelul. Iată o configurare de bază pentru TensorRT-LLM:
name: "gpt2"
platform: "tensorrt_llm"
max_batch_size: 8

<p>input [
{
name: "input_ids"
data_type: TYPE_INT32
dims: [-1]
}
]</p>

<p>output [
{
name: "logits"
data_type: TYPE_FP32
dims: [-1, -1]
}
]</p>
Pașul 3: Lansarea serverului Triton
Utilizați următoarea comandă Docker pentru a lansa Triton cu depozitul de modele:
docker run --rm --gpus all \
-v $(pwd)/model_repository:/models \
nvcr.io/nvidia/tritonserver:23.05-py3 \
tritonserver --model-repository=/models
Pașul 4: Trimiterea cererilor de inferență către Triton
Odată ce serverul Triton rulează, puteți trimite cereri de inferență către acesta utilizând HTTP sau gRPC. De exemplu, utilizând curl pentru a trimite o cerere:
curl -X POST http://localhost:8000/v2/models/gpt2/infer -d '{
"inputs": [
{"name": "input_ids", "shape": [1, 128], "datatype": "INT32", "data": [[101, 234, 1243]]}
]
}'
Triton va procesa cererea utilizând motorul TensorRT-LLM și va returna logit-urile ca ieșire.
Practici recomandate pentru optimizarea inferenței LLM cu TensorRT-LLM
Pentru a valorifica pe deplin puterea TensorRT-LLM, este important să urmați practicile recomandate atât în timpul optimizării modelului, cât și în timpul implementării. Iată câteva sfaturi cheie:
1. Profilarea modelului înainte de optimizare
Înainte de a aplica optimizări precum cuantificarea sau fuziunea kernelului, utilizați instrumentele de profilare NVIDIA (cum ar fi Nsight Systems sau Profilerul TensorRT) pentru a înțelege blocajele actuale din execuția modelului. Acest lucru vă permite să vizați zonele specifice pentru îmbunătățire, conducând la optimizări mai eficiente.
2. Utilizarea preciziei mixte pentru performanță optimă
Atunci când optimizați modele cu TensorRT-LLM, utilizarea preciziei mixte (o combinație de FP16 și FP32) oferă o accelerare semnificativă a vitezei fără o pierdere majoră de acuratețe. Pentru cel mai bun echilibru între viteză și acuratețe, luați în considerare utilizarea FP8 acolo unde este disponibil, în special pe GPU-urile H100.
3. Utilizarea atenției paginate pentru secvențe lungi
Pentru sarcini care implică secvențe de intrare lungi, cum ar fi rezumarea documentelor sau conversațiile multi-turn, activați întotdeauna atenția paginată pentru a optimiza utilizarea memoriei. Acest lucru reduce suprasarcina de memorie și preveniți erorile de memorie insuficientă în timpul inferenței.
4. Reglarea paralelismului pentru configurații multi-GPU
Atunci când implementați LLM-uri pe mai multe GPU-uri sau noduri, este esențial să reglați setările pentru paralelismul tensorial și paralelismul pipeline pentru a se potrivi cu încărcătura dvs. specifică de lucru. Configurarea corespunzătoare a acestor moduri poate conduce la îmbunătățiri semnificative ale performanței, distribuind sarcina de calcul uniform pe GPU-uri.
Concluzie
TensorRT-LLM reprezintă o schimbare de paradigmă în optimizarea și implementarea modelului de limbaj mare. Cu caracteristici avansate precum cuantificarea, fuziunea operațiunilor, precizia FP8 și suportul multi-GPU, TensorRT-LLM permite LLM-urilor să ruleze mai rapid și mai eficient pe GPU-urile NVIDIA. Indiferent dacă lucrați la aplicații de chat în timp real, sisteme de recomandare sau modele de limbaj la scară largă, TensorRT-LLM oferă instrumentele necesare pentru a depăși limitele performanței.
Acest ghid vă a condus prin configurarea TensorRT-LLM, optimizarea modelelor cu API-ul său Python, implementarea pe serverul de inferență Triton și aplicarea practicilor recomandate pentru inferență eficientă. Cu TensorRT-LLM, puteți accelera sarcinile dvs. de inteligență artificială, reduceți latența și livrați soluții LLM scalabile în medii de producție.
Pentru informații suplimentare, consultați documentația oficială TensorRT-LLM și documentația serverului de inferență Triton.



