
Cele mai bune
Cei mai buni 10 algoritmi de învățare automată

 Adaugă Unite.AI la sursele tale preferate pe Google
Puncte cheieTransformatoarele au revoluționat NLP prin permiterea procesării paralele și a memoriei…
Vezi mai mult
- Transformatoarele au revoluționat NLP prin permiterea procesării paralele și a memoriei persistente, spre deosebire de RNN-uri.
- GAN-urile forțează generatoarele să exploreze soluții diverse prin reținerea feedback-ului de eroare al discriminatorului.
- K-Cei mai apropiați vecini din 1951 încă depășește algoritmii moderni în predicția fluctuației angajaților.
Deși trăim într-o perioadă de inovație extraordinară în învățarea automată accelerată de GPU, cele mai recente lucrări de cercetare prezintă frecvent, și în mod proeminent, algoritmi vechi de decenii, în unele cazuri chiar de 70 de ani.
Unii ar putea susține că multe dintre aceste metode mai vechi aparțin mai degrabă „analizei statistice” decât învățării automate și ar prefera să dateze apariția domeniului abia din 1957, odată cu inventarea perceptronului.
Având în vedere măsura în care acești algoritmi mai vechi susțin și se împletesc cu cele mai recente tendințe și evoluții spectaculoase din învățarea automată, această poziție este discutabilă. Să analizăm, așadar, câteva dintre componentele „clasice” care stau la baza inovațiilor recente, precum și câțiva nou-veniți care aspiră deja la un loc printre realizările de referință ale inteligenței artificiale.
1: Transformatoare
În 2017, Google Research a coordonat o colaborare de cercetare care a culminat cu lucrarea Attention Is All You Need. Aceasta descria o arhitectură nouă care transforma mecanismele de atenție din componente auxiliare ale modelelor codificator/decodificator și ale rețelelor recurente într-o tehnologie transformatoare centrală, de sine stătătoare.
Abordarea a primit denumirea de Transformerși a devenit ulterior o metodologie revoluționară în procesarea limbajului natural (NLP), alimentând, printre multe alte exemple, modelul lingvistic autoregresiv GPT-3, devenit emblematic pentru inteligența artificială.

Transformatoarele au rezolvat elegant problema transducției secvențelor, numită și „transformare”, care privește prelucrarea secvențelor de intrare în secvențe de ieșire. Un transformator primește și gestionează datele în mod continuu, nu în loturi secvențiale, permițând o „persistență a memoriei” pe care arhitecturile RNN nu sunt concepute să o obțină. Pentru o prezentare mai detaliată a transformatoarelor, consultați articolul nostru de referință.
Spre deosebire de rețelele neuronale recurente (RNN), care începuseră să domine cercetarea în învățarea automată în era CUDA, arhitectura Transformer putea fi și paralelizatăcu ușurință, deschizând calea spre prelucrarea eficientă a unui volum de date mult mai mare decât cel abordabil cu RNN.
Utilizări frecvente
Transformatoarele au captivat imaginația publicului în 2020, odată cu lansarea GPT-3 de către OpenAI, care se putea lăuda atunci cu un record de 175 de miliarde de parametri. Această realizare aparent uluitoare a fost în cele din urmă eclipsată de proiecte ulterioare, precum lansarea din 2021 a modelului Megatron-Turing NLG 530B de la Microsoft, care, după cum sugerează numele, cuprinde peste 530 de miliarde de parametri.

Cronologia proiectelor NLP Transformer la scară foarte mare. Sursa: Microsoft
Arhitectura Transformer a trecut și dincolo de NLP, în viziunea computerizată, alimentând o nouă generație de sisteme de sinteză a imaginilor, precum CLIP și DALL-Ede la OpenAI, care folosesc corespondențe între domeniile text>imagine pentru a completa imagini incomplete și a sintetiza imagini noi din domeniile pe care au fost antrenate, printre un număr tot mai mare de aplicații conexe.
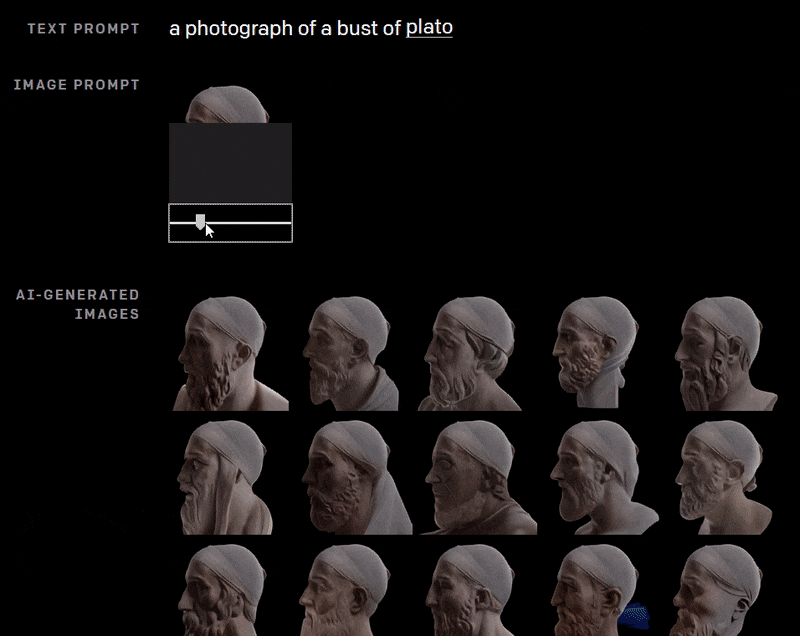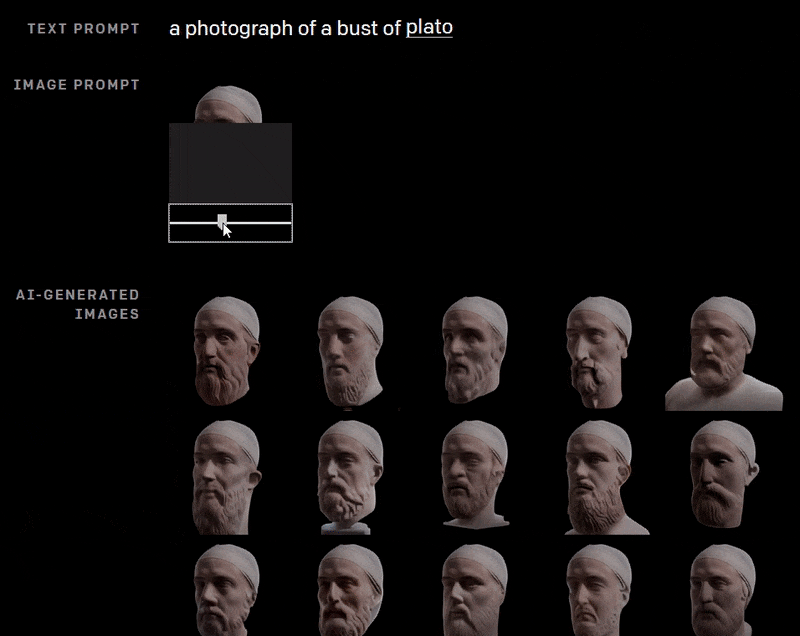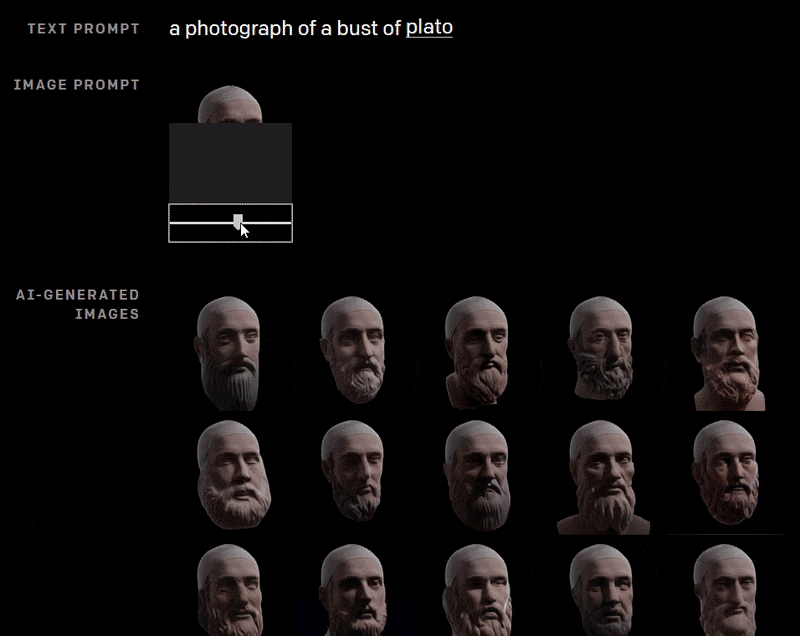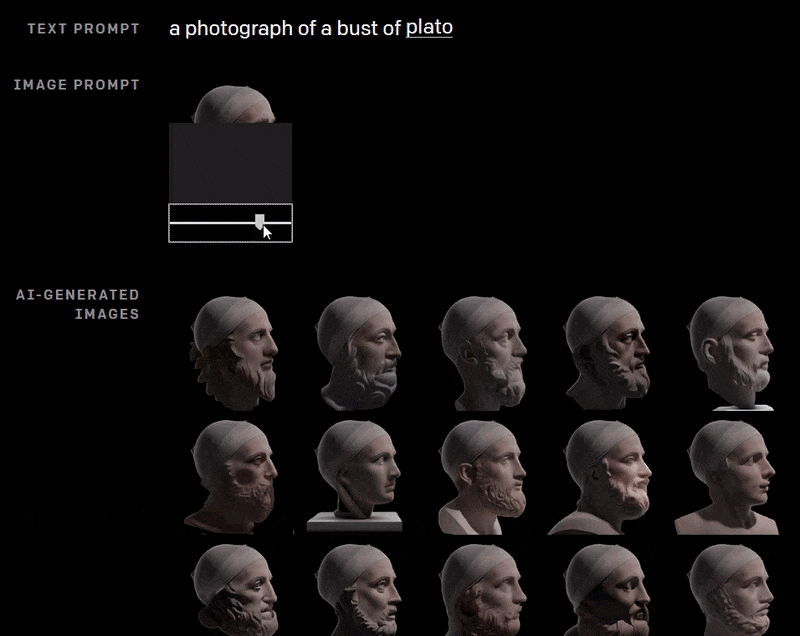
DALL-E încearcă să completeze imaginea parțială a unui bust al lui Platon. Sursa: https://openai.com/blog/dall-e/
2: Rețele generative adversariale (GAN)
Deși transformatoarele au beneficiat de o acoperire mediatică extraordinară prin lansarea și adoptarea GPT-3, rețeaua generativă adversarială (GAN) a devenit o denumire recognoscibilă de sine stătătoare și ar putea ajunge, asemenea termenului deepfake , să fie folosită și ca verb.
Propusă pentru prima dată în 2014 și utilizată în principal pentru sinteza imaginilor, arhitectura unei rețele generative adversariale este alcătuită dintr-un generator și un discriminator. Generatorul parcurge mii de imagini dintr-un set de date și încearcă iterativ să le reconstruiască. La fiecare încercare, discriminatorul evaluează rezultatul generatorului și îl trimite să încerce din nou să obțină unul mai bun, fără să-i explice însă în ce fel a greșit reconstrucția precedentă.

Sursa: https://developers.google.com/machine-learning/gan/gan_structure
Acest lucru obligă generatorul să exploreze numeroase căi, în loc să urmeze potențiale piste înfundate, așa cum s-ar fi putut întâmpla dacă discriminatorul i-ar fi spus unde greșește (a se vedea punctul 8 de mai jos). Până la sfârșitul antrenării, generatorul are o hartă detaliată și cuprinzătoare a relațiilor dintre punctele din setul de date.
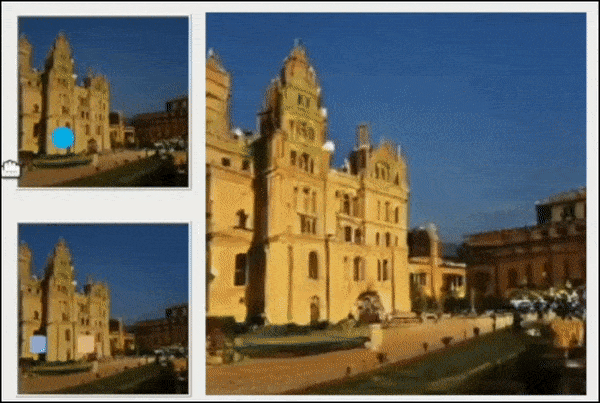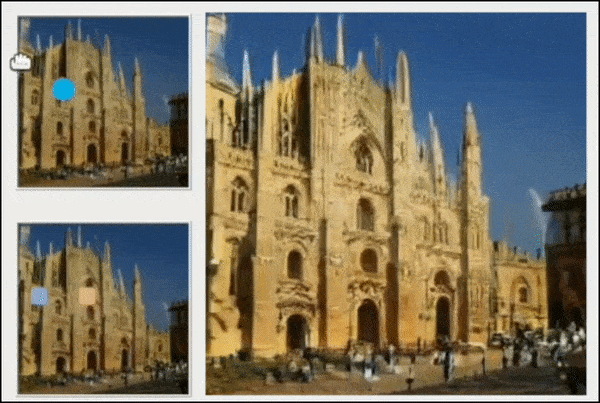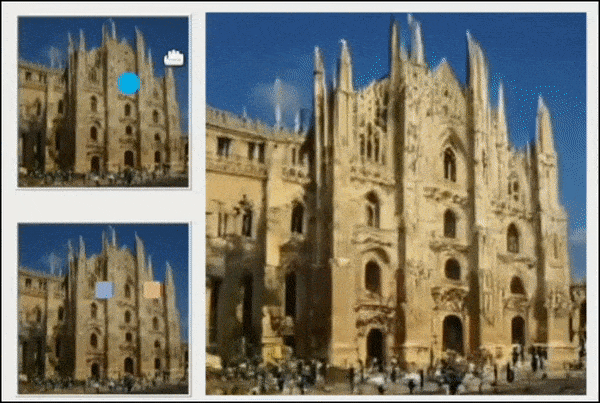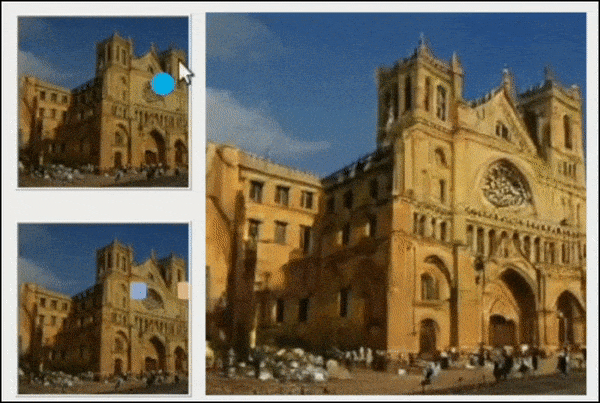
Din lucrarea Improving GAN Equilibrium by Raising Spatial Awareness: un sistem nou parcurge spațiul latent, uneori misterios, al unei rețele GAN, oferind un control interactiv asupra unei arhitecturi de sinteză a imaginilor. Sursa: https://genforce.github.io/eqgan/
Prin analogie, aceasta este diferența dintre a învăța o singură rută banală de navetă spre centrul Londrei și a dobândi, cu mult efort, The Knowledge, cunoașterea aprofundată a străzilor cerută taximetriștilor londonezi.
Rezultatul este un ansamblu de caracteristici de nivel înalt în spațiul latent al modelului antrenat. Indicatorul semantic al unei caracteristici de nivel înalt ar putea fi „persoană”, în timp ce coborârea spre elemente mai specifice ale acestei caracteristici poate dezvălui alte trăsături învățate, precum „bărbat” și „femeie”. La niveluri inferioare, subcaracteristicile pot include „blond”, „caucazian” și altele.
Întrepătrunderea caracteristicilor este o problemă importantă în spațiul latent al rețelelor GAN și al sistemelor codificator/decodificator: zâmbetul de pe chipul unei femei generat de GAN este o caracteristică întrepătrunsă cu „identitatea” ei în spațiul latent sau reprezintă o ramură paralelă?

Chipuri generate de GAN de pe thispersondoesnotexist. Sursa: https://this-person-does-not-exist.com/en
În ultimii doi ani au apărut tot mai multe inițiative de cercetare în această direcție, care ar putea pregăti terenul pentru editarea la nivel de caracteristici, în stil Photoshop, a spațiului latent al unei rețele GAN. În prezent însă, multe transformări sunt practic operațiuni de tipul „totul sau nimic”. În mod remarcabil, versiunea EditGAN lansată de NVIDIA la sfârșitul anului 2021 realizează o interpretabilitate ridicată în spațiul latent folosind măști de segmentare semantică.
Utilizări frecvente
Pe lângă implicarea lor, de fapt destul de limitată, în videoclipurile deepfake populare, rețelele GAN axate pe imagini și video s-au înmulțit în ultimii patru ani, captivând atât cercetătorii, cât și publicul. Este dificil să ții pasul cu ritmul amețitor și frecvența noilor lansări, deși depozitul GitHub Awesome GAN Applications își propune să ofere o listă cuprinzătoare.
Rețelele generative adversariale pot, în teorie, extrage caracteristici din orice domeniu bine definit, inclusiv din text.
3: SVM
Apărut în 1963, algoritmul mașinii cu vectori de suport (SVM) este un algoritm de bază care reapare frecvent în cercetările noi. În SVM, vectorii reprezintă dispunerea relativă a punctelor dintr-un set de date, în timp ce vectorii de suport delimitează granițele dintre grupuri, caracteristici sau trăsături diferite.

Vectorii de suport definesc granițele dintre grupuri. Sursa: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Granița rezultată se numește hiperplan.
La niveluri reduse ale caracteristicilor, SVM este bidimensional (imaginea de mai sus), dar, atunci când este recunoscut un număr mai mare de grupuri sau tipuri, devine tridimensional.

Un ansamblu mai complex de puncte și grupuri necesită un SVM tridimensional. Sursa: https://cml.rhul.ac.uk/svm.html
Utilizări frecvente
Deoarece mașinile cu vectori de suport pot aborda eficient date cu multe dimensiuni, de numeroase tipuri, fără a depinde de un domeniu anume, acestea apar pe scară largă în diverse ramuri ale învățării automate, inclusiv detectarea deepfake-urilor, clasificarea imaginilor, clasificarea discursului instigator la ură, analiza ADN și predicția structurii populației, printre multe altele.
4: Gruparea K-means
Gruparea, în general, este o abordare de învățare nesupervizată care urmărește să clasifice punctele de date prin estimarea densității, creând o hartă a distribuției datelor studiate.

Gruparea K-means identifică segmente, grupuri și comunități în date. Sursa: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
Gruparea K-means a devenit cea mai populară implementare a acestei abordări, repartizând punctele de date în „K grupuri” distincte, care pot indica segmente demografice, comunități online sau orice altă agregare ascunsă ce așteaptă să fie descoperită în datele statistice brute.

Formarea grupurilor în analiza K-means. Sursa: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
Valoarea K în sine este factorul determinant pentru utilitatea procesului și pentru stabilirea unei valori optime pentru un grup. Inițial, valoarea K este atribuită aleatoriu, iar caracteristicile și proprietățile sale vectoriale sunt comparate cu cele ale vecinilor. Vecinii care seamănă cel mai mult cu punctul de date cu valoarea atribuită aleatoriu sunt repartizați iterativ în grupul său, până când datele au produs toate grupările pe care procesul le permite.
Graficul erorii pătratice, sau al „costului” valorilor diferite dintre grupuri, va dezvălui un punct de cotitură pentru date:

„Punctul de cotitură” într-un grafic al grupurilor. Sursa: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Conceptual, punctul de cotitură seamănă cu modul în care pierderea se aplatizează, aducând îmbunătățiri tot mai mici, la sfârșitul unei sesiuni de antrenare pe un set de date. El reprezintă punctul după care nu mai apar diferențe suplimentare între grupuri și indică momentul trecerii la etapele următoare ale fluxului de prelucrare a datelor sau al raportării rezultatelor.
Utilizări frecvente
Din motive evidente, gruparea K-means este o tehnologie esențială pentru analiza clienților, deoarece oferă o metodologie clară și explicabilă de transformare a unor volume mari de evidențe comerciale în informații demografice și clienți potențiali.
În afara acestei aplicații, gruparea K-means este folosită și pentru predicția alunecărilor de teren, segmentarea imaginilor medicale, sinteza imaginilor cu GAN, clasificarea documentelorși planificarea urbană, printre numeroase alte utilizări potențiale și efective.
5: Pădure aleatoare
Pădurea aleatoare este o metodă de învățare de ansamblu care calculează media rezultatelor unui ansamblu de arbori de decizie pentru a stabili o predicție globală a rezultatului.

Sursa: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Chiar dacă singura documentare în acest sens a fost vizionarea trilogiei Înapoi în viitor , un arbore de decizie este destul de ușor de imaginat: în fața ta se află mai multe căi, iar fiecare se ramifică spre un rezultat nou, care conține, la rândul său, alte căi posibile.
În învățarea prin întărire, te poți retrage de pe o cale și poți reîncepe dintr-o poziție anterioară, în timp ce arborii de decizie se angajează pe traseele alese.
Prin urmare, algoritmul pădurii aleatoare distribuie, în esență, riscul între mai multe decizii. Algoritmul este numit „aleator” deoarece face selecții și observații ad-hoc pentru a înțelege suma mediană a rezultatelor ansamblului de arbori de decizie.
Deoarece ține cont de numeroși factori, o abordare bazată pe păduri aleatoare poate fi mai greu de transpus în grafice relevante decât un arbore de decizie, dar are șanse să fie considerabil mai productivă.
Arborii de decizie sunt predispuși la supraînvățare: rezultatele obținute sunt specifice datelor și probabil nu se generalizează. Selecția aleatorie a punctelor de date într-o pădure aleatoare combate această tendință, scoțând la iveală tendințe reprezentative, relevante și utile din date.

Regresie cu arbore de decizie. Sursa: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Utilizări frecvente
La fel ca mulți algoritmi din această listă, pădurea aleatoare funcționează de obicei ca un mecanism de sortare și filtrare preliminară a datelor și, ca atare, reapare constant în lucrările noi de cercetare. Câteva exemple de utilizare sunt sinteza imaginilor de rezonanță magnetică, predicția prețului Bitcoin, segmentarea datelor de recensământ, clasificarea textelor și detectarea fraudelor cu carduri de credit.
Deoarece pădurea aleatoare este un algoritm de nivel inferior în arhitecturile de învățare automată, poate contribui și la performanța altor metode de nivel inferior, precum și a algoritmilor de vizualizare, inclusiv gruparea inductivă, transformările caracteristicilor, clasificarea documentelor text folosind caracteristici rareși vizualizarea fluxurilor de prelucrare.
6: Naive Bayes
Împreună cu estimarea densității (a se vedea punctul 4de mai sus), un clasificator Naive Bayes este un algoritm puternic, dar relativ ușor, capabil să estimeze probabilități pe baza caracteristicilor calculate ale datelor.

Relațiile dintre caracteristici într-un clasificator Naive Bayes. Sursa: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
Termenul „naiv” se referă la presupunerea din teorema lui Bayes că trăsăturile nu sunt corelate, cunoscută drept independență condiționată. Dacă adoptăm această perspectivă, faptul că ceva merge și măcăie ca o rață nu este suficient pentru a stabili că avem de-a face cu o rață și nu sunt acceptate prematur presupuneri „evidente”.
Acest nivel de rigoare academică și de investigație ar fi excesiv acolo unde este disponibil „bunul-simț”, dar reprezintă un standard valoros când explorăm numeroasele ambiguități și corelații potențial fără legătură care pot exista într-un set de date pentru învățare automată.
Într-o rețea bayesiană originală, caracteristicile sunt supuse unor funcții de evaluare, inclusiv lungimea minimă a descrierii și evaluarea bayesiană, care pot impune restricții asupra datelor în funcție de conexiunile estimate între punctele de date și de direcția acestor conexiuni.
În schimb, un clasificator Naive Bayes presupune că trăsăturile unui obiect dat sunt independente, folosind apoi teorema lui Bayes pentru a calcula probabilitatea unui obiect dat pe baza caracteristicilor sale.
Utilizări frecvente
Filtrele Naive Bayes sunt bine reprezentate în predicția bolilor și clasificarea documentelor, filtrarea mesajelor spam, clasificarea sentimentelor, sistemele de recomandareși detectarea fraudelor, printre alte aplicații.
7: Cei mai apropiați K vecini (KNN)
Propus pentru prima dată de Școala de Medicină Aeronautică a Forțelor Aeriene ale SUA în 1951și nevoit să se adapteze nivelului tehnicii de calcul de la mijlocul secolului XX, algoritmul celor mai apropiați K vecini (KNN) este unul suplu, care continuă să ocupe un loc important în lucrările academice și în inițiativele de cercetare a învățării automate din sectorul privat.
KNN a fost numit „învățăcelul leneș”, deoarece parcurge exhaustiv un set de date pentru a evalua relațiile dintre punctele de date, în loc să necesite antrenarea unui model complet de învățare automată.

O grupare KNN. Sursa: https://scikit-learn.org/stable/modules/neighbors.html
Deși KNN are o arhitectură simplă, abordarea sa sistematică solicită considerabil operațiile de citire/scriere. Utilizarea sa pe seturi de date foarte mari poate fi problematică fără tehnologii complementare, precum analiza componentelor principale (PCA), care poate transforma seturi de date complexe și voluminoase în grupări reprezentative pe care KNN le poate parcurge cu mai puțin efort.
Un studiu recent a evaluat eficacitatea și costurile mai multor algoritmi însărcinați să prezică dacă un angajat va părăsi o companie și a constatat că algoritmul KNN, vechi de șaptezeci de ani, rămânea superior concurenților mai moderni din punctul de vedere al preciziei și eficacității predictive.
Utilizări frecvente
În ciuda simplității sale conceptuale și de implementare, pentru care este cunoscut, KNN nu a rămas blocat în anii 1950: a fost adaptat într-o abordare axată mai mult pe rețele neuronale profunde într-o propunere din 2018 a Universității de Stat din Pennsylvania și rămâne un proces central în etapele inițiale, sau un instrument analitic de postprocesare, în multe sisteme de învățare automată mult mai complexe.
În diverse configurații, KNN a fost utilizat pentru verificarea online a semnăturilor, clasificarea imaginilor, extragerea informațiilor din texte, predicția recoltelorși recunoașterea facială, pe lângă alte aplicații și integrări.

Un sistem de recunoaștere facială bazat pe KNN, în timpul antrenării. Sursa: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Procesul decizional Markov (MDP)
Un cadru matematic introdus de matematicianul american Richard Bellman în 1957, procesul decizional Markov (MDP) este una dintre componentele fundamentale ale arhitecturilor de învățare prin întărire . Algoritm conceptual de sine stătător, el a fost adaptat în numeroși alți algoritmi și reapare frecvent în cercetarea actuală din domeniul inteligenței artificiale și al învățării automate.
MDP explorează un mediu de date folosindu-și evaluarea stării curente, adică a poziției sale în date, pentru a decide ce nod de date să exploreze în continuare.

Sursa: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Un proces decizional Markov de bază acordă prioritate avantajului pe termen scurt față de obiectivele mai dezirabile pe termen lung. Din acest motiv, este de obicei integrat într-o arhitectură mai cuprinzătoare de politici din învățarea prin întărire și este adesea supus unor factori restrictivi, precum recompensa actualizată, și altor variabile de mediu modificatoare, care îl împiedică să se grăbească spre un obiectiv imediat fără a lua în considerare rezultatul general dorit.
Utilizări frecvente
Conceptul de nivel inferior al MDP este răspândit atât în cercetare, cât și în implementările active ale învățării automate. A fost propus pentru sisteme de apărare pentru securitatea IoT, recoltarea peșteluiși prognoza pieței.
Pe lângă aplicabilitatea sa evidentă în șah și în alte jocuri strict secvențiale, MDP este un candidat firesc și pentru antrenarea procedurală a sistemelor robotice, după cum putem vedea în videoclipul de mai jos.
9: Frecvența termenului – frecvența inversă a documentelor
Frecvența termenului (TF) împarte numărul de apariții ale unui cuvânt într-un document la numărul total de cuvinte din acel document. Astfel, cuvântul focă , apărut o singură dată într-un articol de o mie de cuvinte, are frecvența 0,001. În sine, TF este în mare măsură inutilă ca indicator al importanței unui termen, deoarece predomină cuvintele funcționale lipsite de conținut semantic distinct, precum termenii englezești a, and, theși it.
Pentru a obține o valoare relevantă pentru un termen, frecvența inversă a documentelor (IDF) calculează TF a unui cuvânt în mai multe documente dintr-un set de date, atribuind scoruri mici cuvintelor de oprirefoarte frecvente, precum articolele. Vectorii de caracteristici rezultați sunt normalizați la valori întregi, fiecărui cuvânt fiindu-i atribuită o pondere adecvată.

TF-IDF ponderează relevanța termenilor în funcție de frecvența lor în mai multe documente, aparițiile mai rare indicând importanța. Sursa: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Deși această abordare împiedică pierderea cuvintelor importante semantic ca valori atipice, inversarea ponderii frecvenței nu înseamnă automat că un termen cu frecvență mică nu este o valoare atipică, deoarece unele lucruri sunt rare și lipsite de valoare. Prin urmare, un termen cu frecvență mică trebuie să-și demonstreze valoarea în contextul arhitectural mai larg prin apariția în mai multe documente ale setului de date, chiar și cu o frecvență mică în fiecare document.
În ciuda vechimiisale, TF-IDF este o metodă puternică și populară pentru etapele inițiale de filtrare în sistemele de procesare a limbajului natural.
Utilizări frecvente
Deoarece TF-IDF a jucat cel puțin un anumit rol în dezvoltarea algoritmului PageRank al Google, în mare parte netransparent, în ultimii douăzeci de ani, acesta a ajuns să fie adoptat pe scară foarte largă ca tactică de manipulare SEO, în ciuda negării importanței sale pentru rezultatele căutărilor de către John Mueller în 2019.
Din cauza secretului care înconjoară PageRank, nu există dovezi clare că TF-IDF nu este în prezent o tactică eficientă de urcare în clasamentele Google. O discuție aprinsă recentă între profesioniști IT indică o percepție răspândită, corectă sau nu, potrivit căreia folosirea abuzivă a termenilor poate duce în continuare la o poziționare SEO mai bună, deși acuzațiile de abuz de monopol și publicitatea excesivă estompează suplimentar limitele acestei teorii.
10: Coborârea stocastică a gradientului
Coborârea stocastică a gradientului (SGD) este o metodă din ce în ce mai populară de optimizare a antrenării modelelor de învățare automată.
Coborârea gradientului este ea însăși o metodă de optimizare și apoi de cuantificare a îmbunătățirii pe care o realizează un model în timpul antrenării.
În acest context, „gradient” indică o pantă descendentă, nu o gradație de culoare (a se vedea imaginea de mai jos), iar punctul cel mai înalt al „dealului”, din stânga, reprezintă începutul procesului de antrenare. În această etapă, modelul nu a parcurs încă toate datele nici măcar o dată și nu a învățat suficient despre relațiile dintre ele pentru a produce transformări eficiente.

Coborârea gradientului într-o sesiune de antrenare FaceSwap. Observăm că antrenarea a stagnat o perioadă în a doua jumătate, dar a reluat în cele din urmă coborârea pe gradient spre o convergență acceptabilă.
Punctul cel mai de jos, din dreapta, reprezintă convergența: punctul în care modelul este atât de eficient pe cât poate deveni în limitele restricțiilor și setărilor impuse.
Gradientul funcționează ca o evidență și un predictor al diferenței dintre rata erorii, adică precizia cu care modelul a reprezentat până atunci relațiile dintre date, și ponderi, adică setările care influențează modul în care modelul învață.
Această evidență a progresului poate fi folosită pentru a ghida un program de ajustare a ratei de învățare, un proces automat care îndrumă arhitectura spre o granularitate și o precizie mai mari pe măsură ce detaliile inițial vagi se transformă în relații și corespondențe clare. În practică, pierderea pe gradient oferă la momentul potrivit o hartă a direcției în care trebuie să continue antrenarea și a modului în care trebuie să se desfășoare.
Inovația coborârii stocastice a gradientului constă în actualizarea parametrilor modelului pentru fiecare exemplu de antrenare la fiecare iterație, ceea ce accelerează în general atingerea convergenței. Odată cu apariția seturilor de date la scară foarte mare în ultimii ani, SGD a câștigat popularitate ca posibilă metodă de abordare a problemelor logistice rezultate.
Pe de altă parte, SGD are implicații negative pentru scalarea caracteristicilor și poate necesita mai multe iterații pentru a obține același rezultat, solicitând planificare și parametri suplimentari față de coborârea obișnuită a gradientului.
Utilizări frecvente
Datorită posibilităților de configurare și în ciuda limitărilor sale, SGD a devenit cel mai popular algoritm de optimizare pentru ajustarea rețelelor neuronale. O configurație SGD care devine dominantă în lucrările noi de cercetare AI/ML este alegerea optimizatorului Adaptive Moment Estimation (ADAM), introdus în 2015.
ADAM adaptează dinamic rata de învățare pentru fiecare parametru („rată de învățare adaptivă”) și încorporează rezultatele actualizărilor anterioare în configurația următoare („momentum”). În plus, poate fi configurat să folosească inovații ulterioare, precum momentumul Nesterov.
Unii susțin însă că utilizarea momentumului poate grăbi și ADAM, precum și algoritmii similari, spre o soluție suboptimă. Ca în mare parte din cercetarea de ultimă oră în învățarea automată, SGD rămâne în curs de dezvoltare.
Publicat inițial la 10 februarie 2022. Modificat la 10 februarie, ora 20:05 EET – formatare.


