
Cele mai bune
10 cele mai bune instrumente AI de web scraping (septembrie 2026)

 Adaugă Unite.AI la sursele tale preferate pe Google
Unite.AI poate primi compensații când folosiți linkuri către produse analizate. Acest lucru nu influențează evaluările noastre editoriale. Citiți dezvăluirea privind afilierea.
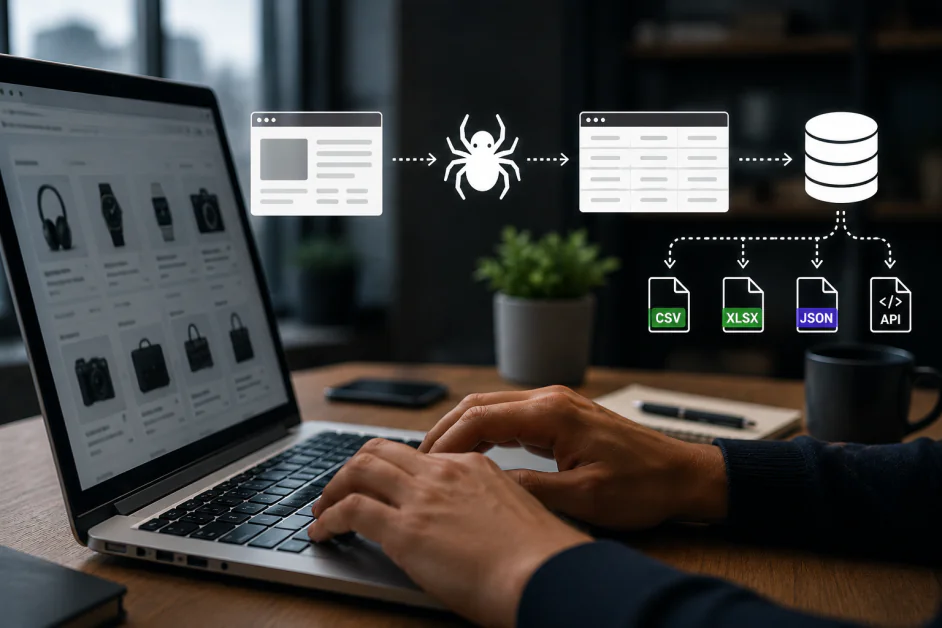
Instrumentele AI de web scraping nu mai sunt doar parsere de pagini. Cele mai bune platforme ajută acum echipele să colecteze date web publice, să transforme paginile dezordonate în seturi de date structurate, să alimenteze sistemele de generare augmentată prin recuperare, să monitorizeze piețele și să ofere agenților AI un context web fiabil.
Această schimbare contează deoarece scraping‑ul a devenit atât mai valoros, cât și mai dificil de realizat corect. Site‑urile moderne sunt dinamice, personalizate, intens scriptate și adesea protejate de sisteme anti‑abuz. Un instrument util de scraping trebuie să facă mai mult decât să extragă HTML. Trebuie să gestioneze redarea, logica de extragere, programarea, calitatea datelor, conformitatea și transferul către sistemele în care datele sunt efectiv utilizate.
Alegerea potrivită depinde de sarcină. Unele echipe au nevoie de infrastructură de nivel enterprise pentru programe mari de date publice. Altele au nevoie de Markdown pregătit pentru LLM, de un robot fără cod pentru cercetări recurente, de o platformă pentru dezvoltatori pentru automatizare de browser sau de un API specializat pentru rezultate de căutare. Instrumentele de mai jos acoperă aceste abordări diferite.
Echipa noastră a evaluat independent fiecare soluție din acest ghid, analizând capabilitățile, punctele forte practice, limitările și potrivirea pentru cazurile de utilizare reflectate în clasamentul nostru.
Cele mai bune instrumente AI de web scraping comparate
| Instrument AI | Cel mai potrivit pentru | Puncte forte cheie |
|---|---|---|
| Bright Data | Scraping web la nivel enterprise, infrastructură de proxy și fluxuri de date AI | API-uri de scraper, API de browser, Scraper Studio, Web Unlocker, infrastructură de proxy, seturi de date, fluxuri de lucru RAG |
| Firecrawl | Transformarea site‑urilor în conținut curat, pregătit pentru LLM, pentru aplicații AI | Scrape, crawl, search, map, monitor, Markdown, JSON structurat, interacțiune cu browserul, API, MCP, open source |
| Apify | Dezvoltatori care construiesc scrapers scalabili, automatizări de browser și agenți de date | Marketplace de actori, Crawlee, Playwright, Puppeteer, Selenium, programare, proxy‑uri, seturi de date, API‑uri, integrări MCP |
| Browse AI | Web scraping fără cod, monitorizare site‑uri și colectare recurentă de date de business | Roboți AI, instruire point‑and‑click, monitorizare site‑uri, extragere programată, roboți predefiniți, integrări |
| SearchAPI | Date SERP și ale motoarelor de căutare în timp real pentru AI, SEO și fluxuri de lucru de cercetare | Google, Google Maps, Bing, YouTube, date de cumpărături și știri, JSON structurat, geotargetare, rotație de proxy, reîncercări, MCP |
| ScrapingBee | API de scraping prietenos dezvoltatorilor, cu extragere AI și redare JavaScript | Extragere în limbaj natural, JSON structurat, Markdown, scenarii JavaScript, rotație de proxy, capturi de ecran, API‑uri dedicate, CLI, MCP |
| Octoparse | Scraping vizual fără cod pentru site‑uri dinamice și sarcini recurente în cloud | Constructor vizual de fluxuri de lucru, detectare automată AI, extracție în cloud, șabloane, rotație IP, programare, exporturi, API‑uri |
| Oxylabs | API‑uri de scraping enterprise, fundamentare AI și site‑uri publice dificile | API Web Scraper, AI Studio, Browser fără interfață, Web Unblocker, Fast Search API, date structurate, geotargetare |
| Diffbot | Clasificare automată a paginilor, extragere de entități și acces la Knowledge Graph | API Extract, API Crawl, Knowledge Graph, îmbogățire de entități, procesare în limbaj natural, vedere computerizată, seturi de date structurate |
| ScrapeGraphAI | Extragere în limbaj natural cu JSON structurat și integrări cu cadre AI | Extragere bazată pe prompt, scheme JSON, crawling, monitorizare, redare JavaScript, SDK‑uri, CLI, MCP, integrări LangChain și CrewAI |
Cum să alegi un instrument AI de web scraping
Începe cu tipul de problemă de date web pe care îl ai. Dacă scopul este să alimentezi un produs AI cu context web curat, prioritizează Markdown, JSON structurat, controale de crawling și ieșire prietenoasă pentru recuperare. Dacă scopul este cercetare de business recurentă, un robot fără cod sau un constructor vizual de fluxuri poate fi mai rapid. Dacă scopul este colectare la scară largă de date publice, caută profunzime în infrastructură: redare, cozi, controale de proxy, deblocare, monitorizare și livrare fiabilă.
A doua întrebare este cine va menține fluxul de lucru. O echipă de marketing care urmărește paginile concurenților are nevoie de un produs foarte diferit de o echipă de inginerie care construiește un pipeline de date. Sistemele bune de scraping fac extragerea repetabilă, dar nu elimină nevoia de validare. Site‑urile se schimbă, câmpurile devin ambigue, iar extragerea asistată de AI poate părea sigură chiar și când pagina este neclară. Configurația optimă este cea care se potrivește cu nivelul tehnic al echipei, procesul de revizuire și obligațiile de conformitate.
10 cele mai bune instrumente AI de web scraping
1. Bright Data
Bright Data este cea mai puternică opțiune atunci când colectarea de date web este un sistem de bază al afacerii, nu un proiect secundar. Combină API‑uri de scraper, infrastructură de browser, management de proxy, tehnologie de deblocare și seturi de date predefinite, astfel încât echipele să poată colecta date publice la scară serioasă fără să asambleze fiecare strat separat.
Platforma este deosebit de utilă pentru companii care construiesc inteligență de piață, monitorizare ecommerce, inteligență de căutare, seturi de date pentru antrenarea modelelor AI, fluxuri de generare augmentată prin recuperare sau produse de date competitive. Bright Data oferă echipelor tehnice suficient control pentru a crea fluxuri complexe, oferind totodată căi gestionate pentru echipele care doresc date structurate fără să mențină o stivă fragilă de scraping.
Această largă acoperire este și criteriul de achiziție. Bright Data are sens atunci când o organizație poate aloca proprietate tehnică sau de operațiuni de date, poate defini ținte aprobate și poate monitoriza calitatea și costurile în timp. Echipele mici cu o listă restrânsă de site‑uri ușoare pot fi deservite mai bine de un API mai ușor sau un serviciu fără cod, în timp ce programele reglementate ar trebui să alinieze politicile de colectare cu revizuiri legale și de confidențialitate.
Pro și Contra
- Cea mai largă acoperire a infrastructurii din acest clasament
- Potrivit pentru site‑uri publice cu volum mare și dificile
- Scraper‑ele și seturile de date predefinite reduc timpul de dezvoltare
- Util pentru fluxuri de date AI, inteligență de căutare și monitorizare ecommerce
- Mai multă infrastructură decât au nevoie proiectele mici ocazionale
- Echipele au în continuare nevoie de guvernanță clară a datelor și reguli pentru site‑urile țintă
- Cazurile avansate necesită configurare tehnică și monitorizare
2. Firecrawl
Firecrawl este construit pentru era AI a web scraping‑ului. În loc să oblige dezvoltatorii să curețe HTML brut, să gestioneze redarea paginilor și să normalizeze manual conținutul dezordonat, transformă paginile web în Markdown curat sau date structurate care pot alimenta agenți, sisteme de recuperare, instrumente de cercetare și fluxuri de produse.
Atractivitatea constă în simplitatea la nivelul aplicației. Dezvoltatorii pot scrapa o pagină, crawl‑a un site, căuta pe web, mapa URL‑uri, monitoriza schimbări sau solicita ieșire structurată cu mult mai puțină „instalație” decât o stivă tradițională de scraper. Firecrawl este potrivit în special când produsul final este un asistent AI, o bază de cunoștințe, un flux de cercetare sau un sistem de generare augmentată prin recuperare.
Echipele ar trebui să trateze Firecrawl ca stratul de achiziție a conținutului, nu ca întreaga platformă de date. Utilizarea în producție necesită în continuare definirea sursei, deduplicare, reguli de prospețime, validare a schemelor și observabilitate când site‑urile se schimbă. Valoarea sa este maximă când dezvoltatorii doresc un API concis și opțiune de auto‑hosting, dar nu au nevoie de controale de proxy extinse sau de seturi de date gestionate oferite de furnizorii enterprise.
Pro și Contra
- Excelent pentru aplicații AI care necesită context web curat
- Markdown și ieșire structurată reduc curățarea ulterioară
- Suprafață API utilă pentru fluxuri de lucru de scrape, crawl, search, map și monitorizare
- Opțiunea open‑source oferă echipelor tehnice mai multă flexibilitate în implementare
- Nu este o platformă completă de proxy sau infrastructură de date enterprise
- Extragerea complexă beneficiază în continuare de proiectarea și validarea schemelor
- Echipele cu cerințe stricte de conformitate ar trebui să revizuiască cu atenție opțiunile de implementare și păstrare
3. Apify
Apify este o alegere solidă pentru echipele care doresc atât o platformă pentru dezvoltatori, cât și un marketplace mare de instrumente de automatizare web gata de utilizare. Modelul său Actor permite ambalarea scraper‑elor, automatizărilor de browser și fluxurilor de date ca joburi cloud reutilizabile, care pot fi programate, apelate prin API, conectate la stocare și partajate în cadrul unei echipe.
Dezvoltatorii beneficiază de o cale practică de la prototip la producție. Pot construi cu Crawlee, Playwright, Puppeteer, Selenium sau cu actori existenți, apoi să folosească Apify pentru execuție, cozi, proxy‑uri, seturi de date, webhook‑uri și integrări. Acest lucru îl face deosebit de util pentru echipele care au nevoie de joburi de date repetitive, nu de extragere punctuală.
Flexibilitatea Apify este atât o forță, cât și o responsabilitate. Echipele trebuie să selecteze actori de încredere, să controleze versiunile, să monitorizeze rulările și să aloce bugete pentru calcul, proxy și stocare pe măsură ce sarcinile cresc. Este ideal pentru dezvoltatorii care doresc blocuri reutilizabile și operațiuni cloud într-un singur loc; utilizatorii ocazionali pot găsi un scraper dedicat mai rapid de învățat.
Pro și Contra
- Marketplace mare de Actori predefiniți pentru ținte comune
- Unelte puternice pentru dezvoltatori pentru scraping personalizat și automatizare de browser
- Potrivit pentru fluxuri de lucru programate și repetitive de colectare a datelor
- Suportul pentru Crawlee oferă echipelor tehnice o bază open‑source flexibilă
- Calitatea marketplace‑ului variază în funcție de Actor și caz de utilizare
- Joburile personalizate necesită în continuare mentenanță când site‑urile se schimbă
- Utilizatorii non‑tehnici pot prefera un scraper vizual mai simplu
4. Browse AI
Browse AI este cel mai potrivit pentru echipele de business care au nevoie de date web, dar nu doresc să construiască scrapers. Utilizatorii instruiesc un robot arătându‑i ce să colecteze, apoi rulează robotul la cerere sau pe o programare. Acest lucru îl face util pentru urmărirea concurenților, monitorizarea listărilor, colectarea de lead‑uri, supravegherea stocurilor sau transformarea cercetărilor repetitive în fluxuri de lucru recurente.
Forța sa constă în accesibilitate. Browse AI oferă echipelor de operațiuni, marketing, recrutare, ecommerce și cercetare o modalitate practică de a colecta date structurate de pe site‑uri fără a solicita ingineriei să mențină fiecare selector. Nu încearcă să fie cea mai profundă platformă pentru dezvoltatori; încearcă să facă colectarea repetabilă de date web accesibilă.
Browse AI funcționează cel mai bine când fluxul țintă poate fi demonstrat clar și revizuit de un om. Utilizatorii ar trebui să testeze paginarea, pașii de autentificare, stările goale și modificările de layout înainte de a se baza pe o automatizare pentru decizii. Este o alegere solidă pentru proiecte departamentale, dar programele conduse de inginerie pot necesita un control mai granular asupra reîncercărilor, contractelor de date și implementării.
Pro și Contra
- Experiență puternică fără cod pentru utilizatorii de business
- Potrivit pentru monitorizare recurentă și fluxuri de lucru în stil foaie de calcul
- Antrenarea robotului prin point‑and‑click este mai ușoară decât configurarea bazată pe selectori
- Util pentru echipele care au nevoie de date web fără suport de inginerie
- Mai puțin flexibil decât platformele orientate spre dezvoltatori pentru logică complexă
- Roboții pot necesita ajustări când paginile țintă se schimbă semnificativ
- Programele mari sau foarte personalizate pot depăși o abordare fără cod
5. SearchAPI
SearchAPI este un serviciu specializat de scraping pentru echipele care au nevoie de rezultate actuale ale motoarelor de căutare ca date structurate, nu de pagini brute de rezultate. Un singur API poate returna linkuri organice, reclame, știri, listări de hărți, rezultate de cumpărături, panouri de cunoștințe, întrebări „People Also Ask”, funcționalități de căutare generate de AI și alte tipuri de rezultate în JSON, în funcție de motorul selectat.
Platforma este deosebit de utilă pentru monitorizare SEO, analiză de căutare locală, cercetare de piață, inteligență de produs și agenți AI care au nevoie de context de căutare în timp real. SearchAPI gestionează redarea în browser, rotația de proxy, reîncercări și gestionarea CAPTCHA‑urilor în spatele cererii, în timp ce parametrii de localizare susțin interogări specifice de țară, limbă, locație și dispozitiv. Motoarele documentate depășesc rezultatele standard Google, incluzând Google Maps, Bing, YouTube, știri și experiențe de căutare comercială.
SearchAPI oferă, de asemenea, un server MCP pentru conectarea asistenților AI susținuți și a mediilor de dezvoltare la instrumentele sale de căutare. Compromisul este specializarea: acesta este un strat puternic de date de căutare, nu un crawler general pentru extragerea de câmpuri arbitrare de pe orice site. Cumpărătorii ar trebui să modeleze cu atenție utilizarea, deoarece planurile sunt pe bază de credite, debitul variază în funcție de nivel, iar suprafețele de căutare mai bogate necesită verificări de schemă când layout‑urile din amonte se schimbă.
Pro și Contra
- Returnează date SERP structurate în timp real fără a menține scrapers de căutare sau infrastructură de proxy
- Suportă principalele motoare de căutare, hărți, video, știri, cumpărături și alte motoare de rezultate specializate
- Controlul de locație, limbă, țară și dispozitiv se potrivește pentru urmărirea pozițiilor și cercetarea de piață
- Accesul prin API și MCP face datele de căutare practice pentru aplicații și agenți AI
- Se concentrează pe datele rezultatelor motoarelor de căutare, nu pe crawling arbitrar de site‑uri
- Planurile bazate pe credite și limitele de debit necesită prognozare pentru sarcini cu volum mare
- Aplicațiile ar trebui să valideze câmpurile pe măsură ce motoarele de căutare își schimbă structura rezultatelor
6. ScrapingBee
ScrapingBee este un API prietenos dezvoltatorilor pentru echipele care doresc să colecteze și să structureze date web fără a menține browsere headless sau infrastructură de proxy. Combină redarea JavaScript, rotația de proxy, capturi de ecran, extragere CSS/XPath și un strat de extragere AI care transformă cererile în limbaj natural și regulile de câmp în JSON structurat.
Platforma este deosebit de utilă când dezvoltatorii doresc un singur punct final atât pentru pagini simple, cât și pentru site‑uri interactive. Scenariile JavaScript pot face click, scroll, tastare sau așteptare înainte de extragere, în timp ce ieșirea în Markdown, API‑uri dedicate, CLI și integrările MCP ajută conținutul extras să ajungă în analize, automatizări și fluxuri AI. ScrapingBee este mai simplu de adoptat decât o stivă completă de scraping, deși consumul de credite poate varia în funcție de proxy‑uri premium, redare și funcții AI.
ScrapingBee se potrivește cel mai bine când inginerii doresc un strat de cerere gestionat, păstrând orchestrarea și calitatea datelor în propria aplicație. Echipele ar trebui să definească reguli de reîncercare, scheme, limite de crawling și validare pentru joburi pe mai multe pagini, în loc să trateze fiecare răspuns HTTP de succes ca pe date de încredere. Un scraper vizual desktop va fi mai ușor pentru utilizatorii non‑tehnici, dar echipele API câștigă un control direct mai mare asupra integrării și implementării.
Pro și Contra
- Extragerea AI în limbaj natural poate returna JSON structurat fără selectori creați manual
- Redarea JavaScript și acțiunile scriptate gestionează multe fluxuri de lucru cu pagini dinamice
- Rotația de proxy, capturi de ecran, ieșire Markdown și API‑uri dedicate sunt disponibile printr-un singur serviciu
- CLI, MCP și integrările de automatizare se potrivesc fluxurilor de lucru ale dezvoltatorilor și agenților
- Consumul de credite crește când cererile includ extragere AI, proxy‑uri premium sau redare JavaScript
- Este un produs orientat API, nu un scraper vizual pentru desktop
- Crawl‑urile complexe pe mai multe pagini necesită în continuare orchestrare și verificări de calitate
7. Octoparse
Octoparse este un scraper matur fără cod pentru utilizatorii care doresc un flux de lucru vizual în loc de un cadru pentru dezvoltatori. Poate detecta datele de pe pagină, ghida utilizatorii prin pașii de extracție și rula joburi de scraping în cloud, fiind util pentru colectare recurentă din site‑uri ecommerce, directoare, listări, pagini de căutare și alte surse web structurate.
Platforma este cea mai puternică când o echipă are nevoie de mai mult control asupra fluxului decât un simplu scraper de extensie de browser, dar dorește să evite scrierea de cod. Șabloanele, programarea, extracția în cloud, exporturile automate și suportul pentru pagini dinamice fac din Octoparse un punct de mijloc practic între instrumentele simple fără cod și platformele de scraping conduse de inginerie.
Modelul său vizual recompensează în continuare un design atent al fluxului. Echipele ar trebui să testeze paginarea, scroll‑ul infinit, stările de autentificare, înregistrările duplicate și ramurile de eroare înainte de a se baza pe joburi programate. Octoparse este bine potrivit pentru analiști și utilizatori de operațiuni care pot gestiona aceste verificări, în timp ce dezvoltatorii care construiesc pipeline‑uri strict versionate pot prefera un API sau un cadru code‑first cu control mai puternic al sursei și testare automată.
Pro și Contra
- Constructorul vizual de fluxuri de lucru oferă utilizatorilor mai mult control decât instrumentele simple cu un singur click
- Extracția în cloud ajută sarcinile recurente să ruleze fără o mașină locală
- Șabloanele reduc timpul de configurare pentru site‑uri și tipuri de date comune
- Potrivit pentru echipele de operațiuni care au nevoie de seturi de date structurate și repetitive
- Proiectarea fluxului de lucru poate necesita timp pe site‑uri complicate
- Mai puțin natural pentru echipele de dezvoltare care preferă pipeline‑uri orientate pe cod
- Monitorizarea continuă este încă necesară când site‑urile țintă se schimbă
8. Oxylabs
Oxylabs este o alegere solidă pentru echipele care au nevoie de acces fiabil la date web publice la scară și nu doresc să gestioneze rotația de proxy, redarea și straturile anti‑blocare în mod intern. API‑ul său Web Scraper este conceput pentru a colecta date publice structurate dintr‑o gamă largă de ținte, gestionând majoritatea infrastructurii de scraping în spate.
Compania a aprofundat, de asemenea, fluxurile de lucru AI cu AI Studio, Fast Search API, automatizare de browser și cazuri de utilizare orientate pe fundamentare. Acest lucru îl face relevant pentru organizații care construiesc sisteme de inteligență de piață, monitorizare de căutare, pipeline‑uri de fundamentare a modelelor, seturi de date ecommerce și fluxuri de lucru ale agenților care necesită context web proaspăt.
Oxylabs este cel mai convingător când fiabilitatea, dificultatea țintei sau acoperirea geografică justifică un serviciu orientat enterprise. Cumpărătorii ar trebui să cartografieze site‑urile țintă, cerințele de ieșire, timpii de răspuns și responsabilitatea de conformitate înainte de a selecta o configurație de produs. Proiectele mici s-ar putea să nu folosească întreaga adâncime a infrastructurii platformei, în timp ce programele mari necesită în continuare monitorizare de calitate independentă, deoarece colectarea reușită nu garantează normalizarea exactă.
Pro și Contra
- Infrastructură de scraping și proxy de nivel enterprise puternică
- Util pentru pipeline‑uri de date web publice care necesită scară și fiabilitate
- AI Studio și Fast Search API susțin fluxuri de lucru ale agenților și de fundamentare
- Potrivit pentru site‑uri dinamice dificile și colectare geotargetată
- Cel mai potrivit pentru echipe cu cerințe tehnice și de conformitate definite
- Poate reprezenta o infrastructură mai mare decât cea necesară pentru proiecte mici fără cod
- Fluxurile de lucru avansate necesită selecție atentă a țintelor și validare
9. Diffbot
Diffbot este diferit de majoritatea instrumentelor de web scraping deoarece se concentrează pe înțelegerea paginilor și a entităților, nu doar pe colectarea de câmpuri. Tehnologia sa de extragere clasifică paginile, identifică entități structurate și conectează datele web la un Knowledge Graph mai larg, util când obiectivul este informație îmbogățită și normalizată, nu rânduri brute de date.
Acest lucru îl face în special relevant pentru echipele care lucrează la inteligență de entități, date despre companii și persoane, cercetare de piață, Knowledge Graph‑uri, monitorizare media și sisteme AI care au nevoie de fapte structurate de pe webul deschis. Nu este un scraper rapid point‑and‑click, ci un strat de extragere și cunoaștere la scară web.
Întrebarea principală de achiziție este dacă modelul de date al Diffbot‑ului se potrivește cu entitățile și relațiile de care proiectul are nevoie. Când se potrivește, echipele pot evita construirea de parsere specifice paginilor și a pipeline‑urilor de îmbogățire de la zero. Când nu, un scraper convențional poate oferi un control mai direct. Evaluarea ar trebui să includă pagini reprezentative, acoperire de câmpuri, frecvența actualizărilor, rezoluția entităților și modul în care proveniența va fi păstrată în downstream.
Pro și Contra
- Extragere automată puternică și înțelegere a entităților
- Accesul la Knowledge Graph adaugă context dincolo de o singură pagină
- Util pentru fluxuri de lucru de îmbogățire, cercetare și inteligență structurată
- Potrivit când entitățile normalizate contează mai mult decât tabelele brute ale paginilor
- Mai puțin intuitiv pentru scraping în stil foaie de calcul simplă
- Cele mai bune rezultate depind de potrivirea modelelor Diffbot cu tipul de conținut țintă
- Echipele trebuie să înțeleagă Knowledge Graph și modelul API pentru a obține valoarea completă
10. ScrapeGraphAI
ScrapeGraphAI este conceput pentru utilizatorii care doresc să descrie datele necesare în limbaj simplu și să primească ieșire structurată. În loc să scrie selectori pentru fiecare câmp, echipele pot furniza un URL, defini informația dorită și folosi extragerea asistată de AI pentru a returna JSON curat pentru aplicații, fluxuri de cercetare sau agenți.
Este o alegere bună pentru dezvoltatorii care construiesc fluxuri AI în jurul datelor web, în special când sarcina de extragere se modifică frecvent sau trebuie să se conecteze la cadre precum LangChain, CrewAI, SDK‑uri, instrumente de linie de comandă sau medii cu MCP. Avantajul cheie este flexibilitatea: logica de extragere poate fi condusă de prompt, nu legată în totalitate de selectori fragili.
Această flexibilitate face ca validarea să fie deosebit de importantă. Echipele ar trebui să definească scheme, comportament de reîncercare, câmpuri de dovezi și reguli de revizuire a eșantioanelor înainte de utilizarea în producție, deoarece un răspuns plauzibil nu este neapărat o extragere completă. ScrapeGraphAI este atractiv pentru experimente și fluxuri adaptive, în timp ce joburile stabile cu volum mare pot beneficia în continuare de selectori deterministici sau de o abordare hibridă care folosește AI doar unde structura paginii variază.
Pro și Contra
- Extragerea în limbaj natural este utilă pentru sarcini în schimbare sau exploratorii
- Ieșirea JSON structurată se potrivește cu aplicațiile AI și fluxurile de automatizare
- Integrările pentru dezvoltatori susțin cazuri de utilizare ale agenților și orchestrării
- Util atunci când mentenanța selectorilor ar încetini experimentarea
- Extragerea AI trebuie validată înainte de utilizarea în producție
- Designul promptului și schemele afectă consistența ieșirii
- Mai puțin potrivit pentru echipe care au nevoie de un flux de lucru complet vizual fără cod
Întrebări frecvente
Ce ca un instrument de web scraping să fie alimentat de AI?
Scraper‑urile alimentate de AI ajută de obicei la una sau mai multe dintre cele patru sarcini: identificarea câmpurilor pe o pagină, transformarea conținutului paginii în date structurate, controlarea unui browser prin instrucțiuni în limbaj natural sau pregătirea conținutului extras pentru sisteme AI. Cele mai bune instrumente au în continuare nevoie de prompturi clare, scheme, validare și reguli privind ce date trebuie colectate.
Care este diferența dintre scraping și automatizarea browserului?
Scraping‑ul se concentrează pe extragerea de date din pagini. Automatizarea browserului controlează un browser pentru a da click, a derula, a se autentifica, a completa formulare, a aștepta conținut dinamic sau a parcurge un flux multi‑pas. Multe instrumente moderne combină ambele, dar distincția contează: o listă statică de produse este o sarcină de scraping, în timp ce un flux care necesită navigare și interacțiune poate necesita automatizare de browser.
Ce format de ieșire este cel mai bun pentru un sistem RAG?
Sistemele de generare augmentată prin recuperare funcționează de obicei cel mai bine cu text curat, Markdown, JSON structurat, metadate și URL‑uri sursă stabile. Scopul nu este doar să colectezi conținut, ci să păstrezi suficientă structură pentru fragmentare, recuperare, citare și verificări de calitate. HTML brut poate fi util, dar adesea creează muncă suplimentară de curățare înainte ca datele să fie utile pentru o aplicație AI.
Pot scraper‑ele AI să gestioneze site‑uri JavaScript?
Mulți pot, dar calitatea depinde de produs. Unele instrumente redau paginile într‑un browser, altele folosesc infrastructură de browser headless, iar altele extrag după ce pagina s‑a încărcat complet. Suportul pentru JavaScript este important pentru ecommerce, piețe, platforme sociale, tablouri de bord și aplicații web moderne în care datele utile apar după răspunsul inițial al paginii.
Sunt scraper‑ele fără cod adecvate pentru proiecte mari?
Scraper‑ele fără cod pot fi excelente pentru fluxuri de lucru de business recurente, monitorizare concurență, cercetare de lead‑uri și sarcini operaționale. Programe mai mari pot necesita în cele din urmă API‑uri, cozi, monitorizare, infrastructură de proxy, control de versiune, validare de date și proprietate tehnică. Cele mai bune instrumente fără cod sunt cele mai puternice când fluxul este clar și echipa vrea viteză fără să construiască un scraper personalizat.
Este legal web scraping‑ul?
Legalitatea web scraping‑ului depinde de jurisdicție, site‑ul țintă, tipul de date, metoda de acces și modul în care datele sunt utilizate. Colectarea de date publice poate ridica în continuare probleme contractuale, de confidențialitate, de proprietate intelectuală, de securitate cibernetică și de politici ale platformei. Echipele ar trebui să revizuiască legile aplicabile, robots.txt și termenele relevante, politicile interne de conformitate și sensibilitatea datelor înainte de a lansa un program de scraping.
Ar trebui validate rezultatele de extragere generate de AI?
Da. AI poate face scraping‑ul mai flexibil, dar poate și să interpreteze greșit pagini, să combine câmpuri, să omită context ascuns sau să returneze structuri inconsistente când layout‑urile se schimbă. Fluxurile de producție ar trebui să includă verificări de schemă, revizuiri de eșantion, alerte de schimbare, gestionare de erori și revizuire umană pentru decizii sensibile.
Gânduri finale despre instrumentele AI de web scraping
Bright Data este cea mai puternică alegere generală pentru echipele care au nevoie de infrastructură serioasă și programe mari de date publice. Firecrawl este cea mai potrivită pentru aplicații AI care necesită context web pregătit pentru LLM, în timp ce Apify oferă dezvoltatorilor o platformă flexibilă pentru scraper‑e personalizate, Actori și automatizare de browser.
Pentru echipele de business, Browse AI și Octoparse fac colectarea recurentă de date mai accesibilă fără a transforma fiecare flux într‑un proiect de inginerie. ScrapingBee este un API puternic pentru dezvoltatori, cu extragere în limbaj natural, redare JavaScript și ieșire structurată, fără a menține infrastructura de browser și proxy.
SearchAPI se remarcă când cerința este date de căutare proaspete și structurate pentru SEO, cercetare sau agenți AI, mai degrabă decât crawling arbitrar de site‑uri. Oxylabs este cel mai bun pentru API‑uri de scraping enterprise și site‑uri publice dificile, Diffbot este convingător când extragerea de entități și contextul Knowledge Graph contează, iar ScrapeGraphAI este o opțiune flexibilă, bazată pe prompt, pentru fluxuri AI.




