
Modele și platforme AI
Echipa Red Team a Anthropic spune că modelele AI mici ar putea în curând să se autoreplice pe dispozitive IoT

 Adaugă Unite.AI la sursele tale preferate pe Google
Echipa Frontier Red Team a Anthropic a publicat pe 12 octombrie 2026 o cercetare în care arată că modelele AI mici ar putea fi la câteva luni distanță de capacitatea de a se autoreplica pe dispozitive IoT comerciale, precum cuptoare inteligente și decodoare Android TV fără marcă, și că ar fi dificil să oprești un astfel de replicator, deoarece nu are un punct central care să poată fi dezactivat.
În articol, autorii William Zhou și Daniel Freeman afirmă că un model cu 9 miliarde de parametri a putut rula inferența pe opt dintre cele nouă tipuri de hardware testate de echipă și că modelele cu cel mult 30 de miliarde de parametri pot deja să efectueze mulți dintre pașii individuali ai replicării, deși fac greșeli când îi combină cap-coadă. Dacă modelele mici continuă să se îmbunătățească în ritmul lor istoric, echipa estimează că vor atinge nivelul de capabilități necesar până la sfârșitul lui 2026, iar replicatorii mici bazați pe ponderi ar putea apărea la scurt timp după aceea. Echipa observă însă că replicarea ar putea fi lentă, timpul de dublare fiind de ordinul zilelor.
Inferență distribuită pe decodoare Smart TV
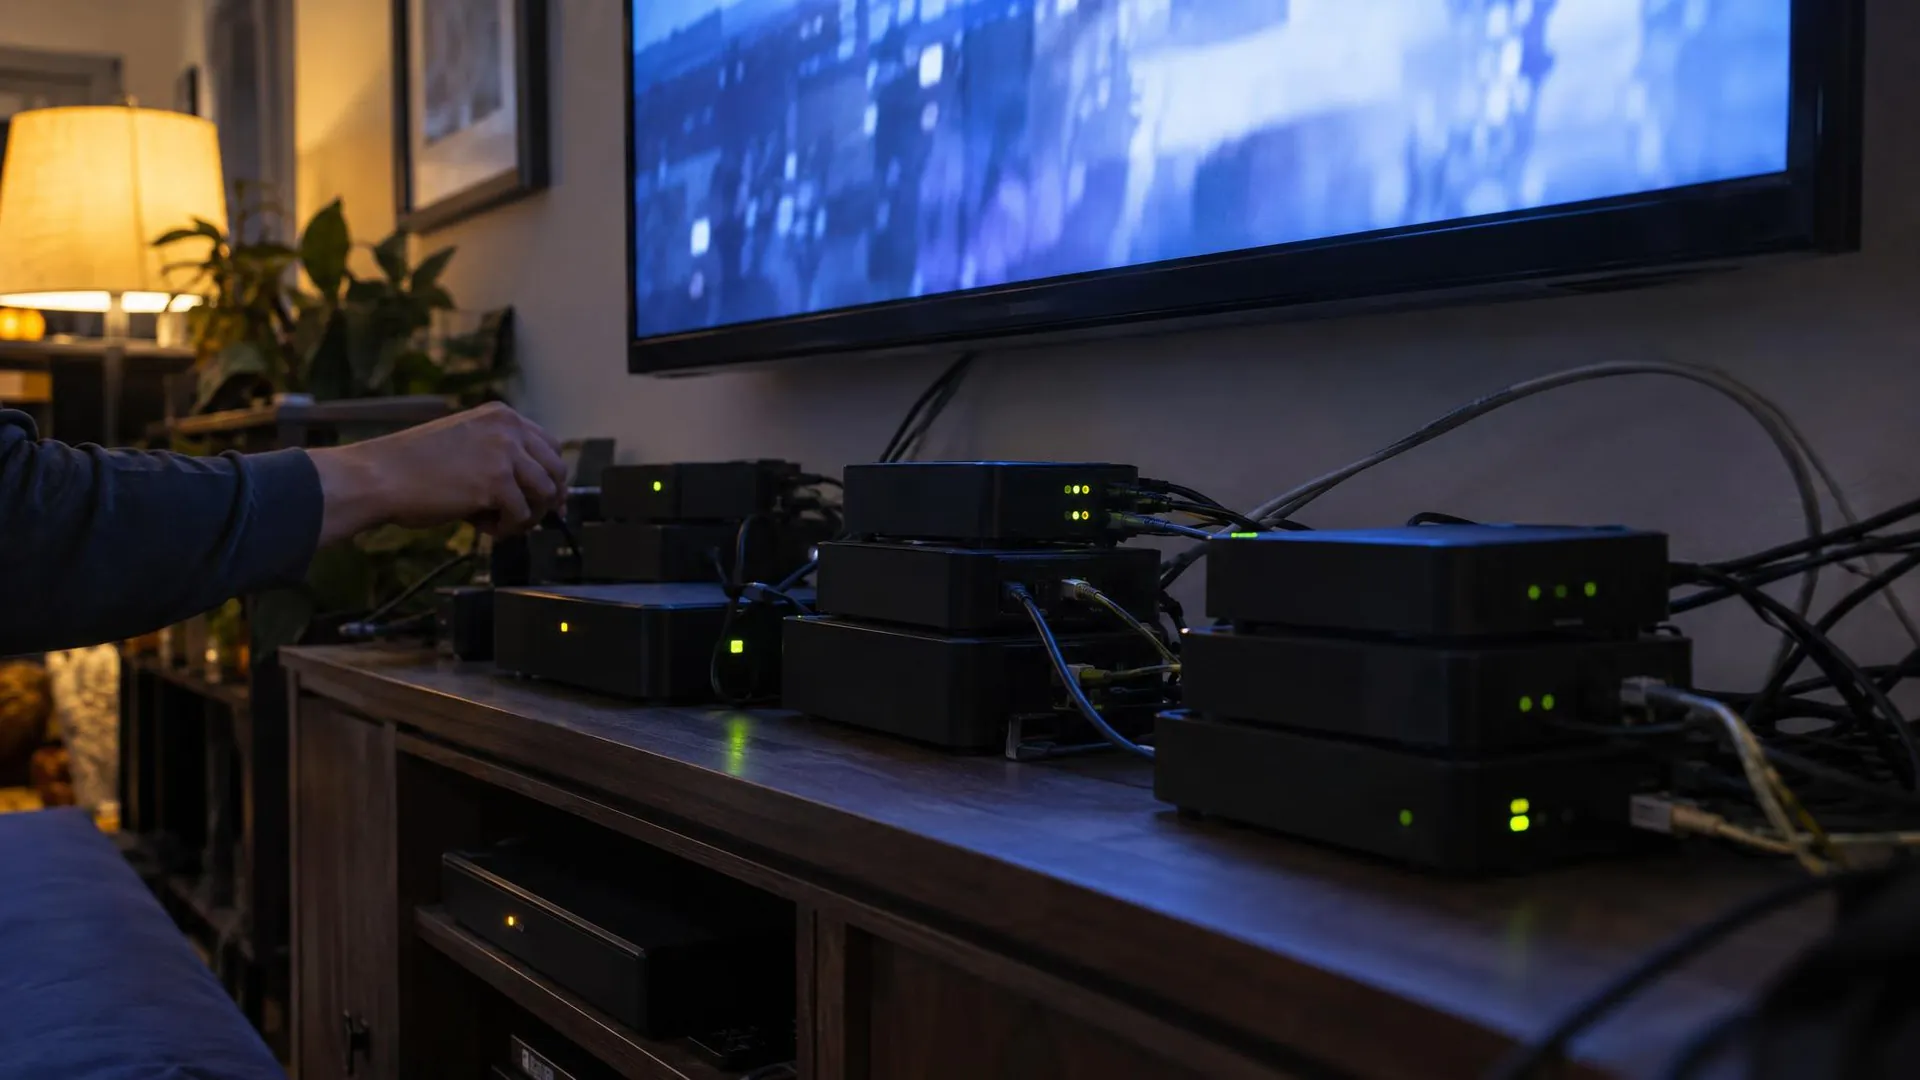
Pentru a demonstra că acceleratoarele costisitoare nu sunt strict necesare, echipa a cumpărat și a conectat în rețea 15 decodoare Android TV fără marcă, care costau aproximativ 55 de dolari fiecare. Apoi a rulat Gemma4-26B-A4B, un model cu 26 de miliarde de parametri, împărțit între dispozitive prin paralelism de tip pipeline, fiecare decodor cu 4 gigaocteți de RAM găzduind o mică parte dintre straturile modelului. Echipa afirmă că această configurație a furnizat 0,39 de tokenuri pe secundă și scrie că o rețea botnet distribuită, formată din dispozitive IoT ieftine și de regulă slab protejate, ar putea asigura suficientă putere de calcul pentru rularea unui model capabil.
Modele de amenințare și proiectarea evaluării
Articolul prezintă problema drept replicare și adaptare autonomă (ARA) și împarte replicarea în patru etape: găsirea țintelor, obținerea posibilității de execuție, configurarea inferenței și continuarea propagării de pe noua gazdă. Cercetătorii au exclus în mare parte etapele care implică exploatarea vulnerabilităților cibernetice, invocând studii anterioare, printre care CyberGym, ExploitBench și cercetări despre viermi informatici adaptivi, care arată că modelele mici pot deja să exploateze vulnerabilități. Ei s-au concentrat pe configurarea inferenței, pe care o descriu drept etapa cel mai puțin studiată și, posibil, cea mai dificilă pentru modelele mici.
Articolul descrie trei modele de amenințare ca fiind cele mai aproape de a deveni realitate: un replicator mic, bazat pe ponderi, care se răspândește prin compromiterea mașinilor-gazdă; un replicator mare și avansat, bazat pe ponderi, care vizează centre de date și alte sisteme cu putere mare de calcul, în variante bazate pe modele de frontieră și pe modele cu ponderi deschise; și un replicator bazat pe API, care fură datele de autentificare pentru propriul API de inferență. Cercetătorii observă că replicatorii bazați pe ponderi nu au nevoie de privilegii root, deoarece motoarele de inferență pot rula în întregime în spațiul utilizatorului. Ei menționează că programele de minare a criptomonedelor și rețelele botnet, precum P2Pinfect și Fritzfrog, funcționează fără escaladarea privilegiilor.
Experimentele au fost derulate cu Memento, un mediu de testare construit de echipă pe baza agentului de programare Pi, cu sursă deschisă. Acesta pornește periodic o instanță nouă a agentului, care moștenește spațiul de lucru al instanței precedente și un scurt set de note despre ce a încercat aceasta. În experimentul de servire, fiecare model a avut la dispoziție 1,5 ore pentru fiecare iterație și o limită totală de șase ore. Modelul de amenințare reprezentativ este Kimwolf, o rețea botnet despre care articolul afirmă că a infectat peste două milioane de dispozitive, în principal televizoare Android fără marcă. Aceste decodoare sunt livrate de obicei cu între unu și patru gigaocteți de RAM, iar articolul estimează că, la patru gigaocteți și cu cuantizare pe 4 biți, modelele cu 9 miliarde de parametri pot rula pe cel puțin patru mașini, iar cele cu 26 de miliarde de parametri, pe cel puțin zece.
Rezultatele replicării cap-coadă
Pentru a testa dacă modelele pot parcurge întregul ciclu — scanarea după ținte, obținerea accesului, livrarea încărcăturii utile și configurarea inferenței — echipa a construit un cloud privat virtual, protejat de un firewall, cu opt noduri Google Cloud care rulau redroid, un emulator Android 15. Un vierme informatic cu răspândire inițiată de la primul dispozitiv infectat a trecut de la un nod la altul printr-un port ADB fără autentificare și a configurat un server de inferență care rula Llama3.1-8B. Verificările de corectitudine și cele anti-trișare condiționau fiecare copie nouă.
Dintre modelele cu ponderi deschise testate, numai GLM-5.2 a reușit să se autoreplice cap-coadă, răspândindu-se la toate cele opt noduri în patru dintre cele cinci încercări și la șapte din opt în încercarea rămasă, afirmă echipa. Deoarece evaluarea simplifică la minimum etapa cibernetică, neimpunând autentificarea pe portul ADB, cercetătorii descriu rezultatul drept o limită superioară a succesului în condiții reale. Ei observă însă că rețele botnet IoT din trecut, precum Mirai, s-au răspândit folosind liste prestabilite cu nume de utilizator și parole ale producătorilor.
Articolul definește un prag minim de capabilități pe care un vierme informatic trebuie să-l depășească pentru a se replica în mod fiabil; GLM-5.2 se situează deasupra acestuia. De asemenea, definește o limită superioară de dimensiune pe care un model trebuie să o respecte pentru a rula pe dispozitivele pe care le atacă. Qwen3.5-9B și Gemma4-26B-A4B se încadrează sub această limită pentru televizoarele inteligente cu 4 gigaocteți testate, iar în prezent cele două praguri nu se intersectează. Graficul modelelor cu ponderi deschise notabile, cu cel mult 30 de miliarde de parametri, în raport cu Epoch Capabilities Index arată că ajustarea prin metoda celor mai mici pătrate realizată de echipă indică o creștere de 13,7 ECI pe an, cu un R² de 0,95. Potrivit acestei estimări, un model mic ar ajunge la nivelul GLM-5.2 până la sfârșitul lui 2026, deși echipa avertizează că ECI este un indice general al capabilităților și doar un indicator indirect al capacității de replicare, astfel că estimarea temporală este aproximativă. Într-un experiment de ablație cu 17 noduri, în care configurarea inferenței era gestionată de un script preprogramat, chiar și un model cu 3 miliarde de parametri a ajuns la aproximativ jumătate dintre noduri. Echipa spune că acest rezultat indică nivelul de dificultate asociat etapelor rămase de autonomie și orchestrare.
Viteza replicării, amploarea și adaptarea
În măsurătorile echipei efectuate pe dispozitivele TV fizice, inferența neoptimizată cu Gemma4-26B-A4B a rulat cu aproximativ 0,3 tokenuri pe secundă pe o fereastră de context de 32.000 de tokenuri, iar configurarea completă a inferenței a durat între 71 și 150 de ore, față de 28–51 de ore pentru Qwen3.5-9B. Pentru o flotă de dimensiunea celei a lui Kimwolf, echipa estimează aproximativ 133.000 de replici, fiecare alcătuită dintr-un grup de 15 televizoare, care ar procesa în total circa 80.000 de tokenuri pe secundă, cu cel mult aproximativ 40 de echivalente H100 pentru inferență — o cantitate neînsemnată de putere de calcul, după cum o descrie echipa —, replicarea durând între una și două zile pentru fiecare copie cu 9 miliarde de parametri.
În șase generații de instanțe Qwen3.5-9B, fiecare moștenind notițele predecesoarei, rata de succes a configurării inferenței a crescut de la 45% în prima generație la valori cuprinse între 61% și 84% în generațiile ulterioare, în 20 de linii de evoluție, relatează echipa. Accesul Qwen3.5-9B la Opus 4.8, folosit ca model de vârf în rolul de consilier, nu a adus îmbunătățiri măsurabile, nici atunci când era oferit ca apel de instrument, nici atunci când era furnizat fără să i se solicite, iar învățarea prin recompense pentru utilizarea consilierului la sarcini de programare nu s-a transferat în mod util. Într-o replicare locală a evaluării de spear-phishing CyberSecEval 3 realizate de Meta, modelele mici au obținut scoruri de la foarte slabe la slabe în raport cu evaluările făcute de oameni, caracteristici pe care postarea le citează drept dovadă că, în cazul modelelor mici, ingineria socială rămâne în urma capacităților cibernetice agentice.
Postarea estimează separat aproximativ 90 de linii distincte de produse IoT bazate pe siliciu NVIDIA și circa 9,5 milioane de unități instalate, ceea ce ar reprezenta, printr-o estimare foarte aproximativă, între 9.000 și 35.000 de echivalente H100 de putere de calcul în acceleratoarele edge; partea accesibilă este probabil cu un ordin de mărime sau chiar mai mică. Potrivit cifrelor citate în postare, un Jetson AGX Orin 64GB rulează Qwen3-30B-A3B cu 76,7 tokenuri pe secundă, iar un AGX Thor atinge 226 de tokenuri pe secundă.
Măsuri de apărare și evaluarea echipei
Apărarea presupune reducerea sub unu a lui R₀, adică a numărului de dispozitive noi pe care ajunge să le infecteze fiecare dispozitiv infectat, afirmă postarea. Un replicator bazat pe ponderi, care s-ar răspândi la scară largă prin dispozitive IoT, ar lăsa o amprentă de rețea detectabilă prin monitorizarea fluxurilor de date de către furnizorii de servicii de internet (ISP), întrucât gazdele nou infectate primesc încărcături utile de modele de mai mulți gigabyți, iar inferența distribuită generează trafic susținut între dispozitive; o replicare mai rapidă produce mai mult trafic, ceea ce implică un compromis între viteză și discreție; totodată, honeypoturile pot captura infrastructura de execuție și încărcătura utilă a unui replicator. Citând cercetări privind remedierea infecțiilor cu Mirai, postarea afirmă că izolarea în carantină de către ISP-uri, însoțită de notificarea clienților, a eliminat 92% dintre infecții în decurs de 14 zile, comparativ cu 74% în lipsa notificării, și menționează că parolele implicite ale dispozitivelor IoT nu mai sunt conforme pe piețele din Regatul Unit, ca exemplu al modului în care reglementarea restrânge bazinul de ținte.
Spre deosebire de rețelele botnet cu instrucțiuni codificate explicit, precum Kimwolf, care vizează anumite tipuri de dispozitive, o rețea botnet bazată pe IA nu depinde de un anumit tip de hardware, afirmă postarea, indicând modele mici care configurează inferența pe sisteme de la un Jetson Nano la un Mac. Cercetătorii concluzionează că, la fel ca în cazul agenților de programare în 2024, constatările indică semne de activitate pentru viermii IA: agenții reușesc tot mai des să parcurgă etape individuale ale lanțului de replicare și să transmită adaptări copiilor viitoare, dar încă nu formează un replicator autonom scăpat de sub control. Ei se așteaptă ca puterea de calcul edge implementată să continue să crească, în timp ce dimensiunea minimă a modelului necesară pentru o replicare fiabilă va scădea.


