

Modele și platforme AI
AniPortrait: Sinteză audio a animației portretului fotorealist

 Adaugă Unite.AI la sursele tale preferate pe Google
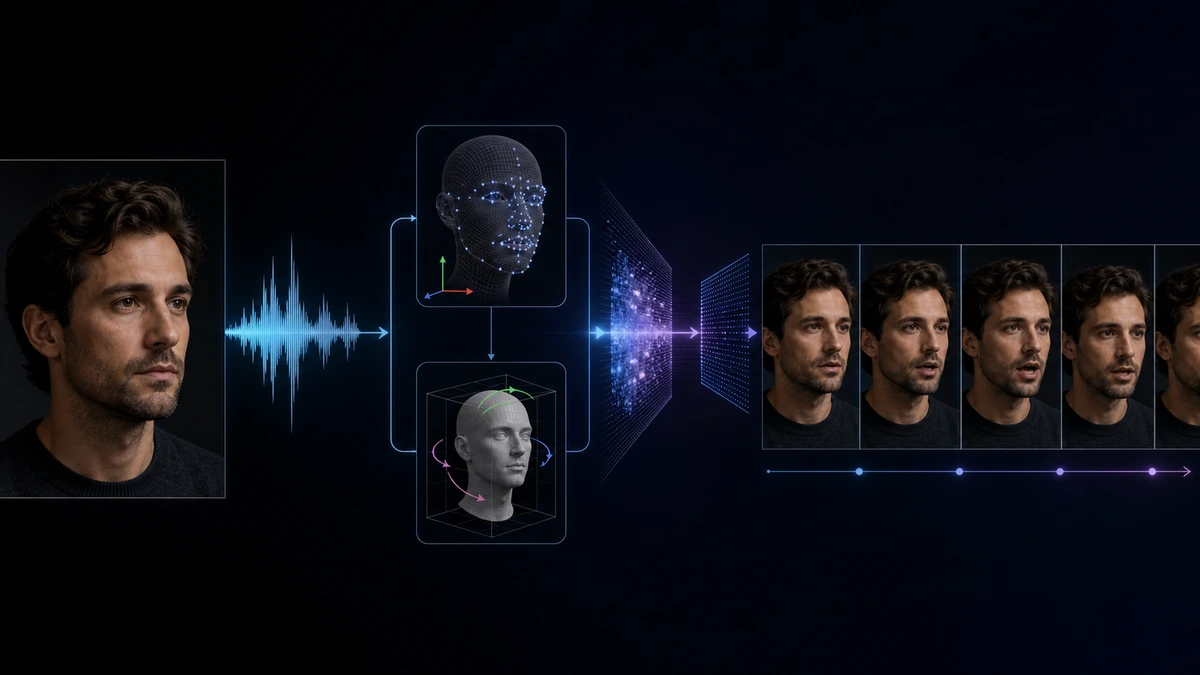
De-a lungul anilor, crearea de animații portret realizate din imagini statice și audio a găsit o varietate de aplicații, inclusiv jocuri, mass-media digitale, realitate virtuală și multe altele. În ciuda potențialului său de aplicare, este încă dificil pentru dezvoltatori să creeze cadre capabile să genereze animații de înaltă calitate care mențin coerența temporală și sunt captivante din punct de vedere vizual. O cauză majoră a complexității este nevoia de coordonare intricată a mișcărilor buzelor, pozițiilor capului și expresiilor faciale pentru a crea un efect vizual captivant.
În acest articol, vom discuta despre AniPortrait, un cadru nou proiectat pentru a genera animații de înaltă calitate conduse de o imagine de portret de referință și un eșantion audio. Funcționarea cadrului AniPortrait este împărțită în două etape. În primul rând, cadrul AniPortrait extrage reprezentări intermediare 3D din eșantioanele audio și le proiectează într-o secvență de repere faciale 2D. În continuare, cadrul utilizează un model de difuzie robust cuplat cu un modul de mișcare pentru a converti secvența de repere în animații temporale coerente și fotorealistice. Rezultatele experimentale demonstrează superioritatea și capacitatea cadrului AniPortrait de a genera animații de înaltă calitate cu calitate vizuală excepțională, diversitate de poziții și naturalitate facială, oferind astfel o experiență perceptuală îmbunătățită și îmbogățită. Mai mult, cadrul AniPortrait are un potențial remarcabil în ceea ce privește controlabilitatea și flexibilitatea și poate fi aplicat eficient în domenii precum reînregistrarea facială, editarea mișcării faciale și multe altele. Acest articol are ca scop să acopere cadrul AniPortrait în profunzime și să explorăm mecanismul, metodologia, arhitectura cadrului, împreună cu comparația cu cadrele de stat de artă. Să începem.
AniPortrait: Animație portret fotorealist
Crearea de animații portret realizate a fost în centrul atenției cercetătorilor de ceva timp, datorită potențialului său incredibil și aplicațiilor care se extind de la mass-media digitale și realitate virtuală la jocuri și multe altele. În ciuda anilor de cercetare și dezvoltare, producerea de animații de înaltă calitate care mențin coerența temporală și sunt captivante din punct de vedere vizual încă prezintă o provocare semnificativă. O barieră majoră pentru dezvoltatori este nevoia de coordonare intricată între pozițiile capului, expresiile vizuale și mișcările buzelor pentru a crea un efect vizual captivant. Metodele existente au eșuat în a aborda aceste provocări, în principal pentru că majoritatea dintre ele se bazează pe generatoare cu capacitate limitată, cum ar fi NeRF, decodoare bazate pe mișcare și GAN pentru crearea de conținut vizual. Aceste rețele au capacități de generalizare limitate și sunt instabile în generarea de conținut de înaltă calitate. Cu toate acestea, apariția recentă a modelelor de difuzie a facilitat generarea de imagini de înaltă calitate, iar unele cadre construite pe baza modelelor de difuzie, împreună cu module temporale, au facilitat crearea de videoclipuri captivante, permițând modelelor de difuzie să exceleze.
Pe baza progreselor modelelor de difuzie, cadrul AniPortrait are ca scop să genereze animații portret de înaltă calitate utilizând o imagine de referință și un eșantion audio. Funcționarea cadrului AniPortrait este împărțită în două etape. În prima etapă, cadrul AniPortrait utilizează modele bazate pe transformatori pentru a extrage o secvență de reprezentări 3D ale feței și poziția capului din intrarea audio și le proiectează ulterior într-o secvență de repere faciale 2D. Prima etapă permite cadrului AniPortrait să capteze mișcările buzelor și expresiile subtile din audio, precum și mișcările capului care se sincronizează cu ritmul eșantionului audio. A doua etapă, cadrul AniPortrait utilizează un model de difuzie robust și îl integrează cu un modul de mișcare pentru a transforma secvența de repere în animații portret fotorealistice și temporale coerente. Mai exact, cadrul AniPortrait se bazează pe arhitectura rețelei existente AnimateAnyone, care utilizează Stable Diffusion 1.5, un model de difuzie extrem de puternic, pentru a genera imagini vii și fluide pe baza unei imagini de referință și a unei secvențe de mișcare a corpului. Ceea ce este demn de remarcat este că cadrul AniPortrait nu utilizează modulul de ghidare a poziției din această rețea, ci îl reproiectează, permițând cadrului AniPortrait să mențină o proiectare ușoară și să arate o precizie îmbunătățită în generarea mișcărilor buzelor.
Rezultatele experimentale demonstrează superioritatea cadrului AniPortrait în crearea de animații cu o calitate vizuală excepțională, o diversitate de poziții și o naturalitate facială. Prin utilizarea reprezentărilor 3D ale feței ca caracteristici intermediare, cadrul AniPortrait câștigă flexibilitatea de a modifica aceste reprezentări în funcție de necesitățile sale. Adaptabilitatea îmbunătățește semnificativ aplicabilitatea cadrului AniPortrait în domenii precum reînregistrarea facială și editarea mișcării faciale.
AniPortrait: Funcționare și Metodologie
Cadrul AniPortrait propus este alcătuit din două module, și anume Lmk2Video și Audio2Lmk. Modulul Audio2Lmk încearcă să extragă o secvență de repere care capturează mișcările intricate ale buzelor și expresiile faciale din intrarea audio, în timp ce modulul Lmk2Video utilizează această secvență de repere pentru a genera videoclipuri portret de înaltă calitate cu stabilitate temporală. Următoarea figură prezintă o vedere de ansamblu a funcționării cadrului AniPortrait. Așa cum se poate observa, cadrul AniPortrait extrage mai întâi reprezentarea 3D a feței și poziția capului din audio și le proiectează ulterior în puncte cheie 2D. În a doua etapă, cadrul utilizează un model de difuzie pentru a transforma punctele cheie 2D într-un videoclip portret cu două etape antrenate concomitent în rețea.

Audio2Lmk
Pentru o secvență dată de fragmente de vorbire, obiectivul principal al cadrului AniPortrait este de a prezice secvența corespunzătoare de reprezentări 3D ale feței cu reprezentări vectoriale de translație și rotație. Cadrul AniPortrait utilizează metoda preantrenată wav2vec pentru a extrage caracteristici audio și modelul prezintă o capacitate de generalizare ridicată, fiind capabil să recunoască intonația și pronunția din audio cu acuratețe, ceea ce joacă un rol crucial în generarea de animații faciale realiste. Prin utilizarea caracteristicilor audio robuste obținute, cadrul AniPortrait este capabil să utilizeze eficient o arhitectură simplă alcătuită din două straturi fc pentru a converti aceste caracteristici în reprezentări 3D ale feței. Cadrul AniPortrait observă că acest design simplu implementat de model nu numai că îmbunătățește eficiența procesului de inferență, ci și asigură acuratețe. Atunci când se convertește audio în poziție, cadrul AniPortrait utilizează aceeași rețea wav2vec ca backbone, deși modelul nu împărtășește greutățile cu modulul audio la mesh. Acest lucru se datorează faptului că poziția este asociată mai mult cu tonul și ritmul prezent în audio, care are un accent diferit în comparație cu sarcinile audio la mesh. Pentru a ține cont de impactul stărilor anterioare, cadrul AniPortrait utilizează un decodator de transformator pentru a decoda secvența de poziție. În timpul acestui proces, cadrul integrează caracteristicile audio în decodator utilizând mecanisme de atenție încrucișată și, pentru ambele module, cadrul le antrenează utilizând pierderea L1. Odată ce modelul obține secvența de poziție și mesh, acesta utilizează proiecția perspectivă pentru a transforma aceste secvențe într-o secvență 2D de repere faciale, care sunt ulterior utilizate ca semnale de intrare pentru etapa următoare.
Lmk2Video
Pentru o imagine de portret de referință și o secvență de repere faciale, modulul Lmk2Video propus creează o animație portret temporally coerentă, care se aliniază cu mișcarea secvenței de repere și menține o apariție care este în concordanță cu imaginea de referință, iar în final, cadrul reprezintă animația portretului ca o secvență de cadre portret. Proiectarea structurii rețelei Lmk2Video se inspiră din cadrul AnimateAnyone existent. Cadrul AniPortrait utilizează un model de difuzie stabil 1.5, un model de difuzie extrem de puternic, ca backbone și încorporează un modul de mișcare temporală care convertește eficient intrările de zgomot multi-cadru într-o secvență de cadre video. În același timp, un component de rețea ReferencenNet reflectă structura modelului de difuzie stabil 1.5 și îl utilizează pentru a extrage informațiile de apariție din imaginea de referință și le integrează în backbone. Proiectarea strategică asigură că identitatea facială rămâne consistentă pe tot parcursul videoclipului de ieșire. Diferențiindu-se de cadrul AnimateAnyone, cadrul AniPortrait îmbunătățește complexitatea proiectării ghidului de poziție. Versiunea originală a cadrului AnimateAnyone conține doar câteva straturi de convoluție după care caracteristicile reperelor se combină cu latenții la intrarea stratului backbone. Cadrul AniPortrait descoperă că proiectarea este lipsită de capacitatea de a capta mișcările intricate ale buzelor și, pentru a aborda această problemă, cadrul adoptă strategia multi-scară a arhitecturii ConvNet și încorporează caracteristici de repere de scară corespunzătoare în blocuri diferite ale backbone-ului. Mai mult, cadrul AniPortrait introduce o îmbunătățire suplimentară prin includerea reperelor imaginii de referință ca intrare suplimentară. Modulul de atenție încrucișată al componentei PoseGuider facilitează interacțiunea dintre reperele țintă ale fiecărui cadru și reperele de referință. Acest proces oferă rețelei informații suplimentare pentru a înțelege corelația dintre apariție și repere faciale, ajutând astfel la generarea de animații portret cu mișcări mai precise.
AniPortrait: Implementare și Rezultat
Pentru etapa Audio2Lmk, cadrul AniPortrait adoptă componenta wav2vec2.0 ca backbone și utilizează arhitectura MediaPipe pentru a extrage mesh-uri 3D și poziții 6D pentru annotări. Modelul utilizează datele de antrenare pentru componenta Audio2Mesh dintr-o bază de date internă care conține aproximativ 60 de minute de date audio de înaltă calitate, provenite de la un singur vorbitor. Pentru a asigura stabilitatea mesh-ului 3D extras de componenta MediaPipe, actorul vocal este instruit să se uite la cameră și să mențină o poziție stabilă a capului pe tot parcursul procesului de înregistrare. Pentru modulul Lmk2Video, cadrul AniPortrait implementează o abordare de antrenare în două etape. În prima etapă, cadrul se concentrează pe antrenarea rețelei ReferenceNet și a modulului PoseGuider, componenta 2D a backbone-ului, și lasă deoparte modulul de mișcare. În a doua etapă, cadrul AniPortrait îngheță toate celelalte componente și se concentrează pe antrenarea modulului de mișcare. Pentru această etapă, cadrul utilizează două seturi de date video faciale de înaltă calitate și le prelucrează utilizând componenta MediaPipe pentru a extrage repere faciale 2D. Mai mult, pentru a îmbunătăți sensibilitatea rețelei față de mișcările buzelor, modelul AniPortrait diferențiază buzele superioare și inferioare cu culori distincte atunci când renderizează imaginea poziției din repere 2D.
Așa cum se demonstrează în imaginea de mai jos, cadrul AniPortrait generează o serie de animații care demonstrează o calitate superioară și realism.

Cadrul AniPortrait utilizează apoi o reprezentare 3D intermediară care poate fi editată pentru a manipula ieșirea în funcție de necesitățile sale. De exemplu, utilizatorii pot extrage repere de la o sursă anume și altera identitatea, permițând astfel cadrului AniPortrait să creeze un efect de reînregistrare facială.
Gânduri finale
În acest articol, am discutat despre AniPortrait, un cadru nou proiectat pentru a genera animații de înaltă calitate conduse de o imagine de portret de referință și un eșantion audio. Prin simpla introducere a unei imagini de referință și a unui fragment audio, cadrul AniPortrait este capabil să genereze un videoclip portret care prezintă mișcări naturale ale capului și mișcări fluide ale buzelor. Prin utilizarea capacităților robuste de generalizare ale modelului de difuzie, cadrul AniPortrait generează animații care prezintă o calitate vizuală realistă și mișcări vii. Funcționarea cadrului AniPortrait este împărțită în două etape. În primul rând, cadrul AniPortrait extrage reprezentări intermediare 3D din eșantioanele audio și le proiectează într-o secvență de repere faciale 2D. În continuare, cadrul utilizează un model de difuzie robust cuplat cu un modul de mișcare pentru a converti secvența de repere în animații temporale coerente și fotorealistice. Rezultatele experimentale demonstrează superioritatea și capacitatea cadrului AniPortrait de a genera animații de înaltă calitate cu calitate vizuală excepțională, diversitate de poziții și naturalitate facială, oferind astfel o experiență perceptuală îmbunătățită și îmbogățită. Mai mult, cadrul AniPortrait are un potențial remarcabil în ceea ce privește controlabilitatea și flexibilitatea și poate fi aplicat eficient în domenii precum reînregistrarea facială, editarea mișcării faciale și multe altele.


