
AI-basisprincipes
Wat is crossvalidatie? Hoe modelprestaties betrouwbaar schatten
Cross‑validatie roteert herhaaldelijk de achtergehouden folds zodat teams de prestaties en variabiliteit kunnen schatten wanneer één validatiesplit onstabiel zou zijn. Deze gids legt het mechanisme, de afwegingen, evaluatie en controles uit die in de praktijk van belang zijn.

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
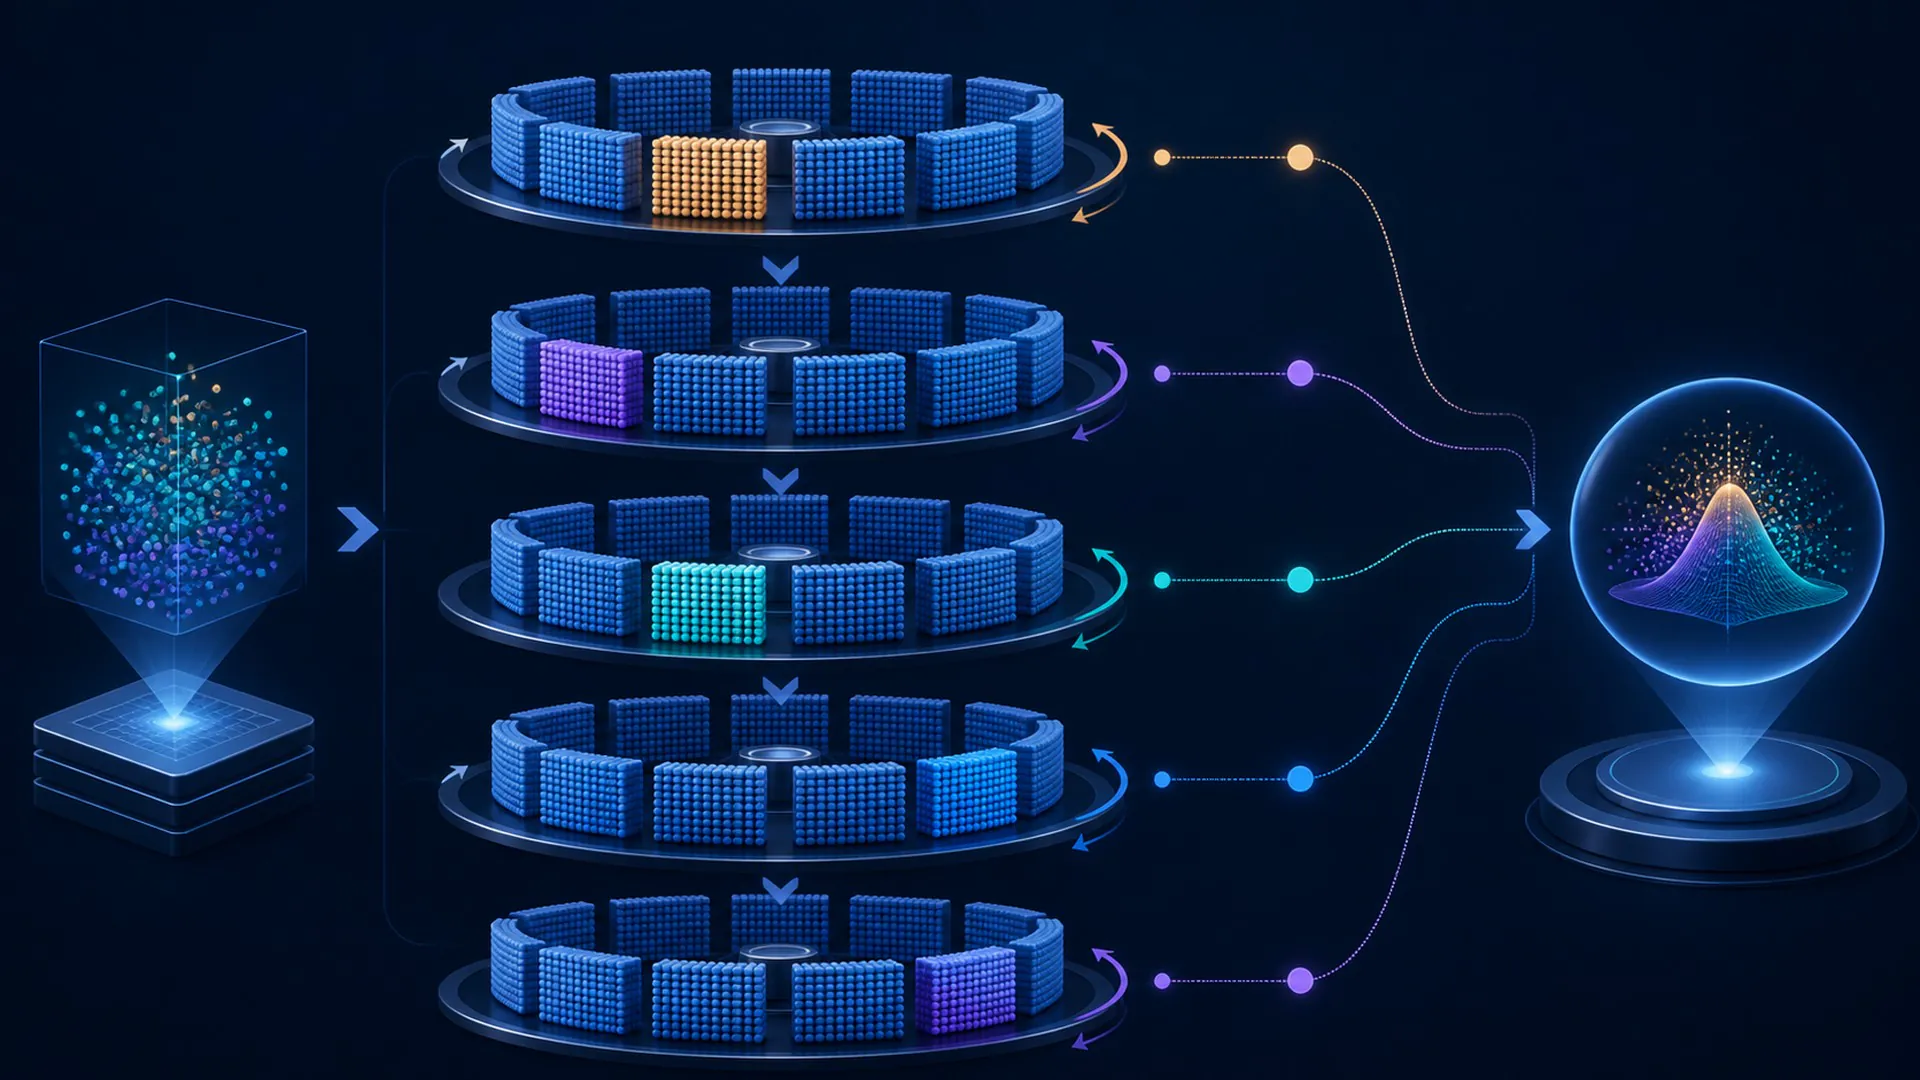
Crossvalidatie roteert herhaaldelijk de achtergehouden vouwen zodat teams de prestatie en variabiliteit kunnen inschatten wanneer één validatiesplit onstabiel zou zijn.
Crossvalidatie verdient een nauwkeurige uitleg omdat de naam een specifieke informatiestroom, trainingskeuze, runtime‑mechanisme of governance‑grens aangeeft. Het behandelen als een synoniem voor “geavanceerde AI” maakt beweringen onmogelijk te testen. Deze gids volgt het concept vanaf de invoer en aannames tot het waarneembare resultaat, en test vervolgens de afkorting die het vaakst ermee wordt verward.
Crossvalidatie: definitie, grens en doel
Crossvalidatie roteert herhaaldelijk de achtergehouden vouwen zodat teams de prestatie en variabiliteit kunnen inschatten wanneer één validatiesplit onstabiel zou zijn. De definitie bevat drie praktische verplichtingen: er is een identificeerbare invoer, een transformatie of beslissing die kenmerkend is voor crossvalidatie, en een uitkomst die kan worden geëvalueerd ten opzichte van een vastgesteld doel. Als een van deze elementen ontbreekt, kan het label een aspiratie beschrijven in plaats van een geïmplementeerd mechanisme.
Statistisch leren zet eindige steekproeven om in beweringen over toekomstige data. Splitsen, optimaliseren, regulariseren, metriek en monitoring zijn daarom onderdelen van één generalisatieprobleem in plaats van geïsoleerde lesboektechnieken. Voor crossvalidatie is dit systeemzicht belangrijk omdat de prestatie kan worden bepaald door de omringende data, interfaces, hardware, permissies en mensen, zelfs wanneer het onderliggende model ongewijzigd blijft. Een nuttige uitleg scheidt daarom het geleerde gedrag van het model van het product dat beslist wanneer, waar en met welke autoriteit dat gedrag wordt gebruikt.
De meest verwarrende afkorting is het testen van vele modellen op de uiteindelijke testset. Het kan een zichtbaar kenmerk delen met crossvalidatie, maar het verandert het causale verhaal: ander bewijs zou succes aantonen, andere middelen zouden de kosten domineren, en andere controles zouden schade voorkomen. De grens is daarom operationeel in plaats van terminologisch.
Een operationele kaart met vijf fasen voor crossvalidatie
Het diagram is een compacte causale kaart voor crossvalidatie, geen bewering dat elke implementatie vijf softwarecomponenten gebruikt. Sommige systemen combineren fasen en andere herhalen ze in een lus. De kaart blijft nuttig omdat hij elke wijziging in informatie of autoriteit dwingt een eigenaar, een invoer, een uitvoer en een test te hebben.
1. Data verdelen in geschikte vouwen: invoer en aannames bij crossvalidatie
In deze fase van crossvalidatie moet het systeem data verdelen in geschikte vouwen. De nuttige vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke status het wijzigt en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van het testen van vele modellen op de uiteindelijke testset en het resultaat onder dezelfde gestelde voorwaarden kunnen reproduceren.
De overdracht naar deze crossvalidatiefase begint met het gestelde doel en moet eindigen met een resultaat dat training op alle behalve één vouw kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, middelengebruik en eventuele menselijke of softwarecontrole vast die op de grens wordt toegepast. Die trace is waar teams kunnen detecteren of gewone willekeurige vouwen ongeldig zijn wanneer data tijds-, groeps- of ruimtelijke afhankelijkheid vertoont, voordat dezelfde zwakte een consequentiale output bereikt.
2. Train op alle behalve één vouw: representatie of beslissing bij crossvalidatie
In deze fase van crossvalidatie moet het systeem trainen op alle behalve één vouw. De nuttige vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke status het wijzigt en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van het testen van vele modellen op de uiteindelijke testset en het resultaat onder dezelfde gestelde voorwaarden kunnen reproduceren.
De overdracht naar deze crossvalidatiefase begint met het verdelen van data in geschikte vouwen en moet eindigen met een resultaat dat evaluatie op de achtergehouden vouw kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, middelengebruik en eventuele menselijke of softwarecontrole vast die op de grens wordt toegepast. Die trace is waar teams kunnen detecteren of gewone willekeurige vouwen ongeldig zijn wanneer data tijds-, groeps- of ruimtelijke afhankelijkheid vertoont, voordat dezelfde zwakte een consequentiale output bereikt.
3. Evalueren op de achtergehouden vouw: onderscheidende transformatie in Crossvalidatie
In deze fase van Crossvalidatie moet het systeem evalueren op de achtergehouden vouw. De nuttige vraag is niet alleen of die handeling plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt, en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet in staat zijn de handeling te onderscheiden van het testen van vele modellen op de uiteindelijke testset en het resultaat onder dezelfde gestelde voorwaarden te reproduceren.
De overdracht naar deze fase van Crossvalidatie begint met trainen op alle vouwen behalve één en moet eindigen met een resultaat dat kan ondersteunen roteren totdat elke vouw als validatie heeft gediend. Leg onzekerheid, verworpen alternatieven, resourcegebruik en eventuele menselijke of softwarematige controle vast die op de grens wordt toegepast. Die trace is waar teams kunnen detecteren of gewone willekeurige vouwen ongeldig zijn wanneer gegevens tijds-, groeps- of ruimtelijke afhankelijkheid vertonen, voordat dezelfde zwakte een consequentiale output bereikt.
4. Roterende totdat elke vouw als validatie heeft gediend: beperking en verificatiegrens in Crossvalidatie
In deze fase van Crossvalidatie moet het systeem roteren totdat elke vouw als validatie heeft gediend. De nuttige vraag is niet alleen of die handeling plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt, en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet in staat zijn de handeling te onderscheiden van het testen van vele modellen op de uiteindelijke testset en het resultaat onder dezelfde gestelde voorwaarden te reproduceren.
De overdracht naar deze fase van Crossvalidatie begint met evalueren op de achtergehouden vouw en moet eindigen met een resultaat dat kan ondersteunen het aggregeren van scores en variatie. Leg onzekerheid, verworpen alternatieven, resourcegebruik en eventuele menselijke of softwarematige controle vast die op de grens wordt toegepast. Die trace is waar teams kunnen detecteren of gewone willekeurige vouwen ongeldig zijn wanneer gegevens tijds-, groeps- of ruimtelijke afhankelijkheid vertonen, voordat dezelfde zwakte een consequentiale output bereikt.
5. Scores en variatie aggregeren: output, feedback en stopregel in Crossvalidatie
In deze fase van Crossvalidatie moet het systeem scores en variatie aggregeren. De nuttige vraag is niet alleen of die handeling plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt, en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet in staat zijn de handeling te onderscheiden van het testen van vele modellen op de uiteindelijke testset en het resultaat onder dezelfde gestelde voorwaarden te reproduceren.
De overdracht naar deze fase van Crossvalidatie begint met roteren totdat elke vouw als validatie heeft gediend en moet eindigen met een resultaat dat kan ondersteunen monitoring of een definitieve beslissing. Leg onzekerheid, verworpen alternatieven, resourcegebruik en eventuele menselijke of softwarematige controle vast die op de grens wordt toegepast. Die trace is waar teams kunnen detecteren of gewone willekeurige vouwen ongeldig zijn wanneer gegevens tijds-, groeps- of ruimtelijke afhankelijkheid vertonen, voordat dezelfde zwakte een consequentiale output bereikt.
Lees de Crossvalidatiekaart vooruit om productie te begrijpen en achteruit om falen te diagnosticeren. Voorwaartse analyse vraagt hoe de ene fase de volgende voorziet. Achterwaartse analyse start vanuit een onjuist, traag, duur of onveilig resultaat en traceert welke eerdere aanname het mogelijk maakte. Het omgekeerde pad is vaak waar een team ontdekt dat de doorslaggevende fout zich voordeed voordat het model iets produceerde.
Een uitgewerkt Crossvalidatie‑voorbeeld
Een kleine medische dataset kan gegroepeerde vouwen gebruiken zodat de dossiers van elke patiënt bij elkaar blijven.
Dit voorbeeld is leerzaam omdat Crossvalidatie kan worden gekoppeld aan waarneembare inputs, tussenliggende toestanden en een uitkomst, in plaats van beoordeeld te worden via een gepolijste demonstratie. Een rigoureuze test zou gewone, moeilijke en opzettelijk misleidende gevallen rond het scenario opbouwen, een basislijn zonder de techniek behouden, en zowel de gemiddelde prestatie als de ernst van individuele fouten vastleggen.
Verander één aanname in het Crossvalidatie‑voorbeeld en herhaal de analyse. Verwijder een vereiste input, introduceer een tegenstrijdig signaal, beperk de rekencapaciteit, wijzig de gebruikerspopulatie, of dwing het systeem tot onthouding. Een mechanisme dat alleen slaagt onder één zorgvuldig gearrangeerde demonstratie heeft niet aangetoond dat het generaliseert naar de operationele omgeving.
Crossvalidatie versus de meest voorkomende shortcut
Crossvalidatie wordt vaak gereduceerd tot het testen van vele modellen op de uiteindelijke testset. Die reductie verwijdert de grens die het concept definieert. Het kan kopers doen vergelijkingen maken tussen ongelijksoortige producten, onderzoekers laten overdrijven wat een experiment aantoont, en operators laten het verkeerde signaal monitoren na de uitrol.
| Lens | Praktisch antwoord |
|---|---|
| Definitie | Cross-validatie roteert herhaaldelijk weggelaten vouwen zodat teams de prestatie en variabiliteit kunnen schatten wanneer één validatiesplit onstabiel zou zijn. |
| Verwarring | veel modellen testen op de uiteindelijke testset. |
| Risico | gewone willekeurige vouwen zijn ongeldig wanneer data tijd-, groeps- of ruimtelijke afhankelijkheid heeft. |
De vergelijking moet ook de analyseeenheid identificeren. Een artikel over cross-validatie kan een model of algoritme isoleren, terwijl een uitgerolde service ophalen, routeren, cachen, beleid, identiteit, gebruikersinterfaces en monitoring toevoegt. Twee producten kunnen dezelfde kopterm gebruiken terwijl ze verschillende delen van die stack implementeren. Vraag welke component de bepalende transformatie uitvoert en welke andere componenten nodig zijn voor het gerapporteerde resultaat.
Waarom cross-validatie belangrijk is in huidige AI-systemen
Cross-validatie is nu belangrijk omdat AI-systemen grotere contexten, meer modaliteiten, meer runtime-rekenkracht, bredere tooltoegang en diepere verbindingen met organisatorische beslissingen krijgen. Onder die omstandigheden kan wat vroeger als een onderzoeksdetail leek, de latentie, beveiliging, toegankelijkheid, milieukosten, productkwaliteit of juridische aansprakelijkheid bepalen.
De relevante maatstaf is niet of cross-validatie één indrukwekkend resultaat kan opleveren. Het gaat erom of de techniek een uitkomst verbetert die van belang is onder representatieve omstandigheden en dat doet effectiever dan een eenvoudigere basislijn. Rapporteer distributies, faalcategorieën, tail‑latentie, hulpbronnengebruik en getroffen subgroepen in plaats van elk resultaat te comprimeren tot één gemiddelde.
Kies procedures op basis van de structuur van de data en de besliskosten. Behoud groepen en tijd, kwantificeer onzekerheid, inspecteer segmenten, vergrendel definitieve tests en verifieer dat offline‑voordelen de implementatie overleven. Toegepast specifiek op cross-validatie maakt die discipline het bewijs draagbaar: een ander team kan beoordelen of de geclaimde winst waarschijnlijk een ander model, taal, hardwareplatform, dataset, gebruikerspopulatie of risicotolerantie zal overleven.
Voordelen die cross-validatie kan leveren
De sterkste reden om cross-validatie te gebruiken is dat het de beoogde knelpunt direct kan aanpakken. Afhankelijk van de implementatie kan het voordeel zich uiten als betere onderbouwing, een getrouwere representatie, verbeterde generalisatie, lagere latentie, minder geheugenverplaatsing, duidelijkere verantwoording, of een veiligere grens tussen een modelvoorstel en een reële actie.
Voordelen moeten worden uitgedrukt als beslissingen en metingen. “Intelligenter” is geen acceptatiecriterium voor cross-validatie. Een nuttig doel kan de foutpercentage op moeilijke gevallen specificeren, herstel na tegenstrijdig bewijs, kosten op een percentiel van het verkeer, tijd voor menselijke beoordeling, kalibratie, of het percentage acties dat binnen een gedefinieerde autoriteitslimiet blijft.
De faalmodus die cross-validatie definieert
De centrale beperking is dat gewone willekeurige vouwen ongeldig zijn wanneer data tijd-, groeps- of ruimtelijke afhankelijkheid heeft. Deze fout is geen nagedachte die pas aan het einde van de ontwikkeling wordt opgesomd. Ze moet vanaf het begin de dataverzameling, architectuur, permissies, evaluatie, releasepoorten en monitoring voor cross-validatie vormgeven.
Een controle voor cross-validatie is alleen nuttig als deze optreedt vóór een dure of onomkeerbare consequentie. Identificeer de vroegste waarneembare voorbode van de fout, stel een drempel of regel in, wijs een verantwoordelijke toe, en test herstel. Afhankelijk van het gebruiksscenario kan herstel betekenen: zich onthouden, terugvallen op een eenvoudiger systeem, meer bewijs vragen, escaleren naar een persoon, een model terugrollen, of een actie volledig stoppen.
Een evaluatieplan voor cross-validatie
Begin de evaluatie van cross‑validatie door de beslissing te formuleren die het bewijs moet ondersteunen. Definieer de operationele populatie, de consequentie van een verkeerd resultaat, de informatie die daadwerkelijk beschikbaar is op het moment van de beslissing, en het eenvoudigste geloofwaardige alternatief. Dit voorkomt dat een benchmark het doel wordt alleen omdat deze gemakkelijk uit te voeren is.
Gebruik een onaangeraakte testset voor gecontroleerde vergelijkingen en valideer vervolgens cross‑validatie in een gefaseerde operationele omgeving. Offline evaluatie maakt varianten vergelijkbaar; shadow‑mode, canaries, rate limits of goedkeuringspoorten laten zien hoe echt verkeer, feedbackloops en mensen gedrag veranderen. De implementatiefase moet een expliciete stopconditie hebben in plaats van aan te nemen dat elke verbetering een volledige uitrol verdient.
Versieer de inputs die nodig zijn om cross‑validatie te reproduceren: brongegevens, preprocessing, tokenizer of encoder, modelgewichten, configuratie, prompt of beleid, retrieval‑index, evaluatieset, hardware‑aannames en servicecode waar van toepassing. Zonder lineage kan een team niet bepalen of een gewijzigd resultaat voortkomt uit de techniek, de omgeving of een onopgemerkte wijziging in de pijplijn.
Vraag tenslotte welke bevinding de bewering dat cross‑validatie helpt zou falsificeren. Als geen enkel resultaat de adoptiebeslissing kan omkeren, is de evaluatie marketing. Vooraf vastgestelde acceptatiedrempels en een bewaarde bevestigingsset maken van de oefening bewijs.
Vragen om te stellen vóór het adopteren van cross‑validatie
- Doel: Welke meetbare knelpunt is cross‑validatie bedoeld op te lossen?
- Mechanisme: Welke van de vijf fasen bevat de onderscheidende transformatie?
- Basislijn: Hoe verhoudt het zich tot het testen van veel modellen op de uiteindelijke testset of tot een ander, eenvoudiger alternatief?
- Bewijs: Welke gewone, moeilijke, adversariële en subgroep‑gevallen werden getest?
- Operaties: Welke latentie-, geheugen-, rek-, energie‑, onderhouds‑ en beoordelingskosten verschijnen op schaal?
- Risico: Hoe zal het team detecteren dat gewone willekeurige folds ongeldig zijn wanneer gegevens tijds-, groeps- of ruimtelijke afhankelijkheid hebben?
- Herstel: Kan het systeem zich onthouden, terugvallen, terugrollen of escaleren vóór schade?
Primaire bronnen voor het bestuderen van cross‑validatie
Autoritatieve startpunten voor het deel van de AI‑stack rond cross‑validatie omvatten scikit-learn modelselectiegids, Google Rules of ML, NIST AI RMF. Lees ze naast de documentatie voor het exacte model, de dataset, hardware en jurisdictie die betrokken zijn. Een algemene bron kan het mechanisme definiëren, maar alleen implementatiespecifiek bewijs kan aantonen dat een bepaalde implementatie geschikt is.
Wat te onthouden over cross‑validatie
Cross‑validatie is een gedefinieerd mechanisme binnen een groter sociotechnisch systeem. De waarde ervan komt voort uit het verbeteren van een specifiek resultaat onder expliciete voorwaarden, niet uit het label zelf. De vijf‑fasenkaart maakt de informatiestroom zichtbaar, de vergelijking identificeert wat het niet is, en het controlepad toont waar een verantwoordelijke operator kan ingrijpen.
De praktische regel voor cross‑validatie is het definiëren van het doel, vergelijken met een geloofwaardige basislijn, de fout testen die het meest telt, en het bewijsmateriaal behouden dat nodig is om veranderingen te monitoren. Met die elementen op hun plaats wordt het concept een engineering‑ en governance‑keuze die geëvalueerd kan worden. Zonder deze blijft het een veelbelovende naam gekoppeld aan een onbekend operationeel risico.


