
AI-basisprincipes
Wat zijn visueel-taalmodellen (VLM’s)? Hoe AI afbeeldingen en woorden met elkaar verbindt
Beeld-taalmodellen verbinden visuele kenmerken met taal, zodat een systeem afbeeldingen met woorden kan beschrijven, vergelijken, doorzoeken of erover kan redeneren. Deze gids legt uit hoe ze werken en bespreekt de afwegingen, evaluatie en beheersmaatregelen die er in de praktijk toe doen.

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
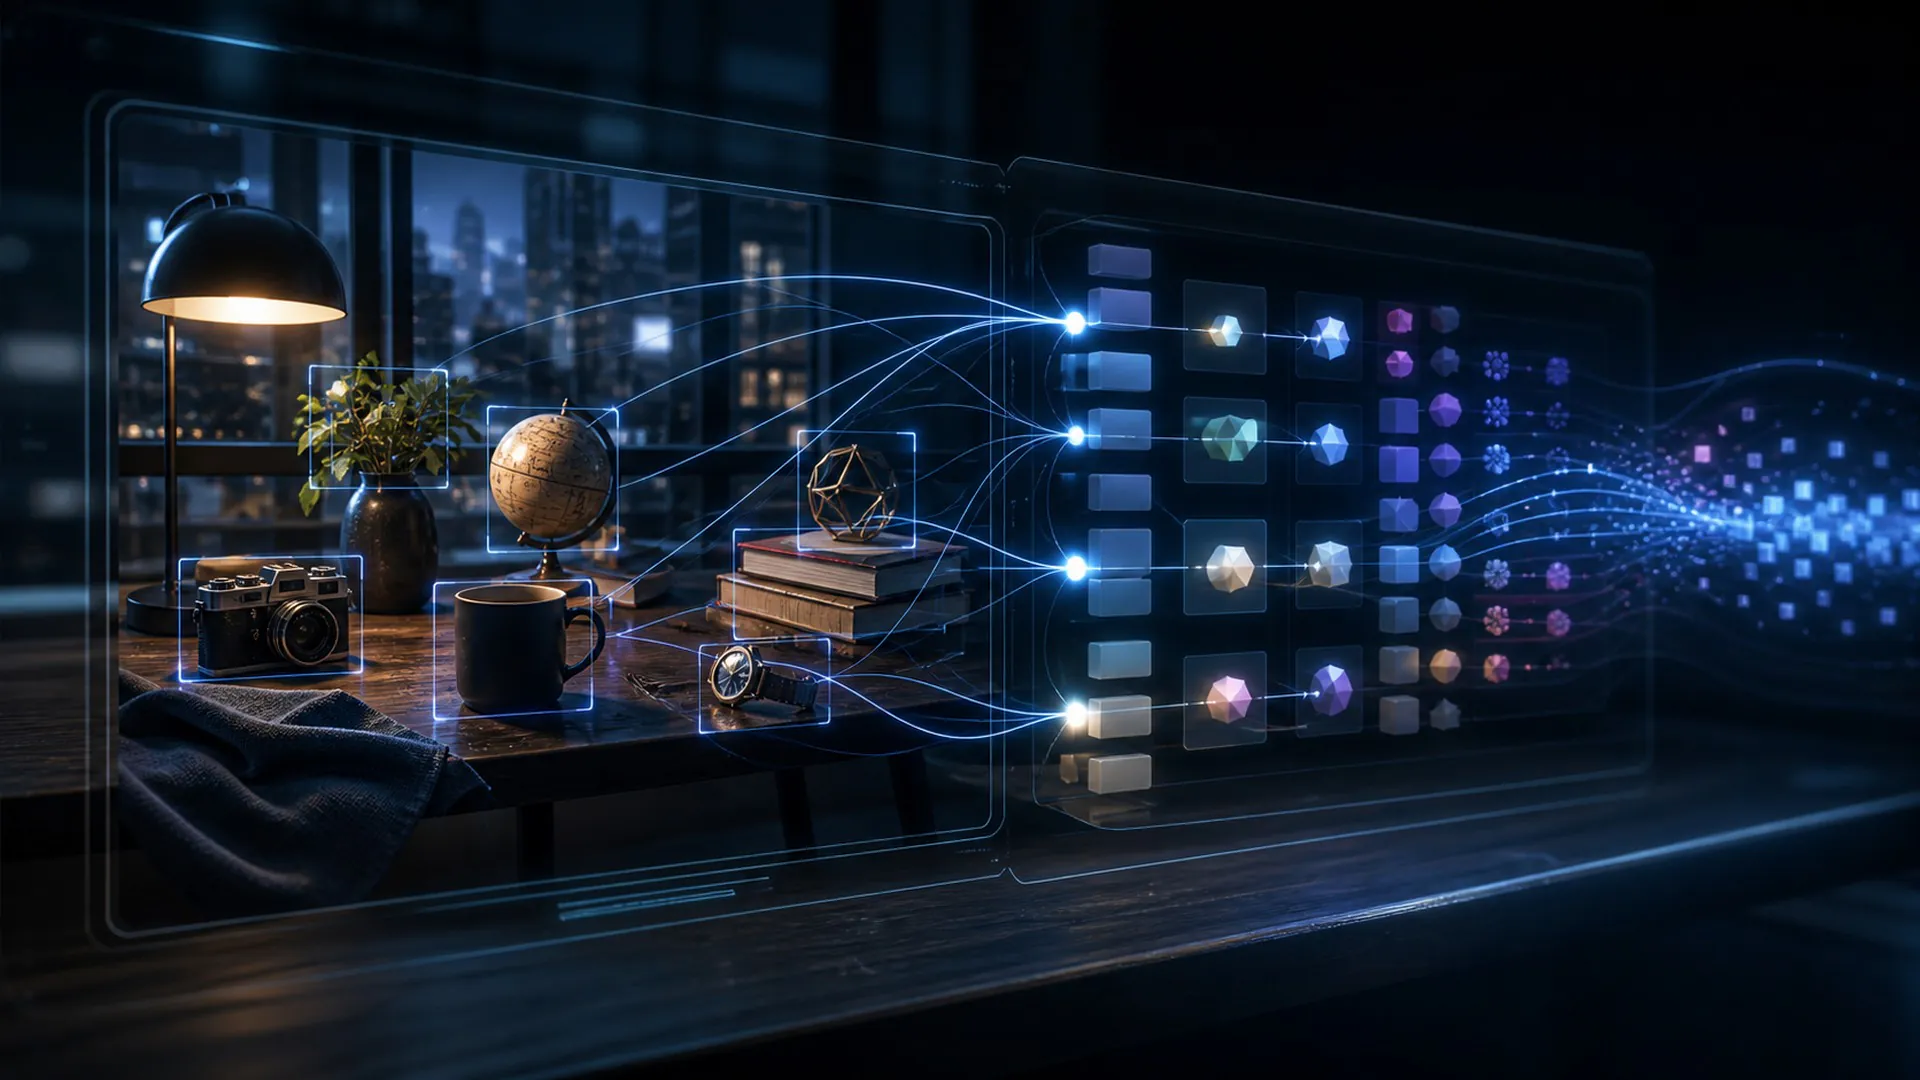
Visueel-taalmodellen verbinden visuele kenmerken met taal, zodat een systeem afbeeldingen met woorden kan beschrijven, vergelijken en ophalen, of erover kan redeneren.
Visueel-taalmodellen verdienen een nauwkeurige uitleg, omdat de naam verwijst naar een specifieke informatiestroom, trainingskeuze, werking tijdens gebruik of grens voor de aansturing. Wie de term als synoniem voor ‘geavanceerde AI’ gebruikt, doet beweringen die onmogelijk te toetsen zijn. Deze gids volgt het concept vanaf de invoer en de aannames tot aan het waarneembare resultaat en toetst vervolgens de simplificatie waarmee het waarschijnlijk het vaakst wordt verward.
Visueel-taalmodellen: definitie, afbakening en doel
Visueel-taalmodellen verbinden visuele kenmerken met taal, zodat een systeem afbeeldingen met woorden kan beschrijven, vergelijken en ophalen, of erover kan redeneren. De definitie omvat drie praktische vereisten: er is een herkenbare invoer, een transformatie of beslissing die kenmerkend is voor visueel-taalmodellen, en een uitkomst die kan worden beoordeeld aan de hand van een vooraf vastgesteld doel. Ontbreekt een van die elementen, dan kan de term eerder een ambitie beschrijven dan een geïmplementeerd mechanisme.
Multimodale systemen moeten signalen op elkaar afstemmen die verschillen in resolutie, timing, ruis en ambiguïteit. Een woord kan verwijzen naar een klein deel van een afbeelding; een audiofragment kan voorafgaan aan het videobeeld dat het verklaart. Bij visueel-taalmodellen is deze systeembenadering belangrijk, omdat de prestaties kunnen afhangen van de omringende data, interfaces, hardware, machtigingen en mensen, zelfs als het onderliggende model ongewijzigd blijft. Een goede uitleg maakt daarom onderscheid tussen het aangeleerde gedrag van het model en het product dat bepaalt wanneer, waar en met welke bevoegdheden dat gedrag wordt ingezet.
De meest voor de hand liggende misleidende simplificatie is computer vision die een vaste classificatie voorspelt zonder gebruik van open taal. Die kan een zichtbaar kenmerk delen met visueel-taalmodellen, maar verandert wel de causale verklaring: voor succes is ander bewijs nodig, andere middelen zijn bepalend voor de kosten en andere maatregelen moeten schade voorkomen. De grens is dus operationeel, niet terminologisch.
Een operationeel overzicht van visueel-taalmodellen in vijf fasen
Het diagram is een beknopte causale weergave van visueel-taalmodellen, geen bewering dat elke implementatie uit vijf softwarecomponenten bestaat. Sommige systemen combineren fasen, terwijl andere ze in een lus herhalen. Het overzicht blijft nuttig, omdat het ervoor zorgt dat elke verandering in informatie of bevoegdheid een verantwoordelijke, een invoer, een uitvoer en een toets heeft.
1. De afbeelding opdelen of coderen in visuele tokens: invoer en aannames bij visueel-taalmodellen
In deze fase van visueel-taalmodellen moet het systeem de afbeelding opdelen of coderen in visuele tokens. De nuttige vraag is niet alleen of die bewerking plaatsvindt, maar ook welke informatie ervoor wordt gebruikt, welke toestand erdoor verandert en welk bewijs aantoont dat die verandering geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van computer vision die een vaste classificatie voorspelt zonder gebruik van open taal, en het resultaat onder dezelfde vastgelegde omstandigheden kunnen reproduceren.
De overdracht naar deze fase van visueel-taalmodellen begint met het vastgestelde doel en moet eindigen met een resultaat dat het coderen van de bijbehorende tekst kan ondersteunen. Leg onzekerheden, verworpen alternatieven, het gebruik van middelen en alle menselijke of softwarematige controles bij deze grens vast. Aan de hand van dat spoor kunnen teams vaststellen of vloeiende beschrijvingen objecten of verbanden benoemen die in werkelijkheid niet zichtbaar zijn, voordat dezelfde zwakte tot een ingrijpende uitkomst leidt.
2. De bijbehorende tekst coderen: representatie of beslissing bij visueel-taalmodellen
In deze fase van visueel-taalmodellen moet het systeem de bijbehorende tekst coderen. De nuttige vraag is niet alleen of die bewerking plaatsvindt, maar ook welke informatie ervoor wordt gebruikt, welke toestand erdoor verandert en welk bewijs aantoont dat die verandering geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van computer vision die een vaste classificatie voorspelt zonder gebruik van open taal, en het resultaat onder dezelfde vastgelegde omstandigheden kunnen reproduceren.
De overdracht naar deze fase van visie-taalmodellen begint met het opdelen van de afbeelding of het coderen ervan in visuele tokens en moet eindigen met een resultaat dat beide representaties met elkaar kan verbinden. Leg onzekerheden, verworpen alternatieven, het gebruik van middelen en alle menselijke of softwarematige sturing op dit overgangspunt vast. Aan de hand van dat spoor kunnen teams nagaan of vloeiende beschrijvingen objecten of relaties benoemen die niet echt zichtbaar zijn, voordat diezelfde zwakte tot uiting komt in een resultaat met grote gevolgen.
3. Beide representaties met elkaar verbinden: de onderscheidende transformatie in visie-taalmodellen
In deze fase van visie-taalmodellen moet het systeem beide representaties met elkaar verbinden. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar ook welke informatie ervoor wordt gebruikt, welke toestand erdoor verandert en welk bewijs aantoont dat die verandering geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van computervisie die een vast label voorspelt zonder gebruik van open taal, en het resultaat onder dezelfde aangegeven omstandigheden kunnen reproduceren.
De overdracht naar deze fase van visie-taalmodellen begint met het coderen van de bijbehorende tekst en moet eindigen met een resultaat dat aandacht voor regio’s en zinsdelen mogelijk maakt. Leg onzekerheden, verworpen alternatieven, het gebruik van middelen en alle menselijke of softwarematige sturing op dit overgangspunt vast. Aan de hand van dat spoor kunnen teams nagaan of vloeiende beschrijvingen objecten of relaties benoemen die niet echt zichtbaar zijn, voordat diezelfde zwakte tot uiting komt in een resultaat met grote gevolgen.
4. Aandacht voor regio’s en zinsdelen: de grens voor beperking en verificatie in visie-taalmodellen
In deze fase van visie-taalmodellen moet het systeem aandacht hebben voor regio’s en zinsdelen. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar ook welke informatie ervoor wordt gebruikt, welke toestand erdoor verandert en welk bewijs aantoont dat die verandering geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van computervisie die een vast label voorspelt zonder gebruik van open taal, en het resultaat onder dezelfde aangegeven omstandigheden kunnen reproduceren.
De overdracht naar deze fase van visie-taalmodellen begint met het verbinden van beide representaties en moet eindigen met een resultaat dat een verankerd antwoord of een verankerde handeling kan opleveren. Leg onzekerheden, verworpen alternatieven, het gebruik van middelen en alle menselijke of softwarematige sturing op dit overgangspunt vast. Aan de hand van dat spoor kunnen teams nagaan of vloeiende beschrijvingen objecten of relaties benoemen die niet echt zichtbaar zijn, voordat diezelfde zwakte tot uiting komt in een resultaat met grote gevolgen.
5. Een verankerd antwoord of een verankerde handeling genereren: uitvoer, feedback en stopregel in visie-taalmodellen
In deze fase van visie-taalmodellen moet het systeem een verankerd antwoord of een verankerde handeling genereren. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar ook welke informatie ervoor wordt gebruikt, welke toestand erdoor verandert en welk bewijs aantoont dat die verandering geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van computervisie die een vast label voorspelt zonder gebruik van open taal, en het resultaat onder dezelfde aangegeven omstandigheden kunnen reproduceren.
De overdracht naar deze fase van visie-taalmodellen begint met aandacht voor regio’s en zinsdelen en moet eindigen met een resultaat dat monitoring of een definitieve beslissing mogelijk maakt. Leg onzekerheden, verworpen alternatieven, het gebruik van middelen en alle menselijke of softwarematige sturing op dit overgangspunt vast. Aan de hand van dat spoor kunnen teams nagaan of vloeiende beschrijvingen objecten of relaties benoemen die niet echt zichtbaar zijn, voordat diezelfde zwakte tot uiting komt in een resultaat met grote gevolgen.
Lees de kaart van visie-taalmodellen vooruit om de werking in productie te begrijpen, en achteruit om fouten op te sporen. Bij een voorwaartse analyse kijk je hoe de ene fase input levert voor de volgende. Een achterwaartse analyse begint bij een onjuist, traag, duur of onveilig resultaat en traceert welke eerdere aanname dat mogelijk maakte. Vaak ontdekt een team juist via die omgekeerde route dat de beslissende fout al was gemaakt voordat het model iets produceerde.
Een uitgewerkt voorbeeld van visie-taalmodellen
Een VLM kan een schermafbeelding van een dashboard bekijken en uitleggen welke grafiek een schriftelijke bewering ondersteunt.
Dit voorbeeld is informatief omdat visie-taalmodellen kunnen worden gekoppeld aan waarneembare input, tussenliggende toestanden en een uitkomst, in plaats van te worden beoordeeld aan de hand van een gepolijste demonstratie. Voor een grondige test zouden rond dit scenario alledaagse, moeilijke en bewust misleidende gevallen moeten worden opgebouwd, een uitgangssituatie zonder de techniek moeten worden vastgelegd en zowel de gemiddelde prestaties als de ernst van afzonderlijke fouten moeten worden bijgehouden.
Verander één aanname in het voorbeeld van visie-taalmodellen en herhaal de analyse. Verwijder een vereiste input, introduceer een tegenstrijdig signaal, beperk de beschikbare rekenkracht, verander de gebruikersgroep of dwing het systeem zich van een antwoord te onthouden. Een mechanisme dat alleen slaagt bij één zorgvuldig samengestelde demonstratie heeft niet aangetoond dat het generaliseert naar de gebruiksomgeving.
Visie-taalmodellen tegenover de meest voorkomende vereenvoudiging
Visie-taalmodellen worden vaak gereduceerd tot computervisie die een vast label voorspelt zonder gebruik van open taal. Door die vereenvoudiging verdwijnt juist de grens die het concept definieert. Daardoor kunnen kopers producten vergelijken die niet vergelijkbaar zijn, kunnen onderzoekers de betekenis van een experiment overdrijven en kunnen operators na implementatie het verkeerde signaal monitoren.
| Invalshoek | Praktisch antwoord |
|---|---|
| Definitie | Visie-taalmodellen koppelen visuele kenmerken aan taal, zodat een systeem afbeeldingen met woorden kan beschrijven, vergelijken en doorzoeken, of erover kan redeneren. |
| Verwarring | computervisie die een vast label voorspelt zonder open taalgebruik. |
| Risico | vloeiende beschrijvingen kunnen objecten of relaties benoemen die in werkelijkheid niet zichtbaar zijn. |
Bij de vergelijking moet ook de analyseeenheid worden vermeld. Een artikel over visie-taalmodellen kan zich beperken tot een model of algoritme, terwijl een geïmplementeerde dienst ook retrieval, routering, caching, beleid, identiteitsbeheer, gebruikersinterfaces en monitoring omvat. Twee producten kunnen dezelfde term in hun kop gebruiken, maar verschillende onderdelen van die keten implementeren. Vraag welke component de bepalende transformatie uitvoert en welke andere componenten nodig zijn voor het gerapporteerde resultaat.
Waarom visie-taalmodellen ertoe doen in de huidige AI-systemen
Visie-taalmodellen zijn nu belangrijk omdat AI-systemen grotere contexten, meer modaliteiten, meer rekenkracht tijdens uitvoering, ruimere toegang tot tools en nauwere verbindingen met organisatorische besluitvorming krijgen. In zulke omstandigheden kan iets wat ooit een onderzoeksdetail leek, bepalend zijn voor de latentie, beveiliging, toegankelijkheid, milieukosten, productkwaliteit of juridische aansprakelijkheid.
De relevante maatstaf is niet of visie-taalmodellen één indrukwekkend resultaat kunnen opleveren. Het gaat erom of de techniek een belangrijk resultaat verbetert onder representatieve omstandigheden en dat doeltreffender doet dan een eenvoudigere referentiemethode. Rapporteer verdelingen, foutcategorieën, latentie in de staart van de verdeling, middelengebruik en getroffen subgroepen, in plaats van alle resultaten samen te vatten in één gemiddelde.
Bij evaluatie moet elke modaliteit afzonderlijk worden onderzocht, moeten tegenstrijdige inputs worden getest en moet worden nagegaan of de temporele of ruimtelijke verankering klopt. Een vloeiend antwoord dat verschillende modaliteiten combineert, bewijst niet dat het model het juiste signaal heeft verwerkt. Door deze aanpak specifiek toe te passen op visie-taalmodellen, wordt het bewijs overdraagbaar: een ander team kan beoordelen of de geclaimde verbetering waarschijnlijk standhoudt bij een ander model, een andere taal, een ander hardwareplatform, een andere dataset, een andere gebruikersgroep of een andere risicotolerantie.
Voordelen die visie-taalmodellen kunnen bieden
De belangrijkste reden om visie-taalmodellen te gebruiken, is dat ze het beoogde knelpunt rechtstreeks kunnen aanpakken. Afhankelijk van de implementatie kan het voordeel bestaan uit een betere verankering, een getrouwere representatie, betere generalisatie, lagere latentie, minder gegevensverplaatsing, duidelijkere verantwoording of een veiligere scheiding tussen een voorstel van een model en een daadwerkelijke handeling.
Druk voordelen uit in termen van beslissingen en meetwaarden. ‘Intelligenter’ is geen acceptatiecriterium voor visie-taalmodellen. Een bruikbaar doel kan bijvoorbeeld het foutenpercentage bij moeilijke gevallen specificeren, het herstel na tegenstrijdig bewijs, de kosten bij een bepaald percentiel van het verkeer, de tijd die menselijke controle kost, de kalibratie of het percentage handelingen dat binnen een vastgestelde bevoegdheidslimiet blijft.
De faalwijze die visie-taalmodellen kenmerkt
De belangrijkste beperking is dat vloeiende beschrijvingen objecten of relaties kunnen benoemen die in werkelijkheid niet zichtbaar zijn. Deze fout is geen bijzaak die pas na afloop van de ontwikkeling op een lijstje thuishoort. Ze moet vanaf het begin richting geven aan de gegevensverzameling, architectuur, machtigingen, evaluatie, vrijgavecriteria en monitoring van visie-taalmodellen.
Een beheersmaatregel voor beeld-taalmodellen is alleen nuttig als die ingrijpt voordat er een kostbaar of onomkeerbaar gevolg optreedt. Breng de vroegste waarneembare voorbode van de fout in kaart, stel een drempelwaarde of regel vast, wijs een verantwoordelijke aan en test hoe herstel verloopt. Afhankelijk van de toepassing kan herstel betekenen dat het systeem geen antwoord geeft, terugvalt op een eenvoudiger systeem, om meer bewijs vraagt, de kwestie voorlegt aan een persoon, een model terugdraait of een actie helemaal stopzet.
Een evaluatieplan voor beeld-taalmodellen
Begin de evaluatie van beeld-taalmodellen met het formuleren van de beslissing die het bewijs moet ondersteunen. Bepaal de populatie waarop het systeem wordt ingezet, de gevolgen van een onjuist resultaat, welke informatie op het beslismoment daadwerkelijk beschikbaar is en wat het eenvoudigste geloofwaardige alternatief is. Zo voorkom je dat een benchmark het doel op zich wordt, alleen omdat die gemakkelijk uit te voeren is.
Gebruik voor gecontroleerde vergelijkingen een onaangeroerde testset en valideer beeld-taalmodellen vervolgens in een gefaseerde gebruiksomgeving. Offline-evaluatie maakt varianten vergelijkbaar; een schaduwmodus, canary-uitrol, snelheidslimieten of goedkeuringspoorten laten zien hoe echt verkeer, terugkoppellussen en mensen het gedrag veranderen. De implementatiefase moet een expliciete stopvoorwaarde hebben, in plaats van ervan uit te gaan dat elke verbetering een volledige uitrol rechtvaardigt.
Leg de versies vast van de invoer en onderdelen die nodig zijn om beeld-taalmodellen te reproduceren: brongegevens, voorbewerking, tokenizer of encoder, modelgewichten, configuratie, prompt of beleid, ophaalindex, evaluatieset, hardwareaannames en code voor de modelbediening, voor zover van toepassing. Zonder een herleidbare geschiedenis kan een team niet vaststellen of een gewijzigd resultaat voortkwam uit de techniek, de omgeving of een onopgemerkte wijziging in de verwerkingsketen.
Vraag ten slotte welke bevinding de bewering zou weerleggen dat beeld-taalmodellen helpen. Als geen enkel resultaat aanleiding kan geven om de beslissing tot invoering te herzien, is de evaluatie marketing. Vooraf vastgelegde acceptatiedrempels en een bewaarde bevestigingsset maken van de evaluatie een oefening die bewijs oplevert.
Vragen die je moet stellen voordat je beeld-taalmodellen invoert
- Doel: Welk meetbaar knelpunt moeten beeld-taalmodellen oplossen?
- Werking: In welke van de vijf fasen vindt de onderscheidende transformatie plaats?
- Uitgangspunt: Hoe verhoudt het systeem zich tot computervisie die een vast label voorspelt zonder open taalgebruik, of tot een ander eenvoudiger alternatief?
- Bewijs: Welke alledaagse, moeilijke, vijandige en subgroepgevallen zijn getest?
- Bedrijfsvoering: Welke kosten voor vertraging, geheugen, rekenkracht, energie, onderhoud en beoordeling ontstaan op grote schaal?
- Risico: Hoe stelt het team vast dat vloeiende beschrijvingen objecten of relaties kunnen benoemen die in werkelijkheid niet zichtbaar zijn?
- Herstel: Kan het systeem geen antwoord geven, terugvallen op een alternatief, worden teruggedraaid of de kwestie voorleggen voordat er schade ontstaat?
Primaire bronnen voor onderzoek naar beeld-taalmodellen
Gezaghebbende startpunten voor het deel van de AI-stack rond beeld-taalmodellen zijn onder meer het CLIP-onderzoeksartikel en het belichaamde multimodale model PaLM-E. Lees deze naast de documentatie bij het exacte model, de dataset, de hardware en het rechtsgebied in kwestie. Een algemene bron kan de werking uiteenzetten, maar alleen bewijs uit de specifieke implementatie kan aantonen dat een bepaalde uitvoering geschikt is.
Wat je moet onthouden over beeld-taalmodellen
Beeld-taalmodellen vormen een afgebakend mechanisme binnen een groter sociotechnisch systeem. Hun waarde ligt in het verbeteren van een specifieke uitkomst onder expliciete voorwaarden, niet in het label zelf. Het overzicht van de vijf fasen maakt de informatiestroom inzichtelijk, de vergelijking laat zien wat ze niet zijn en het beheerspad toont waar een verantwoordelijke operator kan ingrijpen.
De praktische regel voor beeld-taalmodellen is: definieer het doel, vergelijk het systeem met een geloofwaardig uitgangspunt, test de belangrijkste fout en bewaar het bewijs dat nodig is om veranderingen te monitoren. Met die onderdelen wordt het concept een keuze op het gebied van techniek en governance die kan worden geëvalueerd. Zonder die onderdelen blijft het een veelbelovende naam waaraan een onbekend operationeel risico kleeft.


