
AI-basisprincipes
Wat zijn AI-guardrails? Hoe productiesystemen modelgedrag beheersen
AI guardrails zijn gelaagde technische en procedurele controles die inputs, acties, outputs en escalatie rond een model of agent beperken. Deze gids legt het mechanisme, de afwegingen, evaluatie en controles uit die in de praktijk van belang zijn.

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
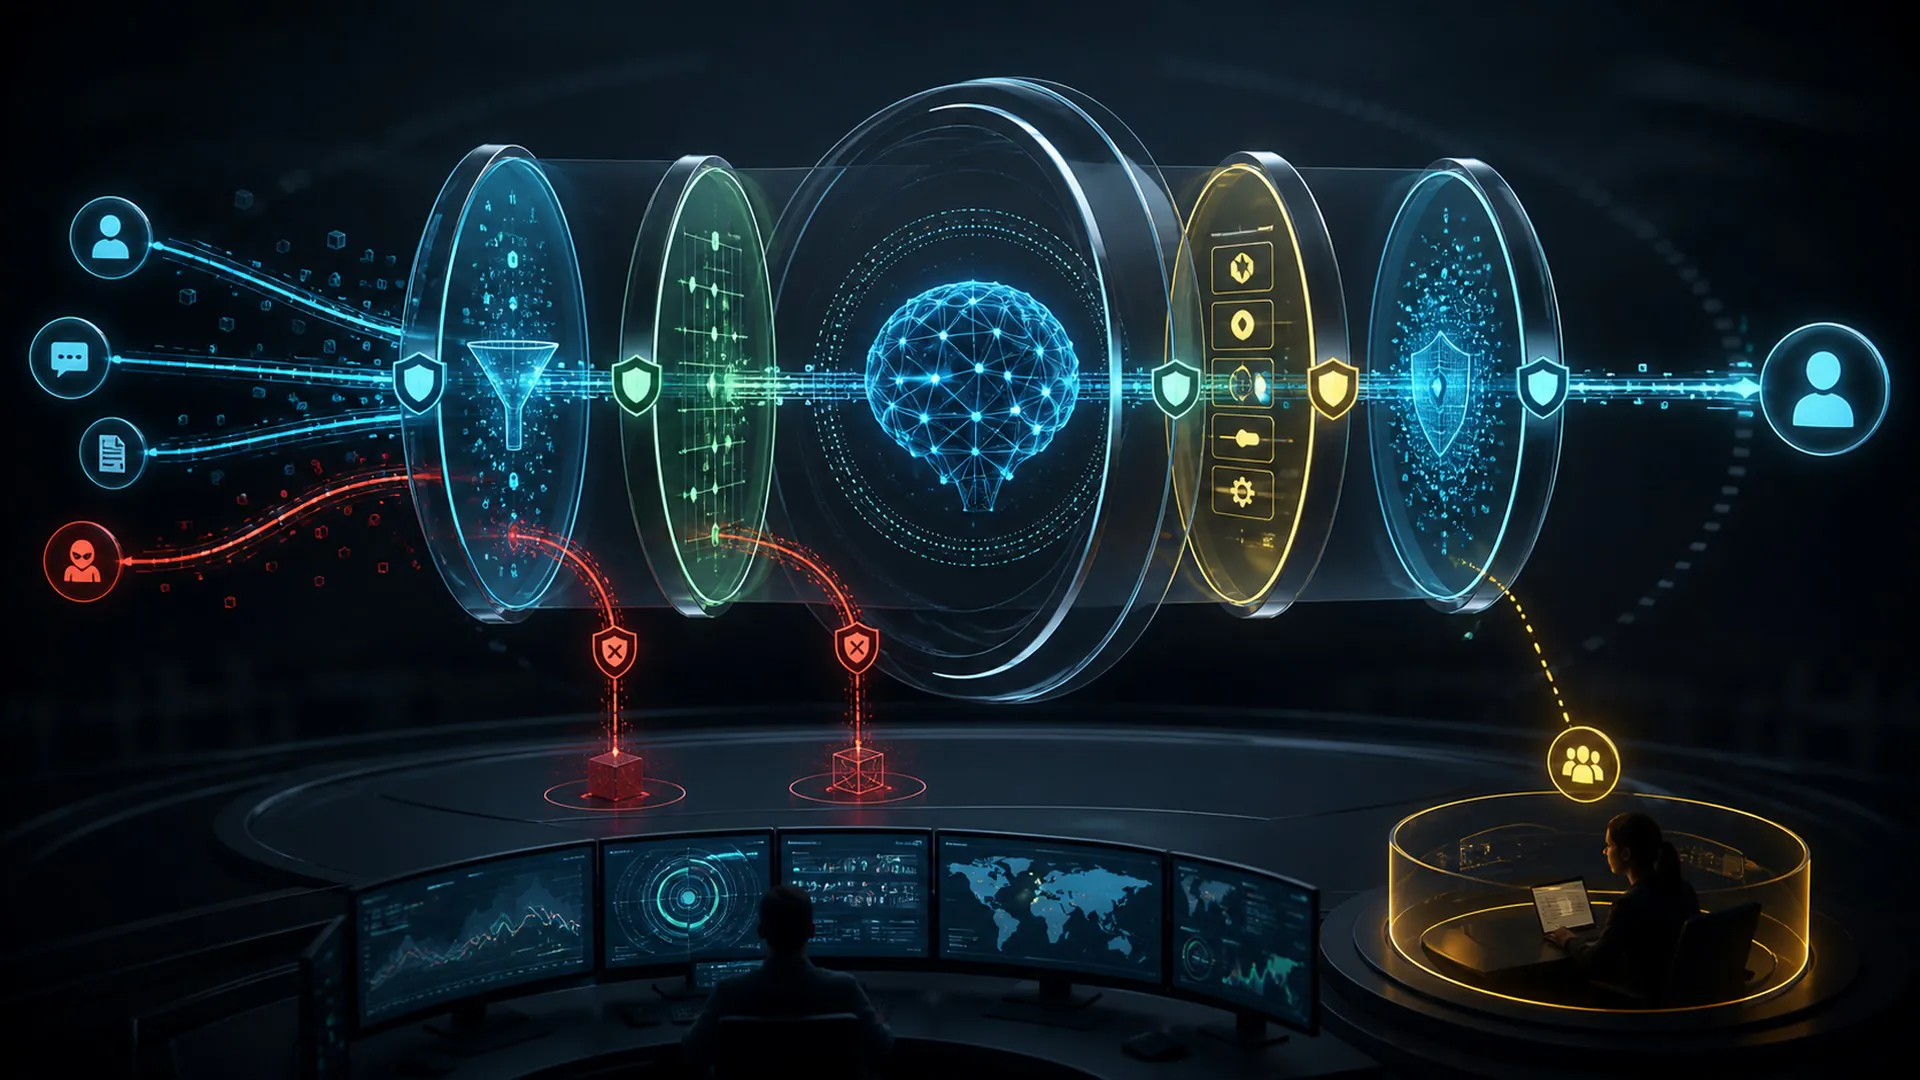
AI-guardrails zijn gelaagde technische en procedurele controles die invoer, acties, uitvoer en escalatie rond een model of agent beperken.
AI-guardrails verdient een precieze uitleg omdat de naam een specifieke informatiestroom, trainingskeuze, runtime‑mechanisme of governance‑grens identificeert. Het behandelen ervan als synoniem voor “geavanceerde AI” maakt claims ontestbaar. Deze gids volgt het concept vanaf de invoer en aannames tot het waarneembare resultaat, en test vervolgens de afkorting die het meest waarschijnlijk wordt verward met dit concept.
AI-guardrails: definitie, grens en doel
AI-guardrails zijn gelaagde technische en procedurele controles die invoer, acties, uitvoer en escalatie rond een model of agent beperken. De definitie bevat drie praktische verplichtingen: er is een identificeerbare invoer, een transformatie of beslissing die kenmerkend is voor AI-guardrails, en een resultaat dat kan worden geëvalueerd ten opzichte van een vastgesteld doel. Als een van deze elementen ontbreekt, kan het label een aspiratie beschrijven in plaats van een geïmplementeerd mechanisme.
Betrouwbare AI vereist bewijs gedurende de volledige levenscyclus. Een controle is alleen zinvol wanneer de eigenaar, reikwijdte, trigger, verwacht gedrag en verificatiemethode expliciet zijn. Voor AI-guardrails is dit systeemzicht belangrijk omdat de prestaties kunnen worden bepaald door de omringende data, interfaces, hardware, permissies en mensen, zelfs wanneer het onderliggende model ongewijzigd blijft. Een bruikbare uitleg scheidt daarom het aangeleerde gedrag van het model van het product dat beslist wanneer, waar en met welke autoriteit dat gedrag wordt gebruikt.
De meest misleidende afkorting is een enkele systeemprompt die elke grens zou moeten afdwingen. Deze kan een zichtbaar kenmerk delen met AI-guardrails, maar verandert het causale verhaal: ander bewijs zou succes aantonen, andere middelen zouden de kosten domineren, en andere controles zouden schade voorkomen. De grens is daarom operationeel in plaats van terminologisch.
Een operationele kaart met vijf fasen voor AI-guardrails
Het diagram is een compacte causale kaart voor AI-guardrails, geen bewering dat elke implementatie vijf softwarecomponenten gebruikt. Sommige systemen combineren fasen en andere herhalen ze in een lus. De kaart blijft nuttig omdat hij elke wijziging in informatie of autoriteit dwingt een eigenaar, een invoer, een uitvoer en een test te hebben.
1. Classificeer het verzoek en het toepasselijke beleid: invoer en aannames in AI-guardrails
In deze fase van AI-guardrails moet het systeem het verzoek en het toepasselijke beleid classificeren. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke status het wijzigt en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van een enkele systeemprompt die elke grens zou moeten afdwingen en het resultaat onder dezelfde gestelde voorwaarden kunnen reproduceren.
De overdracht naar deze fase van AI-guardrails begint met het gestelde doel en moet eindigen met een resultaat dat de beperking van context, tools en data‑toegang kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, resource‑gebruik en eventuele menselijke of software‑controle die op de grens wordt toegepast vast. Die trace is waar teams kunnen detecteren of guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren voordat dezelfde zwakte een consequentiale uitvoer bereikt.
2. Beperk context, tools en data‑toegang: representatie of beslissing in AI-guardrails
In deze fase van AI-guardrails moet het systeem context, tools en data‑toegang beperken. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke status het wijzigt en welk bewijs aantoont dat de wijziging geldig was. Een beoordelaar moet de bewerking kunnen onderscheiden van een enkele systeemprompt die elke grens zou moeten afdwingen en het resultaat onder dezelfde gestelde voorwaarden kunnen reproduceren.
De overdracht naar deze fase van AI-guardrails begint met het classificeren van het verzoek en het toepasselijke beleid en moet eindigen met een resultaat dat het valideren van voorgestelde acties vóór uitvoering kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, resource‑gebruik en eventuele menselijke of software‑controle die op de grens wordt toegepast vast. Die trace is waar teams kunnen detecteren of guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren voordat dezelfde zwakte een consequentiale uitvoer bereikt.
3. Voorgestelde acties valideren vóór uitvoering: onderscheidende transformatie in AI-guardrails
In deze fase van AI-guardrails moet het systeem voorgestelde acties valideren vóór uitvoering. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt en welk bewijs aantoont dat de wijziging geldig is. Een beoordelaar moet in staat zijn de bewerking te onderscheiden van een enkele systeemprompt die elke grens moet afdwingen en het resultaat onder dezelfde gestelde voorwaarden moet reproduceren.
De overdracht naar deze fase van AI-guardrails begint met het beperken van context, hulpmiddelen en gegevenstoegang en moet eindigen met een resultaat dat het inspecteren van uitvoer en gewijzigde toestand kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, middelengebruik en elke menselijke of softwarematige controle die op de grens wordt toegepast vast. Die trace is waar teams kunnen detecteren of guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren voordat dezelfde zwakte een consequentiale output bereikt.
4. Uitvoer en gewijzigde toestand inspecteren: beperking- en verificatiegrens in AI-guardrails
In deze fase van AI-guardrails moet het systeem uitvoer en gewijzigde toestand inspecteren. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt en welk bewijs aantoont dat de wijziging geldig is. Een beoordelaar moet in staat zijn de bewerking te onderscheiden van een enkele systeemprompt die elke grens moet afdwingen en het resultaat onder dezelfde gestelde voorwaarden moet reproduceren.
De overdracht naar deze fase van AI-guardrails begint met het valideren van voorgestelde acties vóór uitvoering en moet eindigen met een resultaat dat escaleren, loggen en verbeteren op basis van incidenten kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, middelengebruik en elke menselijke of softwarematige controle die op de grens wordt toegepast vast. Die trace is waar teams kunnen detecteren of guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren voordat dezelfde zwakte een consequentiale output bereikt.
5. Escaleren, loggen en verbeteren op basis van incidenten: uitvoer, feedback en stopregel in AI-guardrails
In deze fase van AI-guardrails moet het systeem incidenten escaleren, loggen en verbeteren. De relevante vraag is niet alleen of die bewerking plaatsvindt, maar welke informatie het verbruikt, welke toestand het wijzigt en welk bewijs aantoont dat de wijziging geldig is. Een beoordelaar moet in staat zijn de bewerking te onderscheiden van een enkele systeemprompt die elke grens moet afdwingen en het resultaat onder dezelfde gestelde voorwaarden moet reproduceren.
De overdracht naar deze fase van AI-guardrails begint met het inspecteren van uitvoer en gewijzigde toestand en moet eindigen met een resultaat dat monitoring of een definitieve beslissing kan ondersteunen. Leg onzekerheid, afgewezen alternatieven, middelengebruik en elke menselijke of softwarematige controle die op de grens wordt toegepast vast. Die trace is waar teams kunnen detecteren of guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren voordat dezelfde zwakte een consequentiale output bereikt.
Lees de AI-guardrails-kaart vooruit om productie te begrijpen en achteruit om fouten te diagnosticeren. Voorwaartse analyse vraagt hoe de ene fase de volgende voedt. Achterwaartse analyse begint bij een onjuist, traag, duur of onveilig resultaat en traceert welke eerdere veronderstelling dit mogelijk maakte. Het omgekeerde pad is vaak waar een team ontdekt dat de doorslaggevende fout zich voordeed voordat het model iets produceerde.
Een uitgewerkt voorbeeld van AI-guardrails
Een financiële assistent kan een overschrijvingsopdracht opstellen, maar een deterministische regel en een geautoriseerde beoordelaar moeten de uitvoering goedkeuren.
Dit voorbeeld is informatief omdat AI-guardrails gekoppeld kunnen worden aan waarneembare invoer, tussenliggende toestanden en een uitkomst, in plaats van beoordeeld te worden via een gepolijste demonstratie. Een rigoureuze test zou alledaagse, moeilijke en opzettelijk misleidende gevallen rond het scenario opbouwen, een basislijn zonder de techniek behouden, en zowel de gemiddelde prestaties als de ernst van individuele fouten vastleggen.
Verander één veronderstelling in het AI-guardrails-voorbeeld en herhaal de analyse. Verwijder een vereiste invoer, introduceer een tegenstrijdig signaal, beperk de rekencapaciteit, wijzig de gebruikerspopulatie, of dwing het systeem tot onthouding. Een mechanisme dat alleen slaagt onder één zorgvuldig gearrangeerde demonstratie heeft niet aangetoond dat het generaliseert naar de operationele omgeving.
AI-guardrails vs. de meest voorkomende shortcut
AI-guardrails wordt vaak gereduceerd tot een enkele systeemprompt die elke grens zou moeten afdwingen. Die reductie verwijdert de grens die het concept definieert. Het kan ertoe leiden dat kopers ongelijksoortige producten vergelijken, onderzoekers de resultaten van een experiment overschatten, en operators na de inzet het verkeerde signaal monitoren.
| Lens | Praktisch antwoord |
|---|---|
| Definitie | AI‑guardrails zijn gelaagde technische en procedurele controles die invoer, acties, uitvoer en escalatie rond een model of agent beperken. |
| Verwarring | een enkele systeemprompt verwacht om elke grens af te dwingen. |
| Risico | guardrails kunnen legitiem werk blokkeren, worden omzeild, of een vals gevoel van veiligheid creëren. |
De vergelijking moet ook de analyseeenheid identificeren. Een artikel over AI‑guardrails kan een model of algoritme isoleren, terwijl een uitgerolde service retrieval, routing, caching, beleid, identiteit, gebruikersinterfaces en monitoring toevoegt. Twee producten kunnen dezelfde kopterm gebruiken terwijl ze verschillende delen van die stack implementeren. Vraag welke component de bepalende transformatie uitvoert en welke andere componenten nodig zijn voor het gerapporteerde resultaat.
Waarom AI‑guardrails belangrijk zijn in huidige AI‑systemen
AI‑guardrails zijn nu belangrijk omdat AI‑systemen grotere contexten, meer modaliteiten, meer runtime‑rekenkracht, bredere tool‑toegang en diepere verbindingen met organisatorische beslissingen krijgen. Onder die omstandigheden kan wat ooit als een onderzoeksdetail leek, latentie, beveiliging, toegankelijkheid, milieukosten, productkwaliteit of juridische verantwoordelijkheid bepalen.
De relevante maatstaf is niet of AI‑guardrails één indrukwekkend resultaat kunnen leveren. Het gaat erom of de techniek een uitkomst verbetert die van belang is onder representatieve omstandigheden en dat doet effectiever dan een eenvoudigere basislijn. Rapporteer distributies, faalcategorieën, tail‑latentie, resource‑gebruik en getroffen subgroepen in plaats van elk resultaat tot één gemiddelde te comprimeren.
Monitor zowel technische metrics als de impact op mensen. Documenteer onzekerheid, bewaar de herkomst, maak escalatie mogelijk en ontwerp herstel voordat het systeem wordt blootgesteld aan veranderende real‑world‑condities. Specifiek toegepast op AI‑guardrails maakt die discipline het bewijs draagbaar: een ander team kan beoordelen of de beweerde winst waarschijnlijk standhoudt bij een ander model, een andere taal, hardware‑platform, dataset, gebruikerspopulatie of risicotolerantie.
Voordelen die AI‑guardrails kunnen bieden
De sterkste reden om AI‑guardrails te gebruiken is dat ze de beoogde knelpunt direct kunnen aanpakken. Afhankelijk van de implementatie kan het voordeel zich uiten in betere verankering, een getrouwere representatie, verbeterde generalisatie, lagere latentie, minder geheugenverplaatsing, duidelijkere verantwoordelijkheid, of een veiligere grens tussen een modelvoorstel en een reële actie.
Voordelen moeten worden uitgedrukt als beslissingen en metingen. “Intelligenter” is geen acceptatiecriterium voor AI‑guardrails. Een nuttig doel kan de foutpercentage op moeilijke gevallen specificeren, herstel na tegenstrijdig bewijs, kosten op een percentiel van het verkeer, tijd voor menselijke beoordeling, calibratie, of het percentage acties dat binnen een gedefinieerde autoriteitslimiet blijft.
De faalmodus die AI‑guardrails definieert
De centrale beperking is dat guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid kunnen creëren. Deze fout is geen bijzaak die pas na voltooiing van de ontwikkeling wordt genoteerd. Ze moet vanaf het begin de dataverzameling, architectuur, permissies, evaluatie, release‑poorten en monitoring voor AI‑guardrails vormgeven.
Een controle voor AI‑guardrails is alleen nuttig als deze optreedt vóór een dure of onomkeerbare consequentie. Identificeer de vroegste waarneembare voorloper van de fout, stel een drempel of regel in, wijs een verantwoordelijke eigenaar toe, en test herstel. Afhankelijk van het gebruiksscenario kan herstel betekenen dat men zich onthoudt, terugvalt op een eenvoudiger systeem, meer bewijs vraagt, escaleert naar een persoon, een model terugdraait, of een actie volledig stopt.
Een evaluatieplan voor AI‑guardrails
Begin de evaluatie van AI guardrails door de beslissing te formuleren die het bewijs moet ondersteunen. Definieer de operationele populatie, de consequentie van een foutief resultaat, de informatie die daadwerkelijk beschikbaar is op het moment van de beslissing, en het eenvoudigste geloofwaardige alternatief. Dit voorkomt dat een benchmark het doel wordt simpelweg omdat hij gemakkelijk uit te voeren is.
Gebruik een onaangeraakt testset voor gecontroleerde vergelijkingen, en valideer vervolgens AI guardrails in een gefaseerde operationele omgeving. Offline evaluatie maakt varianten vergelijkbaar; shadow‑mode, canaries, rate‑limits of goedkeuringspoorten tonen hoe echt verkeer, feedback‑loops en mensen gedrag veranderen. De implementatiefase moet een expliciete stopconditie hebben in plaats van ervan uit te gaan dat elke verbetering volledige uitrol verdient.
Versieer de inputs die nodig zijn om AI guardrails te reproduceren: brondata, preprocessing, tokenizer of encoder, modelgewichten, configuratie, prompt of beleid, retrieval‑index, evaluatieset, hardware‑aannames en serveercode waar van toepassing. Zonder lineage kan een team niet bepalen of een gewijzigd resultaat voortkomt uit de techniek, de omgeving, of een onopgemerkte wijziging in de pijplijn.
Tenslotte, vraag welke bevinding de bewering dat AI guardrails helpt zou falsifiëren. Als geen enkel resultaat de adoptiebeslissing kan omkeren, is de evaluatie marketing. Vooraf vastgestelde acceptatiedrempels en een bewaarde bevestigingsset maken van de oefening bewijs.
Vragen om te stellen vóór het adopteren van AI Guardrails
- Doelstelling: Welke meetbare knelpunt moet AI guardrails oplossen?
- Mechanisme: Welke van de vijf fasen bevat de onderscheidende transformatie?
- Baseline: Hoe verhoudt het zich tot een enkele systeem‑prompt die elke grens moet afdwingen of een ander eenvoudiger alternatief?
- Bewijs: Welke gewone, moeilijke, adversariale en subgroep‑cases zijn getest?
- Operaties: Welke latentie, geheugen, rek, energie, onderhouds‑ en beoordelingskosten verschijnen op schaal?
- Risico: Hoe zal het team detecteren dat guardrails legitiem werk kunnen blokkeren, omzeild kunnen worden, of een vals gevoel van veiligheid creëren?
- Herstel: Kan het systeem zich onthouden, terugvallen, terugrollen of escaleren vóór schade?
Primaire bronnen voor het bestuderen van AI Guardrails
Autoritatieve startpunten voor het deel van de AI‑stack rondom AI guardrails omvatten NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Lees ze naast de documentatie voor het exacte model, de dataset, hardware en jurisdictie die betrokken zijn. Een algemene bron kan het mechanisme definiëren, maar alleen implementatie‑specifiek bewijs kan aantonen dat een bepaalde uitvoering geschikt is.
Wat te onthouden over AI Guardrails
AI guardrails is een gedefinieerd mechanisme binnen een groter sociotechnisch systeem. De waarde ervan komt voort uit het verbeteren van een specifiek resultaat onder expliciete voorwaarden, niet uit het label zelf. De vijf‑fasenkaart maakt de informatiestroom zichtbaar, de vergelijking identificeert wat het niet is, en het controlepad toont waar een verantwoordelijke operator kan ingrijpen.
De praktische regel voor AI guardrails is om het doel te definiëren, te vergelijken met een geloofwaardige baseline, de fout te testen die het meest telt, en het bewijs te behouden dat nodig is om veranderingen te monitoren. Met die onderdelen op hun plaats wordt het concept een engineering‑ en governance‑keuze die geëvalueerd kan worden. Zonder die elementen blijft het een veelbelovende naam gekoppeld aan een onbekend operationeel risico.


