

AI-modellen en platforms
SEER: een doorbraak in zelfgesuperviseerde computervisiemodellen?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Kunstmatige intelligentie (AI) en machine learning (ML) hebben het afgelopen decennium enorme vooruitgang geboekt. Modellen zijn nauwkeuriger, efficiënter en capabeler dan ooit. Ze herkennen objecten in afbeeldingen en video’s soepel en nauwkeurig en kunnen tekst en spraak genereren die menselijke intelligentie benaderen.
Huidige AI- en ML-modellen zijn sterk afhankelijk van training met gelabelde datasets. Die leren hun tekst te interpreteren, objecten in afbeeldingen of videoframes te herkennen en andere taken uit te voeren.
Toch zijn de modellen niet perfect. Onderzoekers ontwikkelen modellen die leren van de aangeboden informatie zonder noodzakelijk te vertrouwen op labels of annotaties. Dit heet zelfgesuperviseerd leren en is een efficiënte manier om modellen te bouwen met “gezond verstand” of achtergrondkennis voor problemen die huidige AI-modellen nog niet aankunnen.
Zelfgesuperviseerd leren heeft al resultaten opgeleverd bij natuurlijke taalverwerking. Het maakt grote modellen en enorme hoeveelheden data mogelijk en leidde tot doorbraken in inferentie in natuurlijke taal, machinevertaling en vraagbeantwoording.
Het SEER-model van Facebook (META ) AI wil het potentieel van zelfgesuperviseerd leren voor computervisie maximaliseren. SEER, oftewel SElf SupERvised , is een zelfgesuperviseerd computervisiemodel met meer dan een miljard parameters. Het kan patronen ontdekken en leren van willekeurige internetafbeeldingen zonder passende annotaties of labels.
Waarom computervisie zelfgesuperviseerd leren nodig heeft
Data annoteren of labelen is een voorbewerkingsstap bij de ontwikkeling van AI- en ML-modellen. Ruwe data, zoals afbeeldingen of videoframes, krijgen labels die hun context aan het model duidelijk maken. Daarmee kan het model nauwkeurige voorspellingen doen.
Een groot obstakel voor ontwikkelaars is het vinden van hoogwaardige geannoteerde data. Modellen voor computervisie gebruiken zulke datasets om patronen te leren waarmee ze objecten herkennen.
Het annoteren en gebruiken van data brengt de volgende uitdagingen mee:
Een consistente datasetkwaliteit bewaken
Voortdurend toegang hebben tot hoogwaardige datasets is moeilijk. Goede labels en duidelijke afbeeldingen verbeteren het leerproces en de nauwkeurigheid, maar het consistent verkrijgen van die kwaliteit kent eigen uitdagingen.
Personeelsbeheer
Voor het verwerken en labelen van veel ongestructureerde, ongelabelde data zijn veel medewerkers nodig, terwijl de kwaliteit gewaarborgd moet blijven. Ontwikkelaars moeten daarom een evenwicht vinden tussen kwaliteit en hoeveelheid.
Financiële beperkingen
De kosten vormen mogelijk het grootste obstakel. Datalabeling vertegenwoordigt vaak een aanzienlijk deel van de totale projectkosten.
Annotatie belemmert dus de ontwikkeling van geavanceerde computervisiemodellen, vooral complexe modellen met veel trainingsdata. Daarom is zelfgesuperviseerd leren nodig voor geavanceerde modellen die taken aankunnen buiten het bereik van huidige oplossingen.
Er zijn al veel zelfgesuperviseerde modellen die goed werken in gecontroleerde omgevingen, vooral op ImageNet. Toch voldoen ze niet aan de voornaamste voorwaarde: leren van onbeperkte datasets of willekeurige afbeeldingen, in plaats van uitsluitend een duidelijk afgebakende dataset. Bij een ideale uitvoering kan zelfgesuperviseerd leren nauwkeurigere, capabelere, betaalbare en haalbare computervisiemodellen opleveren.
Een inleiding tot SEER: SElf-supERvised
Recente ontwikkelingen wijzen erop dat semi-gesuperviseerde, zwak gesuperviseerde en zelfgesuperviseerde voortraining de prestaties van veel deep-learningmodellen op vervolgtaken sterk kan verbeteren.
Twee factoren hebben veel bijgedragen aan deze verbetering.
Voortraining op enorme datasets
Enorme datasets bieden een breed scala aan voorbeelden, waardoor modellen patronen beter begrijpen. Dit verbetert doorgaans de nauwkeurigheid en de prestaties in de praktijk.
Goed presterende modellen zoals GPT-3 en Wav2vec 2.0 zijn met grote datasets getraind. GPT-3 gebruikt voortraining met meer dan 300 miljard woorden , terwijl Wav2vec 2.0 voor spraakherkenning meer dan 53.000 uur audiogegevens gebruikt.
Modellen met een enorme capaciteit
Meer parameters geven vaak nauwkeurigere resultaten doordat het model zich kan richten op relevante objecten in de data, in plaats van op storing of ruis.
Eerdere pogingen tot zelfgesuperviseerde training op ongelabelde of niet-gecureerde data gebruikten kleinere datasets met slechts enkele miljoenen afbeeldingen. Kunnen zulke modellen ook nauwkeurig zijn wanneer ze op enorme hoeveelheden ongelabelde, niet-gecureerde data worden getraind? Dat is precies de vraag die SEER wil beantwoorden.
Het SEER-model is een deep-learningframework dat internetafbeeldingen wil verwerken zonder afhankelijkheid van gecureerde of gelabelde datasets. Ontwikkelaars kunnen grote, complexe modellen trainen op willekeurige data zonder supervisie: het model analyseert zelf de data en leert patronen en informatie zonder extra handmatige invoer.
Het uiteindelijke doel is voortrainingsstrategieën ontwikkelen die met niet-gecureerde data geavanceerde prestaties bij transfer learning opleveren. Daarnaast wil SEER systemen creëren die zelfgesuperviseerd blijven leren uit een eindeloze datastroom.
SEER traint modellen met veel capaciteit op miljarden willekeurige, onbeperkte internetafbeeldingen. Metadata of annotaties worden niet gebruikt voor training of filtering. Recent leverde zelfgesuperviseerde training op niet-gecureerde data betere vervolgprestaties op dan gesuperviseerde voortraining.
Wat is het verband tussen SEER en RegNet?
Voor de analyse richt SEER zich op RegNet met meer dan 700 miljoen parameters. Twee eigenschappen passen bij zelfgesuperviseerd leren op niet-gecureerde data:
- Een goede balans tussen prestaties en efficiëntie.
- Veel flexibiliteit om het aantal parameters op te schalen.

SEER: eerder werk uit verschillende gebieden
SEER onderzoekt de grenzen van het trainen van grote architecturen op niet-gecureerde of ongelabelde datasets met zelfgesuperviseerd leren, geïnspireerd door eerder onderzoek.
Ongesuperviseerde voortraining van visuele kenmerken
Zelfgesuperviseerd leren wordt al langer in computervisie gebruikt met auto-encoders, onderscheid tussen afzonderlijke voorbeelden en clustering. Recent laten contrastieve methoden zien dat ongesuperviseerde voortraining betere vervolgprestaties kan geven dan gesuperviseerd leren.
De belangrijkste les is dat gesuperviseerde labels niet nodig zijn zolang op gefilterde data wordt getraind. SEER onderzoekt of grote architecturen nauwkeurige representaties kunnen leren uit enorme aantallen niet-gecureerde, ongelabelde, willekeurige afbeeldingen.
Visuele kenmerken op grote schaal leren
Eerdere modellen profiteerden van zwak gesuperviseerde, gesuperviseerde en semi-gesuperviseerde voortraining op grote gelabelde datasets en miljoenen gefilterde afbeeldingen. Voortraining op miljarden afbeeldingen geeft doorgaans ook betere nauwkeurigheid dan helemaal opnieuw trainen.
Grootschalige training gebruikt vaak filtering om afbeeldingen bij doelconcepten te laten aansluiten. Dit gebeurt met voorspellingen van een voorgetrainde classifier of hashtags die overeenkomen met synoniemgroepen van ImageNet-klassen . SEER wil juist kenmerken uit willekeurige afbeeldingen leren en cureert de data daarom niet naar vooraf bepaalde kenmerken of concepten.
Architecturen voor beeldherkenning opschalen
Grote architecturen kunnen betere visuele kenmerken opleveren. Bij veel trainingsdata kan een klein model onderfitten, dus voldoende capaciteit is belangrijk. Dat geldt vooral bij contrastief leren, waar het model voorbeelden moet onderscheiden om betere representaties te leren.
Opschalen omvat bij beeldherkenning meer dan diepte en breedte aanpassen. Voor capaciteit én schaalefficiëntie is veel onderzoek nodig. SEER toont de voordelen van de RegNets-modelfamilie voor zelfgesuperviseerd leren op grote schaal.
SEER: methoden en onderdelen
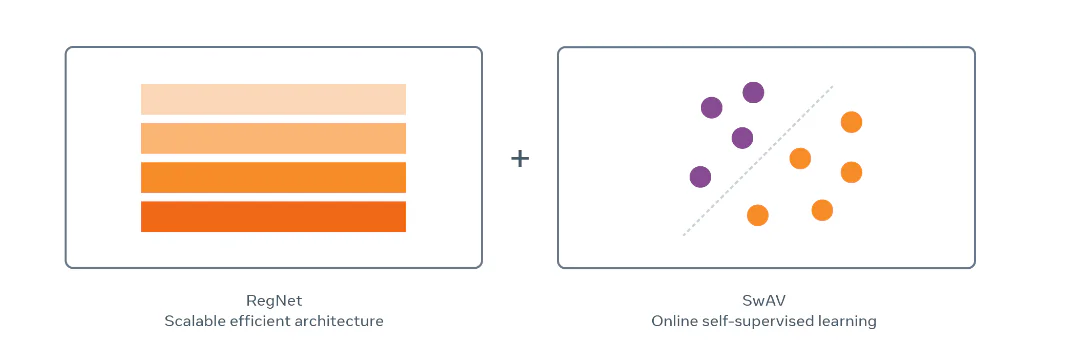
SEER gebruikt verschillende methoden om visuele representaties voor te trainen. Belangrijke onderdelen zijn RegNet en SwAV. We bespreken ze kort.
Zelfgesuperviseerde voortraining met SwAV
SEER wordt voorgetraind met SwAV, een online zelfgesuperviseerde aanpak. SwAV is een online clustermethode voor het trainen van convolutionele netwerken zonder annotaties. Een embedding leert consistente clustertoewijzingen tussen verschillende weergaven van dezelfde afbeelding. Zo worden semantische representaties geleerd uit clusters die invariant zijn voor data-augmentatie.
SwAV vergelijkt kenmerken van verschillende weergaven via hun onafhankelijke clustertoewijzingen. Als die dezelfde of vergelijkbare kenmerken vastleggen, kan het kenmerk van de ene weergave de toewijzing van de andere voorspellen.
SEER beschouwt K clusters, elk met een leerbare d-dimensionale vector vk. Voor een batch van B afbeeldingen wordt elke afbeelding i omgezet in twee weergaven: xi1 en xi2. Een convolutioneel netwerk extraheert kenmerken en levert twee verzamelingen op: (f11, …, fB2) en (f12, …, fB2). Elke verzameling wordt onafhankelijk aan clusterprototypen toegewezen via een oplosser voor optimaal transport .
Deze verdeelt kenmerken gelijkmatig over clusters en voorkomt de triviale oplossing waarin alle representaties naar één prototype gaan. De toewijzingen worden tussen beide verzamelingen uitgewisseld: clustertoewijzing yi1 van weergave xi1 moet worden voorspeld met kenmerkrepresentatie fi2 van weergave xi2, en omgekeerd.
Prototypegewichten en het convolutionele netwerk worden getraind om het verlies voor alle voorbeelden te minimaliseren. Het clustervoorspellingsverlies l is in wezen de cross-entropie tussen een softmax van het inproduct van f en de clustertoewijzing.

RegNetY: een schaalefficiënte modelfamilie
Meer modelcapaciteit en data vereisen architecturen die efficiënt zijn qua geheugen en uitvoeringstijd. RegNets is specifiek daarvoor ontworpen.
De RegNet-ontwerpruimte bestaat uit convolutionele netwerken met vier fasen. Elke fase heeft een reeks identieke blokken, met een vaste blokstructuur, vooral residuele bottleneckblokken.
SEER richt zich op RegNetY en voegt Squeeze-and-Excitation toe aan de standaardarchitectuur om prestaties te verbeteren. Vijf parameters helpen goede configuraties te zoeken met een vast aantal FLOPs en redelijk middelengebruik. SEER past RegNetY direct toe op zelfgesuperviseerde voortraining.
De RegNetY 256GF-architectuur SEER gebruikt vooral RegNetY 256GF, waarvan de parameters de schaalregel van RegNets volgen. De configuratie is als volgt.

De vier fasen hebben breedtes (528, 1056, 2904, 7392) en dieptes (2, 7, 17, 1), samen meer dan 696 miljoen parameters. Op 512 NVIDIA V100-GPU’s met 32 GB duurt een iteratie met 8.704 afbeeldingen ongeveer 6.125 ms. Meer dan een miljard afbeeldingen trainen met deze batchgrootte en meer dan 512 GPU’s vraagt 114.890 iteraties en ongeveer acht dagen.
Optimalisatie en training op schaal
SEER stelt verschillende aanpassingen voor om zelfgesuperviseerde methoden op grote schaal toe te passen:
- Een leersnelheidsschema.
- Minder geheugenverbruik per GPU.
- Optimalisatie van de trainingssnelheid.
- Voortrainingsdata op grote schaal.
We bespreken ze kort.
Leersnelheidsschema
SEER onderzoekt twee schema’s: een cosinusschema en een vast leersnelheidsschema.
Het cosinusschema past zich aan het aantal updates aan en maakt eerlijke modelvergelijkingen mogelijk. Voor grootschalige training is het minder geschikt: afbeeldingen krijgen afhankelijk van hun verschijningsmoment een ander gewicht en het schema gebruikt het totale aantal updates.
Het vaste schema houdt de leersnelheid gelijk totdat het verlies niet meer daalt en halveert die dan. Analyse laat zien dat dit flexibeler is en beter werkt. Omdat het grootste model slechts een miljard afbeeldingen traint, gebruikt SEER daarvoor toch een cosinusschema. Dit model is RegNet 256GF.
Geheugenverbruik per GPU verminderen
Gemengde precisie en gradient checkpointing verminderen de benodigde GPU-middelen. Het O1-optimalisatieniveau van NVIDIA Apex voert convoluties en GEMM-bewerkingen uit met 16-bits drijvende-kommaprecisie. PyTorch gradient checkpointing ruilt extra berekeningen in voor minder geheugenverbruik.
Tussenliggende activaties van de voorwaartse stap worden weggegooid en tijdens de achterwaartse stap opnieuw berekend.
Trainingssnelheid optimaliseren
Gemengde precisie verhoogt ook de doorvoer: accelerators profiteren van het kleinere FP16-formaat ten opzichte van FP32 en verminderen de bottleneck door geheugenbandbreedte.
SEER synchroniseert daarnaast de BatchNorm-laag tussen GPU’s in procesgroepen, in plaats van met de tragere globale synchronisatie. De datalader haalt meer batches vooraf op en bereikt zo meer doorvoer dan de datalader van PyTorch .
Voortrainingsdata op grote schaal
SEER gebruikt meer dan een miljard afbeeldingen en bemonstert willekeurig rechtstreeks van internet en Instagram. Omdat het online op beelden uit de praktijk traint, gebruikt het geen voorbewerking, deduplicatie of hashtagfiltering.
De dataset is niet statisch: afbeeldingen worden elke drie maanden vernieuwd. Dit beïnvloedt de modelprestaties niet.
Implementatie van SEER
RegNetY 256GF wordt met SwAV voorgetraind op zes uitsneden per afbeelding, met resolutie 2×224 + 4×96. Een MLP met drie lagen heeft projectiehoofden met dimensies 10444×8192, 8192×8192 en 8192×256.
In plaats van BatchNorm-lagen in het hoofd gebruikt SEER 16.000 prototypen met temperatuur t gelijk aan 0,1. De Sinkhorn-regularisatieparameter is 0,05 en het algoritme draait tien iteraties. BatchNorm-statistieken worden tussen GPU’s gesynchroniseerd in meerdere procesgroepen van grootte 64.
Verder gebruikt het model de LARS-optimizer, oftewel Layer-wise Adaptive Rate Scaling, gewichtsverval van 10-5, activatiecheckpoints en O1 gemengde precisie. Stochastische gradiëntafdaling gebruikt batches van 8.192 willekeurige afbeeldingen verdeeld over 512 NVIDIA-GPU’s, dus 16 per GPU.
Tijdens de eerste 8.000 updates stijgt de leersnelheid lineair van 0,15 naar 9,6. Daarna daalt die volgens een cosinusschema tot 0,0096. In totaal traint SEER meer dan een miljard afbeeldingen in 122.000 iteraties.
Resultaten van SEER
De kwaliteit van zelfgesuperviseerde kenmerken wordt op verschillende benchmarks en vervolgtaken onderzocht. Ook wordt een low-shot-situatie getest, met beperkte toegang tot afbeeldingen en labels voor vervolgtaken.
Grote voorgetrainde modellen finetunen
Modellen die op willekeurige data zijn voorgetraind, worden voor objectclassificatie naar ImageNet overgebracht. De evaluatie gebruikt de volgende instellingen.
Experimentele opzet
Zes RegNet-architecturen met verschillende capaciteit worden voorgetraind: RegNetY-{8,16,32,64,128,256}GF , met SwAV op meer dan een miljard willekeurige openbare Instagram-afbeeldingen. Daarna volgt finetuning op ImageNet, met meer dan 1,28 miljoen correct gelabelde trainingsbeelden en ruim 50.000 validatiebeelden.
Het model gebruikt dezelfde augmentatie als SwAV en finetunet 35 epochs met SGD, batchgrootte 256 en leersnelheid 0,0125, die na 30 epochs met factor tien daalt. Het momentum is 0,9 en gewichtsverval 10-4. Top-1-nauwkeurigheid wordt gemeten op de validatieset met een centrale uitsnede van 224×224.
Vergelijking met andere zelfgesuperviseerde voortraining
De tabel vergelijkt het grootste model, RegNetY-256GF, met bestaande zelfgesuperviseerde voorgetrainde modellen.

SEER behaalt 84,2% top-1-nauwkeurigheid op ImageNet, 1% beter dan het eerder beste model SimCLRv2.
De volgende figuur vergelijkt verschillende capaciteiten. Ongeacht de capaciteit geeft de combinatie RegNet en SwAV nauwkeurige voortrainingsresultaten.

SEER wordt op niet-gecureerde willekeurige afbeeldingen voorgetraind met RegNet en SwAV. Het wordt vergeleken met SimCLRv2 en ViT met andere netwerkarchitecturen. Daarna volgt ImageNet-finetuning en rapportage van top-1-nauwkeurigheid.
Invloed van modelcapaciteit
Capaciteit heeft grote invloed op voortraining. De volgende figuur vergelijkt dit met helemaal opnieuw trainen.

Voorgetrainde modellen hebben een hogere top-1-nauwkeurigheid en het verschil groeit met het aantal parameters. Meer capaciteit helpt beide benaderingen, maar bij veel parameters is het effect groter voor voorgetrainde modellen.
Een mogelijke oorzaak van overfitting bij opnieuw trainen op ImageNet is de beperkte datasetgrootte.
Leren met weinig voorbeelden
Low-shot learning evalueert SEER op vervolgtaken met slechts een deel van alle beschikbare data.
Experimentele opzet
Twee datasets worden gebruikt: Places205 en ImageNet. Bij transfer learning is toegang tot zowel afbeeldingen als labels beperkt. Dit verschilt van de gebruikelijke zelfgesuperviseerde opzet, waarin alle afbeeldingen beschikbaar zijn en alleen de labels worden beperkt.
-
Resultaten op Places205
De figuur toont de invloed van voortraining bij verschillende beschikbare delen van Places205.

De aanpak wordt vergeleken met gesuperviseerde ImageNet-voortraining van dezelfde RegNetY-128GF-architectuur. Ongeacht de hoeveelheid finetuningsdata op Places205 is er een stabiele verbetering van ongeveer 2,5% in top-1-nauwkeurigheid.
Het verschil kan voortkomen uit de aard van de trainingsdata. Kenmerken uit willekeurige praktijkbeelden kunnen beter passen bij scèneclassificatie. Een ongelijke conceptverdeling kan ook voordelig zijn voor voortraining op een ongebalanceerde dataset als Places205.
Resultaten op ImageNet

De tabel vergelijkt SEER met zelfgesuperviseerde en semi-gesuperviseerde low-shot-methoden. Die gebruiken bij voortraining alle 1,2 miljoen ImageNet-afbeeldingen en beperken alleen de labels. SEER ziet daarentegen slechts 1 tot 10% van de afbeeldingen uit die dataset.
Meer afbeeldingen uit dezelfde verdeling geven de andere methoden een groot voordeel. Toch haalt SEER met slechts 1 tot 10% van ImageNet ongeveer 80% top-1-nauwkeurigheid, iets onder de methoden in de tabel.
Invloed van modelcapaciteit
De figuur toont de invloed van capaciteit op low-shot learning bij 1%, 10% en 100% van ImageNet.

Meer capaciteit kan de nauwkeurigheid verbeteren wanneer toegang tot afbeeldingen én labels beperkt is.
Overdracht naar andere benchmarks
Voor verdere evaluatie worden de voorgetrainde kenmerken naar andere vervolgtaken overgebracht.
Lineaire evaluatie van beeldclassificatie

De tabel vergelijkt SEER’s RegNetY-256GF-kenmerken met RegNetY-128GF dat met dezelfde architectuur op ImageNet is voorgetraind, met en zonder supervisie. Gewichten worden bevroren en bovenop de kenmerken wordt een lineaire classifier getraind op de vervolgtaak. Benchmarks zijn Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) en Pascal VOC (VOC).
Detectie en segmentatie
De volgende figuur vergelijkt en evalueert voorgetrainde kenmerken voor detectie en segmentatie.

SEER traint Mask-RCNN op COCO met voorgetrainde RegNetY-64GF en RegNetY-128GF als bouwstenen. Voor beide architecturen en vervolgtaken presteert zelfgesuperviseerde voortraining beter dan gesuperviseerde training met 1,5 tot 2 AP-punten.
Vergelijking met zwak gesuperviseerde voortraining
Internetafbeeldingen hebben vaak metabeschrijvingen, alt-tekst, beschrijvingen of locaties die voortraining kunnen helpen. Eerder werk laat zien dat het voorspellen van gecureerde of gelabelde hashtags betere visuele kenmerken kan opleveren. Hiervoor moeten beelden worden gefilterd en de aanpak werkt het best met tekstuele metadata.
De figuur vergelijkt top-1-nauwkeurigheid van ResNetXt101-32dx8d op willekeurige afbeeldingen met dezelfde architectuur op gelabelde beelden met hashtags en metadata.

Hoewel SEER geen metadata gebruikt bij voortraining, is de nauwkeurigheid vergelijkbaar met modellen die dat wel doen.
Ablatiestudies
Een ablatiestudie verwijdert een onderdeel volledig om de verandering in modelprestaties te meten. Zo wordt de bijdrage van dat onderdeel duidelijk.
Invloed van de architectuur
De architectuur beïnvloedt prestaties sterk, vooral bij schaalvergroting of wijzigingen in voortrainingsdata.
De figuur evalueert veranderingen in kenmerken door de architectuur aan te passen, met lineaire ImageNet-evaluatie. Kenmerken kunnen direct worden onderzocht, omdat de evaluatie geen voorkeur geeft aan modellen die vanaf nul goed presteren op ImageNet.

Bij de huidige instellingen werken de kenmerken uit de voorlaatste laag beter voor ResNeXt en ResNet. RegNet presteert beter dan de andere architecturen.
Meer capaciteit verbetert dus de kenmerken, met een logaritmische prestatiewinst.
Voortrainingsdata opschalen
Twee redenen voor betere visuele kenmerken bij grotere datasets zijn meer unieke afbeeldingen en meer parameters. We bekijken hun effect.
Meer unieke afbeeldingen

De figuur vergelijkt RegNet8 en RegNet16 met hetzelfde aantal parameters, maar verschillende aantallen unieke afbeeldingen. SEER gebruikt updates voor één epoch op een miljard afbeeldingen, of 32 epochs op 32 unieke afbeeldingen, met een leersnelheid volgens een halve cosinusgolf.
Voor goede prestaties zijn idealiter veel unieke afbeeldingen nodig. Hier presteert het model goed wanneer dat aantal groter is dan in ImageNet.
Meer parameters
De figuur toont RegNet-128GF tijdens training op een miljard afbeeldingen. De prestaties stijgen gestaag wanneer het aantal parameters toeneemt.

Zelfgesuperviseerde computervisie in de praktijk
Na de theorie bekijken we hoe zelfgesuperviseerde computervisie in praktijksituaties werkt en waarom SEER de toekomst ervan kan vormen.
SEER is vergelijkbaar met ontwikkelingen in natuurlijke taalverwerking, waar geavanceerde modellen biljoenen datasets en parameters combineren met biljoenen woorden tijdens voortraining. Meer trainingsdata verbeteren doorgaans de vervolgprestaties; dat geldt ook voor computervisie.
Toch verschillen tekst en beeld. In tekst zijn semantische concepten meestal verdeeld over afzonderlijke woorden. Bij afbeeldingen moet het model bepalen welke pixel bij welk concept hoort.
Afbeeldingen verschillen ook in perspectief en concept, zelfs met hetzelfde object. Een kat kan stilstaan op de ene foto en met een bal spelen op de andere. Het model moet veel afbeeldingen zien om verschillen rond hetzelfde concept te begrijpen.
Efficiënt opschalen voor complexe, hoogdimensionale beelddata vereist twee onderdelen:
- Een convolutioneel neuraal netwerk (CNN) dat groot genoeg is om visuele concepten uit een enorme beelddataset te leren.
- Een algoritme dat patronen uit veel afbeeldingen leert zonder labels, annotaties of metadata.
SEER past beide toe op computervisie. Het benut SwAV, dat met online clustering afbeeldingen met vergelijkbare visuele concepten groepeert of koppelt en via die overeenkomsten patronen beter herkent.
SwAV maakt zelfgesuperviseerde computervisie effectiever en kan de trainingstijd tot een factor zes verkorten.
Training op meer dan een miljard afbeeldingen vereist efficiëntie in tijd, geheugen en nauwkeurigheid. RegNet-modellen zijn convolutionele netwerken die naar biljoenen parameters kunnen opschalen en kunnen worden aangepast aan geheugen- en tijdsbeperkingen.
Conclusie: een zelfgesuperviseerde toekomst
Zelfgesuperviseerd leren is een belangrijk onderwerp in AI en ML. Modellen leren rechtstreeks uit veel willekeurige internetdata, in plaats van uit zorgvuldig gecureerde en gelabelde datasets die uitsluitend voor modeltraining zijn gemaakt.
Het kan modellen opleveren die zich aan de praktijk aanpassen en meerdere toepassingen hebben in plaats van één specifiek doel. SEER is een mijlpaal voor de invoering ervan in computervisie.
SEER zet een eerste stap naar verandering van computervisie en minder afhankelijkheid van gelabelde data. Het wil annotatie overbodig maken, zodat ontwikkelaars meer diverse en omvangrijke data kunnen gebruiken. Dit helpt vooral in gebieden met weinig beelden of metadata, zoals de medische sector.
Zonder menselijke annotatie kunnen modellen sneller worden ontwikkeld en ingezet, waardoor sneller en nauwkeuriger op veranderende situaties kan worden gereageerd.



