
Interviews
David Maher, CTO van Intertrust – Interview Serie

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
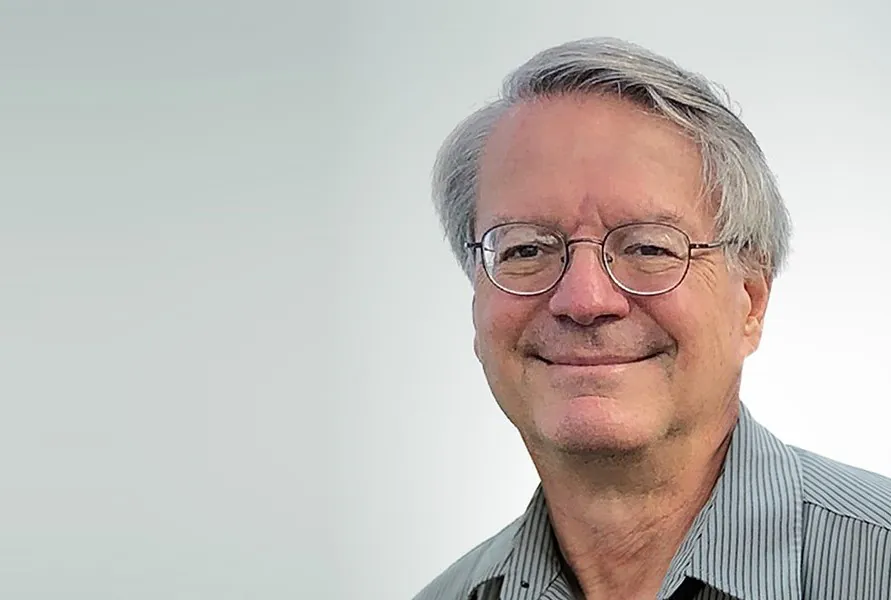
David Maher fungeert als Executive Vice President en Chief Technology Officer van Intertrust. Met meer dan 30 jaar ervaring in vertrouwde gedistribueerde systemen, beveiligde systemen en risicobeheer, heeft Dave R&D-inspanningen geleid en belangrijke leiderschapsposities ingenomen binnen de dochterondernemingen van het bedrijf. Hij was voorheen president van Seacert Corporation, een Certificate Authority voor digitale media en IoT, en president van whiteCryption Corporation, een ontwikkelaar van systemen voor softwarezelfverdediging. Hij was ook co-voorzitter van de Marlin Trust Management Organization (MTMO), die toezicht houdt op ‘s werelds enige onafhankelijke digitale rechtenbeheersysteem.
Intertrust heeft innovaties ontwikkeld die het mogelijk maken voor gedistribueerde besturingssystemen om gegevens en berekeningen over open netwerken te beveiligen en te reguleren, wat heeft geresulteerd in een fundamentele octrooi op vertrouwd gedistribueerd rekenen.
Origineel geworteld in onderzoek, is Intertrust geëvolueerd naar een productgerichte onderneming die vertrouwde rekeningsdiensten aanbiedt die apparaat- en gegevensoperaties verenigen, met name voor IoT en AI. De markten van het bedrijf omvatten mediadistributie, apparaatidentiteit/authenticatie, digitale energiemanagement, analytics en cloudopslagbeveiliging.
Hoe kunnen we de AI-vertrouwenskloof dichten en de groeiende zorgen van het publiek over AI-veiligheid en -betrouwbaarheid aanpakken?
Transparantie is de belangrijkste kwaliteit die ik geloof dat zal helpen bij het aanpakken van de groeiende zorgen over AI. Transparantie omvat functies die zowel consumenten als technici helpen om te begrijpen welke AI-mechanismen deel uitmaken van systemen waarmee we interactie hebben, wat voor soort afkomst ze hebben: hoe een AI-model getraind is, welke beveiligingsmaatregelen bestaan, welke beleidsregels zijn toegepast bij de ontwikkeling van het model en welke andere waarborgen bestaan voor de veiligheid en beveiliging van een bepaalde mechanisme. Met grotere transparantie zullen we in staat zijn om echte risico’s en problemen aan te pakken en ons minder te laten afleiden door irrationele angsten en vermoedens.
Wat is de rol van metadata-authenticatie bij het waarborgen van de betrouwbaarheid van AI-uitvoer?
Metadata-authenticatie helpt onze vertrouwen te vergroten dat waarborgen over een AI-model of een andere mechanisme betrouwbaar zijn. Een AI-modelkaart is een voorbeeld van een verzameling van metadata die kan helpen bij het evalueren van het gebruik van een AI-mechanisme (model, agent, enz.) voor een specifiek doel. We moeten standaarden vaststellen voor duidelijkheid en volledigheid voor modelkaarten met standaarden voor kwantitatieve metingen en geauthenticeerde beweringen over prestaties, vooroordelen, eigenschappen van trainingsgegevens, enz.
Hoe kunnen organisaties het risico van AI-vooringenomenheid en hallucinaties in grote taalmodellen (LLM’s) mitigeren?
Red teaming is een algemene aanpak voor het aanpakken van deze en andere risico’s tijdens de ontwikkeling en voorafgaand aan de release van modellen. Oorspronkelijk gebruikt om beveiligde systemen te evalueren, wordt deze aanpak nu standaard voor AI-gebaseerde systemen. Het is een systeemaanpak voor risicobeheer dat de hele levenscyclus van een systeem kan omvatten, van de initiële ontwikkeling tot de implementatie in het veld, en de hele ontwikkelingsketen kan omvatten. Vooral kritisch is de classificatie en authenticatie van de trainingsgegevens die voor een model worden gebruikt.
Welke stappen kunnen bedrijven nemen om transparantie in AI-systemen te creëren en de risico’s te verminderen die zijn gekoppeld aan het “black box”-probleem?
Begrijp hoe het bedrijf het model gaat gebruiken en welke soorten aansprakelijkheden het kan hebben bij de implementatie, of het nu voor intern gebruik is of voor gebruik door klanten, direct of indirect. Vervolgens moet u begrijpen wat ik de afkomst van de AI-mechanismen noem die worden geïmplementeerd, inclusief beweringen op een modelkaart, resultaten van red-teamproeven, differentiële analyse van het specifieke gebruik van het bedrijf, wat formeel is geëvalueerd en wat de ervaring van anderen is. Interne testing met een uitgebreid testplan in een realistische omgeving is absoluut noodzakelijk. Best practices evolueren in dit nog prille gebied, dus het is belangrijk om bij te blijven.
Hoe kunnen AI-systemen worden ontworpen met ethische richtlijnen in gedachten, en wat zijn de uitdagingen bij het bereiken hiervan in verschillende industrieën?
Dit is een onderzoeksgebied, en velen beweren dat het concept van ethiek en de huidige versies van AI incongruent zijn, aangezien ethiek conceptueel zijn gebaseerd en AI-mechanismen voornamelijk zijn gebaseerd op gegevens. Bijvoorbeeld, eenvoudige regels die mensen begrijpen, zoals “valselijkheid niet toestaan”, zijn moeilijk te waarborgen. Echter, zorgvuldige analyse van interacties en conflicten van doelen in doelgericht leren, uitsluiting van verdachte gegevens en desinformatie, en het opbouwen van regels die het gebruik van uitvoerfilters vereisen die beveiligingshekken afdwingen en testen op schendingen van ethische principes, zoals het aanmoedigen of sympathiseren met het gebruik van geweld in uitvoerinhoud, moet worden overwogen. Evenzo kan rigoureuze testing voor vooroordelen helpen om een model meer in overeenstemming te brengen met ethische principes. Opnieuw, veel van dit kan conceptueel zijn, dus zorg moet worden genomen om de effecten van een bepaalde aanpak te testen, aangezien de AI-mechanismen instructies niet zullen “begrijpen” zoals mensen dat doen.
Wat zijn de belangrijkste risico’s en uitdagingen waar AI in de toekomst mee te maken krijgt, vooral nu het meer geïntegreerd raakt met IoT-systemen?
We willen AI gebruiken om systemen te automatiseren die kritieke infrastructuurprocessen optimaliseren. Bijvoorbeeld, we weten dat we energiedistributie en -gebruik kunnen optimaliseren met behulp van virtuele krachtcentrales, die duizenden elementen van energiproductie, -opslag en -gebruik coördineren. Dit is alleen praktisch met massive automatisering en het gebruik van AI om te helpen bij minuutbeslissingen. Systemen zullen agents bevatten met conflicterende optimalisatiedoelen (bijv. voor het voordeel van de consument versus de leverancier). AI-veiligheid en -beveiliging zullen kritisch zijn bij de grootschalige implementatie van dergelijke systemen.
Wat voor soort infrastructuur is nodig om entiteiten in AI-systemen veilig te identificeren en te authenticeren?
We zullen een robuuste en efficiënte infrastructuur nodig hebben waarbij entiteiten die betrokken zijn bij de evaluatie van alle aspecten van AI-systemen en hun implementatie, autoritaire en geauthenticeerde claims over AI-systemen, hun afkomst, beschikbare trainingsgegevens, de herkomst van sensorgegevens, beveiligingsincidenten en -gebeurtenissen, enz. kunnen publiceren. Die infrastructuur zal ook moeten zorgen voor een efficiënte manier om claims en beweringen te verifiëren door gebruikers van systemen die AI-mechanismen bevatten en door elementen binnen geautomatiseerde systemen die beslissingen nemen op basis van uitvoer van AI-modellen en -optimalisatoren.
Kunt u ons enkele inzichten geven in wat u bij Intertrust aan het werken bent en hoe dit past in wat we hebben besproken?
We onderzoeken en ontwerpen technologie die de soort vertrouwensbeheersinfrastructuur kan bieden die in de vorige vraag is vereist. We richten ons specifiek op problemen van schaal, latentie, beveiliging en interoperabiliteit die ontstaan in IoT-systemen die AI-componenten bevatten.
Hoe zorgt Intertrust’s PKI (Public Key Infrastructure) -dienst voor de beveiliging van IoT-apparaten, en wat maakt het schaalbaar voor grote implementaties?
Onze PKI was specifiek ontworpen voor vertrouwensbeheer voor systemen die de governance van apparaten en digitale inhoud omvatten. We hebben miljarden cryptografische sleutels en certificaten geïmplementeerd die naleving waarborgen. Ons huidige onderzoek richt zich op de schaal en waarborgen die massive industriële automatisering en kritieke wereldwijde infrastructuur vereisen, inclusief best practices voor “zero-trust”-implementaties en apparaat- en gegevensauthenticatie die triljoenen sensoren en gebeurtenisgeneratoren kunnen accommoderen.
Wat motiveerde u om deel te nemen aan NIST’s AI-initiatieven, en hoe draagt uw betrokkenheid bij aan het ontwikkelen van betrouwbare en veilige AI-standaarden?
NIST heeft enorm veel ervaring en succes in het ontwikkelen van standaarden en best practices in beveiligde systemen. Als Principal Investigator voor de US AISIC van Intertrust, kan ik belangrijke standaarden en best practices in vertrouwensbeheerssystemen die AI-mechanismen bevatten, bevorderen. Op basis van eerdere ervaring, waardeer ik vooral de aanpak die NIST hanteert om creativiteit, vooruitgang en industriële samenwerking te bevorderen, terwijl het helpt om belangrijke technische standaarden te formuleren en te verspreiden die interoperabiliteit bevorderen. Deze standaarden kunnen de adoptie van gunstige technologieën stimuleren, terwijl ze de soorten risico’s aanpakken die de samenleving tegenkomt.
Bedankt voor het geweldige interview, lezers die meer willen leren, kunnen Intertrust bezoeken.


