
Interviews
Ben Koska, Oprichter en CEO van SF Tensor – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
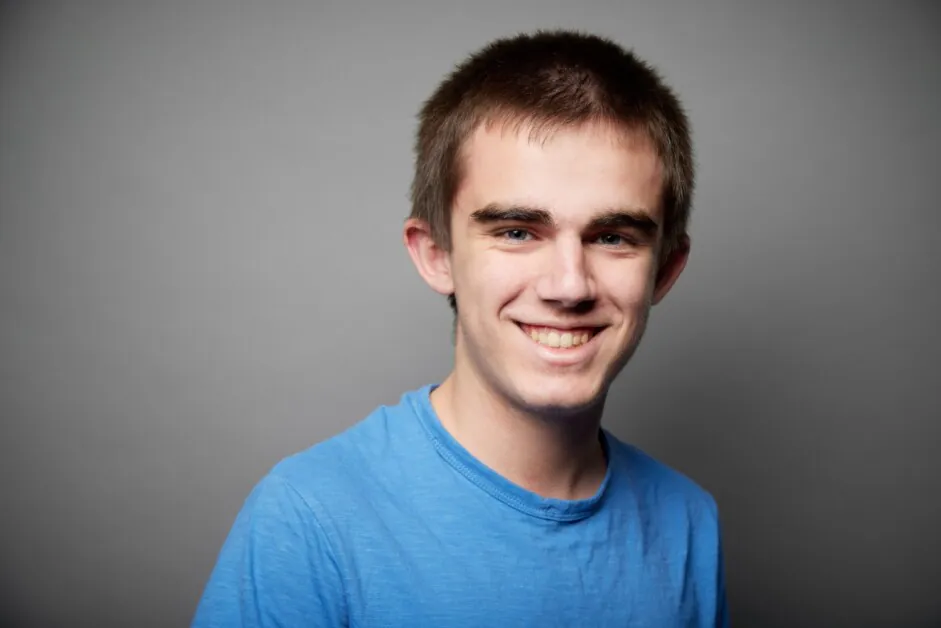
Ben Koska, Oprichter en CEO van SF Tensor, is een AI-onderzoeker en systeemingenieur bekend van zijn werk aan high-performance compute, kernel-optimalisatie en efficiënte modeltraining. Zijn achtergrond omvat het ontwikkelen van low-level AI-infrastructuur, het verbeteren van de trainingsdoorvoer en het ontwerpen van tools die geavanceerde modelontwikkeling toegankelijk maken zonder zware technische overhead. Hij richt zich op het bouwen van systemen die de grenzen van snelheid, portabiliteit en betrouwbaarheid over heterogene hardware heen pushen.
SF Tensor is het bedrijf dat hij leidt om die filosofie om te zetten in een praktisch platform. Het introduceert een uniform programmeringsmodel, een kernel-optimalisator en een cross-cloud-orkestratielaag ontworpen om de complexiteit van gedistribueerde AI-werklasten te verwijderen. Het platform heeft als doel om ingenieurs een schone, hardware-agnostische omgeving te geven waarin ze één keer kunnen schrijven, overal kunnen implementeren en automatisch hoge prestaties kunnen bereiken. De missie van SF Tensor is om AI-compute dramatisch sneller, gemakkelijker te beheren en vrij te maken van vendor-lock-in te maken.
U heeft SF Tensor opgericht op 19-jarige leeftijd, nadat u al leiding had gegeven aan meerdere startups. Wat inspireerde u om de uitdaging aan te gaan om AI-infrastructuur op zo jonge leeftijd te vernieuwen?
Het probleem dat we oplossen, is een dat ik diep van binnen voel, omdat het een probleem is dat ik zelf heb meegemaakt. Toen we wat nu de core-stack van SF Tensor is, ontwikkelden, werkten we niet aan een commercieel project, het was eigenlijk een academisch project. We hadden een subsidie ontvangen om interessant onderzoek te doen, maar we besteedden de meeste tijd aan het worstelen met infrastructuur en optimalisaties, in plaats van onderzoek te doen. We ontdekten dat mensen veel meer geïnteresseerd waren in onze infrastructuurtechnologie dan in ons onderzoeksproject.
SF Tensor tackelt een van de moeilijkste problemen in AI — het breken van NVIDIA’s CUDA-dominantie. Hoe bent u een systeem gaan ontwerpen dat ware hardware-portabiliteit kon bereiken zonder prestaties te compromitteren
Uiteindelijk komt alle AI neer op eenvoudige wiskunde. Elk model is in wezen een set van wiskundige operaties die we moeten berekenen om de resultaten te krijgen. Door het primair als een wiskundig probleem te behandelen in plaats van een computerwetenschappelijk probleem, kunnen we de kleinste set van beperkingen op de berekeningen identificeren, vervolgens miljoenen tot miljarden verschillende manieren vinden om die berekeningen om te zetten in machinecode, en de snelste vinden. Dat is gemakkelijker gezegd dan gedaan, want we kunnen niet daadwerkelijk miljarden verschillende programma’s uitvoeren om de snelste te vinden, dus om onze zoekruimte te snoeien, moesten we een accurate wiskundig model ontwikkelen om de snelheid van een gegeven programma voor een gegeven hardware te schatten, wat een van de kerninnovaties is die ons werk vandaag mogelijk maken.
Het bedrijfsblog benadrukt innovaties rond compiler-optimalisatie en cross-cloud-orkestratie. Kunt u uitleggen hoe SF Tensor’s aanpak verschilt van bestaande frameworks zoals PyTorch of JAX?
We hebben nog geen technisch blog over het onderwerp geschreven, maar we ondersteunen eigenlijk frameworks zoals PyTorch en JAX, waardoor code die in deze frameworks is geschreven, kan worden geoptimaliseerd door onze stack. Er zijn enkele architectonische beslissingen die JAX en PyTorch hebben genomen die hen onderscheiden van onze stack, maar de meest significante is dat we de hele model als een enkele berekening behandelen die moet worden opgelost, in plaats van individuele modules die afzonderlijk en vervolgens gezamenlijk moeten worden geoptimaliseerd. Om die reden passen we traditionele compiler-optimalisatietechnieken niet toe en proberen we geen individuele optimalisaties toe te passen, maar creëren we in plaats daarvan een zoekruimte van miljoenen tot soms miljarden potentieel kernels en beweren we dat geen mens een set van regels kan bedenken om elke gegeven code om te zetten in de snelste, dus we moeten gewoon elke combinatie creëren en vervolgens de snelste identificeren.
Veel startups zijn gericht op trainings-efficiëntie, maar u hebt de “infrastructuurtaks” benadrukt — de tijd die onderzoekers verliezen door compute te beheren in plaats van te innoveren. Hoe adresseert SF Tensor deze onevenwichtigheid?
We geloven dat beide problemen moeten worden aangepakt, en veel van ons werk is gericht op het aanpakken van trainings-efficiëntie, maar het meest acute probleem dat we nu kunnen oplossen zonder afhankelijk te zijn van toekomstige innovaties, is de infrastructuurtaks, omdat het een probleem is dat we al voor onszelf hebben opgelost.
U hebt vermeld dat u tot 80% reductie in trainingskosten heeft bereikt. Welke specifieke optimalisaties of architectonische doorbraken maken dit mogelijk?
Onze hele software-stack is gebouwd op het idee dat een zoek-gebaseerde compiler altijd zal winnen van menselijk gecreëerde regels. Tot nu toe is de grootste beperking op deze compilers het feit dat het niet mogelijk is om miljoenen of zelfs miljarden kernels te benchmarken en te rangschikken. Het was daarom noodzakelijk voor ons om een wiskundig model van compute te creëren dat in staat is om de tijd die een gegeven berekening of set van berekeningen zal duren op een gegeven hardware, nauwkeurig te schatten. Door dit te doen, kunnen we onze zoekruimte uitbreiden en vervolgens snoeien, wat een noodzaak is als je de snelste kernels consistent wilt vinden.
Hoe beïnvloedt uw achtergrond in het bouwen van de Emma-programmeertaal de architectuur en filosofie van SF Tensor ten aanzien van prestaties en abstractie?
Vertel het mijn investeerders niet, maar in mijn hart ben ik nog steeds een compiler-ingenieur. Ik ben altijd geïnteresseerd geweest in het vinden van verschillende manieren om dingen nog maar een beetje sneller te maken. Bij het ontwikkelen van Emma hebben we de hele compiler 4 of 5 keer weggegooid; we zijn van scratch begonnen, elke keer omdat we een optimalisatie tegenkwamen die we niet konden implementeren gegeven de huidige beperkingen, waardoor we het systeem moesten herschrijven om nog algemener te zijn, terwijl we nog steeds in staat waren om naar het laagste niveau van optimalisatie te gaan wanneer nodig, vaak tegen de gebruikelijke principes van compiler- en taalontwerp in. Die kennis en de resulterende architectuur, die bijna twee jaar van wat leek op kleine optimalisaties en verkeerde weddenschappen was, heeft zich opgehoopt tot een systeem dat ons nu in staat stelt om sneller te itereren en beter te optimaliseren dan enig ander systeem dat de gebruikelijke principes volgt, omdat die principes fundamenteel zijn ontworpen voor CPUs, niet voor GPUs en AI-modellen.
U heeft gewerkt aan grote trainingsruns over 4.000+ GPUs — wat waren enkele van de grootste lessen die u hebt geleerd over het beheren van compute op die schaal?
Een belangrijke les is dat hardware-fouten veel vaker voorkomen en veel problematischer zijn dan men zou denken. Ik heb veel tijd besteed aan het werken met traditionele programma’s en compilers, en over het algemeen doet een computer precies wat hem wordt opgedragen, en als er iets misgaat, is het bijna altijd de schuld van de persoon die de code heeft geschreven. Met GPUs is hardware-fouten echter een veelvoorkomend probleem, vooral bij gedistribueerde trainingsruns op extreem grote clusters. Daarbij gaat het feit dat, in tegenstelling tot CPUs die over het algemeen deterministisch en voorspelbaar gedragen, GPUs soms onverklaarbaar dingen doen, zoals het verlagen van de kloksnelheid zonder duidelijke reden, waardoor het hele trainingsproces vertraagt omdat een enkele chip langzamer loopt.
Y Combinator heeft enkele van de meest transformatieve infrastructuurbedrijven in de technologie gesponsord. Hoe heeft die ervaring uw aanpak beïnvloed om SF Tensor’s product en visie te schalen?
Voordat ik bij Y Combinator kwam, dacht ik dat de weddenschap die we wilden plaatsen toen ambitieus was. Na een paar weken was onze definitie van ambitieus echter drastisch veranderd, en we hebben onze inzet verdubbeld op een nog grotere weddenschap. Bovendien heeft de zin voor gemeenschap en leren die ik kan opnemen door de telefoon of per e-mail naar vrijwel elk bedrijf of persoon te sturen en binnen enkele uren of dagen antwoord en advies te ontvangen, onze manier van denken over het aanpakken van problemen en het omarmen van een veel meer collaboratieve aanpak veranderd.
Als we vooruitkijken, heeft u interesse getoond in non-LLM-modellen, robotica en synthetische gegevens. Hoe passen deze gebieden in uw langetermijnvisie voor het bedrijf?
LLM’s zijn absoluut een interessante technologie en zullen een integraal onderdeel zijn van hoe de wereld er in de toekomst uitziet, maar de reden waarom ze zo veel verder zijn dan enig ander gebied van AI, komt voornamelijk door het feit dat er veel geld in hun ontwikkeling wordt geïnvesteerd, en dat er genoeg mensen samenwerken aan het probleem, waardoor ze redelijk geoptimaliseerd zijn. Stel dat we de drempel voor toegang kunnen verlagen, waardoor onderzoekers over de hele wereld, zelfs met beperkte middelen en weinig tot geen kennis van optimalisaties, hun onderzoek zo goedkoop en efficiënt mogelijk kunnen uitvoeren. Dan denk ik dat we een hele nieuwe generatie modellen zullen zien opkomen die problemen zullen aanpakken die LLM’s niet geschikt voor zijn, ofwel omdat ze met de fysieke wereld interactie hebben, ofwel omdat ze problemen zijn die niet goed in taal kunnen worden uitgedrukt.
Wat denkt u dat de AI-infrastructuurstapel er over vijf jaar uit zal zien — en waar ziet u SF Tensor’s rol daarin?
Over vijf jaar hoop ik dat veel meer bedrijven hun eigen gespecialiseerde chips hebben ontwikkeld en uitgebracht, en dat onderzoekers in staat zullen zijn om ze te benutten en te gebruiken zonder dat ze specifiek voor hen hoeven te programmeren, idealiter zonder zelfs maar te weten dat ze bestaan. Dat is de toekomst waar we naar toe werken en waarvan ik geloof dat we een significante rol zullen spelen in het vormgeven.
Bedankt voor het geweldige interview, lezers die meer willen leren, kunnen SF Tensor bezoeken op SF Tensor.


