AI 기초
전이 학습이란 무엇인가?

 Unite.AI를 Google의 선호 소스에 추가
Transfer learning은 한 문제에 대해 학습한 지식을 재사용하여 관련 문제의 학습을 향상시킵니다. 모든 파라미터를 무작위로 초기화하는 대신, 실무자는 사전 학습된 모델이나 표현을 시작점으로 삼아 목표 작업에 맞게 조정합니다.
이 접근법은 목표 데이터셋이 작거나 라벨링 비용이 높거나, 사전 학습에 필요한 연산량이 목표 팀이 감당하기에 너무 클 때 특히 유용합니다. 모델을 처음부터 학습하는 것이 전이 학습의 대안이며, 전이 학습의 한 종류가 아닙니다.
핵심 요점
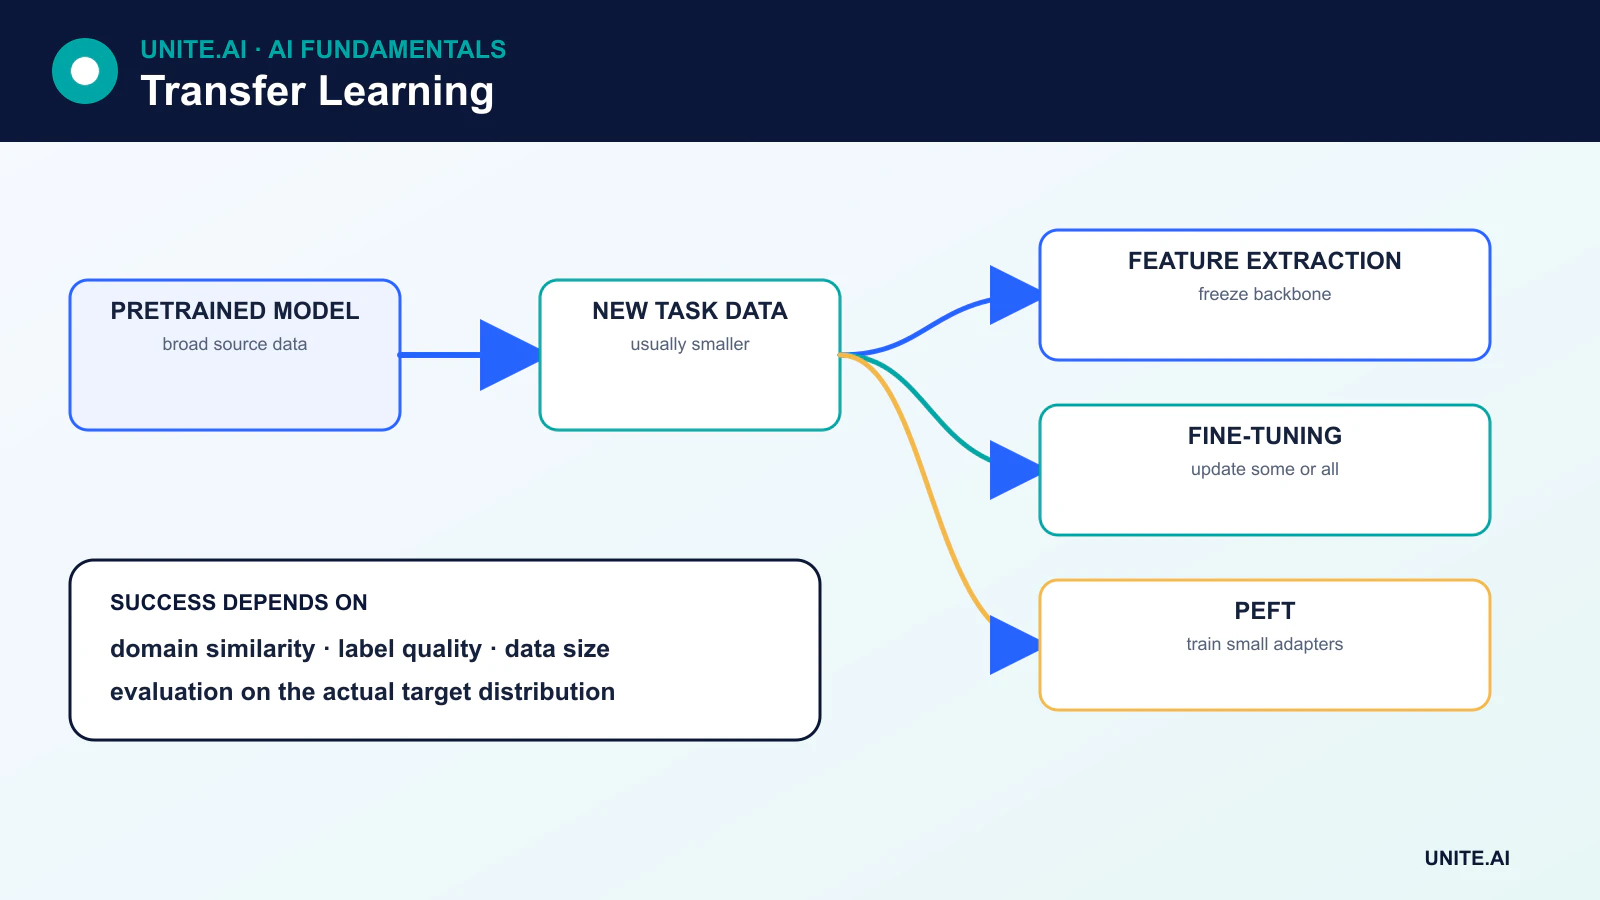
- 특징 추출은 사전 학습된 베이스를 고정하고 새로운 작업 전용 헤드를 학습합니다.
- 미세 조정은 목표 도메인 데이터를 사용해 일부 또는 전체 사전 학습 파라미터를 업데이트합니다.
- 어댑터와 LoRA와 같은 파라미터 효율적인 방법은 모델의 작은 부분만 업데이트합니다.
- 소스와 목표 도메인이 다르거나 라이선스가 충돌하거나 소스 모델에 부적절한 편향이 포함된 경우 전이가 실패할 수 있습니다.
전이 학습이 작동하는 이유
모델은 종종 학습된 정확한 데이터 외에도 유용한 표현을 학습합니다. 이미지 모델의 초기 층은 재사용 가능한 로컬 패턴을 포착할 수 있고, 언어 모델은 자체 지도 예측을 통해 구문, 의미 및 광범위한 연관성을 학습합니다. 목표 작업은 이러한 표현을 기반으로 할 수 있어 제한된 예시로 모든 것을 다시 학습할 필요가 없습니다.
이점은 소스와 목표 작업 간의 유사성, 사전 학습의 규모와 품질, 그리고 모델이 어떻게 적응되는지에 따라 달라집니다. 재사용이 보장되는 것은 아니며: 전이된 특징이 무관하거나 오히려 해로울 수도 있습니다.
특징 추출
특징 추출에서는 사전 학습된 베이스가 고정되어 파라미터가 변하지 않습니다. 그 출력은 새로운 분류기, 회귀기 또는 기타 작업 전용 헤드의 입력이 됩니다. 새로운 헤드만 학습됩니다.
이는 빠르고 데이터 효율적이며 유용한 사전 학습 표현이 손상될 위험을 줄입니다. 그러나 목표 도메인이 사전 학습과 크게 다를 경우 과소 적합될 수 있습니다. 배치 정규화와 같은 층은 저장된 통계와 학습 동작이 대부분의 가중치가 고정되어 있어도 적응에 영향을 미칠 수 있기 때문에 특별한 주의가 필요합니다.
미세 조정
Fine-tuning은 목표 데이터에 대해 사전 학습 파라미터를 업데이트합니다. 일반적인 워크플로는:
- 사전 학습된 모델을 로드하고 출력 헤드를 교체하거나 추가합니다.
- 베이스를 고정하고 새로운 헤드를 학습합니다.
- 선택된 층(또는 전체 모델)을 해제하고 더 작은 학습률로 계속 학습합니다.
- 과적합, 망각, 목표 도메인 성능을 검증합니다.
오직 최종 층만 조정해야 한다는 보편적인 규칙은 없습니다. 최적의 선택은 아키텍처, 목표 데이터 규모, 도메인 유사성, 정규화 층, 메모리 및 연산량에 따라 달라집니다. 전체 미세 조정은 더 큰 용량을 제공하지만 더 많은 자원이 필요하고 파국적인 망각을 일으킬 수 있습니다.
파라미터 효율적 미세 조정
대형 transformer는 전체 미세 조정을 비용이 많이 들게 합니다. 파라미터 효율적 미세 조정(PEFT)은 대부분의 베이스 모델을 고정한 채 작은 파라미터 집합을 수정하거나 추가합니다.
- Adapters는 네트워크에 작은 학습 가능한 모듈을 삽입합니다.
- LoRA는 저랭크 행렬로 가중치 업데이트를 표현하여 학습 가능한 파라미터와 옵티마이저 메모리를 감소시킵니다.
- Prompt and prefix tuning은 연속적인 작업 전용 입력 또는 내부 프리픽스를 학습합니다.
PEFT는 하나의 베이스 모델 주위에 다수의 작업 적응을 저장할 수 있지만, 추론 서비스, 어댑터 호환성 및 병합된 가중치 관리에는 여전히 신중한 엔지니어링이 필요합니다.
데이터 유형 간 전이 학습
이미지 분류기는 일반적으로 대규모 이미지 데이터셋에 사전 학습된 모델에서 시작합니다. 언어 시스템은 기본 모델을 시작점으로 삼아 감독 미세 조정, 선호도 최적화, 검색 또는 도구 사용을 통해 적응합니다. 음성, 오디오, 단백질 및 멀티모달 모델도 유사한 패턴을 따릅니다.
전이는 원본 모델을 변경하지 않고도 발생할 수 있습니다. 고정된 모델은 다운스트림 분류기, 벡터 유사도 검색 시스템 또는 검색 파이프라인을 위한 임베딩을 생성할 수 있습니다.
도메인 이동 및 부정적 전이
Domain shift는 목표 입력이 소스 데이터와 다를 때 발생합니다. 예를 들어 의료 영상 모델은 사전 학습에 포함되지 않은 장비, 인구 집단, 혹은 획득 프로토콜을 마주할 수 있습니다. Negative transfer는 재사용이 목표 성능을 적절한 처음부터 학습한 기준보다 악화시키는 것을 의미합니다.
팀은 적응 전략을 비교하고 의미 있는 하위 그룹을 평가하며 목표 도메인 테스트 세트를 유지해야 합니다. 소스 작업이 부적절하게 매치될 경우, 작은 도메인 특화 모델이 더 큰 일반 모델보다 성능이 좋을 수 있습니다.
라이선스, 출처 및 보안
다운로드 가능한 모델이 자동으로 배포에 안전한 것은 아닙니다. 라이선스, 허용된 사용, 학습 데이터 공개, 모델 카드 제한 사항 및 의존성 체인을 검토하십시오. 모델은 편향을 재현하거나 민감한 데이터를 기억하거나 악의적인 직렬화 코드를 포함할 수 있습니다. 신뢰할 수 있는 형식을 사용하고, 아티팩트를 스캔하며, 신뢰할 수 없는 가중치는 격리된 환경에서 로드하십시오.
전이 학습을 언제 활용할까
관련 사전 학습 모델이 존재하고 목표 데이터가 제한적일 때 전이 학습은 강력한 기본 선택입니다. 도메인이 매우 특수하거나, 라이선스가 호환되지 않거나, 모델 크기가 배포 한도를 초과하거나, 간단한 작업이 대규모 사전 학습 표현의 혜택을 받지 못할 경우 처음부터 학습하는 것이 바람직할 수 있습니다. 결정은 모델 규모만으로 추정하기보다 실증적으로 검증되어야 합니다.
무엇이 전이되고 어떻게 적응시킬까
전이 학습은 소스 작업이나 데이터셋에서 학습한 표현을 목표 작업에 재사용합니다. 비전 분야에서는 초기 특징이 종종 가장자리와 질감을 포착하고, 언어 분야에서는 사전 학습 모델이 토큰과 컨텍스트 전반에 걸친 통계적 패턴을 인코딩합니다. 전이는 소스 표현에 목표와 관련된 정보가 포함되어 있을 때 작동하지만, 도메인, 라벨, 모달리티 및 획득 차이가 부정적 전이를 초래할 수 있습니다. 사전 학습된 베이스로 시작하고, 학습 라이선스와 문서를 검토한 뒤, 작은 목표 전용 모델을 처음부터 학습하는 것과 비교하십시오.
특징 추출은 백본을 고정하고 새로운 헤드를 학습합니다; 부분 미세 조정은 선택된 층을 해제합니다; 전체 미세 조정은 전체 모델을 업데이트합니다. 파라미터 효율적 방법은 어댑터나 저랭크 업데이트를 추가해 학습 가능한 파라미터를 줄이지만 반드시 추론 메모리를 감소시키지는 않습니다. 사전 학습 가중치에는 낮은 학습률을 사용하고, 정규화 동작을 유지하며, 필요 시 스케줄, 정규화, 재현 또는 제한된 업데이트로 파국적 망각을 방지하십시오. 목표 검증 데이터에서 체크포인트를 선택하고 작은 목표 데이터셋이 높은 변동성을 보이므로 여러 시드를 테스트하십시오.
데이터, 평가 및 배포 트레이드오프
목표 데이터는 배포 조건과 중요한 하위 그룹을 대표해야 하며, 단순히 편리한 라벨링 샘플이 되어서는 안 됩니다. 주제, 소스, 시간 또는 위치별로 분할하여 관련 예시가 파티션을 교차하지 않도록 하십시오. 도메인 내와 도메인 이동 상황 모두를 테스트하십시오. 고정, 부분 조정, 전체 조정 변형을 품질, 보정, 학습 비용, 지연시간 및 견고성 측면에서 비교하십시오. 평균 점수 향상이 소스 편향에서 유래한 희귀 클래스 손실을 숨길 수 있습니다. 소스 특유의 지름길, 어휘 격차, 센서 차이에 대한 실패 사례를 검토하십시오.
베이스 모델, 가중치, 토크나이저 또는 전처리, 어댑터, 데이터, 라이선스를 하나의 의존성 그래프로 추적하십시오. 호스팅된 베이스 모델은 동작이 변할 수 있고, 오픈 가중치는 공급망 및 패치 책임을 초래할 수 있습니다. 병합되거나 내보낸 아티팩트를 검증하고, 신뢰할 수 없는 출처의 모델 파일을 스캔하십시오. 프로덕션에서는 목표 드리프트와 성능을 모니터링하고, 적응 및 베이스 버전을 모두 롤백할 수 있는 능력을 유지하십시오. 전이는 필요한 목표 데이터를 감소시키지만 라벨링, 평가, 프라이버시 또는 도메인 전문성을 없애지는 못합니다.
실제 예시: 비전 모델을 새로운 클리닉에 적용하기
한 클리닉은 사전 학습된 영상 인코더를 진단 검토 전 이미지 품질을 분류하도록 적용합니다. 소스 모델의 라이선스와 의도된 모달리티를 확인하고, 현지 장비와 획득 조건을 수집하며, 환자별로 데이터를 분할합니다. 고정 특징, 어댑터, 부분 및 전체 미세 조정 변형을 작은 현지 베이스와 비교합니다. 측정 지표에는 클래스 재현율, 보정, 하위 그룹 행동, 계산량, 장치·사이트·희귀 아티팩트에 대한 민감성이 포함됩니다.
적응된 모델은 진단을 내릴 수 없으며, 신뢰도가 낮거나 지원되지 않는 이미지를 기술자에게 전달합니다. 내보내기 검증은 현지 전처리와 수치적 동등성을 확인합니다. 모델, 어댑터, 장치 및 데이터셋 버전은 기록에 연결됩니다. 모니터링은 새로운 스캐너, 프로토콜 변경 및 출력 드리프트를 감지하고, 정기적인 검토 샘플을 통해 실제 성능을 추정합니다. 소스 모델 업그레이드는 새로운 의존성으로 간주되어 검증이 필요하며, 전이 학습이 자동으로 오래된 증거 재사용을 정당화하지는 않습니다.
구현 증거 및 운영 준비성
프로덕션 의사결정은 성공적인 시연 이상의 것이 필요합니다. 의도된 사용자, 운영 환경, 입력·출력, 의존성, 소유자 및 각 주요 실패의 결과를 정의하십시오. 튜닝 전에 재현 가능한 베이스라인과 버전 관리된 평가 세트를 마련하십시오. 일반 사례, 경계 조건, 형식이 잘못되었거나 누락된 입력, 분포 이동, 의존성 장애, 오용 및 가장 소외될 가능성이 높은 그룹·환경을 테스트하십시오. 작업 품질을 보정·불확실성, 지연시간, 처리량, 자원 비용, 접근성, 프라이버시 및 보안과 함께 측정하십시오. 모든 변환과 임계값을 기록해 독립적인 검토자가 결과를 재현하고 매력적인 프로토타입과 증거를 구분할 수 있게 하십시오.
출시 전에는 릴리스, 예외, 변경, 롤백 및 폐기에 대한 권한을 지정하십시오. 단계적 롤아웃을 사용하고 안전한 폴백을 유지하며, 의도적으로 삽입한 실패를 통해 모니터링을 검증하십시오. 운영 텔레메트리는 불필요한 민감 데이터를 수집하지 않으면서 입력 품질, 출력 행동, 모델·규칙 버전, 의존성 상태, 인간 개입 및 확인된 결과를 보여야 합니다. 알림 임계값과 대응 담당자를 정의하고, 배포 후 실제 증거를 검토하십시오. 데이터 소스, 사용자, 모델, 공급업체, 정책, 하드웨어 또는 목표가 변경될 때마다 재평가하십시오. 유지되는 시스템은 문서화된 복구, 사고 학습, 삭제·보존 절차 및 시스템을 중단하거나 교체해야 하는 명확한 시점을 필요로 합니다.
주요 참고문헌