
Anderson의 관점
엔비디아의 eDiffi 확산 모델은 ‘단어로 그림 그리기’와 더 많은 것을 가능하게 합니다

 Unite.AI를 Google의 선호 소스에 추가
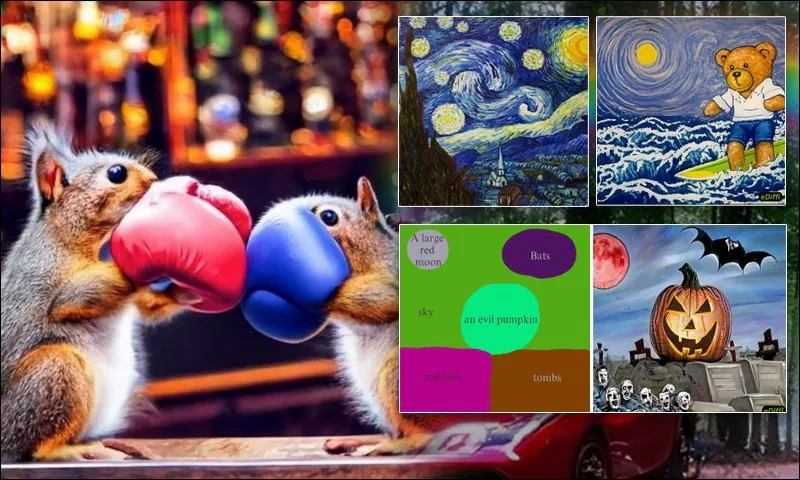
핵심 포인트NVIDIA의 eDiffi는 전문가 노이즈 제거기 앙상블을 사용하여 뛰어난 텍스트-이미지 제어를 제공합니다.
더 보기
- NVIDIA의 eDiffi는 전문가 노이즈 제거기 앙상블을 사용하여 뛰어난 텍스트-이미지 제어를 제공합니다.
- 이 모델은 T5와 CLIP 인코더를 통합하여 세부 디테일과 전체 구성을 개선합니다.
- eDiffi는 색상을 프롬프트 요소에 매핑하여 정확한 레이아웃을 구현함으로써 단어로 그림을 그리는 기능을 가능하게 합니다.
Stable Diffusion 같은 잠재 확산 기반 생성 이미지 모델로 정확한 구도를 만드는 것은 고양이 떼를 모는 일처럼 어렵습니다. 비교적 단순한 텍스트 프롬프트에서 놀라운 세부와 이미지를 만들어 내는 상상력과 해석 능력은 Photoshop 수준의 제어를 원할 때 끄기도 어렵습니다.
NVIDIA (NVDA ) 연구진의 새로운 접근법인 ensemble diffusion for images(eDiffi)는 처리 과정 내내 같은 방법을 쓰는 대신 여러 임베딩과 해석 방법을 결합해 생성 콘텐츠를 훨씬 더 세밀하게 제어합니다. 아래에서는 사용자가 프롬프트의 단어 하나를 색상 하나에 대응시켜 요소를 칠합니다.
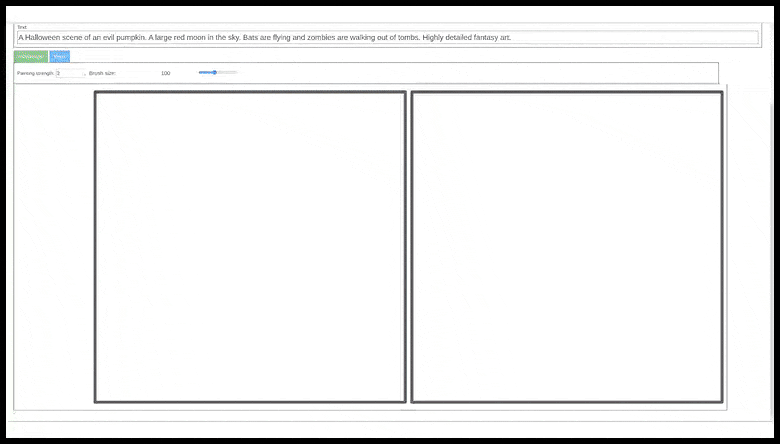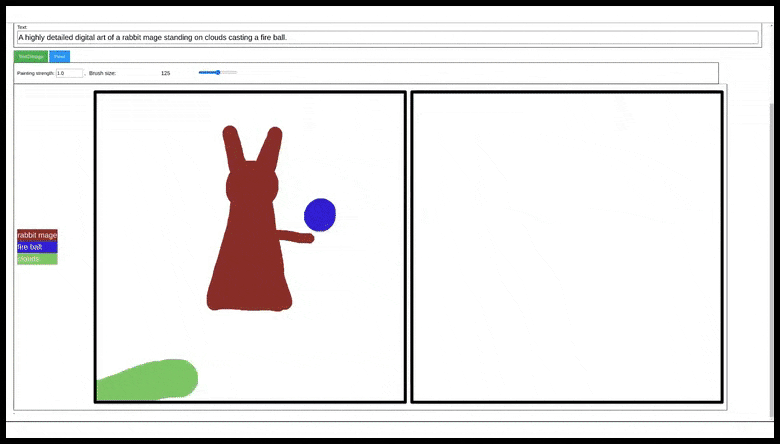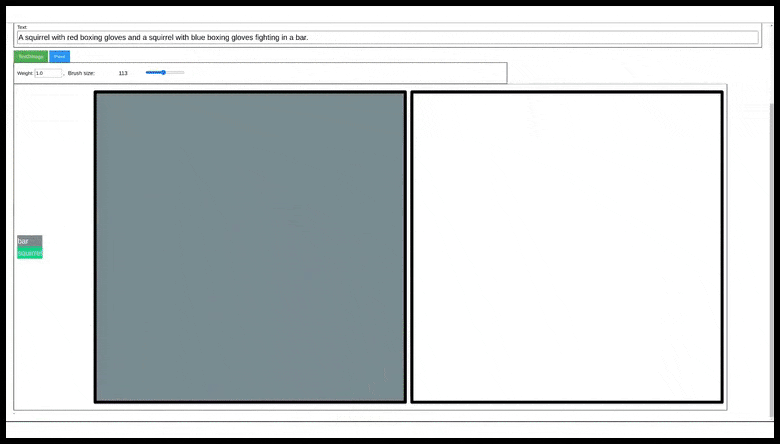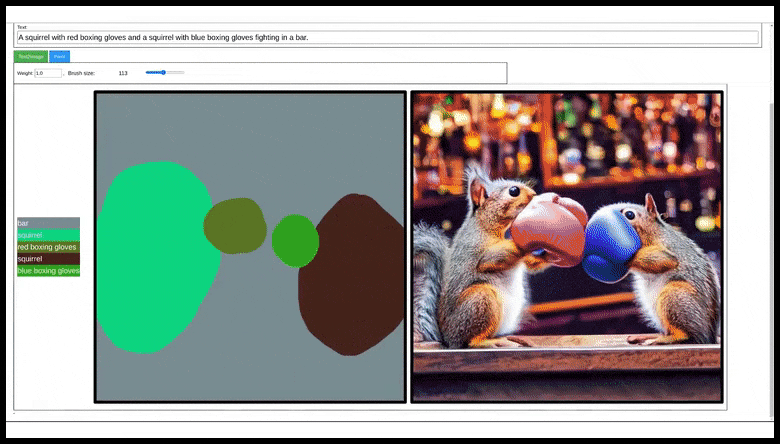
단어로 그리기는 NVIDIA eDiffi의 두 가지 새로운 기능 중 하나입니다. 칠한 색마다 프롬프트의 한 단어가 대응하며, 생성 중 왼쪽에 표시됩니다. 색칠한 영역에는 해당 요소만 들어갑니다. 더 많은 예와 높은 해상도는 공식 영상을 참조하십시오. https://www.youtube.com/watch?v=k6cOx9YjHJc
이는 사실상 마스크로 그리기이며, Stable Diffusion의 인페인팅 방식을 뒤집습니다. 인페인팅은 손상되거나 마음에 들지 않는 이미지를 고치거나, 처음부터 원하는 크기로 만들 수도 있었던 이미지를 확장하는 방식입니다.
여기서는 색칠한 부분의 가장자리가 한 개념에 해당하는 단일 요소의 대략적인 허용 경계를 정합니다. 따라서 사용자는 처음부터 최종 캔버스 크기를 정하고 요소를 개별적으로 추가할 수 있습니다.

새 논문의 예시입니다. 출처: https://arxiv.org/pdf/2211.01324.pdf
eDiffi의 다양한 방법은 길고 자세한 프롬프트의 모든 요소를 반영하는 데에도 유리합니다. Stable Diffusion과 OpenAI의 DALL-E 2는 목표 단어가 얼마나 일찍 등장하는지, 또는 프롬프트에 충실하고 완전한 구도를 위해 여러 요소를 분리하기가 얼마나 어려운지 등에 따라 특정 부분을 우선시하는 경향이 있습니다.

논문에서: eDiffi는 가능한 한 많은 요소를 그릴 때까지 프롬프트를 더 철저하게 처리합니다. 맨 오른쪽 열의 향상된 eDiffi 결과는 유리하게 선별된 것이지만, Stable Diffusion과 DALL-E 2의 비교 이미지도 마찬가지로 선별되었습니다.
전용 T5 텍스트 대 텍스트 인코더 덕분에 eDiffi는 읽을 수 있는 영어 문구를 그릴 수 있습니다. 이미지에 [x]라는 문구가 있다처럼 추상적으로 요청하거나, 티셔츠에 Nvidia Rocks라고 적혀 있다처럼 명시적으로 요청할 수 있습니다.

eDiffi의 전용 텍스트 대 텍스트 처리는 이미지에 문구를 그대로 표시할 수 있게 합니다. 출력을 망가뜨리는 텍스트 대 이미지 해석 계층만 거치는 방식과 다릅니다.
또 다른 이점은 한 장의 이미지로 스타일을 지정할 수 있다는 것입니다. 어떤 장르나 스타일의 여러 예시로 DreamBooth 모델이나 텍스트 임베딩을 훈련할 필요가 없습니다.

참조 이미지의 스타일을 텍스트 대 이미지 프롬프트나 이미지 대 이미지 프롬프트에 적용할 수 있습니다.
새 논문 제목은 eDiffi: 전문 노이즈 제거기 앙상블을 활용한 텍스트 대 이미지 확산 모델입니다.
T5 텍스트 인코더
Google의 Text-to-Text Transfer Transformer(T5)가 eDiffi의 향상된 결과를 만드는 핵심입니다. 일반적인 잠재 확산 파이프라인은 훈련 이미지와 인터넷에서 수집될 당시의 캡션 간 연관성에 집중합니다. 나중에 사람이 캡션을 수정할 수도 있지만, 비용이 많이 들어 드문 작업입니다.

2020년 7월 T5 논문의 텍스트 기반 변환입니다. eDiffi 및 다른 잠재 확산 모델의 이미지 생성 워크플로를 지원할 수 있습니다. 출처: https://arxiv.org/pdf/1910.10683.pdf
원본 텍스트를 바꾸어 표현하고 T5 모듈을 실행하면, 모델이 처음 학습한 것보다 더 정확한 연관성과 표현을 얻을 수 있습니다. 사후 수동 라벨링과 비슷하며, 요청된 프롬프트의 조건에 더 구체적으로 맞출 수 있습니다.
저자들은 다음과 같이 설명합니다.
“기존 확산 모델 연구 대부분은 모든 노이즈 수준에서 같은 노이즈 제거 모델을 사용합니다. 시간 변화는 MLP 네트워크를 통해 모델에 전달되는 단순한 시간 임베딩으로 나타냅니다. 용량이 제한된 공유 모델은 노이즈 제거 확산의 복잡한 시간 변화를 데이터에서 효율적으로 학습하지 못할 수 있다고 봅니다.
“대신 전문 노이즈 제거기 앙상블을 도입해 모델 용량을 늘릴 것을 제안합니다. 각 전문가는 특정 노이즈 수준 범위를 담당합니다. 각 수준에서 처리 요소를 평가하는 계산 복잡도가 같으므로, 샘플링 속도를 늦추지 않고도 모델 용량을 늘릴 수 있습니다.”

eDiffi의 개념적 작업 흐름입니다.
DALL-E 2와 Stable Diffusion의 기존 CLIP 인코딩 모듈도 사용자 입력 텍스트에 대해 다른 이미지 해석을 찾을 수 있습니다. 그러나 원래 모델과 비슷한 정보로 훈련되며, eDiffi의 T5처럼 별도 해석 계층으로 쓰이지 않습니다.
저자들에 따르면 eDiffi는 T5와 CLIP 인코더를 한 파이프라인에 통합한 첫 사례입니다.
“두 인코더는 다른 목표로 훈련되어 같은 입력 텍스트에서도 서로 다른 이미지 형성을 선호합니다. CLIP 텍스트 임베딩은 생성 이미지의 전체적인 모습을 정하는 데 도움이 되지만, 출력은 텍스트의 세밀한 내용을 놓치는 경향이 있습니다.
“반면 T5 텍스트 임베딩만으로 만든 이미지는 텍스트의 개별 객체를 더 잘 반영하지만 전체 모습은 덜 정확합니다. 둘을 함께 사용할 때 우리 모델에서 가장 좋은 이미지 생성 결과가 나옵니다.”
확산 과정의 중단과 보강
논문은 일반적인 잠재 확산 모델이 생성 초기에는 오직 텍스트에 의존해 순수한 노이즈에서 이미지로 가는 과정을 시작한다고 설명합니다.
노이즈가 프롬프트의 설명을 반영한 대략적인 구도가 되면 텍스트가 이끄는 부분은 사실상 사라지고, 나머지 과정은 시각적 특성을 보강하는 데 집중합니다.
따라서 텍스트로 노이즈를 해석하는 초기에 결정되지 않은 요소는 나중에 추가하기 어렵습니다. 텍스트에서 구도로, 구도에서 이미지로 이어지는 두 과정의 겹침이 작고, 이미지 보강에 도달할 즈음에는 기본 구도가 이미 상당히 얽혀 있기 때문입니다.

논문의 단계별 어텐션 맵입니다. 노이즈에서 이미지로 가는 과정이 진행되면서 아래 행의 CLIP 영향은 급격히 줄지만, T5는 렌더링 과정의 훨씬 뒤까지 이미지에 영향을 줍니다.
전문적 활용 가능성
프로젝트 페이지와 YouTube 영상은 홍보하기 좋은 귀여운 밈 이미지 생성에 집중합니다. 평소처럼 NVIDIA 연구는 최신 기술의 사실적 이미지 및 VFX 워크플로 개선 가능성과 deepfake 이미지·영상 개선 가능성을 덜 강조합니다.
예시에서는 초보자나 아마추어가 요소의 위치를 대략적으로 그립니다. 더 체계적인 VFX 워크플로에서는 정확한 윤곽을 바탕으로 eDiffi가 텍스트 대 이미지 방식으로 영상 요소의 여러 프레임을 해석하게 할 수 있습니다. 예컨대 그린 스크린이나 알고리즘으로 배경을 제거한 인물의 윤곽을 쓸 수 있습니다.

Runway ML은 이미 AI 로토스코핑을 제공합니다. 이 예시에서 피사체 주변의 그린 스크린은 알파 계층을 나타내며, 분리는 실제 녹색 배경을 알고리즘으로 지운 것이 아니라 머신러닝으로 수행했습니다. 출처: https://twitter.com/runwayml/status/1330978385028374529
훈련된 DreamBooth 캐릭터와 eDiffi의 이미지 대 이미지 파이프라인을 사용하면 모든 잠재 확산 모델의 난제인 시간적 안정성을 다루기 시작할 수 있습니다. 적용할 이미지의 경계와 내용은 사용자 캔버스에 대해 미리 배치됩니다. 훈련 데이터를 기억한 고정 DreamBooth 모델이 실제 태극권 수련자를 로봇으로 바꾸는 등의 생성 콘텐츠에 시간적 연속성을 제공할 수 있습니다. 해석 가능성에는 나쁘지만 재현성, 충실도, 연속성에는 좋습니다.
방법, 데이터 및 시험
eDiffi는 공개 및 독점 데이터셋의 모음으로 훈련됐습니다. 사전 훈련된 CLIP 모델로 강하게 필터링해 전반적인 미적 점수를 낮출 이미지를 제거했습니다. 최종 데이터는 약 10억 개의 텍스트·이미지 쌍이며, 훈련 이미지의 가장 짧은 변은 64픽셀보다 깁니다.
여러 모델을 훈련했습니다. 기본 모델과 초해상도 모델은 모두 AdamW 옵티마이저, 학습률 0.0001, 가중치 감쇠 0.01, 배치 크기 2048을 사용했습니다.
기본 모델은 NVIDIA A100 GPU 256개로, 두 초해상도 모델은 각각 NVIDIA A100 GPU 128개로 훈련했습니다.
NVIDIA의 Imaginaire PyTorch 라이브러리를 사용했습니다. COCO와 Visual Genome은 평가에 사용했고 최종 모델의 훈련에는 포함하지 않았습니다. 시험에는 MS-COCO 변형을 사용했습니다. 비교 대상은 GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion, Google의 Imagen과 Parti입니다.
유사한 선행 연구와 마찬가지로 zero-shot FID-30K를 평가에 사용했습니다. COCO 검증 세트에서 훈련에 쓰인 이미지나 텍스트가 아닌 캡션 30,000개를 무작위로 뽑아 이미지 합성용 텍스트 프롬프트로 사용했습니다.
생성 이미지와 실제 참조 이미지 사이의 Fréchet Inception Distance(FID)를 계산하고, 생성 이미지의 CLIP 점수도 기록했습니다.

COCO 2014 검증 데이터에서 최신 기법과 비교한 zero-shot FID 시험 결과입니다. 낮은 값이 더 좋습니다.
eDiffi는 파라미터가 훨씬 많은 시스템과 비교해도 가장 낮은, 즉 가장 좋은 zero-shot FID를 얻었습니다. Parti는 200억 개의 파라미터를 가지며, 시험용 최고 사양 eDiffi 모델은 91억 개입니다.
결론
eDiffi는 기존 시스템에 데이터와 복잡성을 계속 늘리는 대신, 더 지능적이고 계층적인 접근을 택합니다. 잠재 확산 이미지 생성에서 요소들의 얽힘과 편집 불가능성 같은 어려운 장애물에 대한 반가운 대안입니다.
Stable Diffusion의 subreddit과 Discord에서는 공개될 수 있는 eDiffi 코드를 직접 통합하거나 별도로 원리를 구현하는 방안을 논의하고 있습니다. 그러나 새 파이프라인은 SD에서 전체 버전 번호를 바꿔야 할 정도로 다릅니다. 일부 하위 호환성을 포기해야 하지만, 잠재 확산의 매력적인 상상력을 희생하지 않으면서 최종 이미지의 제어 수준을 크게 높일 수 있습니다.
최초 게시: 2022년 11월 3일.


