
Anderson의 관점
얼굴 외곽 영역으로 유명인 딥페이크 식별하기

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트ICT는 얼굴 교체 인공물이 아닌 내부 및 외부 얼굴 정체성을 비교하여 딥페이크를 탐지합니다.
더 보기
- ICT는 얼굴 교체 인공물이 아닌 내부 및 외부 얼굴 정체성을 비교하여 딥페이크를 탐지합니다.
- 이 방법은 인공물 기반 탐지가 실패하는 저해상도 비디오에서 경쟁사보다 뛰어난 성능을 보입니다.
- ICT는 MS-Celeb-1M 데이터에 의존하기 때문에 공개 이미지가 풍부한 유명인에게만 효과가 제한됩니다.
Microsoft (MSFT )와 중국 대학의 새로운 공동 연구는 현재 딥페이크 기법의 한계를 이용해 다른 사람에게 덧씌워진 유명인의 정체성을 식별하는 새로운 방법을 제안했다.
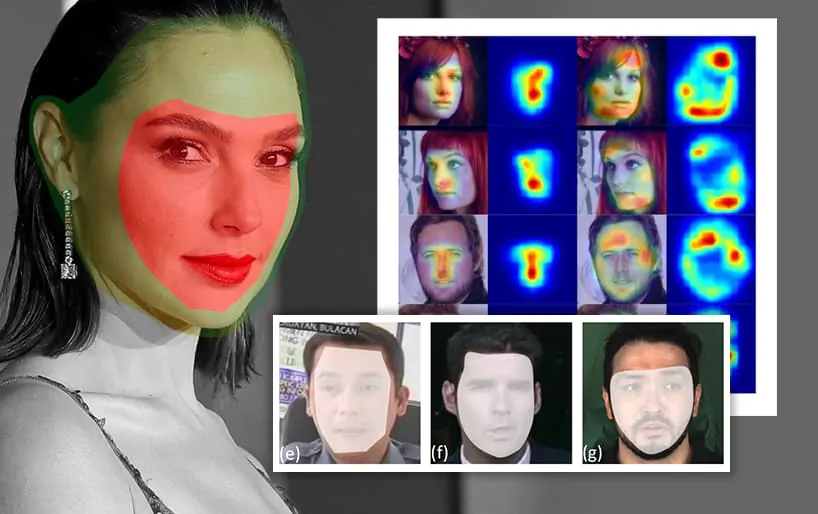
Identity Consistency Transformer(ICT)는 턱, 광대뼈, 헤어라인 등 얼굴 가장자리의 특징과 얼굴 안쪽을 비교한다. 널리 공개된 유명인 사진을 활용하기 때문에, 컴퓨터 비전 데이터셋과 인터넷에 사진이 충분히 많은 유명 인물에 주로 효과적이다.

일곱 기법의 얼굴 위조 범위: FF+와 Google DeepFake Detection의 DeepFake, DeepFaceLab, Face2Face, FSGAN, DF-VAE. DeepFaceLab과 FaceSwap 같은 패키지도 교체 범위가 비슷하게 제한된다. 출처: https://arxiv.org/pdf/2203.01318.pdf
위 그림처럼 널리 쓰이는 딥페이크 기법은 자원 제약이 크며, 얼굴 교체 흔적을 줄이기 위해 적절한 원본 인물의 얼굴에 의존한다. 원본 얼굴은 딥페이크로 정체성이 바뀔 사람의 사진이나 영상 속 얼굴이다.
일부 방법은 이마 전체와 턱·광대뼈의 상당 부분을 바꾸지만, 모두 원본 얼굴의 테두리 안으로 어느 정도 제한된다.

ICT가 계산한 안쪽과 바깥쪽 정체성을 강조한 주목 영역 지도. 안쪽 정체성만 맞고 바깥쪽이 일치하지 않으면 이미지를 가짜로 판단한다.
실험에서 ICT는 저해상도 영상처럼 위조 흔적을 숨기기 쉬운 조건에서도 딥페이크를 탐지했다. 압축 아티팩트가 영상 전체의 품질을 떨어뜨리면 딥페이크 생성 과정의 잔여 흔적도 가려지는데, 많은 경쟁 탐지 방법은 이 조건에서 어려움을 겪는다.

ICT는 경쟁 방법보다 딥페이크 탐지 성능이 우수하다. 추가 사례와 더 높은 해상도는 글 끝의 원본 영상에서 확인할 수 있다. 출처: https://www.youtube.com/watch?v=zgF50dcymj8
논문 제목은 Protecting Celebrities with Identity Consistency Transformer이며, 중국과학기술대학교, Microsoft Research Asia, Microsoft Cloud + AI에 소속된 연구자 아홉 명이 작성했다.
신뢰성의 빈틈
DeepFaceLab과 FaceSwap 같은 얼굴 교체 알고리즘이 얼굴 가장자리를 충분히 처리하지 않는 데에는 적어도 두 가지 이유가 있다.
첫째, 딥페이크 모델 훈련에는 시간과 자원이 많이 든다. 서로 잘 맞는 원본 얼굴과 몸을 선택하면 GPU 연산과 훈련 에포크를, 정체성을 구별하는 데 사용하는 비교적 변하지 않는 얼굴 안쪽 특징에 집중할 수 있다. 체중 변화나 노화도 단기간에는 이 핵심 특징을 바꿀 가능성이 상대적으로 낮다.
둘째, 특히 유명하거나 악명 높은 제작자들이 쓰는 DeepFaceLab을 비롯한 대부분의 방법은 볼과 턱 등 얼굴 끝부분을 재현하는 능력이 제한적이다. 기반이 된 2017년 코드는 이 문제를 충분히 다루지 않았다.
두 인물의 정체성이 잘 맞지 않으면 알고리즘이 얼굴 주변 배경을 인페인팅으로 메워야 한다. 논문 연구에 작품이 사용된 Ctrl Shift Face 같은 뛰어난 제작자의 손에서도 이 작업은 기껏해야 서툴게 처리된다.

Ctrl Shift Face가 Jim Carrey의 얼굴을 Gary Oldman에게 입힌 딥페이크의 장면. 당시 DeepFaceLab과 후처리의 뛰어난 사례지만, 얼굴 가장자리에 대한 처리가 제한되어 데이터 선별과 훈련에 막대한 노력이 필요하다. 출처: https://www.youtube.com/watch?v=x8igrh1eyLk
이런 눈속임이나 주의 분산은 딥페이크의 사실성이 높아지는 데 대한 우려 속에서도 대중의 눈을 피하기 쉽다. 딥페이크를 비판적으로 평가하는 능력이 아직 놀라움과 충격의 단계를 넘어 발전하는 중이기 때문이다.
분리된 정체성
논문은 기존 탐지 기법 대부분이 일관되지 않은 머리 자세, 눈 깜박임 등 교체 과정을 드러내는 흔적에 의존한다고 설명한다. 이 밖에도 여러 기법이 있다. 같은 주에 나온 다른 논문은 FaceSwap의 서로 다른 모델 유형이 남기는 특징적 서명을 활용해 해당 프로그램으로 만든 영상을 식별하는 방법을 제안했다.

FaceSwap의 여러 모델이 남기는 고유한 서명을 이용한 딥페이크 식별. 출처: https://arxiv.org/pdf/2202.12951.pdf
반면 ICT는 한 사람에 대해 서로 안팎으로 겹치는 두 정체성을 만든다. 전체 영상이나 이미지를 진짜로 판단하려면 두 정체성 모두 검증되어야 한다.

ICT의 훈련 및 시험 단계 구조.
시각 Transformer는 먼저 얼굴을 식별한 다음, 분석 영역을 안쪽 또는 바깥쪽 정체성에 속하는 토큰으로 나눈다.

두 정체성 표상 사이에 이미지 패치를 분배하는 방식.
논문은 다음과 같이 설명한다.
“안타깝게도 기존 얼굴 검증 방법은 가장 식별력이 높은 영역, 즉 얼굴 안쪽을 중심으로 특징을 표현하며 바깥쪽의 정체성 정보는 포착하지 못하는 경향이 있다. ICT에서는 안쪽과 바깥쪽 얼굴에 해당하는 정체성 벡터 한 쌍을 학습하도록 모델을 훈련한다. 두 정체성이 매끄럽게 통합된 하나의 모델에서 동시에 학습되도록 Transformer를 설계한다.”
이 식별 프로토콜에 사용할 기존 모델이 없으므로 연구진은 진위 판단 척도로 사용할 새로운 일관성 손실을 고안했다. 정체성 추출 모델의 안쪽 토큰과 바깥쪽 토큰은 얼굴 식별 프레임워크가 만드는 기존의 이미지 패치 임베딩에 추가된다.
데이터와 훈련
ICT는 Microsoft Research의 MS-Celeb-1M 데이터셋으로 훈련되었다. 훈련 데이터에는 배우, 정치인 등 유명인10만 명의 얼굴 사진1,000만 장이 들어 있다. Microsoft Research의 이전 방법인 Face X-ray 절차에 따라, ICT의 위조 생성 루틴은 이 데이터셋에서 가져온 얼굴의 안쪽과 바깥쪽 영역을 교체해 알고리즘을 시험할 자료를 만든다.
이를 위해 머리 자세와 얼굴 기준점이 비슷한 사진 두 장을 찾고, 교체할 수 있는 중심 특징 영역의 마스크를 만든 뒤 RGB 색 보정을 적용해 딥페이크 교체를 수행한다.
ICT가 유명인 식별에 제한되는 이유는 가장 효과적인 버전에서 새로운 참조 집합에 의존하기 때문이다. 이 집합은 MS-Celeb-1M 같은 중심 자료에서 도출한 얼굴 벡터를 포함한다. 참조 대상을 인터넷 사진으로 넓힐 수는 있지만, 충분한 품질과 수량의 사진이 존재하는 사람은 주로 잘 알려진 공인일 것이다.
도출된 벡터 쌍은 안쪽과 바깥쪽 얼굴 영역을 함께 검증하는 진위 확인 토큰으로 작동한다.
연구진은 이 토큰이 고수준 특징을 나타내므로 저해상도 또는 다른 방식으로 품질이 떨어진 영상에서도 탐지가 유지될 가능성이 높다고 설명한다.
중요한 점은 ICT가 아티팩트 기반 증거를 찾는 것이 아니라, 얼굴 인식에 더 가까운 정체성 검증에 초점을 맞춘다는 것이다. 유명하지 않은 피해자를 대상으로 한 딥페이크 보복성 음란물 사건처럼 자료가 적은 경우에는 이런 접근이 어렵다.
실험
MS-Celeb-1M으로 훈련한 ICT를 참조 지원 버전과 참조 없이 작동하는 버전으로 나누고 여러 데이터셋과 경쟁 방법에 대해 시험했다. 대상에는 FaceForensics++(FF++), 즉 Face2Face와 FaceSwap을 포함한 네 방법으로 만든 실제·딥페이크 영상1,000개를 담은 데이터셋이 포함됐다. Google의 Deepfake Detection(DFD) 역시 Google이 만든 딥페이크 수천 개로 구성된다. Celeb-DeepFake v1(CD1)은 실제 영상408개와 인위적 흔적이 적은 합성 영상795개, v2는 실제590개와 가짜5,639개를 포함한다. 중국의2020년 Deeper-Forensics(Deeper)도 시험에 사용됐다.
비교한 탐지 방법은 Multi-task, MesoInc4, Capsule, Xception-c0와 c2(FF++에서 사용하는 방법), 올버니대학교의 FWA/DSP-FW, Two-Branch, PCL+I2G, Yuval Nirkin의 맥락 불일치 방법이다.
이 방법들은 특정 얼굴 조작을 찾는 데 초점을 맞춘다. 연구진은 더 일반적인 탐지 방법인 Face X-ray, 미시간주립대학교의 FFD, CNNDetection, MIT CSAIL의 Patch-Forensics도 시험했다.
가장 두드러진 결과는 영상 해상도와 품질이 낮아질수록 경쟁 방법의 효과가 크게 떨어진다는 점이다. 저화질 영상은 딥페이크가 사람의 판별 능력을 속일 위험이 특히 큰 환경이므로 의미 있는 결과다.

위 그래프의 파란색과 빨간색 선은 ICT가 대부분의 영상 열화에 견딘다는 것을 보여준다. 예외는 가우스 잡음으로, Zoom이나 웹캠 영상에서는 발생 가능성이 낮다. 경쟁 방법의 신뢰도는 크게 떨어진다.
아래 표는 이전에 보지 못한 데이터셋에서의 결과다. 회색 및 별표 항목은 외부 검증이 불가능한 비공개 소스 프로젝트가 발표한 결과와의 비교를 뜻한다. 거의 모든 비교 가능한 조건에서 ICT는 굵게 표시된 경쟁 방법보다 뛰어나다.

연구진은 추가로 Ctrl Shift Face의 YouTube 채널 영상을 시험했으며, 경쟁 방법의 식별 점수가 상당히 낮다는 사실을 확인했다.

일반 실험의 일부 데이터에서는 최고 수준 점수를 기록한 FF++ 방법(Xception-c23)과 FFD도, 제작에 큰 노력을 들인 실제 딥페이크 영상에서는 ICT보다 훨씬 낮은 점수를 기록했다.
연구진은 결과가 탐지 연구를 더 일반화하기 쉬운 고수준 특징으로 이끌기를 기대한다. 생성 프레임워크의 발전이나 다른 요인에 의해 최신 탐지법이 계속 무력화되는 아티팩트 탐지의 ‘냉전’에서 벗어나자는 것이다.
다른 방법을 속이는 딥페이크를 ICT가 식별하는 추가 사례는 아래의 보충 영상에서 볼 수 있다.
https://www.youtube.com/watch?v=zgF50dcymj8
2022년3월4일 최초 게시.


