
파트너십
Google Cloud의 NVIDIA Vera Rubin A5X 인스턴스 첫 가동

 Unite.AI를 Google의 선호 소스에 추가
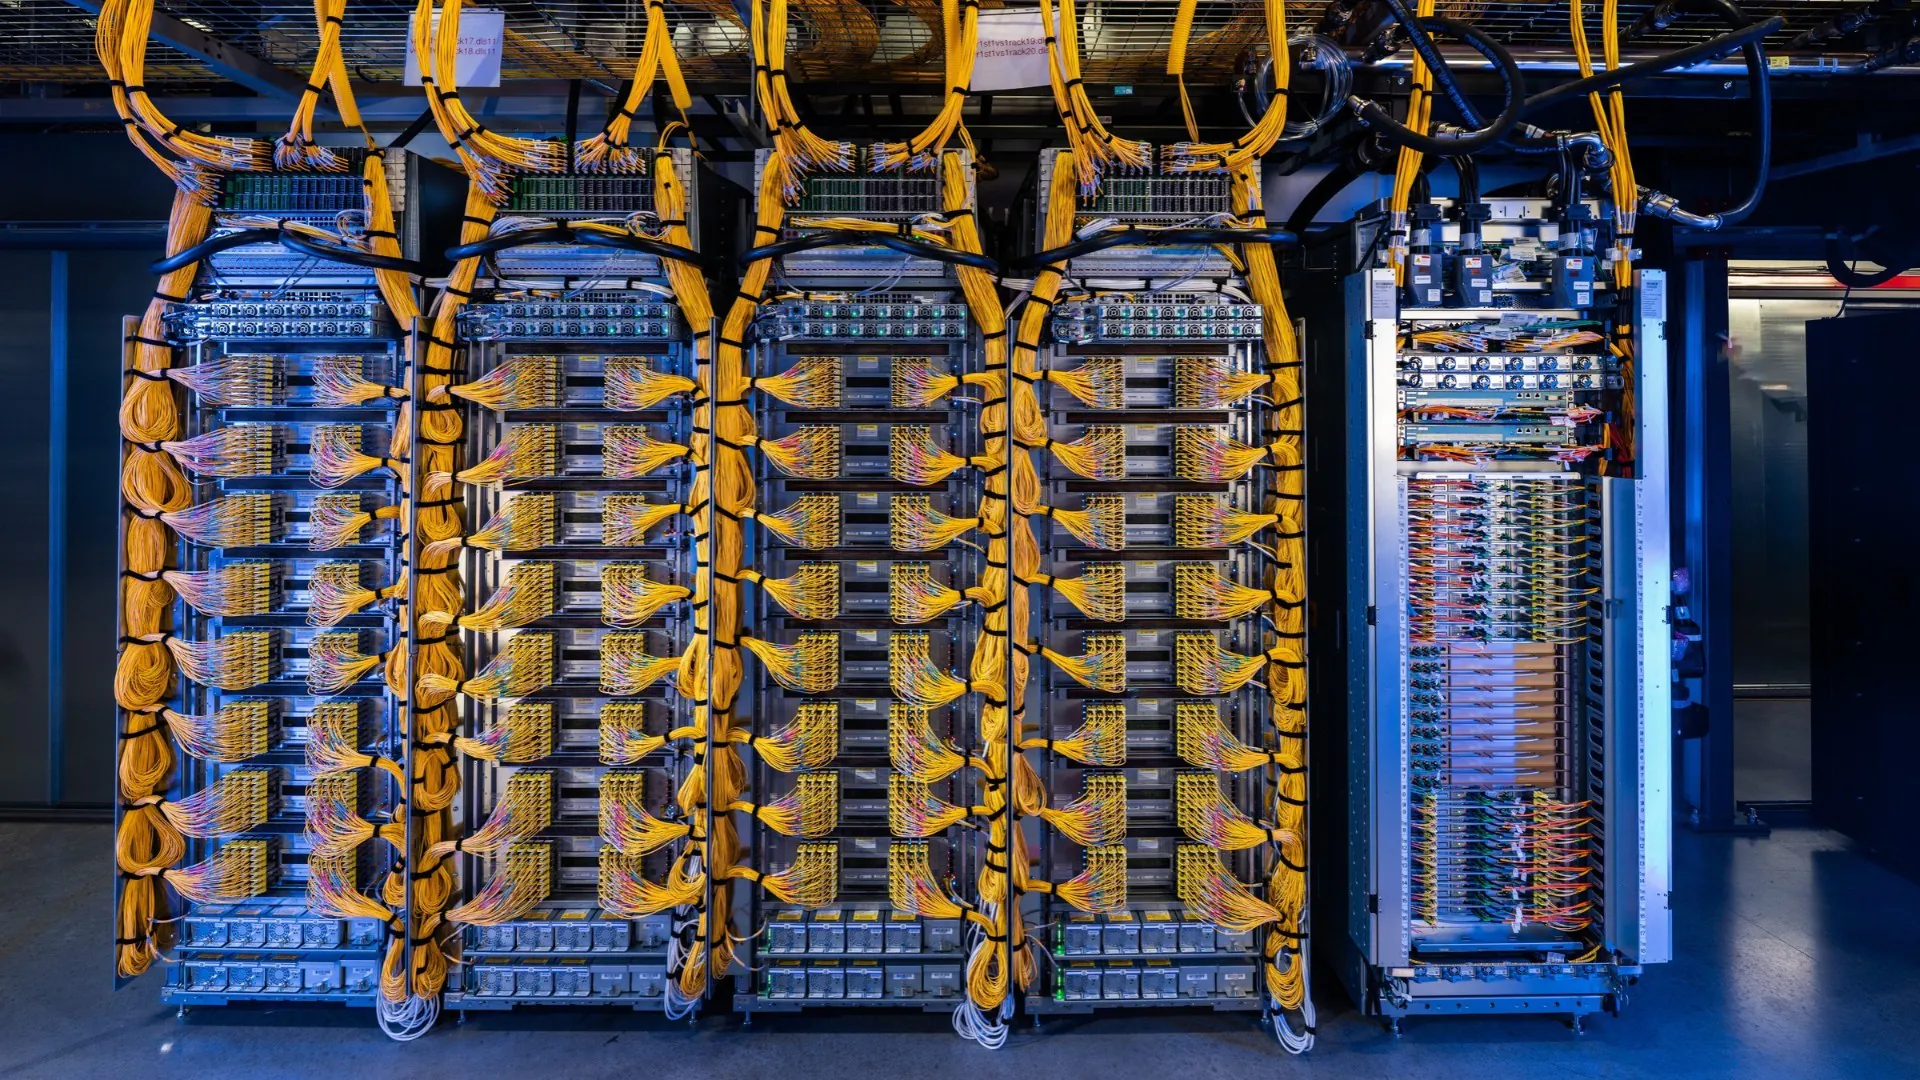
NVIDIA와 Google Cloud는 2026년 10월 21일 GTC Berlin에서 NVIDIA Vera Rubin NVL72 기반 A5X 인스턴스가 첫 고객사와 함께 가동 중이라고 발표했다. 일반 제공은 2026년 11월로 예정되어 있으며, 유럽에서도 이용 가능 범위를 확대할 계획이다.
A5X 인스턴스와 확장 계획
A5X 인스턴스는 NVIDIA Vera Rubin NVL72 랙 단위 시스템과 NVIDIA ConnectX-9 SuperNIC을 Google Cloud Virgo Network 및 Google Cloud의 4세대 고급 액체 냉각 기술과 결합하며, 대규모 에이전트형 추론 및 강화 학습 워크로드를 위해 설계됐다. Google Cloud의 AI Hypercomputer에서 A5X는 컴퓨팅, 네트워킹, 스토리지를 하나의 시스템으로 통합해 대규모 경험 기반 학습을 지원하도록 설계됐다. Google Cloud는 Vera Rubin 기반 인프라를 여러 사이트에 걸쳐 Rubin GPU 최대 960,000개 규모로 확장할 계획이라고 밝혔다.
Google은 2026년 4월 Google Cloud Next에서 A5X를 처음 발표했다. 당시 NVIDIA의 게시물에 따르면, 이 인스턴스는 이전 세대에 비해 토큰당 추론 비용을 최대 10배 낮추고 메가와트당 토큰 처리량을 최대 10배 높일 것으로 예상됐다. 또한 단일 사이트 클러스터에서는 Rubin GPU를 최대 80,000개, 여러 사이트에 걸친 배포에서는 최대 960,000개까지 확장하는 계획도 소개했다.
A5X는 NVIDIA가 2026년 1월 5일 출시한 Rubin 플랫폼을 기반으로 한다. Vera Rubin NVL72는 Rubin GPU 72개, Vera CPU 36개, NVLink 6 인터커넥트, ConnectX-9 SuperNIC, BlueField-4 DPU를 하나의 랙 단위 시스템에 통합한다. NVIDIA는 출시 당시 Rubin이 본격 생산 단계에 들어갔으며, Rubin 기반 제품은 2026년 하반기부터 파트너사를 통해 제공될 예정이라고 밝혔다. 또한 2026년 Vera Rubin 기반 인스턴스를 배포할 첫 클라우드 제공업체 중 하나로 Google Cloud를 꼽았다.
A5X를 이용하는 첫 고객사
A5X에 처음으로 접근한 고객사는 런던에 본사를 둔 기술 기업 Ineffable Intelligence로, AlphaGo 개발자 데이비드 실버가 설립했다. 이 회사는 대규모 강화 학습과 경험을 통해 지속적으로 학습하는 ‘슈퍼러너’ 시스템 개발에 이 플랫폼을 활용하고 있다. 발표 내용에 따르면 상호작용을 통한 학습은 경험 생성, 결과 평가, 모델 업데이트가 계속 이어지는 순환 과정이며, 인프라는 이를 대규모로 지원할 수 있어야 한다.
실버는 “Vera CPU와 Rubin GPU 사이, 그리고 랙 내 Rubin GPU 간의 고대역폭 연결성과 연산 성능을 결합한 Vera Rubin 덕분에 강화 학습 연구의 규모와 목표를 한층 더 확장할 수 있습니다”라고 말했다.
런던에 본사를 둔 마케팅 및 커뮤니케이션 기업 WPP도 NVIDIA Nemotron 모델과 NVIDIA OpenShell을 사용해 A5X 인스턴스에서 크리에이티브 에이전트 참조 아키텍처를 시연했다. NVIDIA OpenShell은 안전한 AI 에이전트를 위한 NVIDIA OpenShell 참조 아키텍처의 일부다. 발표에 따르면 WPP의 에이전트는 대화형 요청을 동영상 생성, 업스케일링, 스타일 변경 같은 여러 단계의 크리에이티브 워크플로로 변환한다. 실행 전에는 사람이 승인하는 단계가 포함되며, OpenShell은 에이전트가 실행되는 관리형 샌드박스를 제공해 민감한 브랜드 자산과 크리에이티브 도구에 대한 접근을 제어한다. WPP는 초기 테스트에서 일반적으로 여러 노드로 구성된 클러스터가 필요한 워크로드를 A5X 인스턴스 하나에서 실행했다.
기밀 컴퓨팅과 전력 효율
발표에 따르면 Google Cloud는 NVIDIA GB300 NVL72 기반 A4X Max 인스턴스를 포함해 베어메탈 인스턴스에서 랙 단위 NVIDIA Confidential Computing을 제공하는 첫 클라우드 제공업체 중 하나가 될 예정이다. 같은 날 올라온 NVIDIA 게시물에 따르면, Google Cloud는 Confidential Bare Metal 지원을 A4X Max 인스턴스로 확대한다. 이 인스턴스는 가상화하지 않은 가속 컴퓨팅과 학습 데이터 및 모델 지식재산을 위한 암호화 보호 기능을 결합한다. Confidential Bare Metal은 Confidential Containers 및 Confidential Virtual Machines와 함께 도입된 새로운 배포 옵션이다. NVIDIA는 전송 중 데이터 보호, 플랫폼 무결성 측정, 하드웨어 수준의 접근 제한을 포함하는 플랫폼 보안 제어 기능도 선보였다.
Google Cloud의 수석 엔지니어이자 AI 인프라 보안 책임자인 Andrés Lagar-Cavilla는 “NVIDIA Confidential Computing을 적용해 구축한 A4X 인스턴스는 사용자 데이터의 프라이버시를 지키고 모델 지식재산을 보호하며, 최고 수준의 서빙 성능을 제공합니다”라고 말했다.
Google Cloud는 기밀 추론 및 미세 조정을 위해 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU 기반 G4 VM에서 Confidential Computing도 정식 제공하고 있다. NVIDIA에 따르면 Vertebrae, Polaris Cloud, Confidential Core AI를 비롯한 고객사는 대화 프라이버시, 검증 가능한 에이전트 실행, 정책에 따라 관리되는 엔터프라이즈 인텔리전스에 Confidential G4를 사용하고 있다. NVIDIA RTX PRO 6000 Blackwell GPU를 탑재한 Confidential G4 VM은 양사가 2026년 4월 발표했을 당시 프리뷰 단계였다.
NVIDIA는 양사가 Vera Rubin 기반 인프라에 NVIDIA DSX MaxLPS 기능을 적용하는 방안도 검토하고 있다고 밝혔다. 이 기능은 와트당 성능을 최적화하고 데이터센터에서 이용할 수 있는 전력 예산 안에서 용량을 확대하는 것을 목표로 한다.



