
인터뷰
YData의 공동 창립자이자 최고 데이터 책임자인 Fabiana Clemente – 인터뷰 시리즈

 Unite.AI를 Google의 선호 소스에 추가
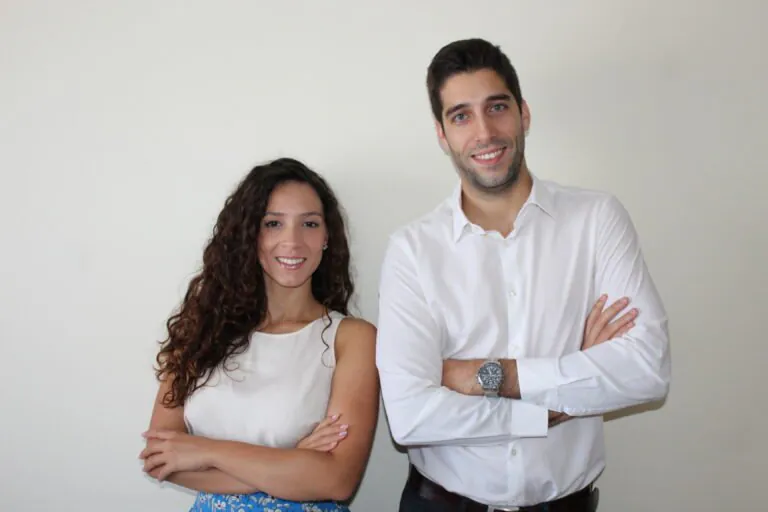
Fabiana Clemente는 YData의 공동 창립자이자 최고 데이터 책임자입니다. YData는 데이터 발견, 개선, 확장을 하나의 플랫폼에서 결합한 최초의 데이터 중심 개발 솔루션을 제공하는 AI 스타트업입니다.
초기에는 무엇이 당신을 AI와 기계 학습에 끌렸나요?
私の 배경은 응용 수학에서 왔으며, 데이터에서 정보를 추출하는 방법을 배우고 코드를 사용하여 이를 수행하는 방법을 알게 되었습니다. 당시에는 기계 학습만큼 섹시하지 않았지만, 이 분야에 대한 열정을 불러일으키는 데 충분했습니다.
YData의 창립 배경을 알려주세요.
스타트업과 기업을 위한 데이터 과학자로 일한 경험을 통해, 데이터에 접근하는 데 어려움을 겪은 적이 많습니다. 때로는 보안이나 개인 정보 보호를 이유로 데이터에 접근할 수 없었고, 다른 때에는 데이터에 접근할 수 있었지만 데이터의 품질이 필요에 미치지 못했습니다. 이러한 어려움이 대부분의 조직에서 빈번하게 발생한다는 것을 알고, 이러한 장애물을 극복하여 AI 개발을 가속화하는 것을 목표로 회사를 설립했습니다.
합성 데이터에 대해 설명해 주세요.
합성 데이터는 실제 세계에서 생성되지 않은 데이터를 말합니다. 합성 데이터를 생성하는 방법에는 규칙 기반 전략부터 기계 학습 모델을 사용하여 이러한 “규칙”을 학습하는 방법까지 있습니다. YData에서는 깊은 학습 기반 전략을 사용하여 실제 세계 이벤트의 행동을 유지하면서 개인 정보 보호에 대한 문제가 없는 새로운 데이터를 생성합니다.
합성 데이터가 중요한 이유는 무엇인가요?
조직이 데이터의 중요성을 인식할수록 합성 데이터의 중요성과 역할을 더 잘 이해할 것입니다. 실제 데이터를 수집하는 것은 시간이 걸리고 비용이 많이 들며, 때로는 불가능할 수도 있습니다. AI 애플리케이션을 구축하려면 데이터가 필수입니다. 여기서 합성 데이터가 구원투수 역할을 합니다. 보이지 않는 시나리오를 생성하거나 데이터에 접근할 수 있도록 하는 능력은 데이터 중심의 세계에서 진보하는 데 핵심입니다.
자율 주행 자동차나 기타 기계 자동화 활동에서 이미 합성 데이터의 중요성을 인식할 수 있습니다. 따라서 이러한 이해가 모든 산업 분야에 걸쳐 전파하는 것은 자연스러운 과정이라고 생각합니다.
YData는 어떻게 합성 데이터를 생성합니까?
YData는 주로 깊은 생성 모델을 사용하여 원래 데이터의 통계적 속성과 변수 간의 상관관계를 학습합니다. 이는 원래 데이터와 동일한 비즈니스 값을 갖는 통계적으로 관련된 데이터 세트를 생성할 수 있도록 합니다. 또한, 원래 기록에 대한 추적을 허용하지 않습니다.
YData는 이 기술을 앞으로推進시키고 있으며, 합성 데이터 커뮤니티를 주도하는 회사입니다. 합성 데이터 커뮤니티는 이 기술을 학습하고 사용하려는 모든 사람을 지원하기 위해 데이터 과학 전문가들이 모인 커뮤니티입니다.
YData 플랫폼은 어떻게 새로운 데이터 소스를 발견하고 해방합니까?
YData의 플랫폼에는 사용자가 관련 메타데이터에 쉽게 접근할 수 있도록 다양한 데이터베이스, 데이터 웨어하우스, 데이터 레이크에 대한 내장 커넥터가 있습니다. 사용자는 실제 데이터를 보지 않고도 비즈니스 질문에 대한 답을 찾을 수 있습니다.
합성 데이터 오픈 소스 커뮤니티에 대해 자세히 알려주세요.
합성 데이터는 아직 초기 단계에 있으며, 더 큰 관객에게는 어떻게 생성되고, 어떤 이점과 제한이 있는지에 대한 인식이 아직 부족합니다. 따라서, YData에서는 교육적인 접근 방식을 취하여 합성 데이터 커뮤니티를 만들었습니다. 이는 아이디어를 교환하거나 전문가의 도움을 받을 수 있는 곳입니다. 또한, 데이터 과학자와 기술 전문가들이 합성 데이터에 대한旅程을 시작할 수 있는 곳입니다.
또한, 데이터 품질에 대한 관점을 제공하여 데이터 과학자들이 작업하는 데이터를 이해할 수 있도록 합니다. 그리고 데이터를 합성하거나 데이터 합성을 개선하는 데 도움이 됩니다. 우리는 데이터 팀이 더 데이터 중심적으로 될 수 있도록 도와주는 데 헌신하고 있습니다.
YData는 최근 270만 달러의 자금을 확보하여 국제 확장을 가속화할 계획입니다. 이에 대한 자세한 내용을 알려주세요.
YData는 이미 국제적으로 출발했습니다. 우리는 이 기술이 초기 채택자가 필요하다는 것을 알고 있었으며, 이러한 초기 채택자는 일반적으로 가장 발전된 국가에서 왔습니다. 따라서, 우리의 첫 고객은 이미 포르투갈 외부에 있었으며, 현재 유럽 전역에서 활동하고 있으며, 북미에서도 활동을 시작하고 있습니다. 이 자금은 우리가 이러한 대륙에서 더 강한 존재를 확립하고, 팀을 성장시키는 데 도움이 될 것입니다. 우리는 완전히 분산된 팀을 운영하므로, 어디에 있든지 최고의 인재를 채용할 수 있습니다.
YData에 대해 더 알려주고 싶은 내용이 있나요?
YData는 데이터 중심 AI의 장벽을突破하고 새로운 카테고리를 만들고 있습니다. 데이터 준비 작업을 의미하는 DataPrepOps는, 현재 많은 회사들이 직면한 고통입니다. 데이터 품질 트렌드는 계속 성장하고 있으며, 데이터 파이프라인과 데이터 관찰 가능성之后, 데이터 과학 팀을 위한 데이터 품질은 아직 초기 단계에 있습니다. YData는 데이터 준비 분야에서 선도적인 역할을 하고 있습니다.
수고하셨습니다. 더 많은 정보를 원하는 독자는 YData를 방문해 주세요.


