
Anderson의 관점
일관된 AI 비디오 콘텐츠 편집을 위한 텍스트 가이드 입력

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트Text2Live는 프레임별 처리 없이 텍스트 프롬프트로 일관된 비디오 편집을 가능하게 합니다.
더 보기
- Text2Live는 프레임별 처리 없이 텍스트 프롬프트로 일관된 비디오 편집을 가능하게 합니다.
- 이 시스템은 신경망 계층 아틀라스를 사용하여 전체 비디오 타임라인에 걸쳐 한 번에 편집을 적용합니다.
- Text2Live는 마스킹과 합성을 자동화하여 로토스코핑이나 그린 스크린이 필요하지 않습니다.
전문 VFX 커뮤니티는 이미지 및 비디오 합성의 새로운 혁신에 매료되면서도 때때로 위협을 느끼고 있습니다. 그러나 대부분의 AI 기반 비디오 편집 프로젝트는 시간적 연속성이 부족하여 이러한 노력은 많은 경우에 ‘사이키델릭’ 영역으로 귀속됩니다. 여기에는 반짝이고 빠르게 변하는 텍스처와 구조, 일관되지 않은 효과, 시각 효과의 광화학 시대를 떠올리게 하는 거친 기술 처리가 나타납니다.
비디오에서 특정한 것을 변경하려는 경우, 딥페이크 영역에 속하지 않는 경우(즉, 사람의 기존 영상을 새로운 정체성으로 대체하는 경우), 대부분의 현재 솔루션은 생산품질의 시각적 효과에 필요한 정밀도에 대한 제한이 있습니다.
하나의 예외는 와이즈만 과학 연구소의 학자들로부터 오는 것입니다. 2021년 이 연구소의 연구자 세 명은 어도비와 협력해 비디오를 분해하고 일관된 내부 매핑을 합성 결과에 겹치는 새로운 방법을 발표했습니다. 이는 알파 채널과 시간적으로 일관된 출력을 갖춘 층화된 신경 지도를 생성했습니다.
(ADBE )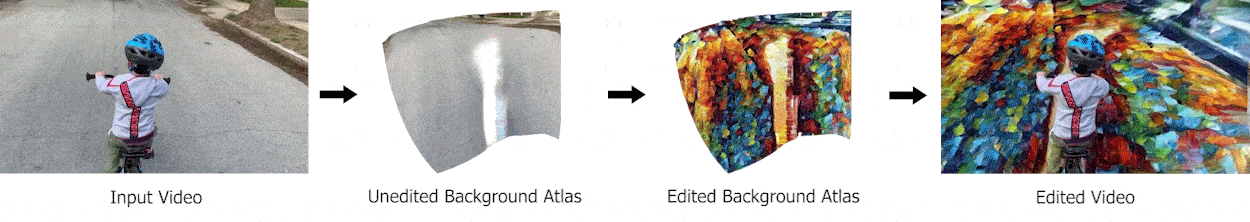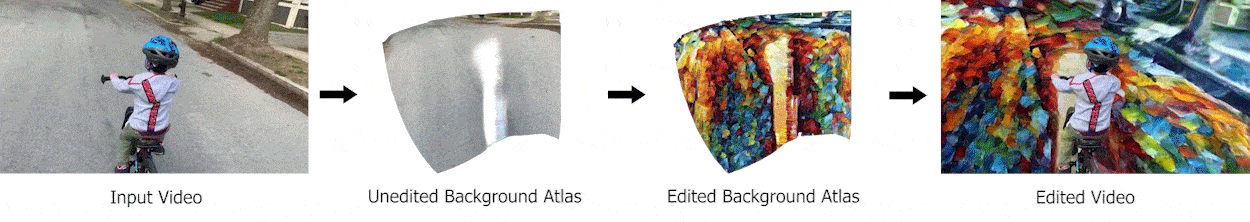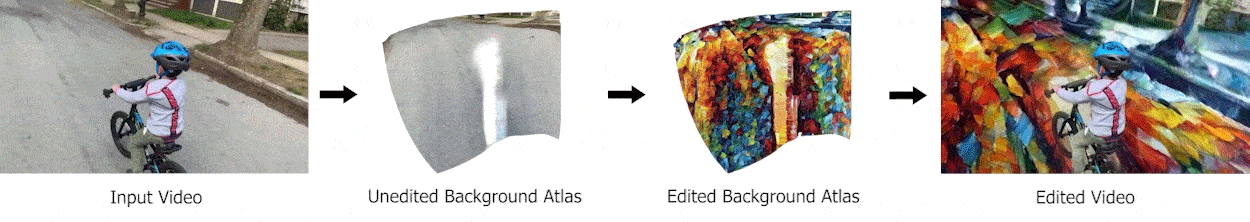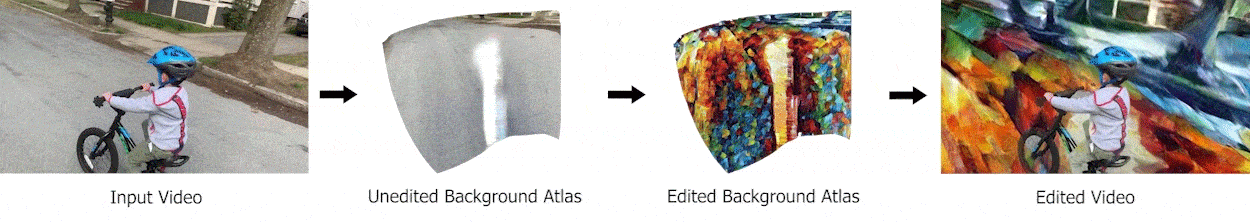
2021년 논문에서: 소스 클립에서 도로의 완전한 통행을 추정하는 것은 전통적으로 광범위한 rotoscoping과 매치 이동이 필요한 방식으로 신경 네트워크를 통해 편집됩니다. 배경과 전경 요소가 별도의 네트워크에서 처리되므로 마스크는 실제로 ‘자동’입니다. 출처: https://layered-neural-atlases.github.io/
이 방법은 VFX 파이프라인의 옵티컬 플로우가 다루는 영역과 어느 정도 겹치지만, 전통적인 CGI 작업 방식에 직접 대응하는 것은 없습니다. 이는 본질적으로 ‘시간적 텍스처 맵’으로서, 전통적인 소프트웨어 방법을 통해 생성되고 편집될 수 있습니다.
위의 삽화에서 두 번째 이미지는 도로 표면의 배경을 전체 비디오 실행 시간에 걸쳐 나타냅니다. 이 기본 이미지를 변경하면(위의 삽화에서 왼쪽에서 세 번째 이미지) 배경에 일관된 변경이 발생합니다.
‘펼친’ 아틀라스의 이미지는 개별적으로 해석된 프레임만을 나타냅니다. 타겟 비디오 프레임의 일관된 변경은 원래 프레임으로 매핑되며, 필요한 오클루전과 다른 필수적인 장면 효과(예: 그림자 또는 반사)를 유지합니다.
코어 아키텍처는 다층 퍼셉트론(MLP)을 사용하여 펼친 아틀라스, 알파 채널 및 매핑을 나타내며, 이들은 모두 완전히 이차원인 공간에서 함께 최적화됩니다. 이는 NeRF 스타일의 3D 기하학 점, 깊이 맵 및 유사한 CGI 스타일의 장치에 대한 이전 지식의 필요성을 제거합니다.
개별 객체의 참조 아틀라스도 신뢰할 수 있게 변경할 수 있습니다.
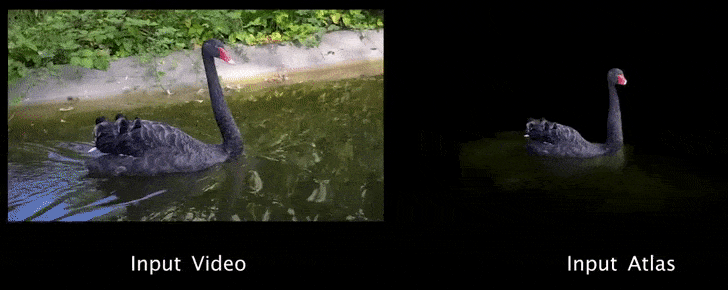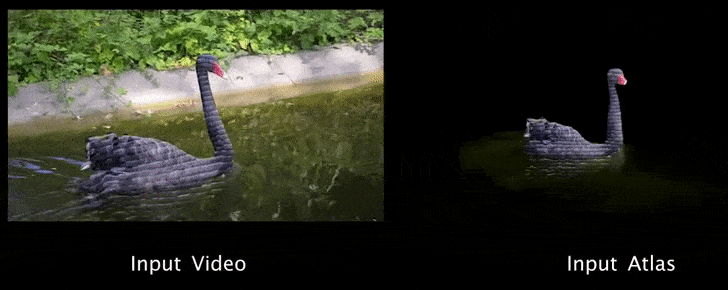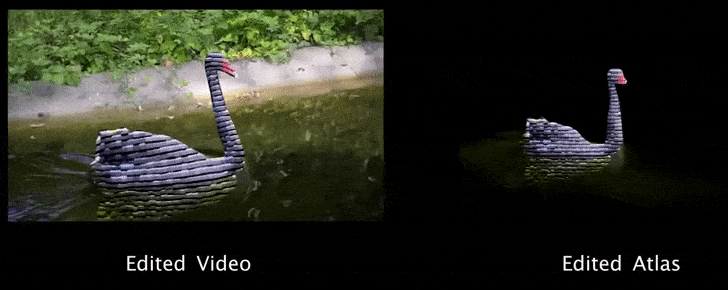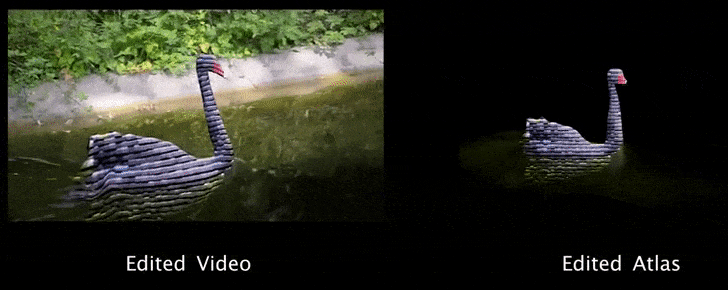
2021 프레임워크에서 이동하는 객체에 대한 일관된 변경. 출처: https://www.youtube.com/watch?v=aQhakPFC4oQ
본질적으로 2021 시스템은 기하학적 정렬, 매치 이동, 매핑, 재 텍스처화 및 로토스코핑을 하나의 별도 신경망 과정으로 결합합니다.
Text2Live
2021년 논문의 3명의 원래 연구자와 NVIDIA (NVDA ) 연구가 새로운 기술에 기여했습니다. 이 기술은 계층형 아틀라스의 장점과 텍스트로 유도하는 CLIP 기술을 결합합니다. CLIP은 이번 주 OpenAI가 DALL-E 2 프레임워크를 공개하면서 다시 주목받았습니다.
새로운 아키텍처는 Text2Live라고 불리며, 사용자가 텍스트 프롬프트에 따라 실제 비디오 콘텐츠를 편집할 수 있도록 합니다.
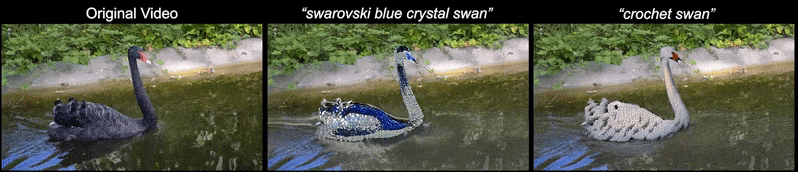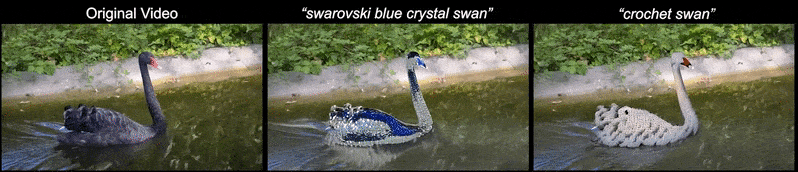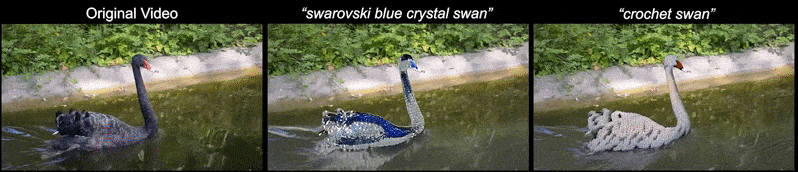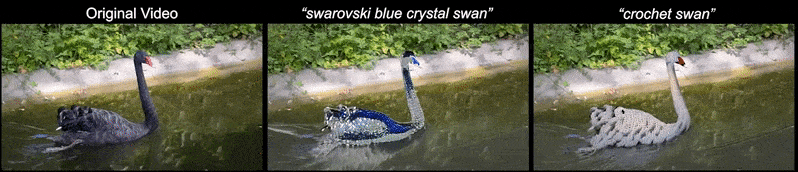
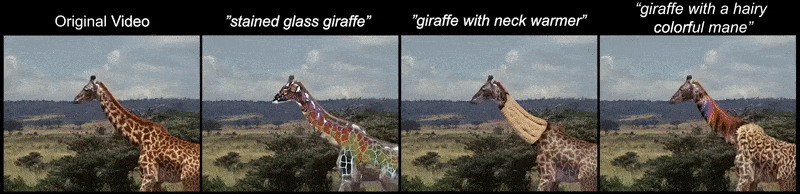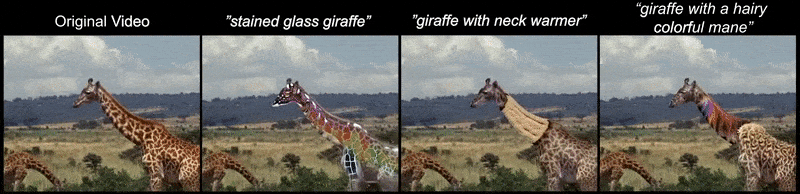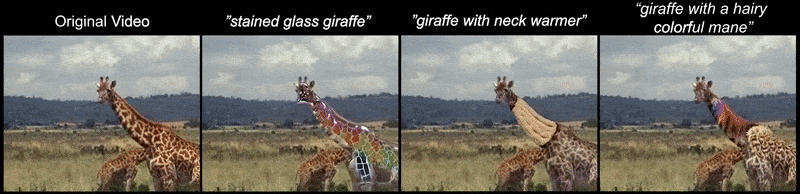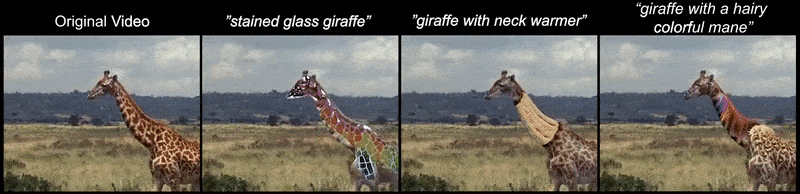
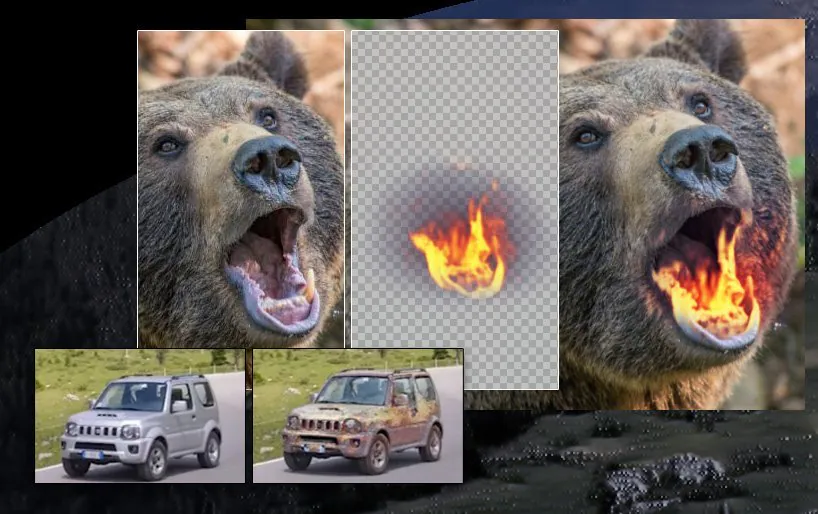
전경 편집의 두 가지 예시. 더 높은 해상도와 선명도를 위해 원본 비디오를 https://text2live.github.io/sm/pages/video_results_atlases.html에서 확인하십시오.
Text2Live는 사전 학습된 생성기 없이, 편집 대상 비디오 클립에만 해당하는 내부 데이터베이스를 이용해 의미 기반의 매우 국소적인 편집을 제공합니다.

Text2Live에서 배경 및 전경(객체) 변환. 출처: https://text2live.github.io/sm/pages/video_results_atlases.html
이 기술은 사용자 제공 마스크(예: 로토스코핑 또는 그린 스크린 워크플로우)가 필요하지 않습니다. 대신, 텔아비브 대학교 컴퓨터과학부와 Facebook AI Research(FAIR)의 2021년 연구를 바탕으로 한 부트스트래핑 기법으로 관련성 맵을 추정합니다.

트랜스포머 기반의 제네릭 어텐션 모델을 통해 생성된 출력 맵.
새로운 논문은 Text2LIVE: 텍스트 기반 층화된 이미지 및 비디오 편집이라고 불립니다. 원래 2021년 팀은 와이즈만의 오메르 바르 탈과 NVIDIA 연구의 요니 카스텐이 합류했습니다.
아키텍처
Text2Live는 하나의 입력 이미지와 목표 텍스트 프롬프트로 학습한 생성기를 포함합니다. 4억 개의 텍스트/이미지 쌍으로 사전 학습된 대조적 언어–이미지 사전 학습(CLIP) 모델은 사용자 입력 변환을 해석할 수 있는 관련 시각적 자료를 제공합니다.

생성기는 입력 이미지(프레임)를 받아서 타겟 RGBA 레이어를 출력하며, 이는 색상 및 불투명도 정보를 포함합니다. 이 레이어는 추가로 보강된 원래 영사에 합성됩니다.

생성된 RGBA 레이어의 알파 채널은 After Effects 같은 픽셀 기반 소프트웨어를 사용하는 전통적인 작업 과정을 거치지 않고 내부 합성을 수행하게 합니다.
Text2Live는 목표 비디오나 이미지와 관련된 내부 이미지로 학습하므로, 입력 이미지를 생성적 적대 신경망(GAN)의 잠재 공간으로 역변환할 필요가 없습니다. 이러한 역변환은 현재 제작용 비디오 편집의 요구를 충족하기에 정확도가 크게 부족합니다. 또한 더 정밀하고 설정을 조절할 수 있지만 목표 비디오에 대한 충실도를 유지하지 못하는 확산 모델을 사용할 필요도 없습니다.

Text2Live의 프롬프트 기반 변환 편집의 예시.
기존 접근 방식은 전파 기반 방법이나 옵티컬 플로우 기반 방법을 사용했습니다. 이 기법들은 어느 정도 개별 프레임을 기준으로 하기 때문에 출력 비디오의 변경 사항을 시간적으로 일관된 외관으로 유지하지 못합니다. 반면 계층형 신경 아틀라스는 변경을 다루는 하나의 공간을 제공하므로 비디오가 진행되어도 적용한 변경에 충실한 결과를 유지할 수 있습니다.
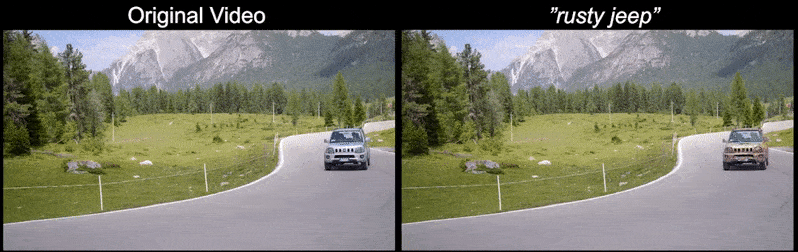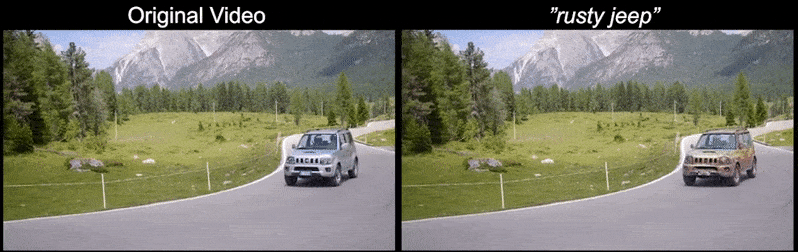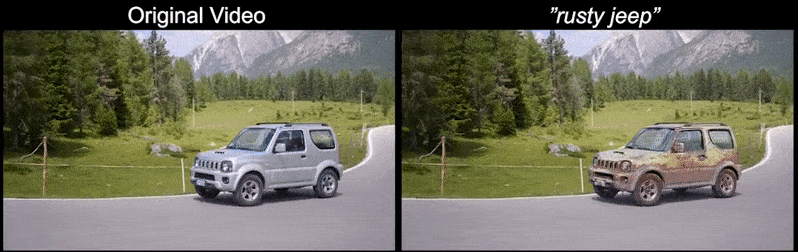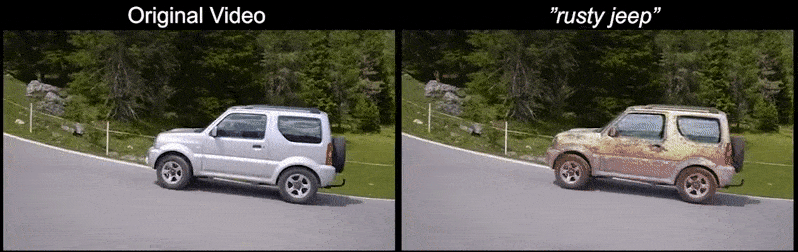
깜박임이나 무작위 환각 없이, Text2Live는 ‘rusty jeep’, 즉 ‘녹슨 지프’라는 텍스트 프롬프트를 해석해 비디오 속 자동차의 계층형 신경 아틀라스에 한 번 적용합니다. 해석된 프레임마다 변환을 처음부터 반복하지 않습니다.

Text2Live가 지프를 녹슨 잔해로 일관되게 변환하는 작업 흐름.
Text2Live는 텍스트에서 이미지를 생성하는 분야보다는 AI 기반 합성 분야의 돌파구에 더 가깝습니다. 텍스트–이미지 분야는 이번 주 OpenAI가 DALL-E 프레임워크의 2세대를 공개하면서 큰 관심을 받았습니다. DALL-E는 변환 과정에 목표 이미지를 포함할 수 있지만 사진을 직접 수정하는 능력은 여전히 제한적입니다. 여기에 사용자 오용을 막기 위한 원본 학습 데이터 검열과 필터 적용이라는 제약도 있습니다.
반면 Text2Live는 사용자가 아틀라스를 추출하고 Photoshop처럼 세밀하게 제어할 수 있는 픽셀 기반 환경에서 한 번에 편집하게 합니다. 어쩌면 NeRF처럼 더 추상적인 이미지 합성 프레임워크에서도 가능하다고 볼 수 있습니다. 그 후 아틀라스를 올바르게 정렬된 환경에 다시 넣으며, 이 환경은 3D 추정이나 과거 방식으로 돌아가는 CGI 접근법에 의존하지 않습니다.
또한 저자들은 Text2Live가 비교 가능한 프레임워크 가운데 처음으로 마스킹과 합성을 완전히 자동으로 수행한다고 주장합니다.
최초로 2022년 4월 7일에 게시되었습니다.





