Anderson의 관점
장면을 이해하는 AI 이미지 매팅

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트AI 매팅은 이제 장면 이해를 활용해 그린 스크린을 대체합니다.
더 보기
- AI 매팅은 이제 장면 이해를 활용해 그린 스크린을 대체합니다.
- 새로운 SPG-IM 파이프라인은 트라이맵이 필요 없는 방법들을 큰 차이로 능가합니다.
- 텍스트 레이블은 값비싼 픽셀 주석에 대한 저비용 대안을 제공합니다.
1992년작 Alien3의 2003년 DVD 출시판에 수록된 부가 다큐멘터리에서 시각효과의 전설 리처드 에들런드는 1930년대 후반부터 1980년대 후반까지 시각효과 작업을 지배한 광화학 매트 추출의 ‘스모 레슬링’을 끔찍했던 기억으로 회상했다. 에들런드는 과정의 성공 여부가 들쭉날쭉했던 것을 ‘스모 레슬링’에 비유했는데, 1990년대 초 디지털 블루·그린 스크린 기법이 이를 대체했다(그는 이후에도 이 비유를 다시 꺼냈다).
전경의 요소(사람이나 우주선 모형 등)를 배경에서 분리해 잘라낸 이미지를 배경 영상에 합성하는 작업은 원래 전경의 대상을 균일한 파란색 또는 녹색 배경 앞에서 촬영하는 방식으로 이뤄졌다.
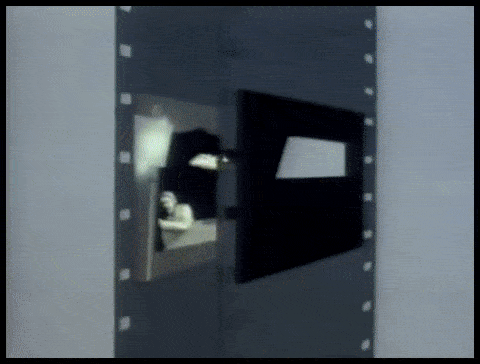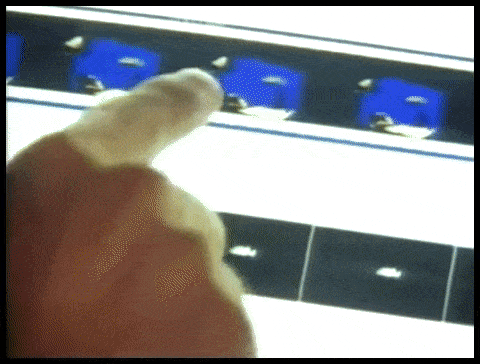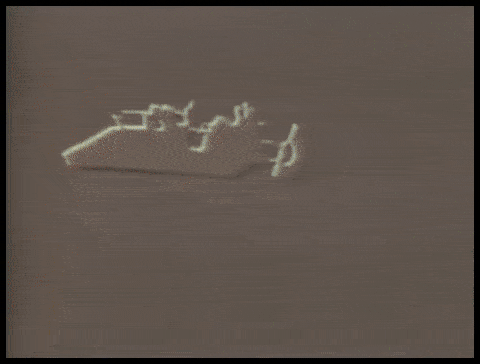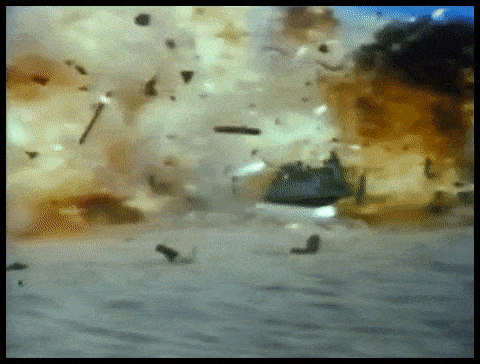
‘Return of the Jedi’(1983)의 ILM 시각효과 장면에 적용된 까다로운 광화학 추출 과정.
이렇게 촬영한 영상에서는 배경색을 화학적으로 분리한 뒤, 이를 본보기로 삼아 광학 프린터에서 전경의 대상(또는 사람)을 다시 인화해 주변이 투명한 필름 프레임 위에 ‘떠 있는’ 것처럼 만들었다.
이 기법은 색분리 오버레이(CSO)라고 불렸지만, 이후 이 용어는 1970~1980년대 저예산 TV 프로그램에서 사용된 조잡한 ‘크로마키’ 영상 효과를 가리키는 말로 더 널리 쓰이게 됐다. 이 효과는 화학이나 디지털 방식이 아닌 아날로그 방식으로 구현됐다.

1970년 영국 어린이 프로그램 ‘Blue Peter’에서 색분리 오버레이를 시연하는 모습. 출처: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
어쨌든 영화든 영상이든, 이렇게 추출한 영상은 이후 다른 영상에 삽입할 수 있었다.
디즈니의 독자적인 공정은 비용이 훨씬 많이 들었지만, 노란색을 기준으로 키잉하는 나트륨 증기 공정은 매트의 윤곽을 더 선명하고 또렷하게 표현했다. 이 공정은 알프레드 히치콕의 1963년 공포 영화 The Birds에도 사용됐다. 그러나 광화학 방식의 추출은 여전히 고된 작업이었고 신뢰하기 어려웠다.

디즈니의 독자적인 나트륨 증기 추출 공정은 스펙트럼의 노란색 영역에 가까운 배경을 필요로 했다. 여기서는 ‘Bedknobs and Broomsticks’(1971)의 시각효과가 들어간 장면을 촬영하는 동안 앤절라 랜즈베리가 와이어에 매달려 있다. 출처
디지털 매팅을 넘어
1990년대 디지털 혁명으로 화학물질은 사라졌지만, 그린 스크린의 필요성은 여전했다. 이제 Photoshop 같은 픽셀 편집 소프트웨어에서 특정 색상의 허용 범위 안에 드는 픽셀을 찾는 것만으로 녹색(또는 다른 색상) 배경을 제거할 수 있었다. 색상 배경을 자동으로 제거하는 새로운 세대의 영상 합성 프로그램도 등장했다. 거의 하룻밤 사이에 60년 동안 이어진 광학 프린팅 업계의 역사는 막을 내렸다.
지난 10년간 GPU 가속 컴퓨터 비전 연구가 이어지면서 매트 추출은 세 번째 전환기를 맞고 있다. 연구자들은 그린 스크린 없이도 고품질 매트를 추출할 수 있는 시스템을 개발해야 하는 과제를 맡았다. arXiv만 보더라도 머신러닝 기반 전경 추출의 혁신과 관련된 논문이 매주 발표된다.
화면 속 우리
AI 기반 추출 기술에 대한 학계와 업계의 관심은 이미 소비자 시장에도 영향을 미쳤다. 영상 회의 중 거실 배경을 열대 섬 등으로 바꿔 주는 Zoom과 Skype 필터는 조잡하지만 쓸 만한 구현 사례로, 이제는 누구나 익숙하게 접한다.
하지만 지난 수요일 Zoom이 지적했듯이, 가장 좋은 매트 결과를 얻으려면 여전히 그린 스크린이 필요하다.

왼쪽은 그린 스크린 앞에 선 남성으로, Zoom의 가상 배경 기능을 통해 머리카락이 깔끔하게 분리됐다. 오른쪽은 일반적인 가정집 배경 앞에 선 여성으로, 머리카락이 알고리즘으로 분리됐지만 정확도가 떨어지고 더 높은 연산 성능이 필요하다. 출처: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Zoom 지원 플랫폼의 후속 게시물에서는 그린 스크린 없이 배경을 분리하려면 촬영 기기에서 더 높은 연산 성능도 필요하다고 경고한다.
배경에서 분리해야 하는 이유
그린 스크린 없이 사람을 분리하는 이른바 ‘실제 환경에서’의 매트 추출 시스템은 품질과 휴대성, 자원 효율성이 개선되면 화상 회의 필터를 넘어 훨씬 더 많은 분야와 용도에서 활용될 수 있다.
데이터 세트 개발 측면에서 얼굴, 머리 전체, 신체 전체를 더 정확히 인식하면 배경의 불필요한 요소가 인간 피사체를 대상으로 하는 컴퓨터 비전 모델의 학습에 포함되지 않도록 할 수 있다. 더 정확한 분리는 영역(예: ‘고양이’, ‘사람’, ‘배’)을 구분하고 통합하도록 설계된 시맨틱 분할 기법을 크게 개선하고, VAE 및 트랜스포머 기반 이미지 합성 시스템, 예를 들어 OpenAI의 새로운 DALL-E 2의 성능도 높일 수 있다. 또한 추출 알고리즘이 개선되면 비용이 많이 드는 VFX 제작 파이프라인에서 값비싼 수작업 로토스코핑의 필요성을 줄일 수 있다.
사실 ‘고양이’와 같은 영역을 이미지와 관련 텍스트 참조로 함께 인코딩하는 멀티모달(대개 텍스트와 이미지) 방법론이 부상하면서 이미 이미지 처리 분야에도 변화가 나타나고 있다. 최근 사례로는 Text2Live 아키텍처가 있다. 이 아키텍처는 멀티모달(텍스트와 이미지) 학습을 활용해 수많은 가능성 중에서도 수정 백조와 유리 기린이 등장하는 동영상을 만든다.
장면을 이해하는 AI 매팅
AI 기반 자동 매팅 연구의 상당수는 이미지나 동영상 프레임 안에서 경계를 인식하고 픽셀 단위 그룹을 평가하는 데 초점을 맞춰 왔다. 그러나 중국 연구진이 발표한 새로운 연구는 장면의 텍스트 기반 설명을 활용해 윤곽 구분과 매트 품질을 개선하는 추출 파이프라인을 제시한다. 컴퓨터 비전 연구 분야에서 지난 3~4년간 주목받아 온 멀티모달 접근 방식이며, 여러 측면에서 기존 방법을 개선했다고 주장한다.

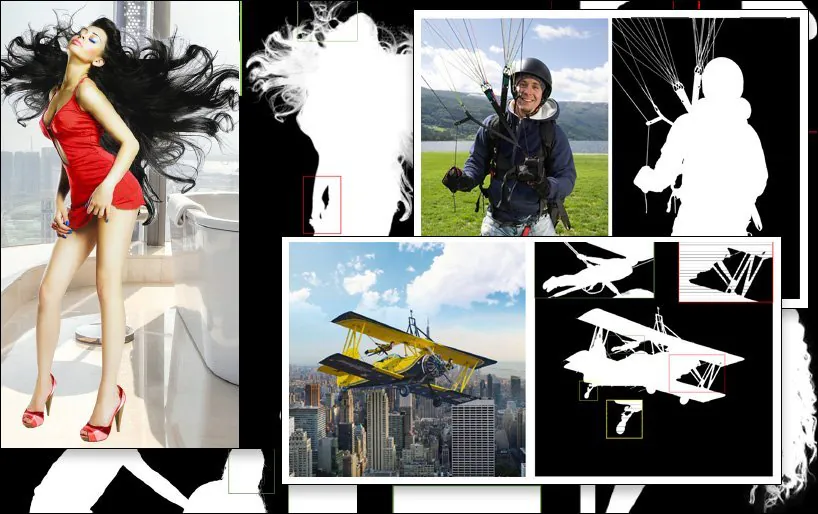
경쟁 관계에 있는 기존 방법과 비교한 SPG-IM 추출 결과의 예(마지막 이미지, 오른쪽 아래). 출처: https://arxiv.org/pdf/2204.09276.pdf
추출 연구 분야가 해결해야 할 과제는 수작업 주석과 사람의 개입을 최소화하고, 이상적으로는 아예 필요로 하지 않는 작업 흐름을 만드는 것이다. 비용 문제뿐 아니라, 새 논문의 연구진은 여러 문화권의 외주 크라우드워커가 주석을 달거나 수동으로 분할할 경우 이미지에 서로 다른 방식으로 레이블이 지정되거나 분할될 수 있으며, 이로 인해 알고리즘의 일관성이 떨어지고 결과가 만족스럽지 못해질 수 있다고 지적한다.
그 한 가지 사례가 ‘전경 객체’를 정의하는 방식에 대한 주관적인 해석이다.

새 논문에서 발췌: 기존 방법인 LFM과 MODNet(‘GT’는 Ground Truth, 즉 흔히 수작업이나 알고리즘이 아닌 방법으로 얻는 ‘이상적인’ 결과를 뜻함)은 전경 콘텐츠를 정의하는 방식이 서로 다르고 효과도 제각각이다. 반면 새로운 SPG-IM 방법은 장면 맥락을 활용해 ‘가까운 콘텐츠’의 윤곽을 더 효과적으로 구분한다.
이를 해결하기 위해 연구진은 Situational Perception Guided Image Matting(SPG-IM)이라는 2단계 파이프라인을 개발했다. 이 인코더·디코더 아키텍처는 Situational Perception Distillation(SPD)과 Situational Perception Guided Matting(SPGM)으로 구성된다.

SPG-IM 아키텍처.
먼저 SPD는 시각 특징을 텍스트 특징으로 변환하는 과정을 사전 학습해 각 이미지에 적합한 캡션을 생성한다. 그런 다음 새로운 현저성 예측 기법을 파이프라인에 연결해 전경 마스크를 예측할 수 있도록 한다.
이후 SPGM은 첫 번째 모듈에서 얻은 생성 마스크와 원본 RGB 이미지 입력을 바탕으로 추정 알파 매트를 출력한다.
목표는 상황 인식을 통한 안내다. 시스템이 이미지에 무엇이 담겼는지 맥락을 이해함으로써, 예를 들어 복잡한 머리카락을 배경에서 분리하는 문제를 해당 작업의 구체적인 특성을 고려해 다룰 수 있게 한다.

아래 예시에서 SPG-IM은 끈이 ‘낙하산’을 이루는 요소임을 이해하지만, MODNet은 이러한 세부 정보를 보존하고 구분하지 못한다. 마찬가지로 위 예시에서는 놀이터 놀이 기구의 전체 구조가 MODNet에서 자의적으로 사라진다.
새 논문의 제목은 상황 인식 기반 이미지 매팅이며, OPPO Research Institute, PicUp.ai, Xmotors의 연구진이 작성했다.
지능형 자동 매트
SPG-IM은 로컬 세부 정보와 전역 맥락을 따로 처리해 ‘지능형 매트’를 구현할 수 있는 Adaptive Focal Transformation (AFT) 정제 네트워크도 제안한다.

이 경우처럼 ‘말과 함께 있는 소녀’라는 장면의 맥락을 이해하면 이전 방식보다 전경을 더 쉽게 추출할 수 있다.
논문은 다음과 같이 설명한다.
“시각-텍스트 과제, 예를 들어 이미지 캡셔닝에서 얻은 시각적 표현은 a) 객체 간, 그리고 b) 객체와 주변 환경 간의 의미상 포괄적인 신호에 더 집중해 전역 정보와 세부 정보를 모두 담은 설명을 생성한다고 생각한다. 또한 이미지 매팅에 필요한 비용이 많이 드는 픽셀 주석 작업과 비교하면, 텍스트 레이블은 매우 낮은 비용으로 대량 수집할 수 있다.”
아키텍처의 SPD 분기는 University of Michigan의 VirTex 트랜스포머 기반 텍스트 디코더와 공동으로 사전 학습된다. 이 디코더는 의미 정보가 풍부한 캡션에서 시각적 표현을 학습한다.

VirTex는 이미지와 캡션의 쌍을 활용해 ConvNet과 트랜스포머를 공동 학습하고, 그렇게 얻은 정보를 객체 감지와 같은 후속 비전 작업에 적용한다. 출처: https://arxiv.org/pdf/2006.06666.pdf
연구진은 여러 테스트와 구성 요소 제거 실험를 비롯해, SPG-IM을 최첨단 트라이맵 기반 방법인 Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA, Semantic Image Matting (SIM)과 비교했다.
그 밖에 테스트한 기존 프레임워크에는 트라이맵을 사용하지 않는 방식인 LFM, HAttMatting, MODNet이 포함됐다. 공정하게 비교하기 위해 테스트 방법은 서로 다른 방법론에 맞춰 조정했다. 코드를 구할 수 없는 경우에는 논문에 설명된 아키텍처를 바탕으로 해당 기법을 재현했다.
새 논문은 다음과 같이 설명한다.
“우리 SPG-IM은 모든 경쟁 트라이맵 비사용 방식([LFM], [HAttMatting], [MODNet])보다 훨씬 뛰어난 성능을 보인다. 또한 공개 데이터셋(Composition-1K, Distinction-646, Human-2K) 전반의 네 가지 지표 모두에서, 그리고 자체 Multi-Object-1K 벤치마크에서도 최첨단(SOTA) 트라이맵 기반 방식 및 마스크 유도 방식보다 현저히 우수한 성능을 보인다.”
논문은 이어서 다음과 같이 설명한다.
“트라이맵의 안내 없이도 우리 방법이 머리카락 끝, 투명한 질감, 경계와 같은 세부 정보를 보존한다는 점을 분명히 확인할 수 있다. 또한 다른 경쟁 트라이맵 비사용 모델과 비교해 우리 SPG-IM은 전역적인 의미의 완전성을 더 잘 유지한다.”


최초 게시일: 2022년 4월 24일.