
Anderson의 관점
Google의 Imagic와 Runway의 ‘Erase and Replace’를 활용한 AI 지원 객체 편집

 Unite.AI를 Google의 선호 소스에 추가

이번 주에 두 가지 새로운, 그러나 대조적인 AI 기반 그래픽 알고리즘이 등장하여 최종 사용자가 사진 속 객체를 매우 세밀하고 효과적으로 수정할 수 있는 새로운 방법을 제공합니다.
첫 번째는 Google Research와 이스라엘 공과대학 및 와이즈만 과학 연구소가 공동으로 개발한 Imagic입니다. Imagic은 텍스트 조건에 따라 확산 모델을 미세 조정함으로써 객체를 세밀하게 편집할 수 있습니다.

원하는 부분만 변경하고 나머지는 그대로 두세요 – Imagic은 변경하고자 하는 부분만 세밀하게 편집할 수 있다고 약속합니다. 출처: https://arxiv.org/pdf/2210.09276.pdf
Stable Diffusion 재렌더링에서 단 하나의 요소만 바꾸려는 시도를 해본 사람이라면, 성공적인 편집 하나당 시스템이 원래 마음에 들던 다섯 가지를 함께 바꾸는 경우가 많다는 것을 잘 알 것입니다. 이는 현재 가장 뛰어난 SD 애호가들이 Stable Diffusion과 Photoshop 사이를 계속 오가며 이러한 ‘부수적 손상’을 고치고 있는 단점입니다. 이러한 관점만 보아도 Imagic의 성과는 주목할 만합니다.
작성 시점에서 Imagic은 아직 홍보 영상조차 없으며, Google이 자유로운 이미지 합성 도구 출시를 조심스러워하고(circumspect attitude) 있기 때문에 시스템을 실제로 시험해 볼 수 있을지 여부가 불확실합니다.
두 번째는 Runway ML이 제공하는 보다 접근성이 높은 Erase and Replace 기능으로, 머신러닝 기반 시각 효과 도구 온라인 전용 제품군의 ‘AI Magic Tools’ 섹션에 추가된 새 기능입니다.
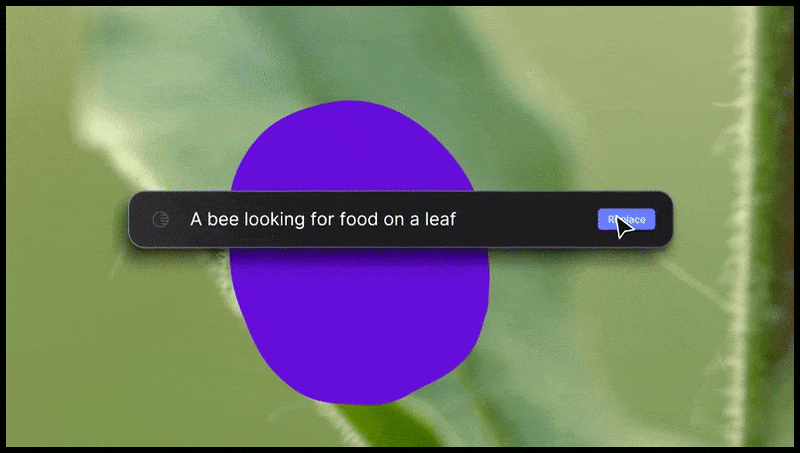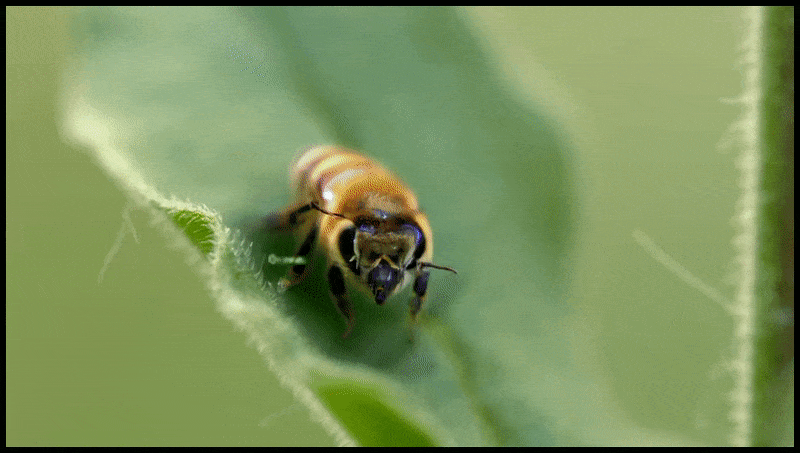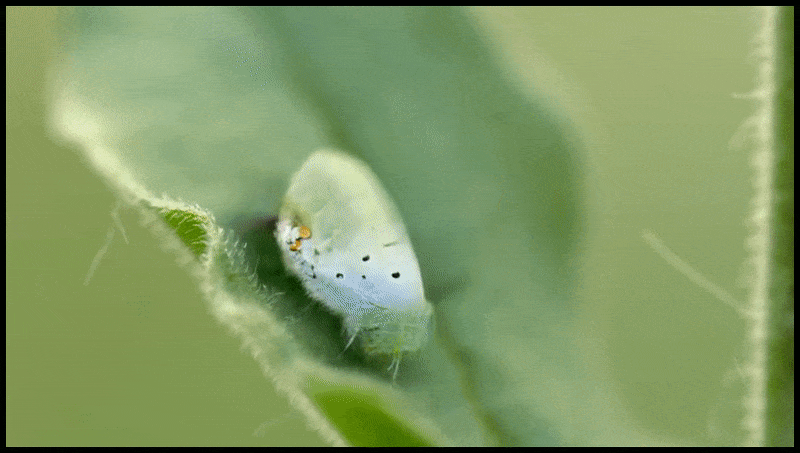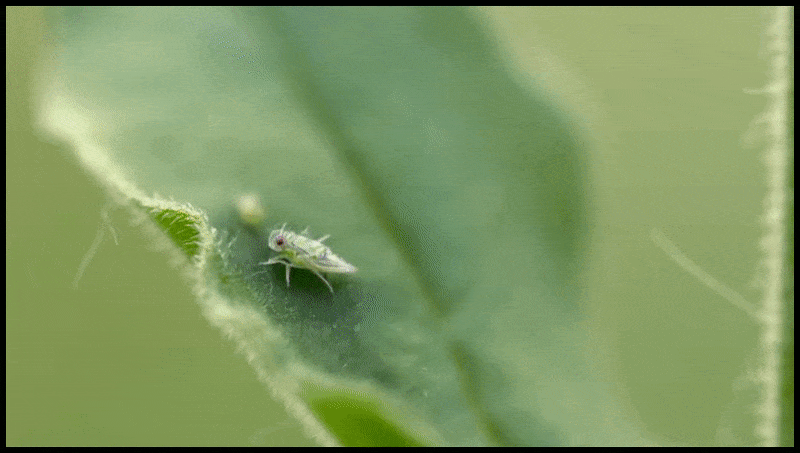
Runway ML의 Erase and Replace 기능으로, 텍스트‑비디오 편집 시스템 미리보기에서도 이미 확인되었습니다.
지우기 및 교체
Imagic과 마찬가지로 Erase and Replace는 정지 이미지에만 적용되지만, Runway는 아직 출시되지 않은 텍스트‑비디오 편집 솔루션에서 동일한 기능을 미리 보여주었습니다:
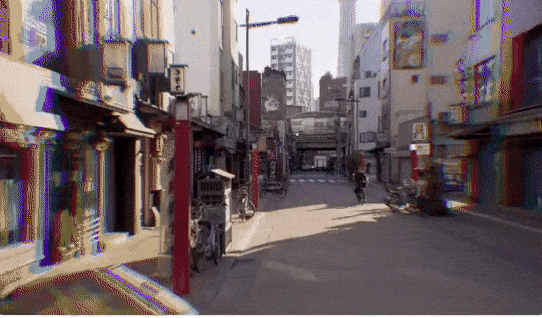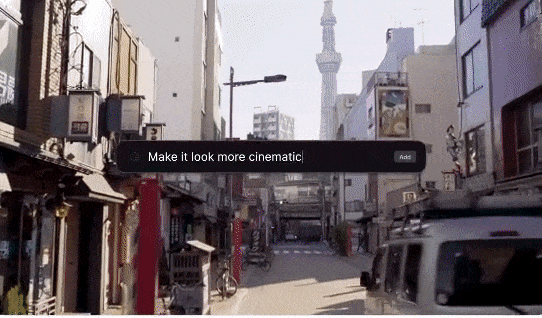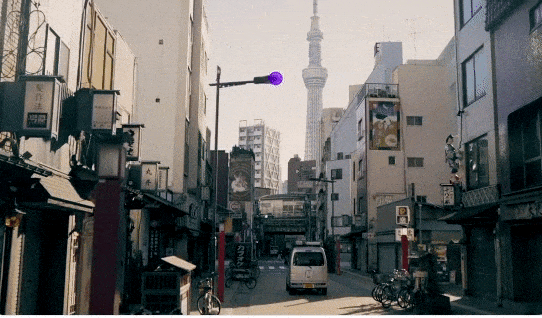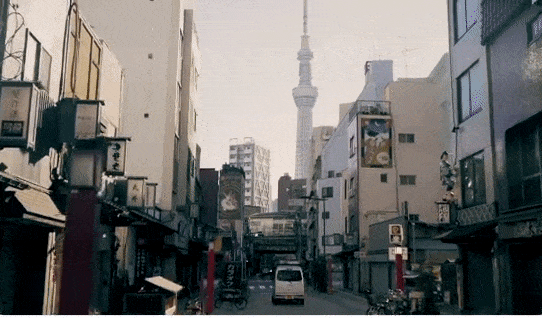
새로운 Erase and Replace를 이미지에 대해 누구나 시험해 볼 수 있지만, 비디오 버전은 아직 공개되지 않았습니다. 출처: https://twitter.com/runwayml/status/1568220303808991232
Runway ML이 Erase and Replace 뒤에 있는 기술 세부 정보를 공개하지 않았지만, 집 식물을 비교적 설득력 있는 로널드 레이건 초상상으로 교체하는 속도를 보면 Stable Diffusion과 같은 확산 모델(또는 가능성은 낮지만 라이선스를 받은 DALL‑E 2)이 Erase and Replace에서 선택한 객체를 재구성하는 엔진임을 알 수 있습니다.

집 식물을 ‘The Gipper’의 초상상으로 교체하는 것이 이만큼 빠르지는 않지만 꽤 빠릅니다. 출처: https://app.runwayml.com/
이 시스템은 DALL‑E 2와 유사한 제한을 가지고 있습니다 – Erase and Replace 필터를 트리거하는 이미지나 텍스트는 추가 위반 시 계정 정지 경고를 발생시킵니다 – 이는 사실상 OpenAI의 DALL‑E 2에 대한 정책을 그대로 복제한 것입니다.
많은 결과가 Stable Diffusion 특유의 거친 가장자리를 보이지 않습니다. Runway ML은 SD의 투자자이자 연구 파트너이며, 현재 우리 대부분이 다루고 있는 오픈소스 1.4 체크포인트 가중치보다 우수한 독점 모델을 훈련했을 가능성이 있습니다(다른 많은 개발 그룹, 취미·전문가 모두 현재 Stable Diffusion 모델을 훈련하거나 미세 조정하고 있기 때문입니다).
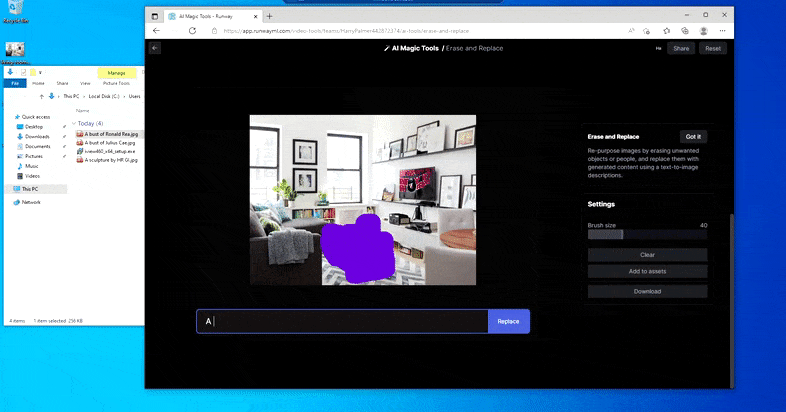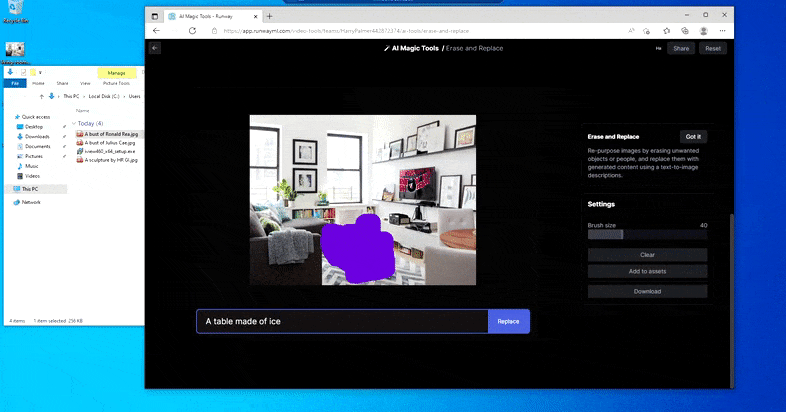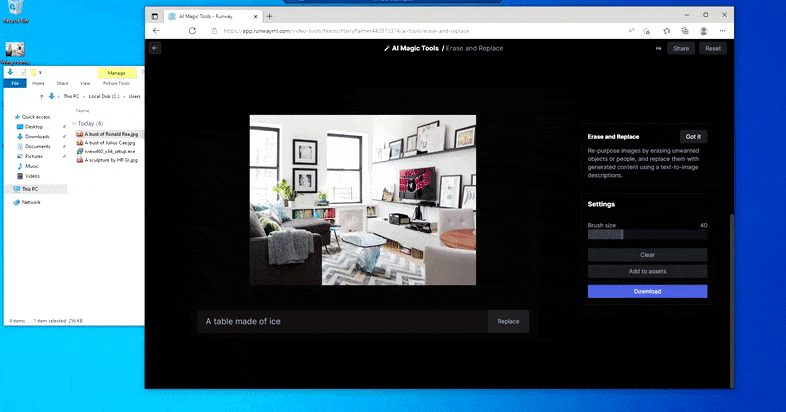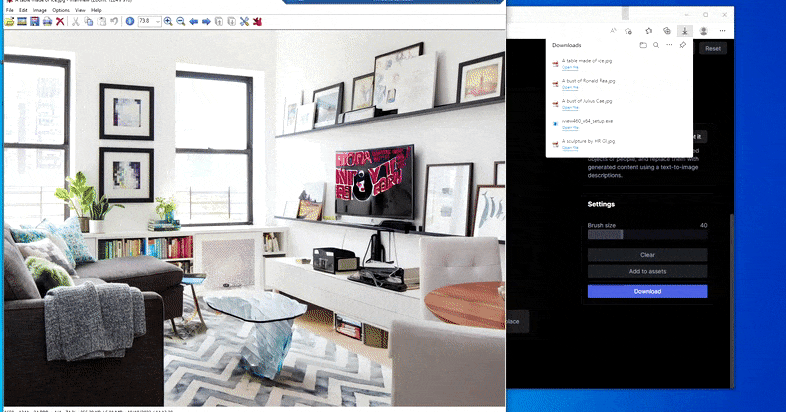
Runway ML의 Erase and Replace에서 일반 테이블을 ‘얼음으로 만든 테이블’로 교체합니다.
Imagic과 마찬가지(아래 참고)로 Erase and Replace는 일종의 ‘객체 지향’ 방식입니다 – 그림의 ‘빈’ 부분을 지우고 텍스트 프롬프트 결과로 채울 수는 없습니다; 이 경우 시스템은 마스크 시선에 가장 가까운 눈에 보이는 객체(예: 벽이나 텔레비전)를 추적하여 그곳에 변환을 적용합니다.
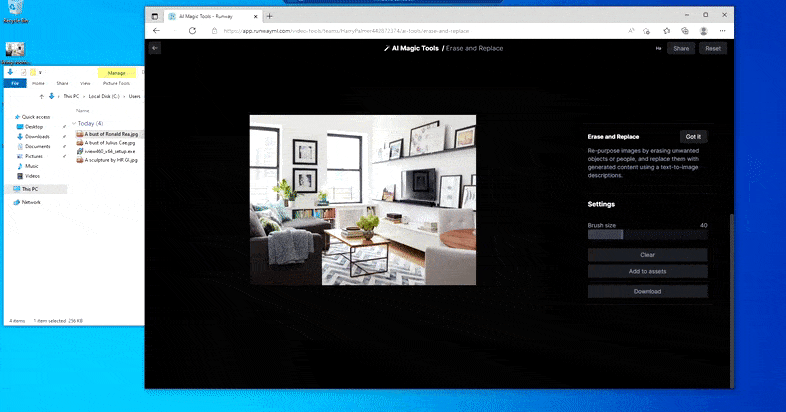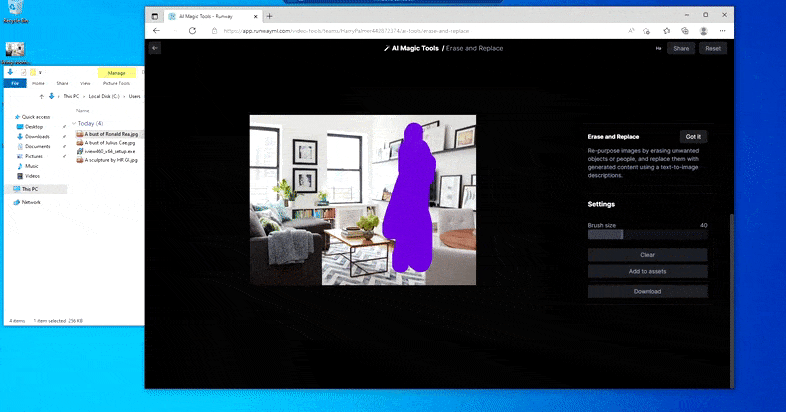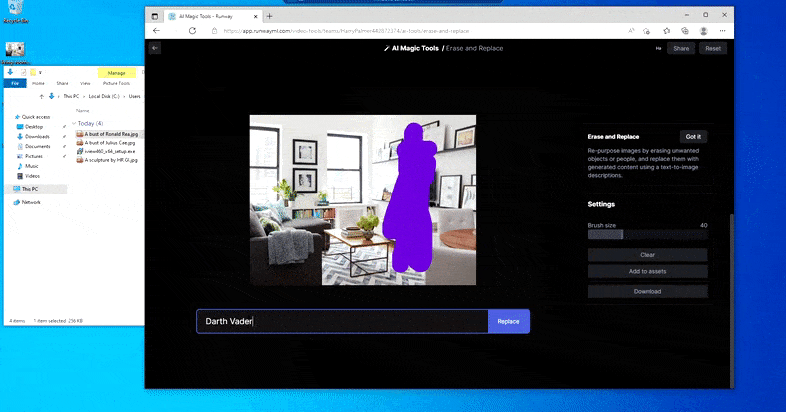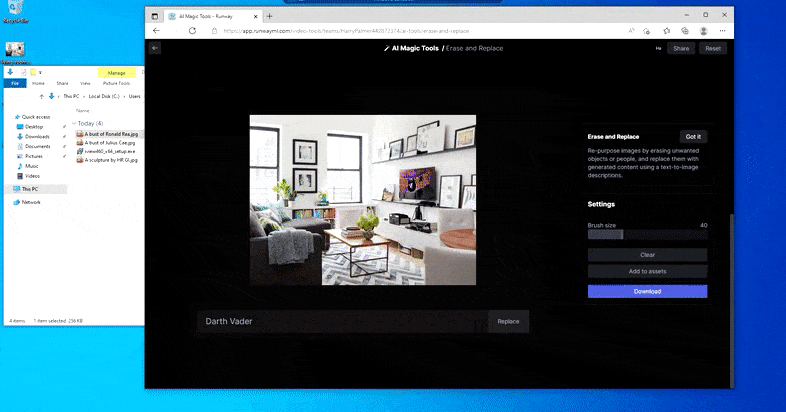
이름이 나타내듯이 Erase and Replace에서는 빈 공간에 객체를 삽입할 수 없습니다. 여기서는 가장 유명한 시스 군주를 소환하려는 시도가 TV에 이상한 베이더 관련 벽화를 만들었으며, 이는 ‘교체’ 영역이 그려진 대략적인 위치입니다.
Erase and Replace가 저작권이 있는 이미지를 회피하고 있는지(이러한 이미지는 DALL‑E 2에서도 여전히 크게 차단되지만 성공률은 다양함) 혹은 백엔드 렌더링 엔진에 사용되는 모델이 해당 용도에 최적화되지 않았는지는 판단하기 어렵습니다.

다소 성인용(NSFW)인 ‘Nicole Kidman 벽화’는 현재 사용 중인(아마도) 확산 기반 모델이 DALL‑E 2가 이전에 가지고 있던 현실적인 얼굴이나 선정적인 콘텐츠를 체계적으로 거부하는 기능이 부족함을 보여줍니다. 저작권이 있는 작품을 시도했을 때 결과는 모호한(‘xenomorph’)에서부터 터무니없는(‘the iron throne’)까지 다양합니다. 오른쪽 하단에 원본 사진이 삽입되어 있습니다.
Erase and Replace가 교체 가능한 객체를 분리하기 위해 어떤 방법을 사용하는지 알면 흥미로울 것입니다. 아마도 이미지는 CLIP의 변형을 통해 처리되고, 객체 인식 및 이후 의미론적 분할을 통해 개별 항목이 구분될 것으로 추정됩니다. 이러한 작업은 일반적인 Stable Diffusion 설치에서는 거의 제대로 작동하지 않습니다.
하지만 완벽한 것은 없습니다 – 때때로 시스템이 지우기는 하지만 교체하지 않을 때가 있습니다. (위 이미지에서 보듯) 기본 렌더링 메커니즘이 텍스트 프롬프트의 의미를 명확히 알고 있더라도 말이죠. 이 경우 커피 테이블을 외계인(xenomorph)으로 바꾸는 것이 불가능하며, 대신 테이블이 사라집니다.
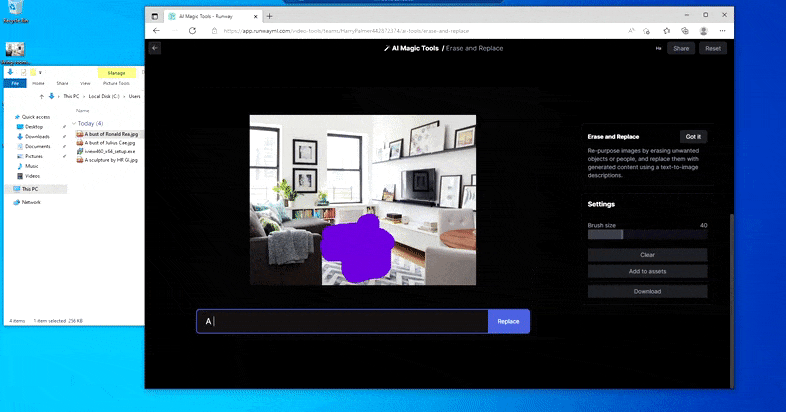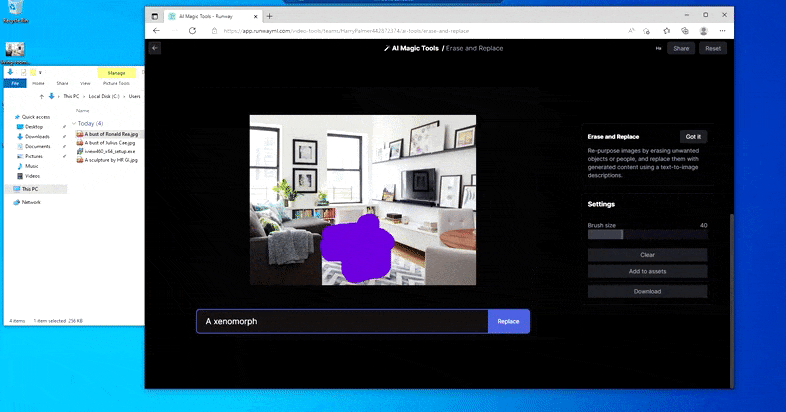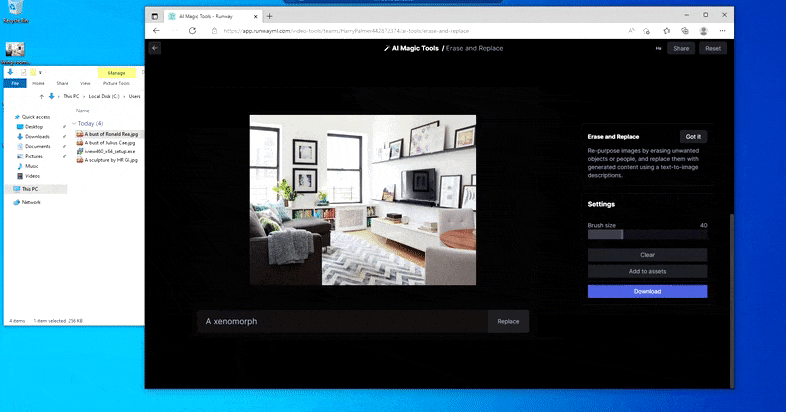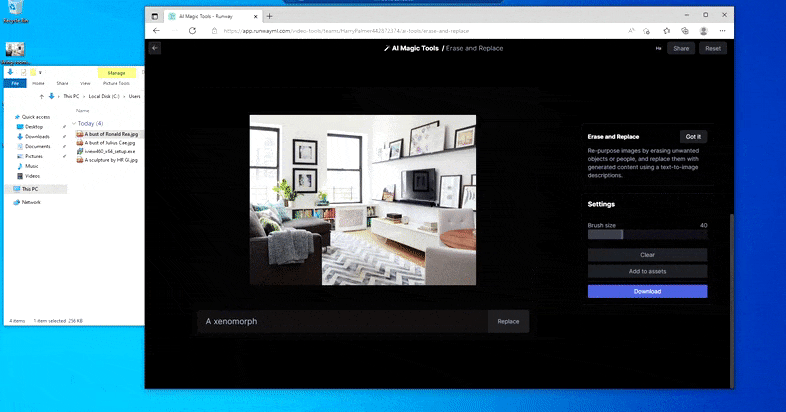
Erase and Replace가 외계인을 만들지 못해 ‘Where’s Waldo’의 더 무서운 버전이 됩니다.
Erase and Replace는 뛰어난 인페인팅을 갖춘 효과적인 객체 교체 시스템으로 보입니다. 그러나 기존에 인식된 객체를 편집할 수는 없고 교체만 가능합니다. 주변 재질을 손상시키지 않고 기존 이미지 내용을 실제로 변경하는 것은 훨씬 더 어려운 과제로, 이는 인기 프레임워크의 다양한 잠재 공간에서 디엔탱글링(disentanglement)을 향한 컴퓨터 비전 연구 분야의 오랜 투쟁과 얽혀 있습니다.
Imagic
Imagic이 바로 이 작업을 다룹니다. 새 논문은 사진의 개별 요소를 성공적으로 수정하면서 나머지 이미지는 그대로 두는 다양한 편집 사례를 제시합니다.

Imagic에서는 수정된 이미지가 단일 이미지에서 파생된 제한된 사전 정보를 이용하는 딥페이크 퍼펏리의 특징인 늘어짐, 왜곡 및 ‘가림 추측’ 현상을 겪지 않습니다.
시스템은 텍스트 임베딩 최적화, 모델 미세 조정, 그리고 최종적으로 수정된 이미지 생성이라는 세 단계 과정을 사용합니다.

Imagic은 목표 텍스트 프롬프트를 인코딩해 초기 텍스트 임베딩을 얻고, 이를 최적화해 입력 이미지를 생성합니다. 이후 생성 모델을 원본 이미지에 맞게 미세 조정하고 다양한 파라미터를 추가한 뒤, 요청된 보간을 수행합니다.
놀랍지 않게도 이 프레임워크는 Google의 Imagen 텍스트‑투‑비디오 아키텍처를 기반으로 하며, 연구자들은 시스템 원리가 잠재 확산 모델에도 폭넓게 적용될 수 있다고 밝히고 있습니다.
Imagen은 회사의 최신 텍스트‑투‑비디오 버전에서 사용되는 7단계 구조와 달리 3단계 아키텍처를 사용합니다. 이 세 개의 모듈은 64×64픽셀 해상도로 작동하는 생성 확산 모델, 이를 256×256픽셀로 확대하는 초해상도 모델, 그리고 최종적으로 1024×1024픽셀까지 확대하는 또 다른 초해상도 모델로 구성됩니다.
Imagic은 이 과정의 가장 초기 단계인 64픽셀 단계에서 요청된 텍스트 임베딩을 고정 학습률 0.0001의 Adam 옵티마이저로 최적화합니다.

디엔탱글링의 최고 수준: 확산, GAN 또는 NeRF 모델에서 렌더링된 객체의 색상 같은 간단한 변화를 시도한 최종 사용자는 Imagic이 이미지 나머지의 일관성을 ‘깨뜨리지’ 않고도 이러한 변환을 수행할 수 있다는 것이 얼마나 중요한지 잘 알고 있습니다.
그 후 미세 조정이 Imagen의 기본 모델에서 입력 이미지당 1500 단계 동안 수정된 임베딩을 조건으로 수행됩니다. 동시에 64px→256px 2차 레이어도 조건부 이미지에 대해 병렬로 최적화됩니다. 연구자들은 최종 256px→1024px 레이어에 대한 유사한 최적화가 최종 결과에 ‘거의 영향을 미치지 않는다’고 언급했으며, 따라서 이를 구현하지 않았습니다.
논문에 따르면 최적화 과정은 듀얼 TPUV4 칩에서 이미지당 약 8분이 소요됩니다. 최종 렌더링은 DDIM 샘플링 방식을 사용해 Imagen 코어에서 진행됩니다.
Google의 DreamBooth와 유사한 미세 조정 과정과 마찬가지로, 생성된 임베딩은 스타일링을 구동하거나 Imagen을 지원하는 광범위한 데이터베이스에서 추출한 정보를 포함한 사진실감 편집에도 활용될 수 있습니다(아래 첫 번째 열이 보여주듯, 원본 이미지에는 이러한 변환에 필요한 내용이 전혀 없습니다).

Imagic을 통해 유연한 사진실감 움직임과 편집을 이끌어낼 수 있으며, 과정에서 얻은 파생 및 디엔탱글된 코드는 스타일화된 출력에도 손쉽게 활용될 수 있습니다.
연구자들은 Imagic을 2021년 스탠포드 대학과 카네기 멜론 대학이 공동 개발한 GAN 기반 접근 방식인 SDEdit와, 2022년 4월 와이즈만 과학 연구소와 NVIDIA가 공동 작업한 Text2Live와 비교했습니다.

Imagic, SDEdit 및 Text2Live 간의 시각적 비교.
이전 접근 방식들은 어려움을 겪고 있는 것이 명확하지만, 자세를 크게 바꾸는 하단 행에서는 기존 방법들이 소스 자료를 전혀 재구성하지 못하고, Imagic은 눈에 띄는 성공을 보여줍니다.
Imagic의 자원 요구량과 이미지당 훈련 시간은 이러한 분야의 기준에 비하면 짧지만, 개인용 컴퓨터의 로컬 이미지 편집 애플리케이션에 포함되기는 어려우며, 미세 조정 과정을 소비자 수준으로 축소할 수 있는 정도는 아직 명확하지 않습니다.
현재로서는 Imagic이 인상적인 제품이지만 API에 더 적합합니다 – 딥페이킹을 촉진한다는 비판을 조심하는 Google Research가 가장 편안하게 여길 수 있는 환경이기도 합니다.
첫 번째 게시일: 2022년 10월 18일.


