
Sudut Anderson
Menghapus Objek dari Video dengan Lebih Efisien Menggunakan Pembelajaran Mesin

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Penelitian baru dari Tiongkok melaporkan hasil state-of-the-art – serta perbaikan yang mengesankan dalam efisiensi – untuk sistem inpainting video baru yang dapat dengan terampil menghapus objek dari footage.
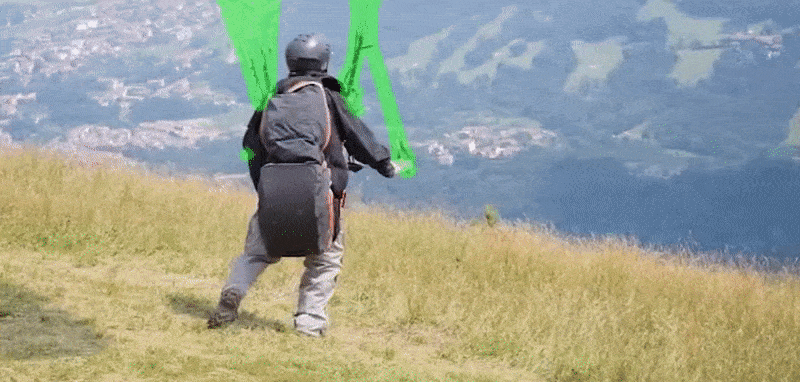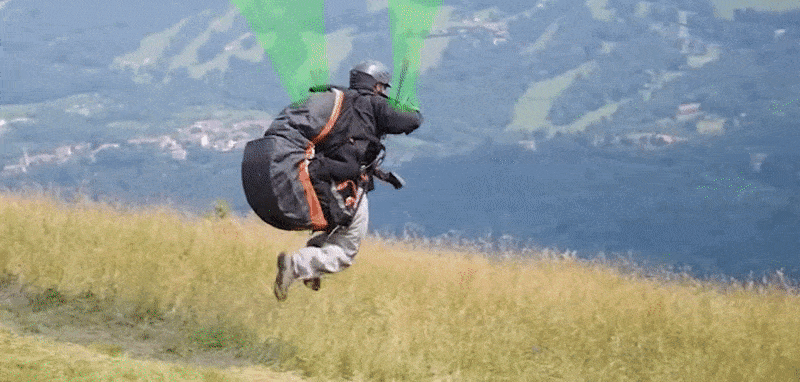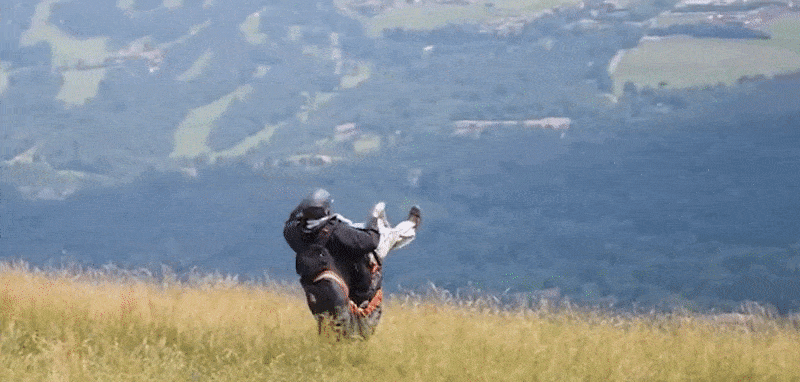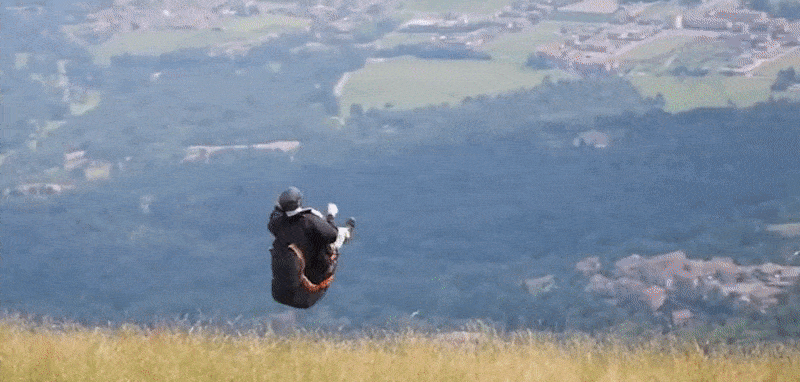
Harness hang-glider dihapus oleh prosedur baru. Lihat video sumber untuk resolusi yang lebih baik dan contoh lainnya. Sumber: https://www.youtube.com/watch?v=N–qC3T2wc4
Teknik ini, disebut End-to-End framework untuk Flow-Guided video Inpainting (E2FGVI), juga dapat menghapus watermark dan berbagai jenis oklusi lainnya dari konten video.
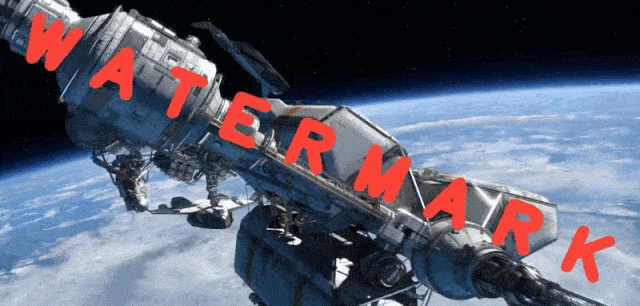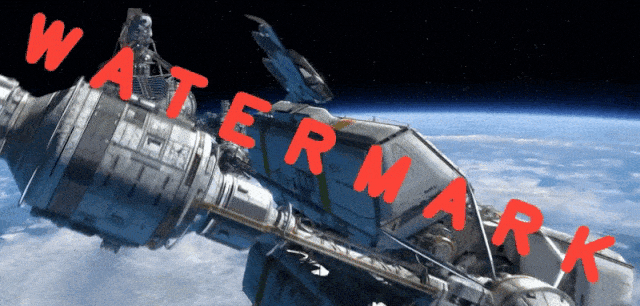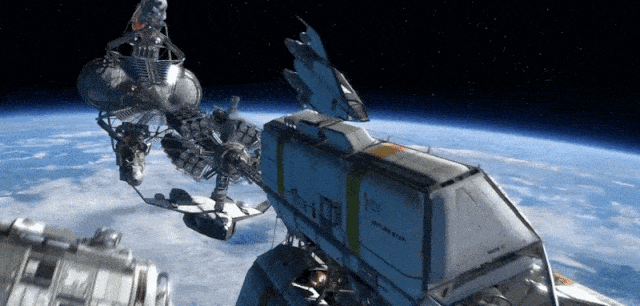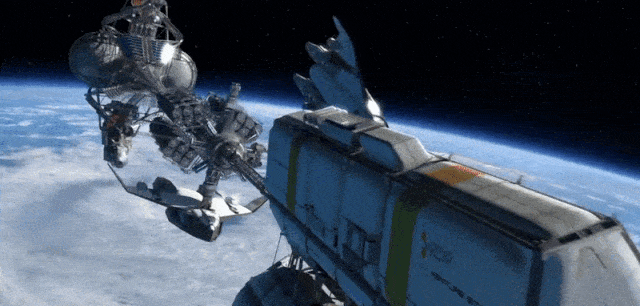
E2FGVI menghitung prediksi untuk konten yang terletak di belakang oklusi, memungkinkan penghapusan watermark yang bahkan sangat mencolok dan sulit diatasi. Sumber: https://github.com/MCG-NKU/E2FGVI
(Untuk melihat contoh lainnya dengan resolusi yang lebih baik, lihat video)
Meskipun model yang ditampilkan dalam makalah yang dipublikasikan dilatih pada video 432px x 240px (ukuran input yang umum, terbatas oleh ruang GPU yang tersedia vs. ukuran batch yang optimal dan faktor lainnya), penulis telah merilis E2FGVI-HQ, yang dapat menangani video dengan resolusi sewaktu-waktu.
Kode untuk versi saat ini tersedia di GitHub, sedangkan versi HQ, yang dirilis hari Minggu lalu, dapat diunduh dari Google Drive dan Baidu Disk.

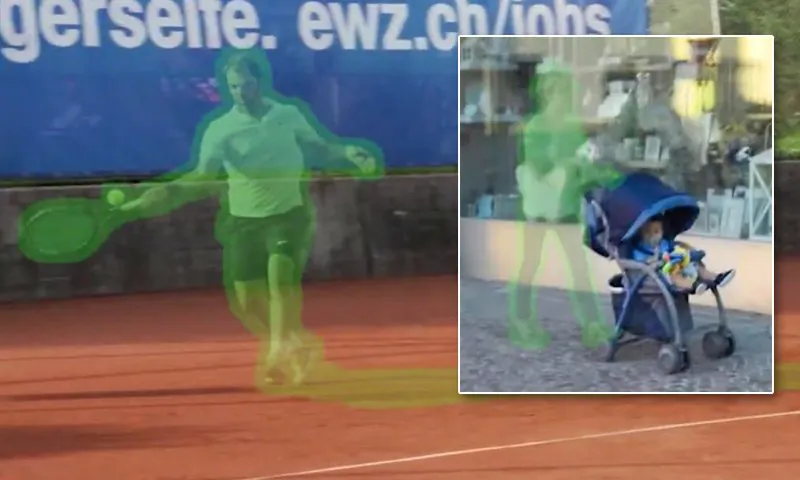
Anak tetap berada dalam gambar.
E2FGVI dapat memproses video 432×240 pada 0,12 detik per frame pada Titan XP GPU (12GB VRAM), dan penulis melaporkan bahwa sistem ini beroperasi lima belas kali lebih cepat daripada metode sebelumnya yang berbasis optical flow.
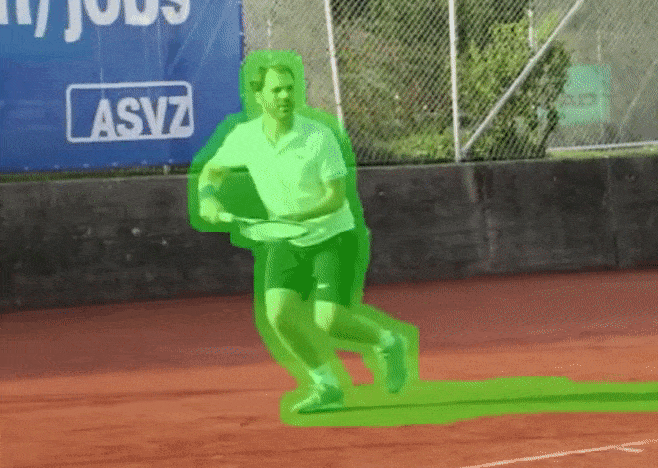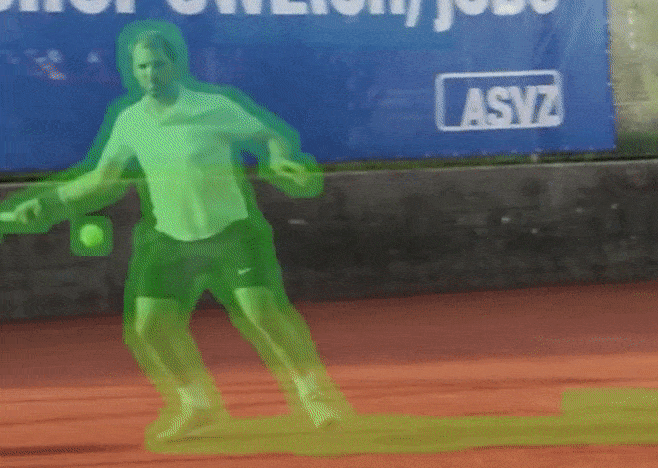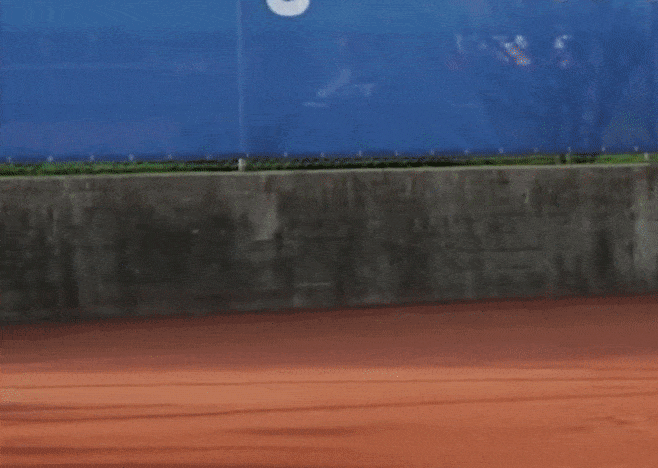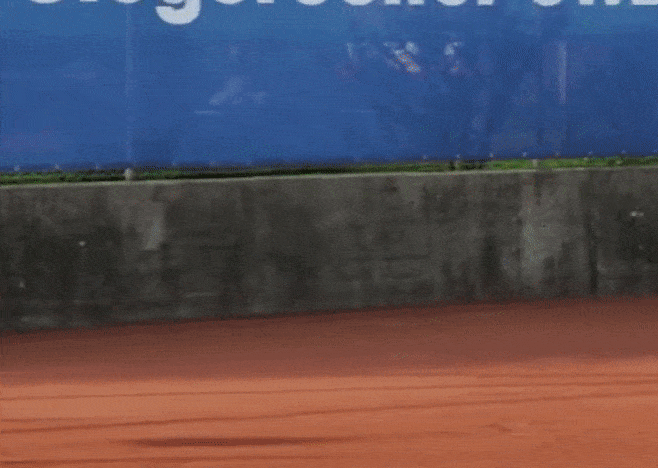
Pemain tenis membuat keluar yang tidak terduga.
Diuji pada dataset standar untuk sub-sektor penelitian sintesis gambar ini, metode baru ini dapat mengungguli saingannya dalam evaluasi kualitatif dan kuantitatif.

Uji coba terhadap pendekatan sebelumnya. Sumber: https://arxiv.org/pdf/2204.02663.pdf
Makalah ini berjudul Towards An End-to-End Framework for Flow-Guided Video Inpainting, dan merupakan kolaborasi antara empat peneliti dari Nankai University, bersama dengan seorang peneliti dari Hisilicon Technologies.
Apa yang Hilang dalam Gambar Ini
Selain aplikasi yang jelas untuk efek visual, inpainting video berkualitas tinggi akan menjadi fitur yang membedakan teknologi sintesis gambar dan pengubah gambar berbasis AI.
Ini terutama berlaku untuk aplikasi mode yang mengubah tubuh, dan kerangka lain yang berusaha untuk ‘menipiskan’ atau mengubah adegan dalam gambar dan video. Dalam kasus seperti itu, perlu untuk mengisi latar belakang yang terbuka dengan sintesis.

Dari makalah terbaru, algoritma ‘pengubahan tubuh’ ditugaskan untuk mengisi latar belakang yang terbuka ketika subjek diubah ukurannya. Di sini, kekurangan itu digambarkan oleh garis merah yang dulu ditempati oleh orang yang lebih berisi (lihat gambar kiri). Berdasarkan materi sumber dari https://arxiv.org/pdf/2203.10496.pdf
Aliran Optik yang Konsisten
Aliran optik (OF) telah menjadi teknologi inti dalam pengembangan penghapusan objek video. Seperti atlas, OF menyediakan peta satu-shot dari urutan temporal. Sering digunakan untuk mengukur kecepatan dalam inisiatif visi komputer, OF juga dapat memungkinkan in-painting yang konsisten secara temporal, di mana jumlah agregat tugas dapat dipertimbangkan dalam satu langkah, bukan perhatian ‘per-frame’ gaya Disney, yang pasti mengarah pada diskontinuitas temporal.
Metode inpainting video hingga saat ini telah berfokus pada proses tiga tahap: flow completion, di mana video secara esensial dipetakan menjadi entitas yang diskrit dan dapat dijelajahi; pixel propagation, di mana lubang dalam video ‘rusak’ diisi dengan mempropagasi piksel secara bidireksional; dan content hallucination (penemuan piksel yang familiar bagi kita dari deepfakes dan kerangka text-to-image seperti seri DALL-E) di mana konten ‘hilang’ yang diestimasi ditemukan dan dimasukkan ke dalam footage.
Inovasi sentral dari E2FGVI adalah menggabungkan tiga tahap ini menjadi sistem end-to-end, menghilangkan kebutuhan untuk melakukan operasi manual pada konten atau proses.

Makalah ini mengamati bahwa kebutuhan untuk intervensi manual memerlukan bahwa proses lama tidak menggunakan GPU, membuatnya cukup memakan waktu. Dari makalah*:
‘Mengambil DFVI sebagai contoh, menyelesaikan satu video dengan ukuran 432 × 240 dari DAVIS, yang berisi sekitar 70 frame, membutuhkan sekitar 4 menit, yang tidak dapat diterima dalam sebagian besar aplikasi dunia nyata. Selain itu, kecuali untuk kelemahan yang disebutkan di atas, hanya menggunakan jaringan inpainting gambar pra-dilatih pada tahap content hallucination mengabaikan hubungan konten di antara tetangga temporal, mengarah pada konten yang dihasilkan yang tidak konsisten dalam video.’
Dengan menggabungkan tiga tahap inpainting video, E2FGVI dapat menggantikan tahap kedua, propagasi piksel, dengan propagasi fitur. Dalam proses yang lebih tersegmentasi dari karya sebelumnya, fitur tidak tersedia secara luas, karena setiap tahap relatif hermetik, dan alur kerja hanya semi-otomatis.
Peneliti juga telah merancang temporal focal transformer untuk tahap content hallucination, yang mempertimbangkan tidak hanya tetangga langsung piksel dalam frame saat ini (yaitu apa yang terjadi di bagian frame itu dalam gambar sebelumnya atau berikutnya), tetapi juga tetangga yang jauh yang berada beberapa frame jauhnya, dan akan mempengaruhi efek kohesif dari operasi yang dilakukan pada video secara keseluruhan.

Arsitektur E2FGVI.
Bagian tengah fitur baru dari alur kerja ini dapat memanfaatkan proses level fitur yang lebih banyak dan offset sampling yang dapat dipelajari, sedangkan transformer fokus waktu proyek ini, menurut penulis, memperluas ukuran jendela fokus ‘dari 2D ke 3D’.
Uji Coba dan Data
Untuk menguji E2FGVI, peneliti mengevaluasi sistem ini melawan dua dataset video object segmentation populer: YouTube-VOS, dan DAVIS. YouTube-VOS memiliki 3741 klip video pelatihan, 474 klip validasi, dan 508 klip uji, sedangkan DAVIS memiliki 60 klip video pelatihan, dan 90 klip uji.
E2FGVI dilatih pada YouTube-VOS dan dievaluasi pada kedua dataset. Selama pelatihan, masker objek (area hijau dalam gambar di atas, dan video YouTube yang menyertainya) dibuat untuk mensimulasikan pengisian video.
Untuk metrik, peneliti mengadopsi Peak signal-to-noise ratio (PSNR), Structural similarity (SSIM), Video-based Fréchet Inception Distance (VFID), dan Flow Warping Error – yang terakhir untuk mengukur stabilitas temporal dalam video yang terkena.
Arsitektur sebelumnya yang diuji melawan sistem ini adalah VINet, DFVI, LGTSM, CAP, FGVC, STTN, dan FuseFormer.

Dari bagian hasil kuantitatif makalah. Panah atas dan bawah menunjukkan bahwa angka yang lebih tinggi atau lebih rendah lebih baik, masing-masing. E2FGVI mencapai skor terbaik di semua bidang. Metode ini dievaluasi sesuai dengan FuseFormer, meskipun DFVI, VINet dan FGVC bukan sistem end-to-end, membuatnya tidak mungkin untuk memperkirakan FLOPs mereka.
Selain mencapai skor terbaik melawan semua sistem yang bersaing, peneliti melakukan studi pengguna kualitatif, di mana video yang diubah dengan lima metode perwakilan ditampilkan secara individual kepada dua puluh relawan, yang diminta untuk menilainya dalam hal kualitas visual.

Sumbu vertikal mewakili persentase partisipan yang lebih memilih output E2FGVI dalam hal kualitas visual.
Penulis mencatat bahwa meskipun preferensi yang seragam untuk metode mereka, salah satu hasil, FGVC, tidak mencerminkan hasil kuantitatif, dan mereka menyarankan bahwa ini menunjukkan bahwa E2FGVI mungkin, secara spekulatif, ‘menghasilkan hasil yang lebih menyenangkan secara visual’.
Dalam hal efisiensi, penulis mencatat bahwa sistem mereka sangat mengurangi operasi floating point per detik (FLOPs) dan waktu inferensi pada satu Titan GPU pada dataset DAVIS, dan mengamati bahwa hasilnya menunjukkan E2FGVI berjalan x15 kali lebih cepat daripada metode berbasis aliran.
Mereka berkomentar:
‘[E2FGVI] memiliki FLOPs terendah dibandingkan dengan semua metode lain. Ini menunjukkan bahwa metode yang diusulkan sangat efisien untuk inpainting video.’
*Konversi saya dari kutipan inline penulis ke tautan.
Dipublikasikan pertama kali pada 19 Mei 2022.
Diperbarui pada hari Selasa, 28 Oktober 2025, untuk menghapus embed video yang rusak dan memperbarui referensi ke video yang disematkan dalam tubuh artikel.


