
प्रॉम्प्ट इंजीनियरिंग
एलएलएम फाइन-ट्यूनिंग को समझना: बड़े भाषा मॉडल्स को आपकी विशिष्ट आवश्यकताओं के अनुसार अनुकूलित करना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुफाइन-ट्यूनिंग बड़े मॉडल्स को विशिष्ट कार्यों के लिए प्री-ट्रेनिंग की तुलना में काफी कम…
और देखें
- फाइन-ट्यूनिंग बड़े मॉडल्स को विशिष्ट कार्यों के लिए प्री-ट्रेनिंग की तुलना में काफी कम डेटा का उपयोग करके अनुकूलित करती है।
- क्यू-लोरा क्वांटीकरण और लो-रैंक अनुकूलन को जोड़कर ट्यूनिंग के लिए मेमोरी आवश्यकताओं को काफी कम कर देता है।
- मानवीय प्रतिक्रिया से सुदृढ़ीकरण सीखना मॉडल आउटपुट को मानवीय प्राथमिकताओं और मूल्यों के साथ सूक्ष्मता से संरेखित करता है।
सितंबर 2023 में, बड़े भाषा मॉडल्स (एलएलएम) का परिदृश्य अभी भी अल्पाका, फाल्कन, लामा 2, जीपीटी-4, और कई अन्य मॉडल्स के उदय को देख रहा है।
इन एलएलएम की क्षमता का लाभ उठाने का एक महत्वपूर्ण पहलू फाइन-ट्यूनिंग प्रक्रिया में निहित है, जो पूर्व-प्रशिक्षित मॉडल्स को विशिष्ट कार्यों के लिए अनुकूलित करने की अनुमति देता है। यह फाइन-ट्यूनिंग के माध्यम से है कि ये मॉडल्स वास्तव में व्यक्तिगत आवश्यकताओं के साथ संरेखित हो सकते हैं, जो नवाचारी और अनुकूलित समाधान प्रदान करते हैं।

हालांकि, यह ध्यान रखना आवश्यक है कि सभी फाइन-ट्यूनिंग मार्ग समान नहीं हैं। उदाहरण के लिए, जीपीटी-4 की फाइन-ट्यूनिंग क्षमताओं तक पहुंचने के लिए एक प्रीमियम सदस्यता की आवश्यकता होती है, जो बाजार में उपलब्ध अन्य विकल्पों की तुलना में अपेक्षाकृत अधिक महंगी है। दूसरी ओर, ओपन-सोर्स डोमेन में विकल्प हैं जो बड़े भाषा मॉडल्स की क्षमता का उपयोग करने के लिए एक अधिक सुलभ मार्ग प्रदान करते हैं। ये ओपन-सोर्स विकल्प उन्नत एआई प्रौद्योगिकी तक पहुंच को लोकतांत्रिक बनाते हैं, जो तेजी से विकसित हो रहे एआई परिदृश्य में नवाचार और समावेशिता को बढ़ावा देते हैं।

एलएलएम फाइन-ट्यूनिंग क्यों महत्वपूर्ण है?
एलएलएम फाइन-ट्यूनिंग केवल एक तकनीकी उन्नति नहीं है, बल्कि एलएलएम मॉडल विकास का एक महत्वपूर्ण पहलू है जो विशिष्ट अनुप्रयोगों में अधिक विशिष्ट और परिष्कृत अनुप्रयोग की अनुमति देता है। फाइन-ट्यूनिंग पूर्व-प्रशिक्षित मॉडल्स को विशिष्ट डेटासेट के लिए अनुकूलित करता है, उनके प्रदर्शन को विशिष्ट कार्यों में बढ़ाता है, और एक अधिक लक्षित अनुप्रयोग सुनिश्चित करता है। यह एलएलएम की उल्लेखनीय क्षमता को प्रदर्शित करता है कि वे नए डेटा के अनुसार अनुकूलित हो सकते हैं, जो एआई अनुप्रयोगों में बढ़ते हुए हित में महत्वपूर्ण है।
बड़े भाषा मॉडल्स को फाइन-ट्यून करने से कई अवसर खुलते हैं, जो उन्हें विशिष्ट कार्यों में उत्कृष्टता प्राप्त करने की अनुमति देता है, जैसे कि भावना विश्लेषण से लेकर चिकित्सा साहित्य समीक्षा तक। मॉडल को एक विशिष्ट उपयोग के मामले के लिए ट्यून करने से, हम नई संभावनाओं को खोलते हैं, मॉडल की दक्षता और सटीकता में सुधार करते हैं। इसके अलावा, यह प्रणाली संसाधनों का अधिक किफायती उपयोग सुनिश्चित करता है, क्योंकि फाइन-ट्यूनिंग के लिए मॉडल को शुरुआत से प्रशिक्षित करने की तुलना में कम गणनात्मक शक्ति की आवश्यकता होती है।
निर्देश-आधारित फाइन-ट्यूनिंग
जनरेटिव AI के जीवनचक्र में फाइन-ट्यूनिंग चरण के दौरान निर्देश वाले इनपुट और उनके आउटपुट के साथ चरणबद्ध तर्क के उदाहरण शामिल किए जाते हैं। इससे मॉडल ऐसे उत्तर देना सीखता है जो प्रासंगिक होने के साथ दिए गए निर्देशों के अनुरूप भी हों। इस चरण में विशिष्ट डेटासेट की मदद से पूर्व-प्रशिक्षित मॉडल को अलग-अलग कार्यों और उपयोगों के लिए अनुकूलित किया जाता है। नीचे का चित्र इस चरण को दिखाता है।

जनरेटिव AI का जीवनचक्र: फाइन-ट्यूनिंग
एकल-कार्य फाइन-ट्यूनिंग
इस पद्धति में मॉडल को किसी एक कार्य, जैसे सारांश बनाने, में विशेषज्ञ बनाया जाता है। यह कानूनी दस्तावेज़ों, बड़े दस्तावेज़ों, लंबी बातचीत और ग्राहक सहायता टिकटों वाले कार्यप्रवाहों के लिए उपयोगी है। केवल 500–1,000 उदाहरणों से भी प्रदर्शन में उल्लेखनीय सुधार हो सकता है, जबकि पूर्व-प्रशिक्षण में अरबों टोकन लगते हैं।

एकल-कार्य फाइन-ट्यूनिंग का उदाहरण
फाइन-ट्यूनिंग की नींव: ट्रांसफॉर्मर आर्किटेक्चर और आगे
LLM को समझने के लिए उसके आधारभूत घटकों को समझना ज़रूरी है। केंद्र में ट्रांसफॉर्मर आर्किटेक्चर होता है, जो सेल्फ-अटेंशन की मदद से केवल वाक्य में शब्दों की निकटता के बजाय उनके संदर्भ को प्राथमिकता देता है। इससे दूर स्थित टोकन के संबंध समझे जा सकते हैं।
प्रक्रिया एनकोडर से शुरू होती है: इनपुट को टोकन में विभाजित किया जाता है और ऐसे एम्बेडिंग वेक्टर बनाए जाते हैं जो इनपुट और वाक्य में उसकी स्थिति को दर्शाते हैं। फिर Query, Value और Key मैट्रिक्स पर गणनाओं से सेल्फ-अटेंशन स्कोर मिलता है, जो तय करता है कि किन टोकन और वाक्यांशों पर ध्यान देना है।

ट्रांसफॉर्मर आर्किटेक्चर
फाइन-ट्यूनिंग में मॉडल को छोटे समायोजन देकर अधिक वांछित आउटपुट प्राप्त किए जाते हैं। बड़ी संख्या में पैरामीटर सँभालने की गणना और भंडारण संबंधी चुनौतियाँ भी होती हैं। पैरामीटर-दक्ष फाइन-ट्यूनिंग (PEFT) प्रशिक्षण योग्य पैरामीटर कम करके प्रक्रिया को सरल बनाती है।
LLM का पूर्व-प्रशिक्षण: मजबूत आधार बनाना
शुरुआती चरण में बड़ी संख्या में पैरामीटर वाले ट्रांसफॉर्मर का उपयोग किया जाता है। बड़े, बिना लेबल वाले पाठ-संग्रहों पर द्विदिशात्मक, ऑटोरेग्रेसिव या सीक्वेंस-टू-सीक्वेंस तरीके से भाषा मॉडलिंग की जाती है। लक्ष्य ऐसा आधार तैयार करना है जिसे बाद में कार्य-विशिष्ट उद्देश्यों के माध्यम से अनुकूलित किया जा सके।

पूर्व-प्रशिक्षण और फाइन-ट्यूनिंग
पूर्व-प्रशिक्षित मॉडल का आकार, जिसे पैरामीटरों की संख्या से मापा जाता है, लगातार बढ़ता रहा है। अनुभवजन्य परिणाम दिखाते हैं कि अधिक डेटा के साथ बड़े मॉडल आम तौर पर बेहतर प्रदर्शन करते हैं। उदाहरण के लिए, 175 अरब पैरामीटर वाला GPT-3 उच्च गुणवत्ता की भाषा उत्पन्न करने और बिना कार्य-विशिष्ट उदाहरणों वाले ज़ीरो-शॉट कार्यों के लिए एक मानक बना।
फाइन-ट्यूनिंग: मॉडल अनुकूलन का रास्ता
पूर्व-प्रशिक्षण के बाद मॉडल को विशिष्ट कार्यों के लिए फाइन-ट्यून किया जाता है। GPT-3 जैसे मॉडल में इन-कॉन्टेक्स्ट लर्निंग के अच्छे परिणामों के बावजूद, कार्य-विशिष्ट परिस्थितियों में फाइन-ट्यूनिंग बेहतर हो सकती है। लेकिन सभी पैरामीटर अपडेट करने पर, खासकर बड़े मॉडल में, गणना और मेमोरी की मांग बहुत बढ़ जाती है।
एक अरब से अधिक पैरामीटर वाले मॉडल में GPU RAM का कुशल प्रबंधन आवश्यक है। 32-बिट पर एक पैरामीटर को 4 बाइट चाहिए, इसलिए एक अरब पैरामीटर का मॉडल लोड करने में ही लगभग 4 GB लगता है। ऑप्टिमाइज़र की अवस्थाएँ, ग्रेडिएंट और अन्य प्रशिक्षण घटक अतिरिक्त मेमोरी लेते हैं; लेख के उदाहरण में प्रशिक्षण के लिए 80 GB तक GPU RAM की आवश्यकता हो सकती है।
क्वांटाइज़ेशन पैरामीटरों की संख्यात्मक परिशुद्धता घटाकर मेमोरी की जरूरत कम करता है। उदाहरण के लिए, 32-बिट से 16-बिट पर जाने से संबंधित भंडारण आवश्यकता आधी हो सकती है। आगे चर्चा की गई QLoRA भी क्वांटाइज़ेशन का उपयोग करती है।

पैरामीटरों की संख्या और परिशुद्धता के अनुसार GPU मेमोरी
PEFT विधियों की श्रेणियाँ

पैरामीटर-दक्ष फाइन-ट्यूनिंग विधियाँ
पूर्ण फाइन-ट्यूनिंग में केवल मॉडल के वज़न ही नहीं, बल्कि ऑप्टिमाइज़र की अवस्थाओं, ग्रेडिएंट, फॉरवर्ड एक्टिवेशन और प्रशिक्षण के विभिन्न चरणों की अस्थायी मेमोरी के लिए भी संसाधन चाहिए। सबसे बड़े मॉडल के वज़न ही सैकड़ों गीगाबाइट तक पहुँच सकते हैं।
अतिरिक्त पैरामीटर जोड़ने वाली विधियाँ
इनमें पूर्व-प्रशिक्षित मॉडल में नए पैरामीटर या परतें जोड़कर केवल उन्हीं को प्रशिक्षित किया जाता है। कुल पैरामीटर बढ़ने के बावजूद प्रशिक्षण में समय और मेमोरी बच सकते हैं। प्रमुख प्रकार हैं:
- एडेप्टर: ट्रांसफॉर्मर की उपपरतों के बाद छोटे पूर्णतः जुड़े नेटवर्क जोड़ना; उदाहरण हैं AdaMix, KronA और Compactor।
- सॉफ्ट प्रॉम्प्ट: ग्रेडिएंट डिसेंट से इनपुट एम्बेडिंग के एक हिस्से को फाइन-ट्यून करना; उदाहरण हैं IPT, prefix-tuning और WARP।
- अन्य तरीके: LeTS, AttentionFusion और Ladder-Side Tuning जैसी तकनीकें।
चयनात्मक विधियाँ
चयनात्मक PEFT में परत के प्रकार और मॉडल की आंतरिक संरचना के आधार पर ऊपरी परतों के सीमित पैरामीटरों को अपडेट किया जाता है। BitFit और LN tuning जैसे तरीके बायस या विशिष्ट पंक्तियों जैसे घटकों पर ध्यान देते हैं।
पुनर्पैरामीटरीकरण-आधारित विधियाँ
लो-रैंक प्रतिनिधित्व से प्रशिक्षण योग्य पैरामीटर घटाए जाते हैं। सबसे प्रसिद्ध उदाहरण LoRA है, जिसमें वज़न के अपडेट को छोटे लो-रैंक मैट्रिक्स के गुणन के रूप में व्यक्त करके कम-रैंक उपस्थान में प्रभावी फाइन-ट्यूनिंग की जाती है।
1) LoRA: लो-रैंक एडेप्टेशन
Edward J. Hu और सहलेखकों ने 2021 के शोधपत्र में LoRA प्रस्तुत किया। यह मॉडल के मूल वज़न स्थिर रखकर ट्रांसफॉर्मर की परतों में नए प्रशिक्षण योग्य लो-रैंक मैट्रिक्स जोड़ता है। इससे प्रशिक्षण योग्य पैरामीटर, समय और गणनात्मक संसाधन कम होते हैं।
ट्रांसफॉर्मर में इनपुट प्रॉम्प्ट को टोकन और फिर एम्बेडिंग वेक्टर में बदला जाता है। वे एनकोडर और/या डिकोडर में सेल्फ-अटेंशन तथा फीड-फॉरवर्ड नेटवर्क से गुजरते हैं, जिनके वज़न पहले से प्रशिक्षित होते हैं।
लेख कम-रैंक प्रतिनिधित्व को सिंगुलर वैल्यू डीकंपोज़िशन (SVD) से समझाता है। SVD मैट्रिक्स को तीन मैट्रिक्स में विभाजित करता है, जिनमें एक विकर्ण मैट्रिक्स सिंगुलर वैल्यू रखता है। बड़ी वैल्यू अधिक महत्वपूर्ण आयामों और छोटी वैल्यू कम महत्वपूर्ण आयामों को दर्शाती हैं।

m × n मैट्रिक्स का SVD
कम-रैंक प्रतिनिधित्व महत्वपूर्ण विशेषताएँ रखते हुए आवश्यक आयाम कम कर सकता है। LoRA सभी मूल पैरामीटर स्थिर रखता है और मूल वज़न के साथ A तथा B नाम के दो छोटे रैंक-डीकंपोज़िशन मैट्रिक्स जोड़ता है, जिन्हें सुपरवाइज्ड लर्निंग से प्रशिक्षित किया जाता है।
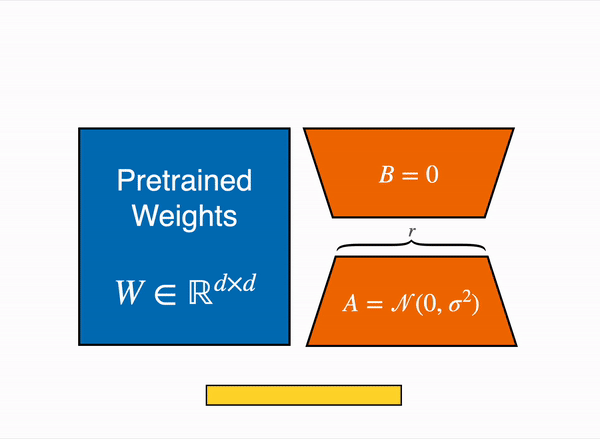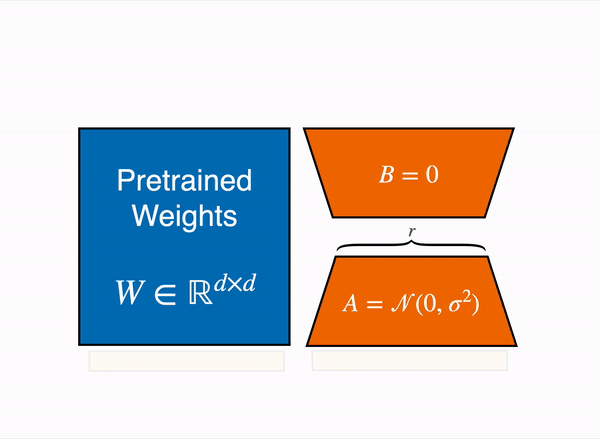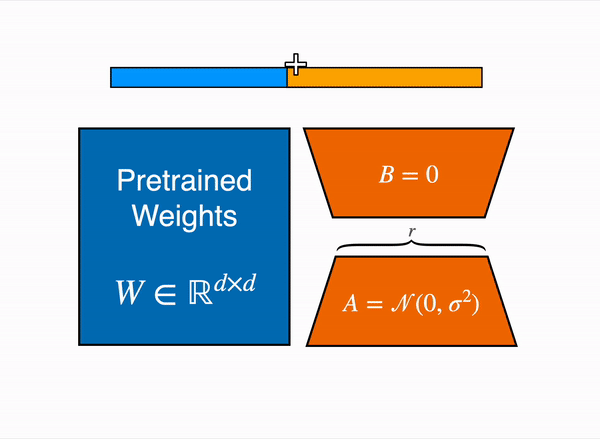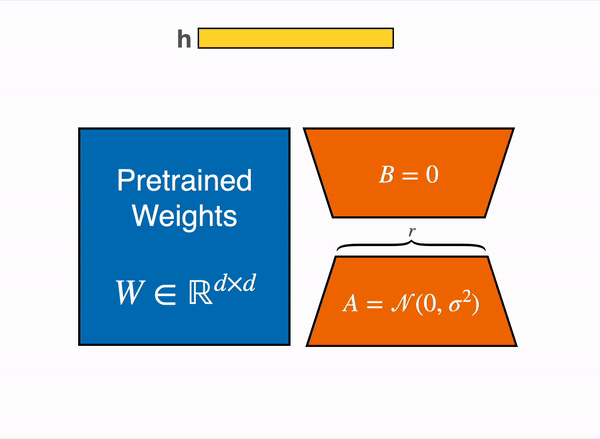
LLM में LoRA का उदाहरण
रैंक r इन मैट्रिक्स का आकार तय करती है। उचित छोटी रैंक से भी अच्छे परिणाम मिल सकते हैं और अपडेट किए जाने वाले पैरामीटर कम रहते हैं। Hugging Face Transformers जैसी ओपन-सोर्स लाइब्रेरी के साथ LoRA फाइन-ट्यूनिंग कई कार्यों में कुशलता से लागू की गई है।
2) QLoRA: LoRA की दक्षता बढ़ाना
Tim Dettmers और सहलेखकों ने 2023 में QLoRA प्रस्तुत किया। यह लो-रैंक एडेप्टेशन को NormalFloat4 (NF4) नाम के 4-बिट क्वांटाइज़ेशन से जोड़कर मेमोरी घटाता है। क्वांटाइज़ेशन अधिक परिशुद्ध प्रतिनिधित्व को कम परिशुद्ध रूप में बदलता है। गणना के समय आवश्यकता अनुसार 4-बिट वज़न को 16-बिट में डी-क्वांटाइज़ किया जाता है, ताकि 16-बिट फाइन-ट्यूनिंग की प्रभावशीलता बनी रहे।
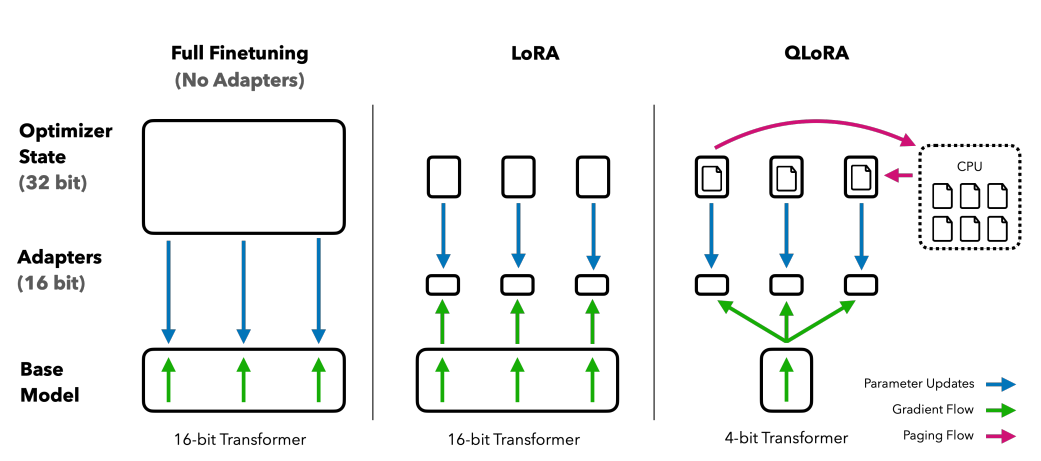
QLoRA में 4-बिट क्वांटाइज़ेशन और मेमोरी उछाल सँभालने वाले पेज्ड ऑप्टिमाइज़र
QLoRA ट्रांसफॉर्मर की सभी परतों पर अनुकूलन लागू करती है और डबल क्वांटाइज़ेशन के माध्यम से पहले से क्वांटाइज़ किए गए स्थिरांकों को भी क्वांटाइज़ करती है। इससे अतिरिक्त मेमोरी बचती है। पेज्ड ऑप्टिमाइज़र और यूनिफाइड मेमोरी प्रबंधन प्रशिक्षण के दौरान होने वाले मेमोरी उछाल सँभालते हैं।
QLoRA से फाइन-ट्यून किए गए Guanaco मॉडल को मानव और स्वचालित मूल्यांकन में अच्छे परिणाम मिले। संशोधित OASST1 डेटासेट पर प्रशिक्षित 65B और 33B संस्करणों को लेख ChatGPT और GPT-4 जैसे मॉडलों के प्रभावी प्रतिस्पर्धी के रूप में प्रस्तुत करता है।
मानव प्रतिक्रिया से पुनर्बलन अधिगम के माध्यम से फाइन-ट्यूनिंग
Reinforcement Learning from Human Feedback (RLHF) पूर्व-प्रशिक्षित भाषा मॉडल को मानव मूल्यों और पसंद के अधिक अनुरूप बनाने की तकनीक है। लेख इसे OpenAI के 2017 के काम से जोड़ता है, जिसने दस्तावेज़ सारांश और InstructGPT जैसे मॉडल के विकास की नींव रखी।
पुनर्बलन अधिगम में एजेंट वातावरण में कार्रवाई करता है, पुरस्कार प्राप्त करता है और अधिक पुरस्कार देने वाले विकल्प चुनना सीखता है। भाषा मॉडल के मामले में एजेंट स्वयं मॉडल होता है, वातावरण वर्तमान कॉन्टेक्स्ट विंडो है और अवस्था उसमें मौजूद टोकन से तय होती है। कार्रवाई के विकल्प वे संभावित टोकन हैं जिनमें से मॉडल अगला टोकन चुन सकता है। लक्ष्य मानव पसंद के अनुरूप चयन करना है।
RLHF में मानव प्रतिक्रिया से एक रिवार्ड मॉडल प्रशिक्षित किया जाता है। वह फाइन-ट्यूनिंग के दौरान मॉडल को अधिक उपयुक्त आउटपुट की ओर मार्गदर्शन देता है। यह पुनरावृत्त प्रक्रिया रोलआउट के माध्यम से चलती है: भाषा उत्पादन के संदर्भ में वे अवस्थाओं और कार्रवाइयों के क्रम होते हैं जो पुरस्कार तक पहुँचते हैं।

RLHF से AI सहायक को व्यक्तिगत उपयोगकर्ता की पसंद, हास्यबोध और दैनिक दिनचर्या के अनुसार ढालने की संभावना बनती है। इससे तकनीकी क्षमता के साथ मानव संचार की बारीकियों के प्रति संवेदनशील प्रणालियाँ बन सकती हैं। फिर भी यह अचूक समाधान नहीं है: विशाल, कभी-कभी अनियंत्रित और पक्षपाती प्रशिक्षण डेटा के कारण मॉडल अब भी अवांछित आउटपुट दे सकता है।
निष्कर्ष
Alpaca, Falcon और GPT-4 जैसे LLM का पूरा उपयोग करने के लिए फाइन-ट्यूनिंग अधिक केंद्रित और परिष्कृत हुई है। एकल-कार्य फाइन-ट्यूनिंग विशिष्ट भूमिकाओं के लिए मॉडल तैयार करती है, जबकि LoRA और QLoRA जैसी PEFT विधियाँ प्रशिक्षण को कुशल और किफायती बनाती हैं। इससे उन्नत AI क्षमताएँ अधिक लोगों तक पहुँच सकती हैं।
RLHF मॉडल को मानव मूल्यों और व्यक्तिगत पसंद के अधिक अनुरूप बनाता है। RLHF और PEFT मिलकर LLM की कार्यक्षमता और दक्षता बढ़ा सकते हैं। ऐसे मॉडल अपनाने वाले व्यवसायों और व्यक्तियों के लिए AI केवल एक उपकरण नहीं, बल्कि मानव संदर्भ समझने और उसके अनुसार व्यक्तिगत समाधान देने वाला सहयोगी बन सकता है।


