Fondamentaux de l’IA
Qu’est‑ce que la descente de gradient ?

 Ajouter Unite.AI à vos sources préférées sur Google
Gradient descent est une méthode d’optimisation qui ajuste les paramètres du modèle afin de réduire une fonction objective. Dans l’entraînement de réseaux neuronaux, cet objectif est généralement une perte calculée sur les exemples. Le gradient indique la direction de l’augmentation locale la plus forte, ainsi la descente de gradient effectue un pas dans la direction opposée.
Le gradient décrit la sensibilité locale ; son amplitude n’est pas une mesure directe de la vitesse d’« apprentissage » d’un modèle. Les progrès réels dépendent également du taux d’apprentissage, de la courbure, du bruit, de la paramétrisation, de l’état de l’optimiseur et des données.
Points clés
- Backpropagation calcule les gradients, tandis que la descente de gradient les utilise pour mettre à jour les paramètres.
- L’optimisation mini-batch est l’approche pratique standard pour le deep learning.
- Le taux d’apprentissage contrôle l’échelle de la mise à jour et peut suivre un planning plutôt que de diminuer après chaque pas.
- Le momentum, AdamW, le clipping et la normalisation résolvent différents problèmes d’optimisation.
Règle de mise à jour de base
Pour le vecteur de paramètres θ, le taux d’apprentissage η et la perte L:
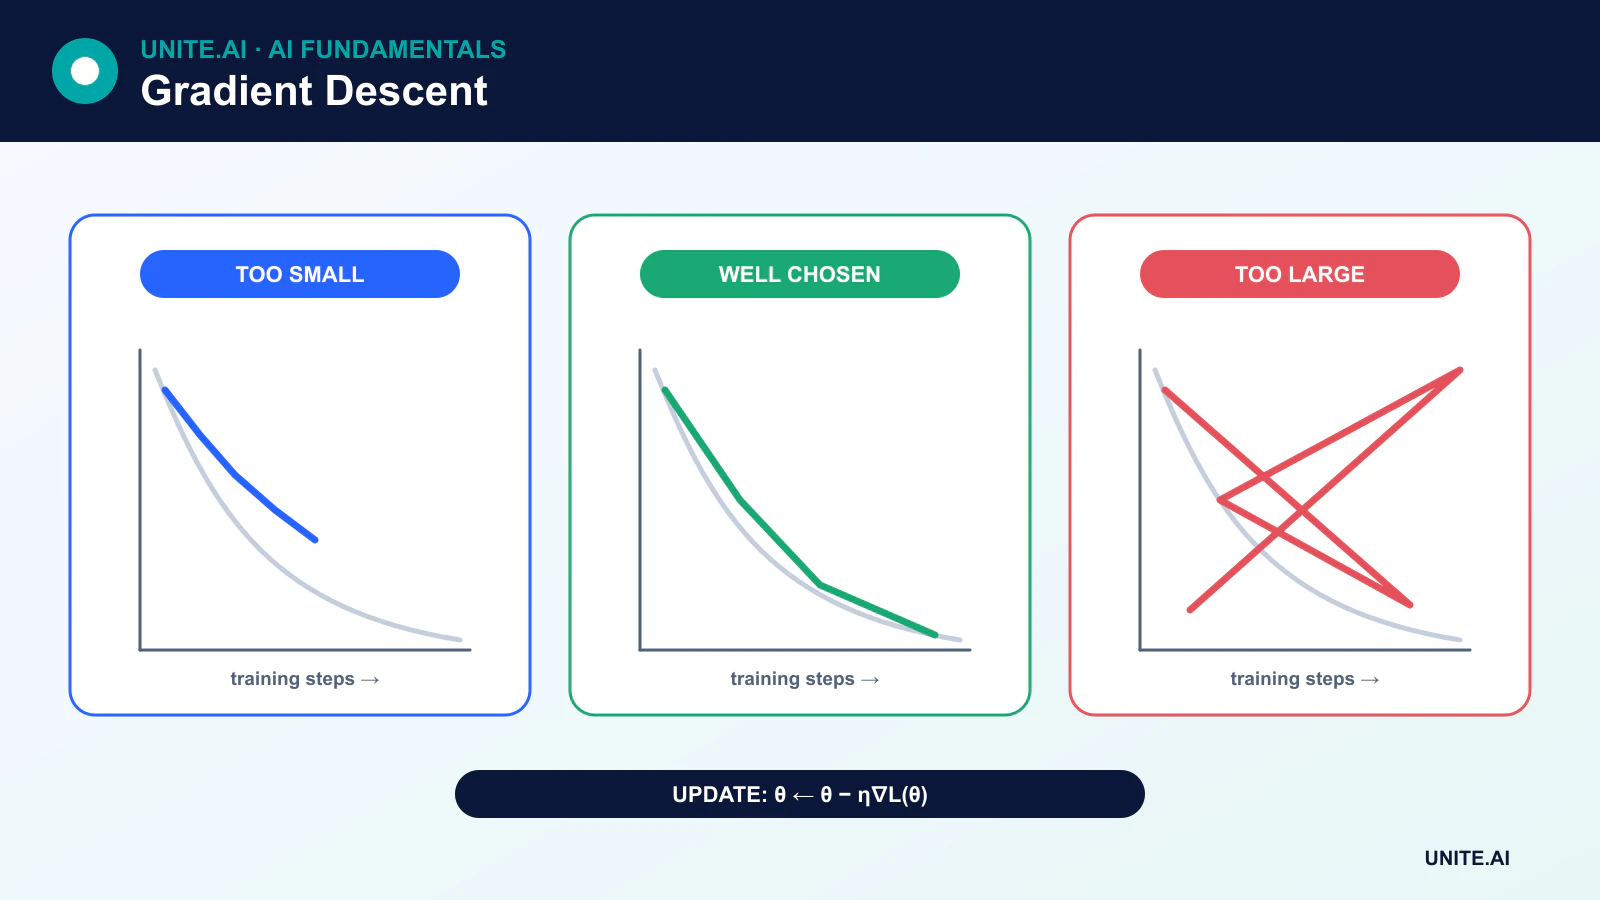
θ ← θ - η∇L(θ)
Le gradient ∇L(θ) contient une dérivée partielle par paramètre. Le soustraire fait descendre localement. Un point stationnaire a un gradient nul, mais il peut s’agir d’un minimum, d’un maximum, d’un point selle ou d’une région plate. Les surfaces de perte en deep learning sont non convexes, de sorte que l’entraînement n’est pas garanti de trouver un minimum global unique ou une perte nulle.
Méthodes batch, stochastique et mini-batch
Descente de gradient batch
La descente de gradient batch calcule un gradient en utilisant l’ensemble complet d’entraînement à chaque mise à jour. L’estimation est stable mais peut être coûteuse en temps et en mémoire, et une mise à jour peut sous‑exploiter les accélérateurs modernes.
Descente de gradient stochastique
La descente de gradient stochastique stricte utilise un exemple choisi aléatoirement par mise à jour. Ses gradients sont bruyants, ce qui peut favoriser l’exploration de la surface de perte, mais les opérations sur un seul exemple peuvent être inefficaces sur du matériel parallèle.
Descente de gradient mini-batch
L’entraînement mini-batch estime le gradient à partir d’un sous‑ensemble d’exemples. Il équilibre le bruit statistique avec des opérations matricielles efficaces et constitue l’approche habituelle en deep learning. La taille du batch influence la mémoire, le débit, le bruit du gradient, la normalisation et parfois la généralisation.
Choisir un taux d’apprentissage
Un taux trop élevé peut dépasser les régions utiles ou provoquer une divergence. Un taux trop faible peut rendre l’entraînement impraticablement lent ou le bloquer dans des régions plates. L’échelle optimale dépend de l’optimiseur, de la taille du batch, du modèle, de l’initialisation et de l’objectif.
Les plannings peuvent s’échauffer progressivement, décroître à des jalons, suivre une courbe cosinus ou réagir aux progrès de validation. Le taux n’a pas besoin de diminuer de façon monotone après chaque mise à jour. Les redémarrages chauds et les plannings cycliques augmentent délibérément le taux pendant certaines phases d’entraînement.
Momentum
Le momentum conserve une moyenne mobile exponentielle des gradients passés. Il peut accélérer le progrès le long de directions cohérentes et réduire les oscillations sur des directions raides et étroites. Le momentum de style Nesterov évalue ou approxime le gradient après avoir anticipé le long de la direction du momentum.
Optimiseurs adaptatifs
RMSProp ajuste les mises à jour en utilisant une moyenne mobile des gradients au carré. Adam combine des premiers moments de type momentum avec un redimensionnement basé sur le second moment. AdamW découple la décroissance de poids de la mise à jour adaptative du gradient et est largement utilisé pour les transformeurs.
Les optimiseurs adaptatifs facilitent souvent l’entraînement précoce, mais ils ne sont pas automatiquement supérieurs pour chaque modèle ou objectif de généralisation final. Les comparaisons d’optimiseurs nécessitent des plannings correspondants et un réglage minutieux.
Clipping et accumulation du gradient
Le clipping du gradient limite la norme ou les valeurs d’un gradient afin de réduire l’impact des gradients explosifs, notamment dans les entraînements récurrents ou instables. L’accumulation du gradient additionne les gradients sur plusieurs petits batches avant une mise à jour, approximant ainsi un batch effectif plus grand lorsque la mémoire est limitée.
Surveiller l’optimisation
Suivez la perte d’entraînement et de validation, les métriques de tâche, le taux d’apprentissage, les normes du gradient, les normes des paramètres et les erreurs numériques. Une perte d’entraînement qui diminue tandis que la performance de validation se détériore indique un surapprentissage, et non un succès d’optimisation qui devrait se poursuivre automatiquement.
L’optimisation minimise l’objectif qui lui est fourni. Une perte faible ne prouve pas que les données, la métrique ou le comportement réel sont appropriés. Des fuites, des étiquettes de mauvaise qualité et un objectif mal aligné peuvent produire un modèle bien optimisé mais préjudiciable.
Géométrie de l’optimisation et règles de mise à jour
La descente de gradient met à jour les paramètres dans la direction opposée au gradient d’une perte. La descente full‑batch utilise chaque exemple d’entraînement à chaque pas ; la descente stochastique en utilise un ; les méthodes mini‑batch estiment le gradient à partir d’un sous‑ensemble et dominent le deep learning. Le taux d’apprentissage fixe l’échelle du pas. Un taux trop petit gaspille le calcul ou bloque ; un taux trop grand provoque des oscillations ou une divergence. Le momentum accumule une direction mobile, tandis que les méthodes adaptatives comme Adam redimensionnent les coordonnées en utilisant les moments du gradient. Leurs biais implicites différents peuvent produire des modèles avec une perte d’entraînement similaire mais une généralisation différente.
Les surfaces de perte des réseaux neuronaux contiennent des régions plates et pointues, des selles, des symétries et des directions mal conditionnées. Le redimensionnement des caractéristiques, la normalisation, l’initialisation, les connexions résiduelles et le préconditionnement modifient la géométrie perçue par l’optimiseur. Les plannings peuvent s’échauffer, décroître, cycler ou réagir aux plateaux. La décroissance de poids est distincte de l’ajout d’une pénalité L2 dans certains optimiseurs adaptatifs. La taille du batch influence le bruit, la mémoire, le parallélisme et le régime du taux d’apprentissage, de sorte que les comparaisons d’optimiseurs nécessitent des budgets d’entraînement correspondants et un réglage minutieux.
Diagnostic, reproductibilité et arrêt
Suivez la perte d’entraînement et de validation, les métriques de tâche, les normes du gradient et des paramètres, le taux d’apprentissage, le débit et les avertissements numériques. La divergence peut provenir de batches corrompus, d’étiquettes invalides, d’une précision mixte instable ou d’une réduction de perte incorrecte. Les plateaux peuvent indiquer une capacité insuffisante, des activations saturées, des caractéristiques médiocres, une régularisation excessive ou un problème de planning. Le surapprentissage nécessite des données, de l’augmentation, de la régularisation ou un arrêt précoce — et non une affirmation que l’optimiseur a échoué. Inspectez les erreurs représentatives et comparez une ligne de base simple avant d’augmenter la complexité de l’entraînement.
La reproductibilité nécessite des graines, l’ordre des données, le code, la configuration, les versions du matériel et des bibliothèques, bien que certains noyaux d’accélérateur restent non déterministes. Enregistrez des points de contrôle avec l’état de l’optimiseur et du planning afin que l’entraînement puisse reprendre de façon cohérente. Sélectionnez un point de contrôle selon des critères de validation fixés à l’avance et réservez un jeu de test intact. Dans l’entraînement distribué, confirmez la taille de batch effective, la moyenne des gradients et la gestion des travailleurs défaillants. L’optimisation minimise l’objectif choisi sur les données disponibles ; elle ne garantit pas des probabilités calibrées, un raisonnement causal, l’équité, la sécurité ou l’utilité dans le monde réel.
Exemple pratique : réglage d’un optimiseur pour un modèle de langage
Une équipe fixe le tokenizer, l’ordre des données, le modèle, le batch effectif et le budget de tokens d’entraînement, puis compare SGD avec momentum et AdamW selon des plannings de taux d’apprentissage défendables. L’échauffement, la décroissance, la décroissance de poids, le clipping et la précision sont enregistrés. Chaque candidat exécute plusieurs graines, et la validation utilise une tranche temporelle réservée ainsi que des évaluations de tâche. Le débit et la consommation d’énergie sont rapportés avec la perte afin qu’un optimiseur légèrement meilleur ne soit pas choisi à un coût disproportionné.
Les diagnostics révèlent si l’instabilité provient d’un fragment de données, d’une taille de pas excessive, d’un sous‑flux ou de l’architecture du modèle. Les points de contrôle conservent l’état de l’optimiseur et du planning et sont repris dans un test. Le choix final repose sur la qualité et la robustesse de la validation, et non sur la perte d’entraînement la plus basse. Un jeu de test scellé est exécuté une fois après la sélection. L’inférence en production est calibrée et surveillée séparément, car le succès de l’optimiseur pendant le pré‑entraînement n’établit pas un comportement sûr ou véridique.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant le réglage. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Consignez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, les procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
La descente de gradient atteint‑elle toujours le minimum global ?
Non. Pour des objectifs convexes, des conditions appropriées offrent de fortes garanties. Les objectifs des réseaux profonds sont non convexes, et les optimiseurs pratiques cherchent généralement une solution utile plutôt que de prouver qu’ils ont trouvé le minimum global unique.
Pourquoi un gradient nul peut‑il être trompeur ?
Un gradient nul ou très petit peut indiquer un minimum, un maximum, un point selle, une saturation ou un plateau plat. Les diagnostics d’entraînement doivent prendre en compte l’historique de la perte, la courbure, l’échelle des paramètres et la performance de validation.
Références principales