Fondamentaux de l’IA
Que sont les agents capables d’utiliser un ordinateur ? Comment l’IA voit, clique, saisit du texte et navigue dans les logiciels
Les agents capables d’utiliser un ordinateur interagissent avec les logiciels au moyen d’écrans, de curseurs et de claviers, un peu comme les humains. Cette polyvalence est puissante, mais l’incertitude visuelle, la longueur des tâches et l’étendue des autorisations rendent indispensables des contrôles rigoureux.

 Ajouter Unite.AI à vos sources préférées sur Google

Les agents capables d’utiliser un ordinateur sont des systèmes d’IA qui peuvent percevoir une interface logicielle et interagir avec elle en cliquant, en saisissant du texte, en faisant défiler la page, en faisant glisser des éléments ou en utilisant des raccourcis clavier. Au lieu d’exiger une API dédiée pour chaque application, ils utilisent bon nombre des mêmes interfaces visuelles que les personnes.
Cette capacité permet aux agents d’interagir avec un large éventail de logiciels anciens, de sites web et d’applications de bureau. Elle introduit aussi des risques inhabituels. Une légère erreur d’interprétation visuelle peut dévier une tâche de longue haleine, et l’accès à l’interface peut exposer tout ce que l’utilisateur connecté peut voir ou modifier.
Pourquoi l’interaction avec un ordinateur est importante
Une grande partie des logiciels importants dans le monde a été conçue pour les personnes, et non pour les agents. Une application peut ne disposer d’aucune API publique, n’exposer qu’une partie de ses fonctionnalités par programmation ou nécessiter des opérations sur plusieurs interfaces.
L’automatisation robotisée des processus traditionnelle peut manipuler les interfaces utilisateur, mais elle repose généralement sur des sélecteurs et des flux de travail prédéfinis. Un agent capable d’utiliser un ordinateur s’appuie en plus sur un modèle qui peut interpréter des écrans inconnus, déterminer l’étape nécessaire et s’adapter aux changements d’interface ou à l’apparition d’une boîte de dialogue inattendue.
L’interaction avec un ordinateur devient ainsi un outil polyvalent. La même boucle de perception et d’action peut potentiellement servir à naviguer dans un tableur, un système de gestion de la relation client, une application de conception, un navigateur ou un portail interne.
Fonctionnement d’un agent capable d’utiliser un ordinateur
L’ancrage est l’étape intermédiaire difficile. L’agent doit relier une consigne conceptuelle, comme « ouvrir la dernière facture », à une ligne ou à un élément de commande précis visible à l’écran. Les libellés textuels et les métadonnées d’accessibilité peuvent aider, mais les mises en page dynamiques, les interfaces reposant sur des canevas, les éléments qui se chevauchent et les icônes ambiguës peuvent obliger le modèle à raisonner à partir des pixels.
La boucle de base ressemble à la façon dont une personne interagit avec un logiciel.
- Observer : capturer une capture d’écran, l’arborescence d’accessibilité, la structure du document, la position du curseur et d’autres informations sur l’état de l’environnement.
- Interpréter : repérer les éléments de commande visibles, le contenu, les avertissements et le lien entre l’écran actuel et la tâche.
- Choisir une action : décider de cliquer, de saisir du texte, de faire défiler la page, d’appuyer sur une touche, d’attendre ou de demander de l’aide.
- Exécuter : l’environnement d’exécution effectue l’action au moyen d’une interface de système d’exploitation, de navigateur ou de machine virtuelle.
- Vérifier : capturer l’écran après le changement et déterminer si l’action a produit l’effet attendu.
- Répéter ou s’arrêter : poursuivre vers l’objectif, corriger une erreur ou faire une pause à une limite protégée.
La description par OpenAI d’un agent capable d’utiliser un ordinateur présente cette capacité comme une combinaison de perception visuelle, de raisonnement et d’actions à la souris et au clavier. L’essentiel ne réside pas dans la prédiction d’un clic isolé, mais dans la boucle fermée qui relie la perception, l’action et l’observation d’un nouvel état.
Ce que l’agent peut « voir »
Les systèmes capables d’utiliser un ordinateur peuvent recevoir différentes représentations d’une interface.
Les captures d’écran offrent une vue générale au niveau des pixels et fonctionnent même en l’absence de métadonnées structurées sur l’interface. Elles peuvent représenter des graphiques, des images, des applications reposant sur des canevas et la disposition visuelle des éléments. Toutefois, les petites cibles, les états masqués et les icônes ambiguës peuvent être difficiles à interpréter.
Les arborescences d’accessibilité ou la structure du document présentent les éléments de commande et le texte sous une forme plus structurée. Elles peuvent permettre une sélection plus précise des éléments, mais risquent d’omettre des informations visuelles ou de se comporter de manière incohérente d’une application à l’autre.
Les systèmes hybrides combinent les pixels, les éléments structurés, l’état de l’application et, parfois, des API directes. Cette approche est souvent plus efficace que de traiter chaque problème comme un simple exercice d’imitation visuelle.
Interaction avec un ordinateur ou automatisation du navigateur
L’automatisation classique du navigateur s’appuie sur du code et des sélecteurs stables pour exécuter une séquence connue. Elle est rapide et prévisible lorsque la structure de la page est maîtrisée. Un agent capable d’utiliser un ordinateur interprète l’interface de manière dynamique et peut décider de la séquence à suivre.
Ces approches sont complémentaires. Un système robuste peut laisser l’agent décider des opérations à effectuer, puis exécuter les opérations bien connues au moyen d’une automatisation déterministe ou d’API. L’interaction au niveau des pixels est particulièrement utile lorsqu’aucune interface structurée n’est disponible ou que le parcours ne peut pas être défini à l’avance.
Utilisation de l’ordinateur, API et appels d’outils
| Perception | Transforme les pixels et les données d’accessibilité en éléments d’interface potentiels. |
|---|---|
| Ancrage | Associe l’action prévue à un élément visible précis. |
| Exécution | Déclenche une action à la souris, au clavier, par écran tactile ou via les fonctions d’accessibilité. |
| Vérification | Lit l’état suivant au lieu de présumer que l’action a réussi. |
Cette approche hybride réduit à la fois les erreurs et les coûts. L’agent peut récupérer des données via une API, ouvrir une application de bureau uniquement pour remplir un formulaire hérité, puis vérifier l’enregistrement final au moyen d’une autre requête structurée. Considérer le contrôle visuel comme un outil parmi d’autres évite de faire passer chaque étape par l’interface la moins fiable.
Une API fournit une interface destinée aux machines, avec des opérations et des types de données explicites. Elle est généralement plus rapide, plus précise et plus facile à valider que la navigation par clics à l’écran. L’utilisation de l’ordinateur offre une compatibilité plus large, au prix d’une plus grande ambiguïté.
Par exemple, un agent peut interroger les stocks via une API, mais utiliser le portail Web du fournisseur pour gérer une exception que l’API ne prend pas en charge. Les appels d’outils peuvent rendre ces deux capacités accessibles au modèle, tandis que l’environnement d’exécution privilégie la voie la plus fiable.
Cas d’utilisation courants
- Opérations administratives : transfert de données entre des portails, traitement de formulaires courants et préparation de dossiers pour approbation.
- Recherche : navigation sur des sites Web, filtrage des résultats, collecte de preuves et mise à jour d’un document de travail.
- Tests logiciels : suivi des parcours utilisateurs, consignation des défaillances et vérification des changements visuels.
- Assistance informatique : inspection des paramètres, collecte de données de diagnostic et accompagnement dans l’application de correctifs approuvés ou exécution de ceux-ci.
- Productivité personnelle : coordination des fichiers, des applications Web, des calendriers et des documents.
- Accessibilité : aide aux utilisateurs pour utiliser des interfaces autrement difficiles à parcourir, sous réserve de contrôles stricts en matière de confidentialité.
Pourquoi les tâches informatiques restent difficiles
Les interfaces utilisateur comportent des menus dynamiques, des chargements différés, des fenêtres contextuelles, des zones de défilement, de petites cibles et des états qui se ressemblent, mais entraînent des conséquences différentes. Une tâche peut nécessiter des dizaines d’étapes correctes ; même un taux d’erreur modéré par étape finit donc par s’accumuler.
Des bancs d’essai tels que OSWorld évaluent les agents dans des environnements informatiques réels plutôt qu’au moyen de clics isolés. OSWorld 2.0 étend cette approche à des flux de travail plus longs, avec des changements d’état et davantage de variété. Le chapitre sur les performances techniques de l’AI Index 2026 de Stanford fait état de progrès rapides, tout en montrant qu’un écart subsiste par rapport aux performances humaines sur OSWorld, ce qui souligne que des démonstrations impressionnantes ne garantissent pas une fiabilité universelle.
Principaux modes de défaillance
- Erreurs d’ancrage visuel : cliquer sur un élément de commande voisin ou ressemblant à celui visé.
- Confusion sur l’état : croire qu’une page s’est chargée, qu’une sauvegarde a réussi ou que la fenêtre active a changé alors que ce n’est pas le cas.
- Dérive au fil d’un processus long : perdre de vue l’objectif de la tâche après de nombreuses petites actions.
- Effets secondaires cachés : envoyer un formulaire ou effectuer un achat alors que l’agent voulait seulement en afficher un aperçu.
- Injection de prompt : suivre des instructions malveillantes intégrées à une page Web, à un document ou à un message.
- Exposition des identifiants : révéler ou utiliser à mauvais escient des informations accessibles dans une session ouverte.
- Erreurs irréversibles : supprimer, publier, envoyer ou acheter sans vérification suffisante.
Principes de sécurité et de contrôle
Le contenu d’une interface n’est pas fiable. Une page Web, un courriel ou un document peut contenir des instructions destinées à détourner l’agent, et une boîte de dialogue malveillante peut imiter une demande de confirmation familière. Le système doit isoler le contenu de la page des règles de fonctionnement, limiter les destinations et les identifiants, et s’interrompre lorsqu’une demande d’autorisation inattendue ou une confirmation lourde de conséquences apparaît.
L’utilisation d’un ordinateur doit se faire dans l’environnement le plus restreint permettant d’accomplir la tâche. Un profil de navigateur dédié, une machine virtuelle ou un bac à sable limite l’accès aux comptes et aux fichiers sans rapport avec la tâche. Les sessions doivent utiliser des identifiants propres à la tâche et des autorisations minimales, plutôt que d’hériter de l’ensemble des droits de l’utilisateur sur son ordinateur.
Les actions à fort impact nécessitent un point de confirmation clairement défini. Le système doit s’interrompre juste avant d’envoyer, de transmettre, d’acheter, de supprimer, de publier ou de modifier des paramètres sensibles, et présenter à l’utilisateur la cible exacte et les conséquences de l’action.
Les agents doivent également considérer le contenu affiché à l’écran comme une donnée non fiable. Les instructions figurant sur une page Web ne doivent pas prendre le pas sur les règles du système ni sur la tâche de l’utilisateur. Les téléchargements, les commandes copiées et les communications externes nécessitent une validation distincte.
Comment évaluer un agent capable d’utiliser un ordinateur
La réussite d’une tâche est nécessaire, mais ne suffit pas. Les équipes doivent mesurer la précision à chaque étape, la capacité à se rétablir face à des états inattendus, les actions superflues, la durée, le coût, l’exposition de données sensibles, le respect des approbations et la cohérence des résultats d’une exécution à l’autre.
Les environnements d’évaluation doivent varier la résolution de l’écran, la mise en page, les données, le moment d’exécution et l’état de l’application. Sans cela, un agent peut se suradapter à un banc d’essai scénarisé et échouer face aux variations rencontrées dans les logiciels du quotidien.
Comment lire les schémas sur l’utilisation d’un ordinateur
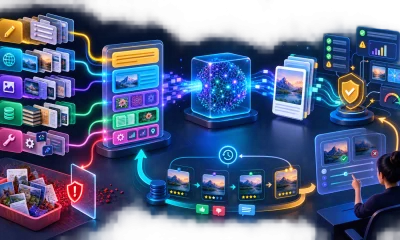
Suivez les schémas sur l’utilisation d’un ordinateur depuis l’entrée numérotée jusqu’au résultat observable. La comparaison met en évidence la frontière qui distingue l’utilisation d’un ordinateur de son raccourci le plus proche, tandis que le parcours de contrôle indique où vérifier l’autorité ou l’incertitude avant qu’une conséquence réelle ne se produise. Les libellés restent du texte ordinaire de la page, qui s’adapte à l’écran : ils peuvent donc être traduits, passer à la ligne et se redistribuer sur un téléphone.
Pour « Que sont les agents capables d’utiliser un ordinateur ? Comment l’IA voit, clique, tape et navigue dans les logiciels », le visuel constitue une carte, et non une garantie. Une mise en œuvre réelle peut combiner des étapes, répéter une étape ou prévoir un point d’approbation humaine. L’essentiel est de savoir si l’équipe peut repérer les mêmes fonctions dans le système déployé, désigner un responsable pour chaque point de contrôle et tester la transition entre ces points. Si une étape ne peut être observée ni mesurée, il sera difficile d’y diagnostiquer les défaillances.
À retenir sur les agents capables d’utiliser un ordinateur
Les agents capables d’utiliser un ordinateur peuvent se servir de l’interface logicielle conçue pour les humains comme d’un outil polyvalent. Ils peuvent accéder à des systèmes dépourvus d’API adaptées et s’adapter à des tâches que l’automatisation fixe ne peut pas facilement anticiper.
Cette polyvalence s’accompagne d’ambiguïté et d’un vaste potentiel d’impact. Les conceptions les plus robustes privilégient les API structurées lorsqu’elles sont disponibles, isolent l’environnement informatique, vérifient chaque changement d’état et laissent aux personnes le contrôle des actions lourdes de conséquences.