Angle d’Anderson
Le détourage d’images par IA qui comprend les scènes

 Ajouter Unite.AI à vos sources préférées sur Google
Points clésLe matting par IA utilise désormais la compréhension de scène pour remplacer les fonds…
Voir plus
- Le matting par IA utilise désormais la compréhension de scène pour remplacer les fonds verts.
- Le nouveau pipeline SPG-IM surpasse largement les méthodes sans trimap.
- Les étiquettes textuelles offrent une alternative à faible coût à l'annotation pixel coûteuse.
Dans le documentaire bonus accompagnant la sortie DVD de 2003 d’Alien3 (1992), Richard Edlund, légende des effets visuels, se remémorait avec horreur la « lutte sumo » que représentait l’extraction photochimique des caches, dominante dans les effets visuels entre la fin des années 1930 et la fin des années 1980. Edlund décrivait le caractère aléatoire du procédé comme une « lutte sumo », par comparaison avec les techniques numériques sur fond bleu ou vert qui ont pris le relais au début des années 1990 (et il est revenu depuis sur cette métaphore).
Pour isoler un élément de premier plan (comme une personne ou une maquette de vaisseau spatial) de l’arrière-plan, afin de pouvoir intégrer l’image détourée à un décor, on filmait à l’origine l’objet au premier plan devant un fond uni bleu ou vert.
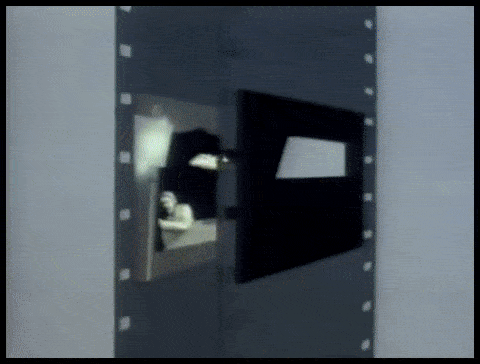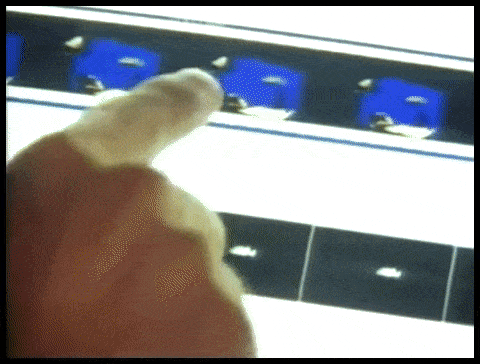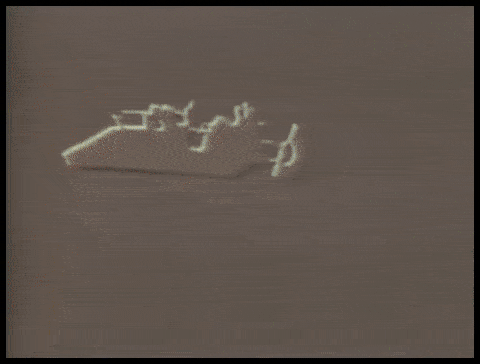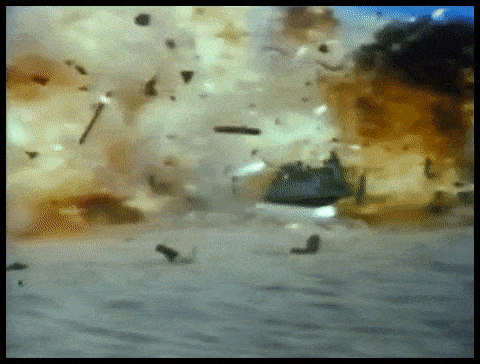
Des procédés d’extraction photochimique laborieux pour un plan à effets visuels réalisé par ILM pour « Le Retour du Jedi » (1983).
Dans les images obtenues, la couleur de fond était ensuite isolée chimiquement et utilisée comme modèle pour réimprimer l’objet (ou la personne) au premier plan sur une imprimante optique, sous la forme d’un élément « flottant » sur une pellicule par ailleurs transparente.
Le procédé était connu sous le nom de superposition par séparation des couleurs (CSO), mais ce terme a fini par être davantage associé aux effets vidéo rudimentaires d’incrustation chromatique des émissions télévisées à petit budget des années 1970 et 1980, réalisés par des moyens analogiques plutôt que chimiques ou numériques.

Une démonstration de la superposition par séparation des couleurs en 1970, pour l’émission britannique pour enfants « Blue Peter ». Source : https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Dans tous les cas, qu’il s’agisse d’éléments filmés ou vidéo, les images extraites pouvaient ensuite être insérées dans n’importe quelles autres images.
Bien que le procédé propriétaire de séparation par vapeur de sodium de Disney, nettement plus coûteux (qui isolait spécifiquement le jaune et a également été utilisé pour le film d’horreur d’Alfred Hitchcock de 1963, Les Oiseaux), produisît des contours plus précis et des caches plus nets, l’extraction photochimique restait fastidieuse et peu fiable.

Le procédé propriétaire d’extraction par vapeur de sodium de Disney nécessitait des fonds proches de l’extrémité jaune du spectre. Ici, Angela Lansbury est suspendue à des câbles pendant le tournage d’une séquence riche en effets visuels pour « L’Apprentie sorcière » (1971). Source
Au-delà du détourage numérique
Dans les années 1990, la révolution numérique a supprimé le recours aux produits chimiques, mais pas le besoin de fonds verts. Il était désormais possible de supprimer le fond vert (ou de toute autre couleur) en recherchant simplement les pixels dont la couleur se situait dans une certaine plage de tolérance, à l’aide de logiciels de retouche d’image comme Photoshop et d’une nouvelle génération de logiciels de composition vidéo capables de supprimer automatiquement les fonds colorés par incrustation. Presque du jour au lendemain, soixante ans d’industrie de l’impression optique ont été relégués aux oubliettes.
Les dix dernières années de recherche en vision par ordinateur accélérée par GPU ouvrent une troisième ère pour l’extraction des caches, en chargeant les chercheurs de mettre au point des systèmes capables de produire des caches de haute qualité sans avoir besoin de fonds verts. Sur arXiv à lui seul, des articles consacrés aux avancées de l’extraction du premier plan par apprentissage automatique paraissent chaque semaine.
Nous mettre en scène
Cet intérêt des milieux universitaires et industriels pour le détourage par IA a déjà eu des répercussions auprès des consommateurs : nous connaissons tous les solutions rudimentaires mais fonctionnelles que proposent les filtres de Zoom et de Skype, capables de remplacer le décor de notre salon par des îles tropicales, entre autres, lors des visioconférences.
Cependant, les détourages les plus réussis nécessitent encore un fond vert, comme l’a indiqué Zoom mercredi dernier.

À gauche, un homme devant un fond vert, dont les cheveux sont bien détourés grâce à la fonction Arrière-plan virtuel de Zoom. À droite, une femme devant un décor domestique ordinaire, dont les cheveux sont détourés par un algorithme, avec moins de précision et des besoins de calcul plus importants. Source : https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Un autre article de la plateforme d’assistance de Zoom avertit que le détourage sans fond vert exige également davantage de puissance de calcul sur l’appareil de capture.
La nécessité de détourer
Les progrès en matière de qualité, de portabilité et d’économie de ressources des systèmes d’extraction de masques « en conditions réelles » (c’est-à-dire capables d’isoler des personnes sans écran vert) concernent bien davantage de secteurs et d’activités que les seuls filtres de visioconférence.
Pour le développement de jeux de données, une meilleure reconnaissance des visages, des têtes entières et des corps entiers permettrait d’éviter que des éléments d’arrière-plan superflus soient intégrés à l’entraînement des modèles de vision par ordinateur représentant des sujets humains. Une isolation plus précise améliorerait considérablement les techniques de segmentation sémantique conçues pour distinguer et assimiler des domaines (c’est-à-dire « chat », « personne », « bateau »), ainsi que les systèmes de synthèse d’images basés sur des VAE et des transformeurs, comme le nouveau DALL-E 2 d’OpenAI ; de meilleurs algorithmes d’extraction réduiraient également le recours au rotoscoping manuel coûteux dans les pipelines d’effets visuels onéreux.
De fait, l’essor des méthodes multimodales (généralement texte/image), dans lesquelles un domaine tel que « chat » est encodé à la fois sous forme d’image et au moyen de références textuelles associées, commence déjà à transformer le traitement d’images. L’architecture Text2Live en est un exemple récent : elle utilise un entraînement multimodal (texte/image) pour créer des vidéos représentant, parmi une myriade d’autres possibilités, des cygnes de cristal et des girafes de verre.
Détourage par IA tenant compte de la scène
Une grande partie des recherches sur le détourage automatique par IA s’est concentrée sur la reconnaissance des contours et l’évaluation des regroupements de pixels dans une image ou une trame vidéo. De nouvelles recherches menées en Chine proposent toutefois un pipeline d’extraction qui améliore la délimitation et la qualité du masque en s’appuyant sur des descriptions textuelles de la scène (une approche multimodale qui a gagné du terrain dans le secteur de la recherche en vision par ordinateur au cours des 3 à 4 dernières années) ; les chercheurs affirment que leur méthode améliore de plusieurs façons les méthodes antérieures.

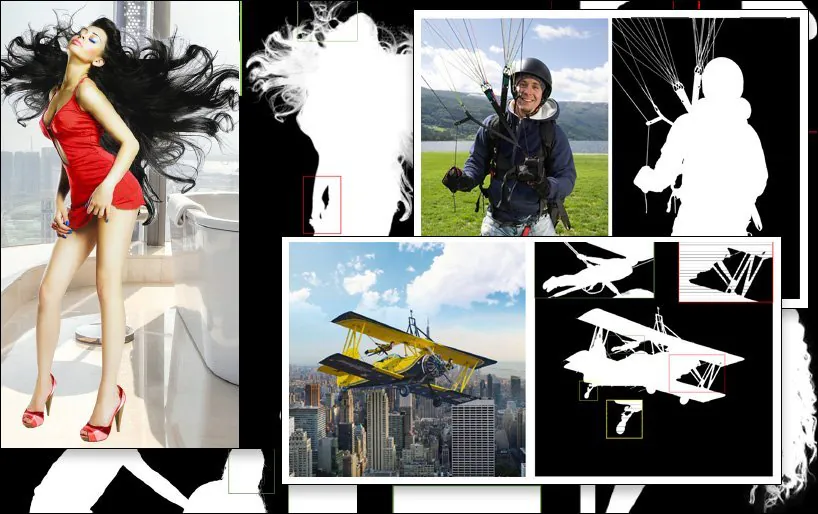
Exemple d’extraction avec SPG-IM (dernière image, en bas à droite), comparée à des méthodes antérieures concurrentes. Source : https://arxiv.org/pdf/2204.09276.pdf
Le défi auquel est confronté le sous-secteur de la recherche sur l’extraction consiste à concevoir des processus qui nécessitent un minimum absolu d’annotations manuelles et d’intervention humaine — idéalement, aucune. Outre les coûts que cela implique, les chercheurs à l’origine de la nouvelle étude observent que les annotations et les segmentations manuelles réalisées par des travailleurs participatifs sous-traitants issus de cultures diverses peuvent conduire à étiqueter, voire à segmenter, les images de différentes manières, ce qui donne lieu à des algorithmes incohérents et insatisfaisants.
Un exemple en est l’interprétation subjective de ce qui définit un « objet de premier plan » :

Extrait de la nouvelle étude : les méthodes antérieures LFM et MODNet (« GT » signifie Ground Truth, un résultat « idéal » souvent obtenu manuellement ou par des méthodes non algorithmiques) proposent des interprétations différentes, d’efficacité variable, de la définition du contenu de premier plan, tandis que la nouvelle méthode SPG-IM délimite plus efficacement le « contenu proche » en s’appuyant sur le contexte de la scène.
Pour répondre à ce problème, les chercheurs ont mis au point un pipeline en deux étapes intitulé Situational Perception Guided Image Matting (SPG-IM). Cette architecture encodeur-décodeur en deux étapes comprend Situational Perception Distillation (SPD) et Situational Perception Guided Matting (SPGM).

L’architecture SPG-IM.
Tout d’abord, SPD préentraîne les transformations de caractéristiques visuelles en représentations textuelles et génère des légendes adaptées aux images correspondantes. Ensuite, la prédiction du masque de premier plan est rendue possible en connectant le pipeline à une nouvelle technique de prédiction de saillance.
SPGM produit ensuite un masque alpha estimé à partir de l’image d’entrée RVB brute et du masque généré dans le premier module.
L’objectif est de guider le système par la perception situationnelle : celui-ci comprend le contexte et le contenu de l’image, ce qui lui permet, par exemple, d’aborder le défi que représente l’extraction de cheveux complexes sur un arrière-plan en tenant compte des caractéristiques propres à cette tâche.

Dans l’exemple ci-dessous, SPG-IM comprend que les cordes font partie intégrante d’un « parachute », tandis que MODNet ne parvient pas à conserver ni à définir ces détails. De même, dans l’exemple ci-dessus, MODNet fait disparaître arbitrairement toute la structure de l’équipement de jeu.
Le nouvel article s’intitule Détourage d’images guidé par la perception situationnelle et est signé par des chercheurs de l’OPPO Research Institute, de PicUp.ai et de Xmotors.
Des masques intelligents automatisés
SPG-IM propose également un réseau de raffinement Adaptive Focal Transformation (AFT), capable de traiter séparément les détails locaux et le contexte global, facilitant ainsi la création de « masques intelligents ».

Comprendre le contexte de la scène, ici une « fille avec un cheval », peut faciliter l’extraction du premier plan par rapport aux méthodes antérieures.
L’article indique :
« Nous pensons que les représentations visuelles issues de tâches de conversion du visuel en texte, par exemple la génération de légendes d’images, privilégient des signaux sémantiquement plus riches entre a) un objet et un autre objet, et b) un objet et son environnement, afin de générer des descriptions qui couvrent à la fois les informations globales et les détails locaux. De plus, contrairement à l’annotation coûteuse des pixels pour le détourage d’images, les étiquettes textuelles peuvent être recueillies en grande quantité à très faible coût. »
La branche SPD de l’architecture est préentraînée conjointement avec le décodeur textuel fondé sur les transformeurs VirTex de l’Université du Michigan, qui apprend des représentations visuelles à partir de légendes sémantiquement denses.

VirTex entraîne conjointement un ConvNet et des transformeurs à partir de paires image-légende, puis transfère les connaissances acquises à des tâches de vision en aval, comme la détection d’objets. Source : https://arxiv.org/pdf/2006.06666.pdf
Parmi d’autres tests et études d’ablation, les chercheurs ont évalué SPG-IM par rapport aux méthodes de pointe fondées sur des trimaps : Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA et Semantic Image Matting (SIM).
Parmi les autres architectures antérieures évaluées figuraient les approches sans trimap LFM, HAttMatting et MODNet. Pour assurer une comparaison équitable, les méthodes de test ont été adaptées en fonction des différences entre les méthodologies ; lorsque le code n’était pas disponible, les techniques décrites dans l’article ont été reproduites à partir de l’architecture présentée.
Le nouvel article indique :
« SPG-IM surpasse largement toutes les méthodes concurrentes sans trimap ([LFM], [HAttMatting] et [MODNet]). Par ailleurs, notre modèle affiche également une supériorité remarquable sur les méthodes de pointe (SOTA) fondées sur un trimap et guidées par masque, selon les quatre métriques, sur les jeux de données publics (Composition-1K, Distinction-646 et Human-2K) ainsi que sur notre référence Multi-Object-1K. »
L’article poursuit :
« On constate clairement que notre méthode préserve les détails fins (par exemple, les pointes des cheveux, les textures transparentes et les contours) sans être guidée par un trimap. De plus, par rapport aux autres modèles concurrents sans trimap, SPG-IM préserve mieux la complétude sémantique globale. »


Première publication le 24 avril 2022.