
Mielipide
Jev ja uusi päätöskerros AI-agenteille

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatAgentit tuhlaavat kallista generatiivista päättelyä kapeisiin arviointeihin, joista…
Näytä lisää
- Agentit tuhlaavat kallista generatiivista päättelyä kapeisiin arviointeihin, joista rajalliset päätösmallit suoriutuvat paremmin.
- Nopean arvioinnin erottaminen hitaasta päättelystä luo päätöskerroksen, jossa ohjelmisto soveltaa käytäntöä.
- Tyyppiturvalliset tulosteet estävät virheelliset vastaukset, mutta eivät voi taata, että arviointi on oikein.
Miksi System One -mallit voivat erottaa nopean päätöksenteon hitaasta päättelystä
Useat AI-agentit käyttävät kielimallia lähes kaikissa päätöksissään. Kielimalli valitsee työkalun, arvioi tulokset, päättää, pitääkö sen jatkaa, ja lopuksi tuottaa vastaukset. Joustava; kuitenkin tämä prosessi voi olla kallis, kun kyllä–ei -päätöksiä toistetaan suuressa mittakaavassa. Unite.AI on aiemmin käsitellyt, miten agenttipohjaiset työnkulut lisäävät mallikutsuja, kontekstia ja uudelleenyrittämisiä. Jokainen lisäpäätös voi lisätä aikaa ja rahaa ennen kuin käyttäjille tarjotaan hyödyllistä tietoa.
Jev ehdottaa tehtävän jakamista eri tavalla. Käytä mallia, joka on rakennettu rajoitettuihin päätöksiin, joissa vastausjoukko on määritelty. Käytä generatiivista mallia avoimeen päättelyyn ja kieleen. Jev ehdottaa, että tärkein ajatus tässä ei ole, että kaikkien agenttien täytyy ostaa yksi uusi tuote. Keskeinen käsite on, että agentti ei tarvitse samaa älykkyyden tasoa kaikissa tilanteissa.
Mitä Jev todellisuudessa tekee
TypeSafe lanseerasi Jevin syyskuussa 2026, ensimmäisen uusista System One -malleistaan. Jev ei kirjoita proosaa. Sen sijaan lähetät sille tilan (kuten tukiviestin ja käyttäjätiedot). Lähetät myös yhden tai useamman kysymyksen, joilla on ennalta määritellyt vastaustyypit. Sitten Jev palauttaa tyypitetyt vastaukset ja todennäköisyydet.
Yrityksen virallisen dokumentaation mukaan on kolme perusmenetelmää päätösten tekemiseen:
- Choice antaa sinun valita ennalta määritellyistä vaihtoehdoista.
- Score antaa sinun arvioida jotain järjestetyn arviointiasteikon perusteella.
- Noul arvioi todennäköisyyden, että väite on tosi.
Voit esittää useita itsenäisiä kysymyksiä samasta tilasta yhdessä pyynnössä.
Esimerkiksi oletetaan, että käsittelet asiakaspalvelutapausta. Järjestelmä saattaa selvittää, minkä tiimin pitäisi hoitaa tämä tapaus. Se voi myös määrittää, kuinka nopeasti jonkun täytyy vastata, ja tarkistaa, onko asiakas pyytänyt hyvitystä.
Keskustelumalli voisi mahdollisesti suorittaa kaikki kolme tehtävää. Kuitenkin sen täytyy toimittaa tulokset takaisin sovellukseesi strukturoituna vastauksena. Sen sijaan Jev tarjoaa vain ne rajoitetut päätökset. Sovelluksesi päättäisi sitten, mitä toimenpidettä seuraavaksi toteutetaan näiden päätösten perusteella.
Arkkitehtoninen muutos on tärkeämpi kuin malli
Useimmissa näistä keskusteluista vertaillaan suuria malleja pieniin. Jev ehdottaa vaihtoehtoista rajaa. Jotkut vaiheet sisältävät kielen generointia. Toiset ovat kapeita päätöksiä, joita ohjelmisto voi hyödyntää.
Tämä luo päätöskerroksen agenttiin. Malli tekee arvion. Ohjelmisto soveltaa käytäntöä. Jos arvioitu todennäköisyys ylittää testatun rajan ja toiminto on vähäriskinen ja peruutettavissa, työnkulku voi jatkua. Jos tuloksissa on epävarmuutta tai toiminnolla voi olla vakavia seurauksia, järjestelmä voi pyytää ihmisen valvontaa. Päättelymalli voi auttaa tutkimaan epävarmuutta, mutta se ei korvaa vaadittua ihmisen hyväksyntää.
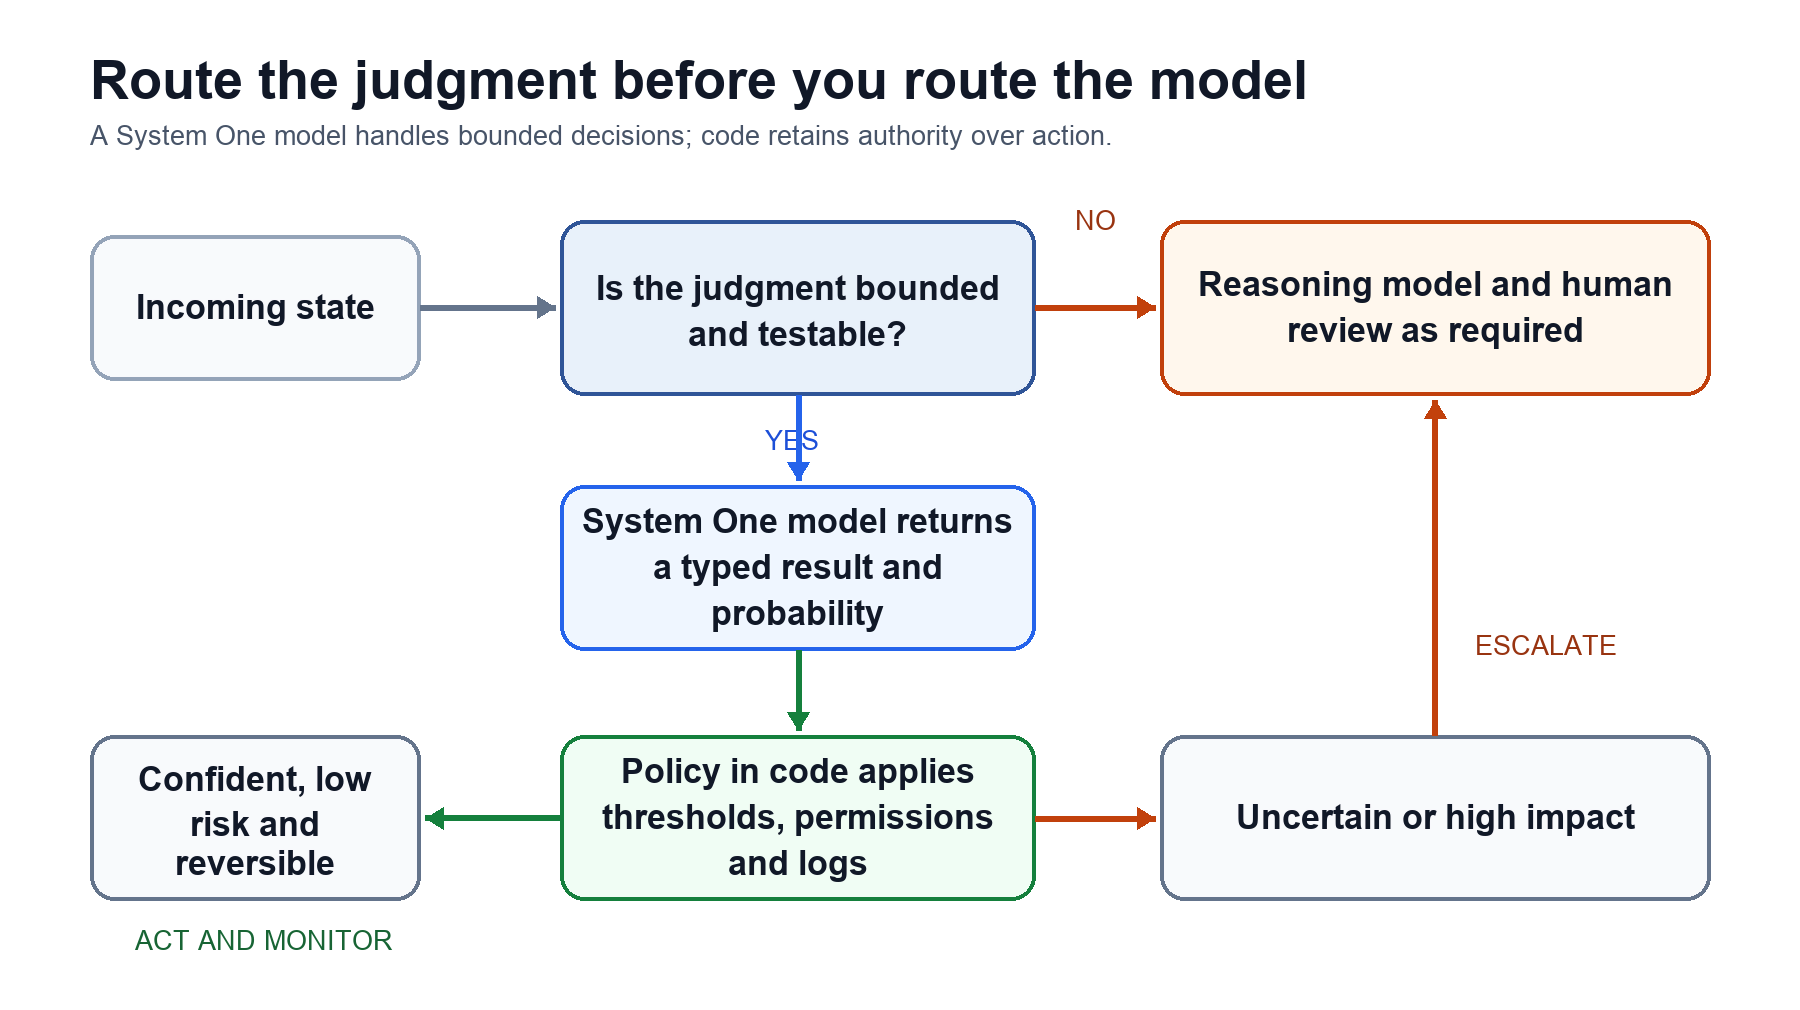
Kuva 1. Rajoitettu päätösreitti pitää kynnysarvot, oikeudet ja eskaloinnin koodissa.
Mallireitityksessä on samankaltaisuuksia, mutta on kriittinen ero. RouteLLM tekee päätöksiä siitä, kumpi kahdesta kielimallista valita. Se valitsee vahvemman ja heikomman mallin välillä tasapainottaen laatua ja hintaa. System One -malli tuottaa rajoitettuja päätöksiä, joita koodi voi käyttää suoraan. Nämä päätökset voivat tukea mallireititystä sekä muita agentin sisäisiä päätöksiä.
Miksi agenttien silmukat ovat luonnollinen valinta
Agenttien silmukoiden luonne tekee niistä erityisen sopivia lukuisten pienten tasojen päätösten tekemiseen. Nämä päätökset auttavat saavuttamaan lopullisen tuloksen. Toisin sanoen agenttien täytyy tehdä paljon “pieniä” päätöksiä sen jälkeen, kun käyttäjä on lähettänyt kysymyksensä tai pyyntönsä. Nämä päätökset tapahtuvat ennen kuin vastaus tai tulos palautetaan.
Esimerkki olisi päätöksenteko, mitä työkaluja käyttää, haettujen tietueiden järjestäminen ja riskin arviointi. Järjestelmä myös määrittää, onko riittävästi todisteita ja tulisiko prosessin jatkaa. Todennäköisesti nämä kaikki tapahtuvat toistuvasti. Lisäksi silmukoiden välisten viiveiden kertyminen ajan myötä voi kasvaa.
Tämä rooli agenttien silmukoille havainnollistuu LangChainin Jev-integraatiossa, jossa Jev voi suorittaa sekä mallireitityksen että työkalukutsujen tarkistukset. Vaikka Jev integroituu generatiivisen mallin reunojen ympärille, itse generatiivinen malli jatkaa suunnittelua ja sisällön tuottamista. Tämä edustaa paljon realistisempaa käyttötapausta Jeville. Se täydentää yleiskäyttöistä kielimallia sen sijaan, että se korvaisi sen.
Lisäksi kysymysten rinnakkaistaminen muuttaa myös tapaa, jolla tiimit ajattelevat tehtävien pilkkomista. Tarkemmin sanottuna tiimit pystyvät jakamaan yhden epäselvän ohjeen useiksi erillisiksi arviointikysymyksiksi. Tämä voi mahdollisesti johtaa paljon lyhyempään mallikutsujen sarjaan. Se voi luoda työnkulun, joka on paljon helpompi arvioida. Se myös antaa kehittäjille mahdollisuuden käyttää eksplisiittistä liiketoimintalogiikkaa saatujen arvioiden yhdistämiseen.
Yleiskäyttöiset kielimallit voivat tuottaa jäsenneltyjä tuloksia ja voivat olla parempi valinta joissakin tapauksissa. Esimerkiksi päätös ja selitys voidaan joutua antamaan yhdessä. Siksi Jevin on osoitettava enemmän kuin pelkkä skeeman noudattaminen, jotta sitä pidetään tehokkaana.
Jevin tehokkuus riippuu kokonaisjärjestelmän viiveen vähentämisestä. Se myös riippuu hyödyllisten todennäköisyysarvioiden tuottamisesta ja suorituskyvyn vakaudesta eri syötteiden välillä. Jos Jev ei pysty tarjoamaan näitä etuja, toisen mallin valinta lisää vain ylimääräistä kehitys- ja operatiivista kuormitusta.
Tarkoittaako tyypitetty tulos oikeaa tulosta?
Myös Jeviä koskevien väitteiden esittämisessä käytettävä kieli on muotoiltava huolellisesti. Koska mahdollisten tulosten joukko on määritelty etukäteen, mallin ei tulisi palauttaa keksittyä kenttää tai jäsentymätöntä kappaletta. Tämä poistaa yhden epäonnistumisen muodon; se ei poista semanttista virhettä. Mikään ei estä järjestelmää palauttamasta väärää osastoa, antamasta virheellistä riskitasoa tai ilmaisemasta liiallista varmuutta. Se pystyy tekemään kaiken tämän ollen täysin tyyppiturvallinen.
TypeSafen oma System One -dokumentaatio tekee tärkeän erottelun. Kalibraatio mitataan ennusteiden ryhmien välillä; se ei takaa yksittäisen ennusteen oikeellisuutta. Tuotannossa tämä on merkityksellistä. Tiimien täytyy testata, vastaavatko ennustetut todennäköisyydet havaittuja tuloksia omassa datassaan.
Suorituskykytodisteet ovat vielä varhaisia
TypeSafe raportoi vasteajoista 70–500 millisekuntia. Se viittaa myös merkittäviin kustannussäästöihin ja nopeusparannuksiin sisäisissä työnkulun arvioinneissa. Lisäksi TypeSafe ilmoittaa, että nämä otsikkoluvut ovat todennäköisesti lähellä todellisten hyötyjen ylärajaa. TypeSafen julkisesti saatavilla oleva työnkulun testaus käyttää viite‑todennäköisyyksiä, joita muut huipputason mallit ovat tarjonneet sen sijaan, että käytettäisiin totuustietoja. Tulokset ovat hyviä hypoteesien muodostamiseen. Tulokset eivät voi korvata riippumatonta testiä todellisella työkuormalla.
Käytännön testi ennen käyttöönottoa
Kun rakennat ensimmäisen tekoälyä hyödyntävän päätöstyönkulun, älä valitse kaikkein kriittisimpiä päätöksiä (esimerkiksi lääketieteellisiä hyväksyntöjä tai tilien jäädytyksiä). Sen sijaan valitse jotain, joka on hyvin yleistä, palautettavissa ja helppo tarkistaa tiimin muiden jäsenten toimesta. Tämä sisältää, mutta ei rajoitu, tukipyyntöjen reititykseen, asiakirjojen luokitteluun, mallin valintaan ja vähäriskiseen laadunvarmistukseen.
Neljä kysymystä auttavat sinua arvioimaan, toimiiko tämä:
- Onko tuloksella äärellinen määrä mahdollisia vastauksia?
- Pystytkö selkeästi määrittelemään arvion kriteerit?
- Onko mitattavia tuloksia?Seuraa ennustetta, sen todennäköisyyttä, toimintoa ja myöhempiä tuloksia. Tarkista kalibraatio säännöllisesti vertaamalla ennustettuja todennäköisyyksiä havaittuihin tuloksiin.
- Onko sinulla varasuunnitelma, jos automatisoitu päätösprosessi epäonnistuu?Määritä tarkka kohta, jolloin käytetään päättelymallia, pyydetään lisätietoja tai otetaan mukaan ihminen.
Analyysisi tulisi kattaa koko työnkulku, mukaan lukien päätöksentekoprosessi. Käytä mittareita, kuten päätösten tarkkuus, pidättäytymis- tai eskalointiprosentit, kokonaiskäsittelyaika alusta loppuun, kustannus per onnistuneesti suoritettu tehtävä ja virheiden vaikutus. Suorita testejä epäedullisissa olosuhteissa: vaihtelevaa sanankäyttöä, olennaisten tietojen puuttumista, harvinaisia luokkia ja vihamielisiä syötteitä. Optimoitu luokitin, joka aiheuttaa lisäkustannuksia myöhemmässä vaiheessa, ei ole optimointi.
Pitkäaikainen opetus tässä
Jos Jev onnistuu, muuttuu merkittävästi tai korvataan nopeasti, yksi asia pysyy vakiona. Arkkitehtoninen kysymys pysyy. Onko välttämätöntä, että jokainen konepohjainen päätös esitetään generoituina kielimuotoina?
Monissa tapauksissa vastaus on \”ei\”. Tuotantoympäristössä generatiivisia malleja käyttävä järjestelmä voi tuottaa tulkintoja, suunnitelmia ja selityksiä. Käyttämällä rajoitettuja päätösmalleja sama järjestelmä voi reitittää, pisteyttää ja säädellä toiminnan etenemistä. Koodi voi edelleen määrittää hyväksyttävät kynnysarvot ja oikeudet. Ihmisten tulisi säilyttää vastuu päätöksistä, jotka vaikuttavat muiden elämään.
Vaikka tämä on vähemmän dramaattinen näkökulma kuin se, että yksi autonominen malli suorittaisi kaikki tehtävät luotettavasti, se heijastaa sitä, miten luotettavia järjestelmiä rakennetaan. Seuraava suorituskyvyn edistys agenttien osalta saattaa riippua näiden järjestelmän alueiden valinnasta, joissa ajattelu kestää pidempään. Toiset alueet tarvitsevat nopeita päätöksiä, ja jotkut eivät vaadi lainkaan toimintaa.


