
AI:n perusteet
Mitä datan myrkyttäminen tarkoittaa? Näin hyökkääjät turmelevat tekoälymalleja ja aineistoja
Datan myrkyttäminen tarkoittaa koulutus-, hienosäätö-, arviointi- tai hakudatan manipulointia niin, että tekoälyjärjestelmä oppii vääristynyttä toimintaa tai tuottaa hyökkääjän haluamia tuloksia. Tässä oppaassa käsitellään menetelmää, sen kompromisseja, arviointia ja käytännössä olennaisia hallintakeinoja.

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
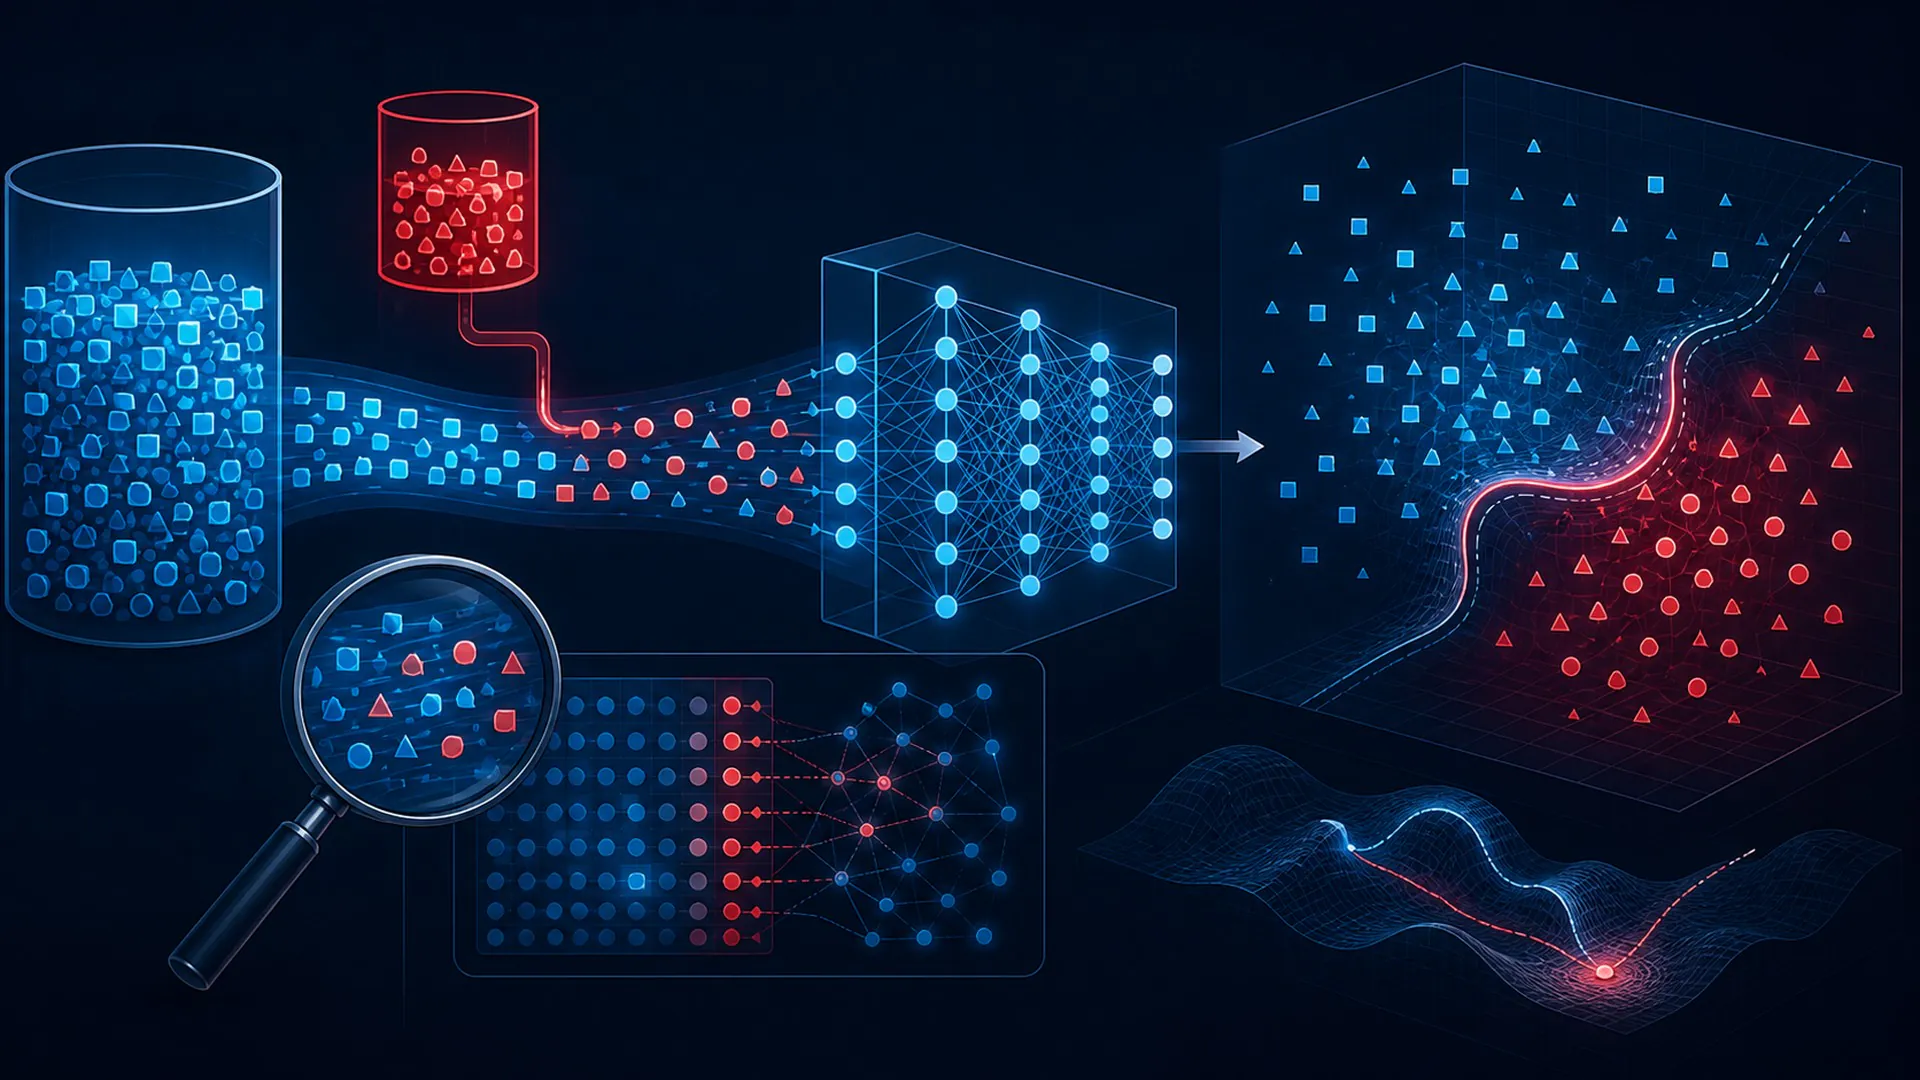
Datan myrkyttämisessä muokataan koulutus-, hienosäätö-, arviointi- tai hakudataa niin, että tekoälyjärjestelmä oppii virheellistä toimintaa tai tuottaa hyökkääjän valitsemia tuloksia.
Datan myrkyttäminen on syytä määritellä tarkasti, sillä nimitys viittaa tiettyyn tietovirtaan, koulutusvalintaan, ajonaikaiseen mekanismiin tai hallinnan rajaan. Jos sitä käytetään ”edistyneen tekoälyn” synonyymina, väitteitä on mahdotonta testata. Tässä oppaassa käsitettä tarkastellaan sen syötteistä ja oletuksista havaittaviin tuloksiin asti, minkä jälkeen arvioidaan oikopolkua, joka sekoitetaan siihen todennäköisimmin.
Datan myrkyttäminen: määritelmä, rajaus ja tarkoitus
Datan myrkyttämisessä muokataan koulutus-, hienosäätö-, arviointi- tai hakudataa niin, että tekoälyjärjestelmä oppii virheellistä toimintaa tai tuottaa hyökkääjän valitsemia tuloksia. Määritelmä sisältää kolme käytännön vaatimusta: syöte on tunnistettavissa, mukana on datan myrkyttämiselle ominainen muunnos tai päätös, ja tulosta voidaan arvioida ilmoitettua tavoitetta vasten. Jos jokin näistä puuttuu, nimitys saattaa kuvata tavoitetta eikä toteutettua mekanismia.
Luotettava tekoäly edellyttää näyttöä koko elinkaaren ajalta. Hallintakeino on mielekäs vain, jos sen omistaja, soveltamisala, käynnistin, odotettu toiminta ja todentamismenetelmä on määritelty selkeästi. Datan myrkyttämisessä tämä järjestelmätason näkökulma on tärkeä, sillä suorituskykyyn voivat vaikuttaa ympäröivät tiedot, rajapinnat, laitteisto, käyttöoikeudet ja ihmiset, vaikka itse malli pysyisi ennallaan. Siksi hyödyllisessä selityksessä erotetaan mallin oppima toiminta tuotteesta, joka päättää, milloin, missä ja millaisin valtuuksin tätä toimintaa käytetään.
Lähin harhaanjohtava oikopolku on kiertohyökkäys, joka tehdään vasta mallin käyttöönoton jälkeen. Sillä voi olla datan myrkyttämisen kanssa jokin näkyvä piirre, mutta syy-seuraussuhteiden kuva muuttuu: onnistumisen osoittamiseen tarvitaan erilaista näyttöä, kustannuksiin vaikuttavat eniten eri resurssit ja haittojen ehkäisemiseen tarvitaan eri hallintakeinoja. Raja on siis käytännöllinen, ei terminologinen.
Datan myrkyttämisen viisivaiheinen toimintamalli
Kaavio on tiivis syy-seuraussuhteita kuvaava malli datan myrkyttämisestä, ei väite siitä, että jokaisessa toteutuksessa olisi viisi ohjelmistokomponenttia. Joissakin järjestelmissä vaiheet yhdistyvät, kun taas toisissa niitä toistetaan silmukassa. Malli on silti hyödyllinen, sillä se edellyttää, että jokaisella tiedon tai toimivallan muutoksella on omistaja, syöte, tuloste ja testi.
1. Hanki vaikutusvaltaa tietolähteeseen: datan myrkyttämisen syöte ja oletukset
Tässä datan myrkyttämisen vaiheessa järjestelmän on saatava vaikutusvaltaa tietolähteeseen. Hyödyllinen kysymys ei ole vain se, tapahtuuko kyseinen toiminto, vaan myös se, mitä tietoja se käyttää, mitä tilaa se muuttaa ja millä näytöllä muutoksen asianmukaisuus voidaan osoittaa. Arvioijan pitäisi pystyä erottamaan toiminto kiertohyökkäyksestä, joka tehdään vasta mallin käyttöönoton jälkeen, ja toistamaan sen tulos samoissa ilmoitetuissa olosuhteissa.
Tähän datan myrkyttämisen vaiheeseen siirrytään ilmoitetusta tavoitteesta, ja vaiheen tuloksen pitäisi mahdollistaa virheellisesti merkittyjen, vinoutuneiden tai laukaisevan ominaisuuden sisältävien esimerkkien lisääminen. Kirjaa epävarmuudet, hylätyt vaihtoehdot, resurssien käyttö sekä kaikki rajalla käytetyt ihmisen tai ohjelmiston hallintakeinot. Jäljitystiedon avulla tiimit voivat havaita, voiko pientä kohdennettua osajoukkoa olla vaikea tunnistaa verkkotason aineistosta, ennen kuin sama heikkous johtaa merkittäviin seurauksiin.
2. Lisää virheellisesti merkittyjä, vinoutuneita tai laukaisevan ominaisuuden sisältäviä esimerkkejä: datan myrkyttämisen esitystapa tai päätös
Tässä datan myrkyttämisen vaiheessa järjestelmän on lisättävä virheellisesti merkittyjä, vinoutuneita tai laukaisevan ominaisuuden sisältäviä esimerkkejä. Hyödyllinen kysymys ei ole vain se, tapahtuuko kyseinen toiminto, vaan myös se, mitä tietoja se käyttää, mitä tilaa se muuttaa ja millä näytöllä muutoksen asianmukaisuus voidaan osoittaa. Arvioijan pitäisi pystyä erottamaan toiminto kiertohyökkäyksestä, joka tehdään vasta mallin käyttöönoton jälkeen, ja toistamaan sen tulos samoissa ilmoitetuissa olosuhteissa.
Tähän datan myrkyttämisen vaiheeseen siirrytään tietolähteeseen vaikuttamisesta, ja vaiheen tuloksen pitäisi mahdollistaa suodatuksesta ja kaksoiskappaleiden poistosta selviäminen. Kirjaa epävarmuudet, hylätyt vaihtoehdot, resurssien käyttö sekä kaikki rajalla käytetyt ihmisen tai ohjelmiston hallintakeinot. Jäljitystiedon avulla tiimit voivat havaita, voiko pientä kohdennettua osajoukkoa olla vaikea tunnistaa verkkotason aineistosta, ennen kuin sama heikkous johtaa merkittäviin seurauksiin.
3. Suodattamisesta ja deduplikoinnista selviytyminen: datamyrkytyksen erottuva muunnos
Tässä datamyrkytyksen vaiheessa järjestelmän on selviydyttävä suodattamisesta ja deduplikoinnista. Olennaista ei ole vain se, tapahtuuko kyseinen käsittely, vaan myös se, mitä tietoja siinä käytetään, mitä tilaa se muuttaa ja mikä näyttö osoittaa muutoksen olleen pätevä. Arvioijan pitäisi pystyä erottamaan tämä käsittely kiertohyökkäyksestä, joka tehdään vasta mallin käyttöönoton jälkeen, ja toistamaan sen tulos samoissa ilmoitetuissa olosuhteissa.
Siirtymä tähän datamyrkytyksen vaiheeseen alkaa väärin luokiteltujen, vinoutuneiden tai laukaisimen sisältävien esimerkkien lisäämisestä, ja sen pitäisi päättyä tulokseen, jonka avulla opittua mallia tai haettua kontekstia voidaan muuttaa. Kirjaa epävarmuus, hylätyt vaihtoehdot, resurssien käyttö sekä kaikki rajapinnassa sovelletut ihmisen tai ohjelmiston tekemät hallintatoimet. Tämän jäljen avulla tiimit voivat havaita, voiko pieni, kohdennettu osajoukko olla vaikea havaita verkkolaajuisessa aineistossa, ennen kuin sama heikkous johtaa merkittäviin seurauksiin.
4. Opitun mallin tai haetun kontekstin muuttaminen: datamyrkytyksen rajoite- ja todennusraja
Tässä datamyrkytyksen vaiheessa järjestelmän on muutettava opittua mallia tai haettua kontekstia. Olennaista ei ole vain se, tapahtuuko kyseinen käsittely, vaan myös se, mitä tietoja siinä käytetään, mitä tilaa se muuttaa ja mikä näyttö osoittaa muutoksen olleen pätevä. Arvioijan pitäisi pystyä erottamaan tämä käsittely kiertohyökkäyksestä, joka tehdään vasta mallin käyttöönoton jälkeen, ja toistamaan sen tulos samoissa ilmoitetuissa olosuhteissa.
Siirtymä tähän datamyrkytyksen vaiheeseen alkaa suodattamisesta ja deduplikoinnista selviytymisestä, ja sen pitäisi päättyä tulokseen, jonka avulla voidaan käynnistää laaja heikkeneminen tai kohdennettu takaovi. Kirjaa epävarmuus, hylätyt vaihtoehdot, resurssien käyttö sekä kaikki rajapinnassa sovelletut ihmisen tai ohjelmiston tekemät hallintatoimet. Tämän jäljen avulla tiimit voivat havaita, voiko pieni, kohdennettu osajoukko olla vaikea havaita verkkolaajuisessa aineistossa, ennen kuin sama heikkous johtaa merkittäviin seurauksiin.
5. Laajan heikkenemisen tai kohdennetun takaoven käynnistäminen: tulos, palaute ja pysäytyssääntö datamyrkytyksessä
Tässä datamyrkytyksen vaiheessa järjestelmän on käynnistettävä laaja heikkeneminen tai kohdennettu takaovi. Olennaista ei ole vain se, tapahtuuko kyseinen käsittely, vaan myös se, mitä tietoja siinä käytetään, mitä tilaa se muuttaa ja mikä näyttö osoittaa muutoksen olleen pätevä. Arvioijan pitäisi pystyä erottamaan tämä käsittely kiertohyökkäyksestä, joka tehdään vasta mallin käyttöönoton jälkeen, ja toistamaan sen tulos samoissa ilmoitetuissa olosuhteissa.
Siirtymä tähän datamyrkytyksen vaiheeseen alkaa opitun mallin tai haetun kontekstin muuttamisesta, ja sen pitäisi päättyä tulokseen, jonka avulla voidaan seurata tilannetta tai tehdä lopullinen päätös. Kirjaa epävarmuus, hylätyt vaihtoehdot, resurssien käyttö sekä kaikki rajapinnassa sovelletut ihmisen tai ohjelmiston tekemät hallintatoimet. Tämän jäljen avulla tiimit voivat havaita, voiko pieni, kohdennettu osajoukko olla vaikea havaita verkkolaajuisessa aineistossa, ennen kuin sama heikkous johtaa merkittäviin seurauksiin.
Lue datamyrkytyksen kaaviota eteenpäin ymmärtääksesi tuotantoon siirtymistä ja taaksepäin vian syyn selvittämiseksi. Eteenpäin suuntautuvassa analyysissa tarkastellaan, miten yksi vaihe tuottaa aineiston seuraavaa vaihetta varten. Taaksepäin suuntautuva analyysi lähtee virheellisestä, hitaasta, kalliista tai turvattomasta tuloksesta ja jäljittää, mikä aiempi oletus sen mahdollisti. Käänteistä tarkastelua seuraamalla tiimi usein huomaa, että ratkaiseva virhe tapahtui jo ennen kuin malli tuotti mitään.
Esimerkki datamyrkytyksestä
Hyökkääjä voi syöttää aineistoon esimerkkejä, jotka opettavat luokittelijan käsittelemään harvinaista visuaalista kuviointia luotettuna luokkana.
Tämä esimerkki on havainnollinen, koska datamyrkytystä voidaan arvioida havaittavien syötteiden, välitilojen ja lopputuloksen perusteella sen sijaan, että sitä arvioitaisiin viimeistellyn demonstraation pohjalta. Perusteellisessa testissä rakennettaisiin skenaarion ympärille tavanomaisia, vaikeita ja tarkoituksella harhaanjohtavia tapauksia, säilytettäisiin vertailutaso ilman kyseistä tekniikkaa sekä kirjattaisiin sekä keskimääräinen suorituskyky että yksittäisten virheiden vakavuus.
Muuta yhtä datamyrkytystä koskevan esimerkin oletusta ja toista analyysi. Poista vaadittu syöte, lisää ristiriitainen signaali, rajoita laskentatehoa, muuta käyttäjäjoukkoa tai pakota järjestelmä pidättäytymään vastaamisesta. Mekanismi, joka onnistuu vain yhdessä huolellisesti järjestetyssä demonstraatiossa, ei ole osoittanut yleistyvänsä käyttöympäristöön.
Datamyrkytys ja sen yleisin virheellinen yksinkertaistus
Datamyrkytys pelkistetään usein kiertohyökkäykseksi, joka tehdään vasta mallin käyttöönoton jälkeen. Tällainen pelkistys sivuuttaa juuri sen rajan, joka määrittelee käsitteen. Se voi saada ostajat vertailemaan keskenään erilaisia tuotteita, tutkijat liioittelemaan kokeen osoittamaa näyttöä ja ylläpitäjät seuraamaan käyttöönoton jälkeen väärää signaalia.
| Näkökulma | Käytännön vastaus |
|---|---|
| Määritelmä | Datan myrkyttämisessä manipuloidaan koulutus-, hienosäätö-, arviointi- tai hakutietoja niin, että tekoälyjärjestelmä oppii vääristynyttä toimintaa tai tuottaa hyökkääjän haluamia tuloksia. |
| Sekaannus | vasta mallin käyttöönoton jälkeen tehtävä väistöhyökkäys. |
| Riski | pieni, kohdennettu osajoukko voi olla vaikea havaita verkkolaajuisessa datassa. |
Vertailussa tulisi myös määritellä analyysin kohdeyksikkö. Datan myrkyttämistä käsittelevässä tutkimuksessa voidaan tarkastella erikseen mallia tai algoritmia, kun taas käyttöön otettuun palveluun kuuluvat lisäksi tiedonhaku, reititys, välimuisti, käytännöt, identiteetti, käyttöliittymät ja valvonta. Kaksi tuotetta voi käyttää samaa yleisnimitystä mutta toteuttaa järjestelmäkokonaisuuden eri osia. Selvitä, mikä komponentti toteuttaa määrittävän muunnoksen ja mitkä muut komponentit ovat välttämättömiä raportoidun tuloksen saavuttamiseksi.
Miksi datan myrkyttäminen on tärkeää nykyisissä tekoälyjärjestelmissä
Datan myrkyttäminen on nyt tärkeää, koska tekoälyjärjestelmille annetaan laajempia konteksteja, ne käsittelevät useampia modaliteetteja, käyttävät enemmän laskentatehoa suorituksen aikana, saavat laajemman pääsyn työkaluihin ja kytkeytyvät tiiviimmin organisaatioiden päätöksentekoon. Näissä oloissa aiemmin pelkältä tutkimuksen yksityiskohdalta vaikuttanut asia voi määrittää viiveen, tietoturvan, saavutettavuuden, ympäristökustannukset, tuotteen laadun tai oikeudellisen vastuun.
Oleellista ei ole se, pystyykö datan myrkyttäminen tuottamaan yhden vaikuttavan tuloksen. Ratkaisevaa on, parantaako menetelmä tärkeää lopputulosta edustavissa olosuhteissa ja tehokkaammin kuin yksinkertaisempi vertailumenetelmä. Raportoi jakaumat, virheluokat, viiveet kuormituksen huippupäässä, resurssien käytön ja vaikutusten kohteena olevat alaryhmät sen sijaan, että tiivistäisit kaikki tulokset yhdeksi keskiarvoksi.
Seuraa sekä teknisiä mittareita että ihmisiin kohdistuvia vaikutuksia. Dokumentoi epävarmuus, säilytä tietojen alkuperää koskevat tiedot, mahdollista asioiden eskalointi ja suunnittele palautuminen ennen järjestelmän altistamista muuttuville todellisen maailman olosuhteille. Kun tätä toimintatapaa sovelletaan nimenomaan datan myrkyttämiseen, näyttöä voidaan hyödyntää myös muualla: toinen tiimi voi arvioida, säilyykö väitetty hyöty todennäköisesti käytettäessä eri mallia, kieltä, laitteistoalustaa, tietojoukkoa tai käyttäjäryhmää tai sovellettaessa erilaista riskinsietokykyä.
Hyödyt, joita datan myrkyttäminen voi tuoda
Vahvin peruste datan myrkyttämisen käytölle on se, että menetelmällä voidaan puuttua suoraan sen kohteena olevaan pullonkaulaan. Toteutustavasta riippuen hyöty voi näkyä parempana ankkuroitumisena, uskollisempana esitysmuotona, parempana yleistämiskykynä, lyhyempänä viiveenä, vähäisempänä muistiliikenteenä, selkeämpänä vastuunjakona tai turvallisempana rajana mallin ehdotuksen ja todellisen toiminnan välillä.
Hyödyt tulisi ilmaista päätöksinä ja mittareina. ”Älykkäämpi” ei ole datan myrkyttämisen hyväksymiskriteeri. Hyödyllinen tavoite voisi määritellä virheprosentin vaikeissa tapauksissa, palautumisen ristiriitaisen näytön jälkeen, kustannukset tietyssä liikenteen prosenttipisteessä, ihmisen tekemään tarkistukseen kuluvan ajan, kalibroinnin tai niiden toimien prosenttiosuuden, jotka pysyvät määritellyn toimivaltarajan sisällä.
Datan myrkyttämisen määrittävä virhetilanne
Keskeinen rajoite on se, että pientä, kohdennettua osajoukkoa voi olla vaikea havaita verkkolaajuisessa datassa. Tämä virhetilanne ei ole jälkikäteen lisättävä huomio, joka kirjataan vasta kehitystyön päätyttyä. Sen tulee alusta alkaen ohjata datan myrkyttämisen tiedonkeruuta, arkkitehtuuria, käyttöoikeuksia, arviointia, julkaisun ehtoja ja valvontaa.
Datan myrkyttämisen valvontatoimesta on hyötyä vain, jos se toteutetaan ennen kallista tai peruuttamatonta seurausta. Tunnista virhetilanteen varhaisin havaittavissa oleva ennusmerkki, määritä raja-arvo tai sääntö, nimeä vastuullinen omistaja ja testaa palautumista. Käyttötapauksesta riippuen palautuminen voi tarkoittaa pidättäytymistä, siirtymistä yksinkertaisempaan järjestelmään, lisänäytön pyytämistä, asian eskalointia ihmiselle, mallin aiemman version palauttamista tai toiminnan keskeyttämistä kokonaan.
Datan myrkyttämisen arviointisuunnitelma
Aloita datan myrkyttämisen arviointi määrittelemällä päätös, jota näytön on tuettava. Määrittele toiminnan kohdejoukko, virheellisen tuloksen seuraukset, päätöshetkellä tosiasiassa käytettävissä olevat tiedot sekä yksinkertaisin uskottava vaihtoehto. Näin vertailutestistä ei tule päämäärää vain siksi, että se on helppo toteuttaa.
Käytä kontrolloiduissa vertailuissa koskematonta testijoukkoa ja validoi datan myrkyttäminen sen jälkeen vaiheittain käyttöympäristössä. Offline-arvioinnissa eri versioita voidaan vertailla keskenään; varjotila, canary-käyttöönotot, käyttörajat tai hyväksymisportit paljastavat, miten todellinen liikenne, palautekierrot ja ihmiset muuttavat toimintaa. Käyttöönoton vaiheelle on määriteltävä selkeä pysäytysehto sen sijaan, että oletetaan jokaisen parannuksen ansaitsevan täysimittaisen käyttöönoton.
Versioi kaikki datan myrkyttämisen toistamiseen tarvittavat syötteet soveltuvin osin: lähdedata, esikäsittely, tokenisoija tai enkooderi, mallin painot, konfiguraatio, kehote tai käytäntö, hakuindeksi, arviointijoukko, laitteistoa koskevat oletukset ja palvelukoodi. Ilman tietojen alkuperän seurantaa tiimi ei voi päätellä, johtuiko muuttunut tulos menetelmästä, ympäristöstä vai huomaamatta jääneestä muutoksesta tietojenkäsittelyputkessa.
Kysy lopuksi, mikä havainto kumoaisi väitteen siitä, että datan myrkyttämisestä on hyötyä. Jos mikään tulos ei voisi muuttaa käyttöönottopäätöstä, arviointi on markkinointia. Etukäteen määritellyt hyväksymiskynnykset ja tallessa pidettävä vahvistusjoukko tekevät arvioinnista näyttöön perustuvaa.
Kysymyksiä, jotka kannattaa esittää ennen datan myrkyttämisen käyttöönottoa
- Tavoite: Minkä mitattavan pullonkaulan datan myrkyttämisellä on tarkoitus ratkaista?
- Menetelmä: Missä viidestä vaiheesta tapahtuu menetelmälle ominainen muunnos?
- Vertailutaso: Miten menetelmä vertautuu kiertohyökkäykseen, joka toteutetaan vasta mallin käyttöönoton jälkeen, tai johonkin muuhun yksinkertaisempaan vaihtoehtoon?
- Näyttö: Millaisia tavanomaisia, vaikeita, vastustajan aiheuttamia ja alaryhmiin kuuluvia tapauksia testattiin?
- Toiminta: Millaisia viive-, muisti-, laskenta-, energia-, ylläpito- ja tarkistuskustannuksia syntyy suuressa mittakaavassa?
- Riski: Miten tiimi havaitsee, että pientä kohdennettua osajoukkoa voi olla vaikea löytää verkkodatan mittakaavassa?
- Palautuminen: Voiko järjestelmä pidättäytyä vastaamisesta, siirtyä varajärjestelmään, palautua aiempaan versioon tai siirtää asian eteenpäin ennen vahingon syntymistä?
Keskeisiä lähteitä datan myrkyttämisen tutkimiseen
Tekoälyn järjestelmäkokonaisuuden datan myrkyttämistä ympäröivää osaa käsitteleviä luotettavia lähtökohtia ovat NISTin tekoälyn riskienhallintakehys, C2PA-määritykset ja NISTin tietosuojakehys. Lue niitä yhdessä juuri kyseistä mallia, tietojoukkoa, laitteistoa ja lainkäyttöaluetta koskevan dokumentaation kanssa. Yleinen lähde voi määritellä menetelmän, mutta vain käyttöönottoa koskeva näyttö voi osoittaa, soveltuuko tietty toteutus kyseiseen tarkoitukseen.
Mitä datan myrkyttämisestä kannattaa muistaa
Datan myrkyttäminen on määritelty menetelmä laajemmassa sosioteknisessä järjestelmässä. Sen arvo syntyy siitä, että se parantaa tiettyä lopputulosta nimenomaisesti määritellyissä olosuhteissa, ei itse nimityksestä. Viisivaiheinen kaavio havainnollistaa tiedonkulkua, vertailu kertoo, mitä menetelmä ei ole, ja hallintapolku osoittaa, missä vastuullinen toimija voi puuttua tilanteeseen.
Datan myrkyttämisen käytännön ohjenuorana on määritellä tavoite, verrata menetelmää uskottavaan vertailutasoon, testata tärkein virhetilanne ja säilyttää muutosten seurantaan tarvittava näyttö. Kun nämä osat ovat paikallaan, menetelmästä tulee arvioitavissa oleva tekninen ja hallinnollinen valinta. Ilman niitä jäljelle jää lupaavalta kuulostava nimi, johon liittyvä toiminnallinen riski on tuntematon.



