
AGI ja tulevaisuuden AI
Vektoriga tietokantojen rooli modernissa generatiivisessa tekoälysovelluksissa

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Keskeiset kohdatVektori tietokannat mahdollistavat nopean samankaltaisuushaun korkeaulotteiselle…
Näytä lisää
- Vektori tietokannat mahdollistavat nopean samankaltaisuushaun korkeaulotteiselle datalle kuten upotuksille, mikä on keskeinen vaatimus tehokkaalle generatiiviselle tekoälylle.
- Suuret teknologiayhtiöt kuten Microsoft ja Oracle investoivat vektoritietokantojen kyvykkyyksiin tekoälytyökalujen ja haun tehostetun generoinnin (RAG) mahdollistamiseksi.
- Vektoritietokannat muuttavat haun avainsanavastaavuudesta semanttiseksi noutamiseksi, ymmärtäen käyttäjän intentia tekstin, kuvien ja äänen kautta.
Laajamittaiset generatiiviset tekoälysovellukset tarvitsevat tehokkaan järjestelmän suurten tietomäärien käsittelyyn. Vektoritietokanta on yksi tällainen järjestelmä. Se pystyy käsittelemään tekstiä, ääntä, kuvia ja videoita numeerisessa vektorimuodossa.
Mitä vektoritietokannat ovat?
Vektoritietokanta on erikoistunut tallennusjärjestelmä, joka on suunniteltu käsittelemään korkeaulotteisia vektoreita tehokkaasti. Nämä vektorit, jotka voidaan ajatella pisteinä moniulotteisessa avaruudessa, edustavat usein upotettuja tai pakattuja edustuksia monimutkaisemmista tiedoista, kuten kuvista, teksteistä tai äänistä.
Vektoritietokannat sallivat nopean samankaltaisuuden etsinnän näiden vektoreiden kesken, mahdollistaen nopean hakemisen vastaavimmista kohteista laajasta tietokannasta.
Perinteiset tietokannat vs. vektoritietokannat
Vektoritietokannat:
- Käsittelee korkeaulotteisia tietoja: Vektoritietokannat on suunniteltu hallitsemaan ja tallentamaan tietoja korkeaulotteisissa avaruuksissa. Tämä on erityisen hyödyllistä sovelluksissa, kuten koneoppimisessa, jossa datapisteet (kuten kuvat tai tekstit) voidaan edustaa vektoreina moniulotteisissa avaruuksissa.
- Optimoitu samankaltaisuuden etsintään: Yksi vektoritietokantojen erityispiirre on niiden kyky suorittaa samankaltaisuuden etsintää. Sen sijaan, että tietoja haettaisiin tarkasti vastaavien perusteella, nämä tietokannat sallivat tietojen hakemisen “samankaltaisten” perusteella, mikä tekee niistä arvokkaita tehtävissä, kuten kuvan tai tekstin hakemisessa.
- Skalattavuus suurten tietojoukkien kanssa: Tekoäly- ja koneoppimissovellusten kasvaessa myös niiden käsittelemien tietojen määrä kasvaa. Vektoritietokannat on suunniteltu skaalautumaan, varmistaen, että ne voivat käsitellä suuria tietomääriä ilman suorituskyvyn heikentymistä.
Perinteiset tietokannat:
- Rakenteisten tietojen tallennus: Perinteiset tietokannat, kuten relaatiotietokannat, on suunniteltu tallentamaan rakenteisia tietoja. Tämä tarkoittaa, että tietoja järjestetään ennalta määritettyihin tauluihin, riveihin ja sarakkeisiin, varmistaen tietojen eheyden ja johdonmukaisuus.
- Optimoitu CRUD-operaatioihin: Perinteiset tietokannat on pääasiallisesti optimoitu CRUD-operaatioihin (luonti, lukeminen, päivittäminen ja poistaminen). Tämä tarkoittaa, että ne on suunniteltu toimimaan tehokkaasti tietojen luomisessa, lukemisessa, päivittämisessä ja poistamisessa, mikä tekee niistä soveltuvia laajalle alueelle sovelluksia, aina verkkopalveluista yrityssovelluksiin.
- Kiinteä skeema: Yksi perinteisten tietokantojen määrittävistä piirteistä on kiinteä skeema. Kun tietokannan rakenne on määritelty, muutokset siihen voivat olla monimutkaisia ja aikaa vieviä. Tämä joustamattomuus varmistaa tietojen eheys, mutta voi olla vähemmän joustava kuin joissakin moderneissa tietokannoissa, joissa on dynaaminen skeema.
Perinteisten tietokantojen on usein vaikea käsitellä upotusten monimutkaisuutta, kun taas vektoritietokannat on suunniteltu juuri tähän tehtävään.
Vektoriesitykset
Vektoritietokantojen toiminta perustuu erilaisten tietojen esittämiseen numeerisina vektoreina. Esimerkiksi kuva kissasta voidaan muuntaa koneen käsiteltäväksi yksilölliseksi 512-ulotteiseksi vektoriksi:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
Vektoritietokantojen avulla generatiiviset tekoälysovellukset voivat hakea tietoa merkityksen perusteella ja säilyttää tietoja pitkäaikaisesti. Menetelmä ei rajoitu kuviin: myös asiayhteyksiä ja semanttisia merkityksiä sisältävä teksti voidaan esittää vektoreina.
Generatiivinen tekoäly ja vektoritietokantojen tarve
Generatiivisessa tekoälyssä käytetään usein upotuksia. Luonnollisen kielen käsittelyssä sanat tai lauseet muunnetaan vektoreiksi, jotka kuvaavat niiden semanttista merkitystä. Ihmisen kaltaista tekstiä tuottavien mallien on pystyttävä vertailemaan ja hakemaan olennaisia upotuksia nopeasti, jotta tuotettu teksti säilyttää asiayhteyden.
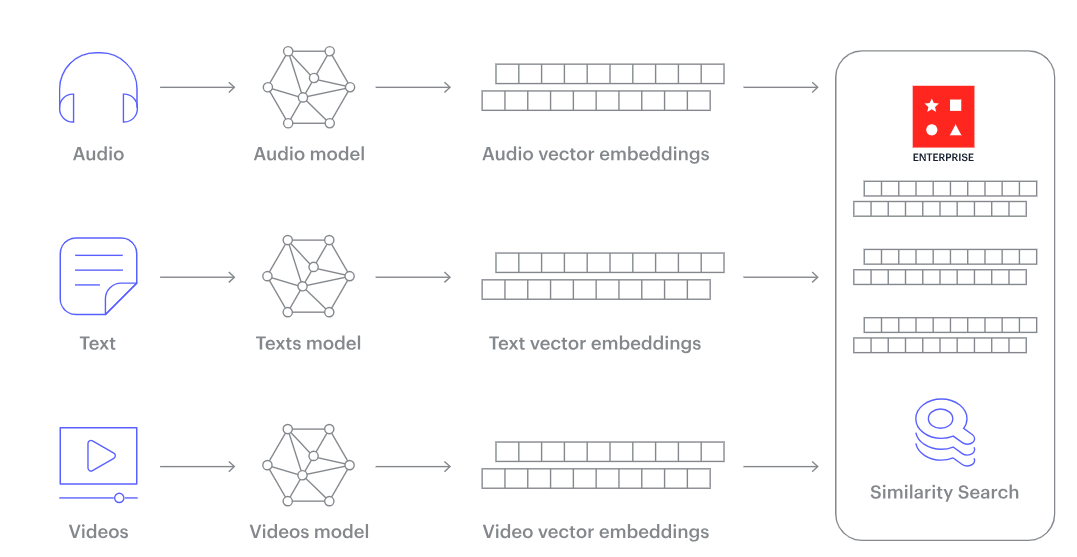
Vektoriupotukset ja tietokannat. Redis
Myös kuvien ja äänen tuottamisessa upotukset koodaavat kuvioita ja ominaisuuksia. Mallien tehokas toiminta edellyttää tietokantaa, josta samankaltaiset vektorit voidaan hakea välittömästi. Siksi vektoritietokannat ovat tärkeä osa generatiivista tekoälyä.
Luonnollisen kielen upotukset luodaan yleensä valmiiksi koulutetuilla malleilla, kuten seuraavilla:
- GPT-3 ja GPT-4: OpenAI:n GPT-3 eli Generative Pre-trained Transformer 3 on ollut merkittävä luonnollisen kielen käsittelyn malli, jossa on 175 miljardia parametria. Sitä seuraava GPT-4 vie laadukkaiden upotusten tuottamista eteenpäin. Monipuolisilla aineistoilla koulutetut mallit pystyvät kuvaamaan lukuisia kielen vivahteita.
- BERT ja sen muunnelmat: Googlen BERT eli Bidirectional Encoder Representations from Transformers on toinen merkittävä malli. Sen pohjalta on kehitetty esimerkiksi RoBERTa ja DistillBERT. BERTin kaksisuuntainen koulutus auttaa ymmärtämään sanaa ympäröivää asiayhteyttä.
- ELECTRA: Tämä uudempi malli toimii tehokkaasti ja voi saavuttaa huomattavasti suurempien GPT-3:n ja BERTin kaltaisten mallien suorituskyvyn pienemmällä laskentateholla. ELECTRA erottaa esikoulutuksessa aidon datan korvatusta datasta, mikä auttaa tuottamaan tarkempia upotuksia.

Prosessi alkaa siitä, että upotusmalli muuntaa halutun sisällön vektoriupotuksiksi. Ne tallennetaan vektoritietokantaan yhdessä alkuperäiseen sisältöön osoittavan linkin tai viitteen kanssa. Näin tiedon alkuperä voidaan jäljittää ja sen merkityksellisyys säilyttää.
Kun käyttäjä tai järjestelmä esittää sovellukselle kysymyksen, sama upotusmalli muuntaa kyselyn vektoreiksi. Niiden avulla tietokannasta etsitään samankaltaisia vektoriesityksiä. Löydetyt vektorit liittyvät suoraan alkuperäiseen sisältöön, joten kyselyyn voidaan palauttaa olennaisia ja täsmällisiä tuloksia.
Vektoritietokantojen uusien toimijoiden rahoitus kasvaa
Tekoälyn suosion kasvaessa monet yritykset investoivat vektoritietokantoihin parantaakseen algoritmiensa laatua ja nopeutta. Tästä kertovat viimeaikaiset sijoitukset muun muassa Pineconeen, Chroma DB:hen ja Weaviateen.

Myös Microsoftin (MSFT ) kaltaisilla suuryrityksillä on omia työkalujaan. Esimerkiksi Azure Cognitive Search auttaa yrityksiä luomaan vektoritietokantoihin perustuvia tekoälytyökaluja.
Oracle (ORCL ) ilmoitti hiljattain Database 23c:n uusista ominaisuuksista ja integroidusta vektoritietokannasta. AI Vector Search tuo uuden tietotyypin, indeksit ja hakutyökalut esimerkiksi asiakirjojen ja kuvien tallentamiseen ja hakemiseen vektoreina. Se tukee hakua hyödyntävää generointia (RAG), jossa suuret kielimallit yhdistetään yrityksen tietoihin. Näin kielipohjaisiin kysymyksiin saadaan parempia vastauksia jakamatta yksityisiä tietoja.
Vektoritietokantojen keskeiset valintaperusteet
Etäisyysmitat
Samankaltaisuushaun tehokkuus riippuu valitusta etäisyysmitasta. Tavallisia vaihtoehtoja ovat euklidinen etäisyys ja kosinisamankaltaisuus. Ne soveltuvat erilaisiin vektorijakaumiin.
Indeksointi
Vektorien suuren ulottuvuusmäärän vuoksi perinteiset indeksointimenetelmät eivät riitä. Vektoritietokannoissa käytetään esimerkiksi Hierarchical Navigable Small World -graafeja (HNSW) ja Annoy-puita. Niiden avulla vektoriavaruus voidaan jakaa tehokkaasti ja lähimmät naapurit löytää nopeasti.

Annoy-puu (lähde)
Annoy käyttää binäärihakupuita. Se jakaa data-avaruuden toistuvasti osiin ja etsii läheisiä naapureita tarkastelemalla vain osaa avaruudesta.
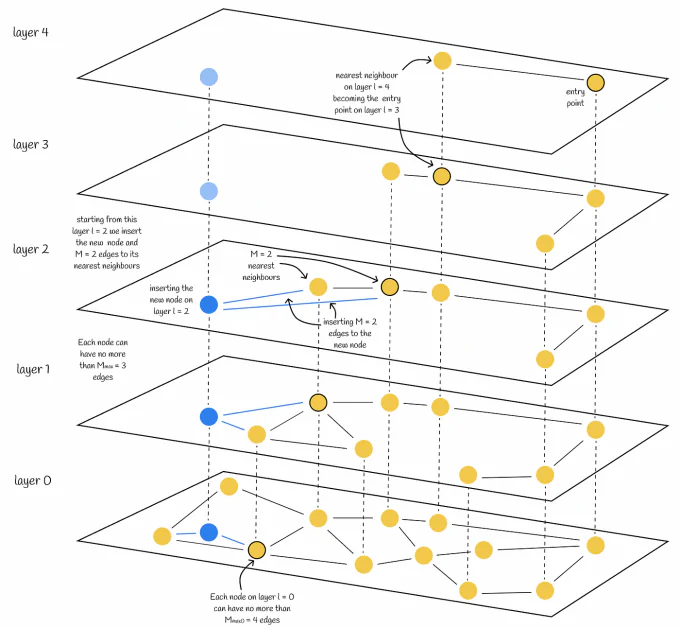
Hierarchical Navigable Small World -graafit (lähde)
HNSW-graafit muistuttavat verkostoja. Ne yhdistävät datapisteet tavalla, joka nopeuttaa hakua ja auttaa löytämään läheiset pisteet nopeasti.
Skalautuvuus
Aineistojen kasvaessa nopeiden hakujen ylläpitäminen vaikeutuu. Hajautetut järjestelmät, grafiikkasuorittimien käyttö ja optimoitu muistinhallinta ovat keinoja vastata tähän haasteeseen.
Vektoritietokantojen rooli: vaikutukset ja mahdollisuudet
1. Koulutusdata edistyneille generatiivisille tekoälymalleille: DALL-E:n ja GPT-3:n kaltaiset mallit koulutetaan valtavilla tietomäärillä. Data sisältää usein kuvista, teksteistä, koodista ja muista lähteistä poimittuja vektoreita. Vektoritietokannat kokoavat ja hallitsevat näitä aineistoja, jotta tekoälymallit voivat löytää vektoreista kuvioita ja yhteyksiä sekä analysoida maailman tietoa.
2. Muutaman esimerkin oppimisen edistäminen: Tässä koulutusmenetelmässä käytetään vain vähän esimerkkejä. Vektoritietokannat tukevat sitä ylläpitämällä kattavaa vektori-indeksiä. Kun malli näkee esimerkiksi muutaman lintukuvan, se voi päätellä lintujen laajemman käsitteen tunnistamalla vektorien samankaltaisuuksia ja suhteita.
3. Suosittelujärjestelmien parantaminen: Vektoritietokannat auttavat suosittelujärjestelmiä ehdottamaan käyttäjän mieltymyksiä vastaavaa sisältöä. Käyttäytymisestä, profiilista ja kyselyistä poimitaan kiinnostuksen kohteita kuvaavia vektoreita. Tietokannasta etsitään niitä muistuttavia sisältövektoreita, mikä mahdollistaa täsmälliset suositukset.
4. Semanttinen tiedonhaku: Perinteinen haku perustuu täsmälleen vastaaviin avainsanoihin. Vektoritietokannat mahdollistavat sisällön ymmärtämisen ja hakemisen semanttisen samankaltaisuuden avulla. Kyselyn merkitys ratkaisee pelkän sanamuodon sijaan: kyselyä vastaavaa vektoria verrataan tietokannan vektoreihin, jotta löydetään käyttäjän tarkoitusta vastaavaa sisältöä.
5. Monimodaalinen haku: Monimodaalinen haku yhdistää tekstiä, kuvia, ääntä, videota ja muita tietolähteitä. Vektoritietokannat mahdollistavat eri tietomuotojen vektorien yhteisen analyysin. Yhdellä kyselyllä voidaan siten löytää tietoa erilaisista lähteistä ja saada kattavampia tuloksia.
Johtopäätös
Tekoäly muuttuu nopeasti ja vaikuttaa moniin toimialoihin, tuoden sekä hyötyjä että uusia ongelmia. Generatiivisen tekoälyn nopea kehitys korostaa vektoritietokantojen keskeistä roolia moniulotteisen datan hallinnassa ja analysoinnissa.
Nämä erikoistuneet tallennusjärjestelmät käsittelevät kuvista, tekstistä ja äänestä muodostettuja korkeaulotteisia vektoreita. Ne ovat tärkeitä nykyaikaisten tekoälysovellusten toiminnalle, erityisesti samankaltaisuushauissa.
Niiden kasvavaa merkitystä osoittavat alalle virtaavat investoinnit. Sekä Pineconen kaltaiset uudet yritykset että Microsoftin kaltaiset suuryritykset edistävät kehitystä.


