
Parhaat
10 parasta koneoppimisen algoritmia

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Vaikka elämme poikkeuksellisen innovatiivista aikaa GPU-kiihdytetyssä koneoppimisessa, uusimmissa tutkimusartikkeleissa esitellään usein näkyvästi algoritmeja, jotka ovat vuosikymmeniä, joissakin tapauksissa jopa 70 vuotta vanhoja.
Jotkut katsovat monien vanhojen menetelmien kuuluvan pikemminkin tilastolliseen analyysiin kuin koneoppimiseen ja ajoittavat alan synnyn vasta vuoteen 1957, jolloin perceptroni keksittiin.
Tämä näkemys on kiistanalainen, sillä vanhat algoritmit tukevat ja läpäisevät uusimpia koneoppimisen suuntauksia ja otsikoihin nousevia edistysaskeleita. Tarkastelemme siksi joitakin uusimpien innovaatioiden taustalla olevia klassisia rakennuspalikoita sekä uudempia tulokkaita, jotka alkavat jo tavoitella paikkaa tekoälyn maineikkaimpien menetelmien joukossa.
1: Transformerit
Vuonna 2017 Google Research johti tutkimusyhteistyötä, joka huipentui artikkeliin Attention Is All You Need. Siinä esiteltiin uusi arkkitehtuuri, joka nosti huomiomekanismit kooderi/dekooderi- ja takaisinkytkettyjen verkkomallien apuroolista itsenäiseksi keskeiseksi teknologiaksi.
Lähestymistapa nimettiin Transformeriksi, ja siitä on tullut mullistava menetelmä luonnollisen kielen käsittelyssä (NLP). Se toimii muun muassa autoregressiivisen kielimallin ja tekoälyn keulakuvan GPT-3:n perustana.

Transformerit ratkaisivat tyylikkäästi ongelman nimeltä sekvenssitransduktio, jota kutsutaan myös muunnokseksi ja jossa syötesekvenssejä käsitellään tulostesekvensseiksi. Transformer myös vastaanottaa ja hallitsee tietoa jatkuvasti eikä peräkkäisinä erinä, mikä mahdollistaa muistin pysyvyyden, jota RNN-arkkitehtuureja ei ole suunniteltu saavuttamaan. Tarkemman yleiskatsauksen transformereihin tarjoaa viiteartikkelimme.
Toisin kuin CUDA-aikakauden koneoppimistutkimusta hallitsemaan alkaneet takaisinkytketyt neuroverkot (RNN), Transformer-arkkitehtuuri oli myös helposti rinnakkaistettavissa, mikä avasi mahdollisuuden käsitellä tehokkaasti paljon RNN-verkkoja laajempia aineistoja.
Yleisiä käyttötapoja
Transformerit herättivät suuren yleisön kiinnostuksen vuonna 2020, kun OpenAI julkaisi GPT-3:n, jossa oli tuolloin ennätykselliset 175 miljardia parametria. Tämän hämmästyttävältä tuntuneen saavutuksen varjoon nousi myöhemmin muita hankkeita, kuten vuonna 2021 julkaistu Microsoftin Megatron-Turing NLG 530B, jossa on nimensä mukaisesti yli 530 miljardia parametria.

Aikajana erittäin laajoista Transformer-pohjaisista NLP-hankkeista. Lähde: Microsoft
Transformer-arkkitehtuuri on siirtynyt myös luonnollisen kielen käsittelystä konenäköön ja mahdollistanut uuden sukupolven kuvasynteesikehykset, kuten OpenAI:n CLIP ja DALL-E. Ne hyödyntävät tekstin ja kuvien välistä aluemappausta muun muassa puutteellisten kuvien täydentämiseen ja uusien kuvien tuottamiseen opetusaineiston aihealueista. Aiheeseen liittyviä sovelluksia syntyy jatkuvasti lisää.
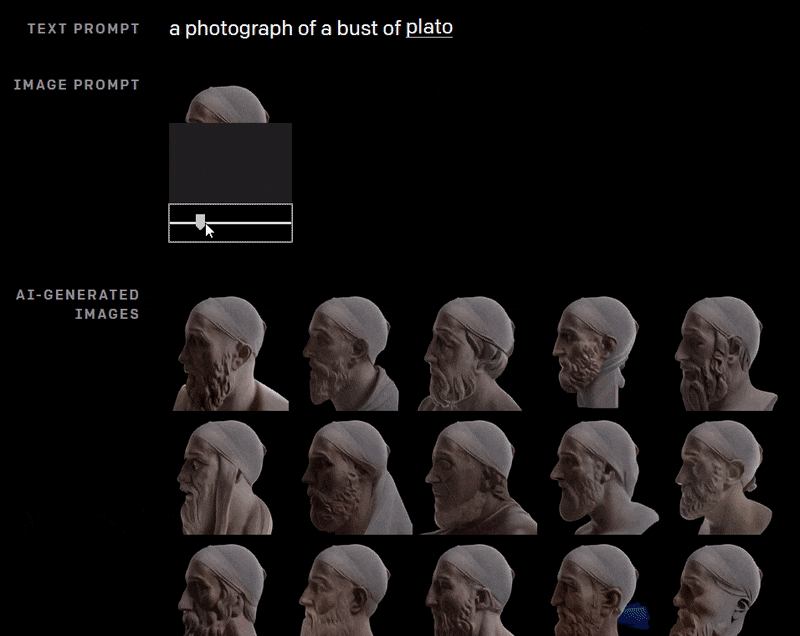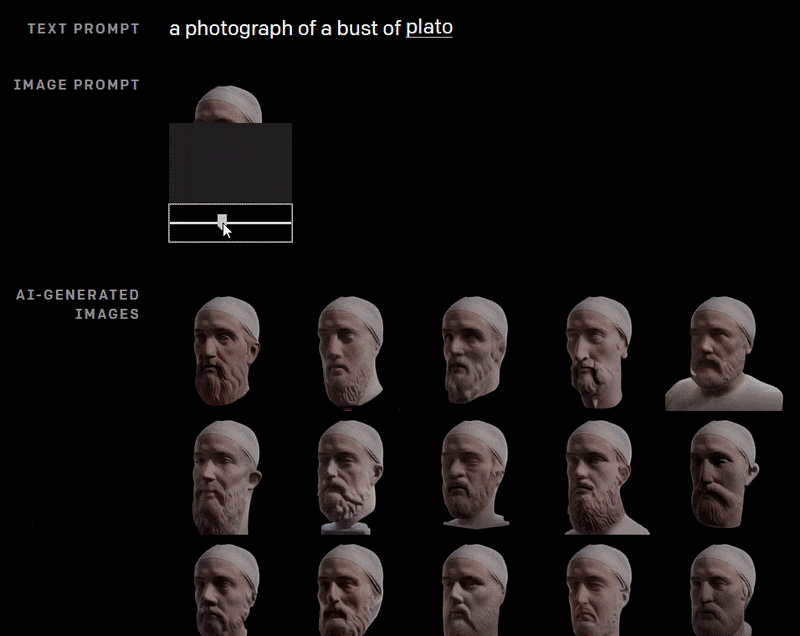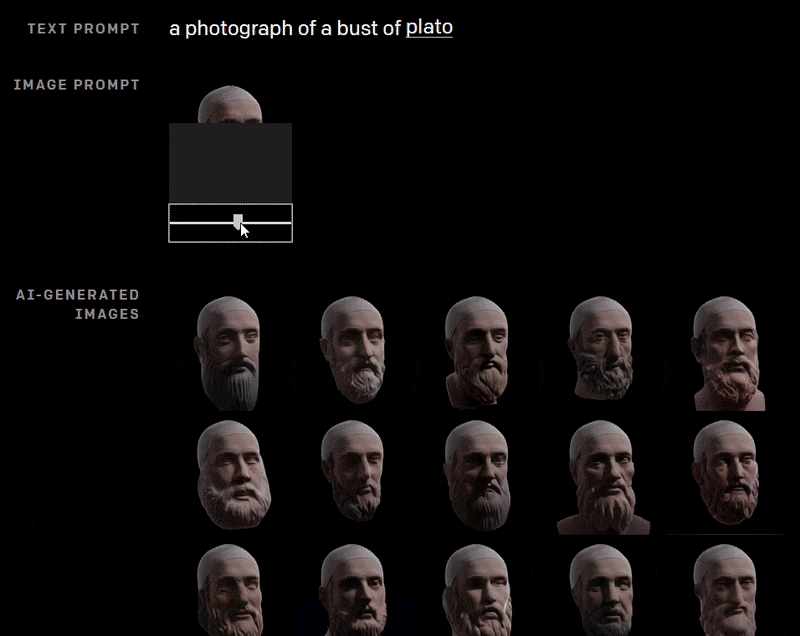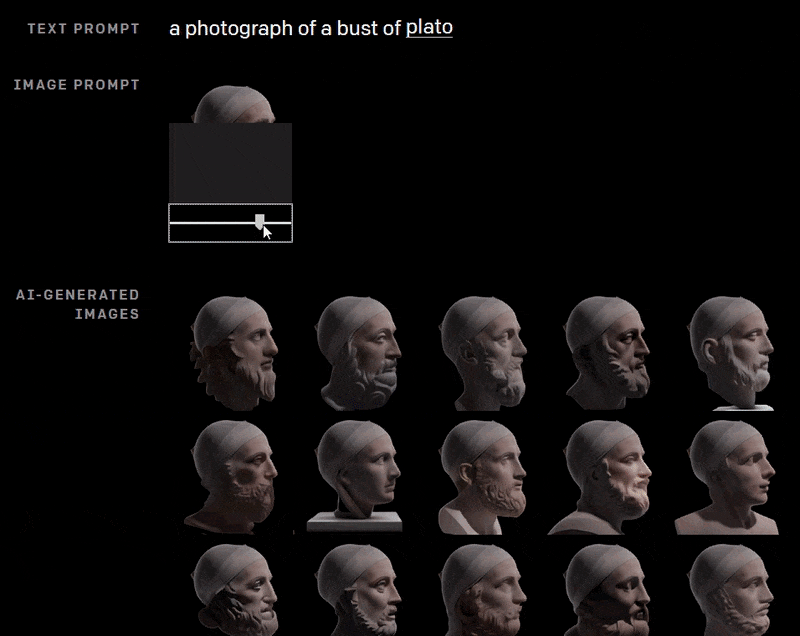
DALL-E yrittää täydentää Platonin rintakuvasta puuttuvia osia. Lähde: https://openai.com/blog/dall-e/
2: Generatiiviset kilpailevat verkot (GAN)
Vaikka transformerit ovat saaneet poikkeuksellisen paljon julkisuutta GPT-3:n julkaisun ja käytön myötä, generatiivinen kilpaileva verkko (GAN) on tullut tunnetuksi myös itsenäisenä käsitteenä ja saattaa lopulta liittyä deepfake -sanan rinnalle verbinä.
Ensimmäisen kerran vuonna 2014 esitetyn ja ensisijaisesti kuvasynteesiin käytetyn generatiivisen kilpailevan verkon arkkitehtuuri koostuu generaattorista ja diskriminaattorista. Generaattori käy läpi tuhansia aineiston kuvia ja yrittää muodostaa ne uudelleen iteratiivisesti. Diskriminaattori arvioi jokaisen yrityksen ja lähettää generaattorin yrittämään paremmin, mutta ei paljasta, millä tavoin edellinen rekonstruktio epäonnistui.

Lähde: https://developers.google.com/machine-learning/gan/gan_structure
Tämä pakottaa generaattorin tutkimaan monia reittejä sen sijaan, että se seuraisi mahdollisia umpikujia, joihin diskriminaattorin antamat tarkat virhevihjeet olisivat voineet johtaa (katso kohta 8 jäljempänä). Opetuksen päätyttyä generaattorilla on yksityiskohtainen ja kattava kartta aineiston pisteiden välisistä suhteista.
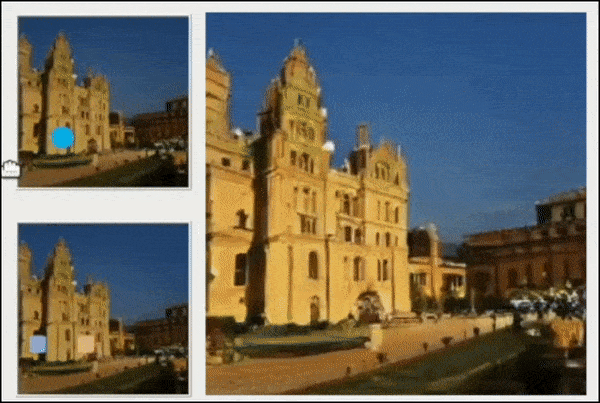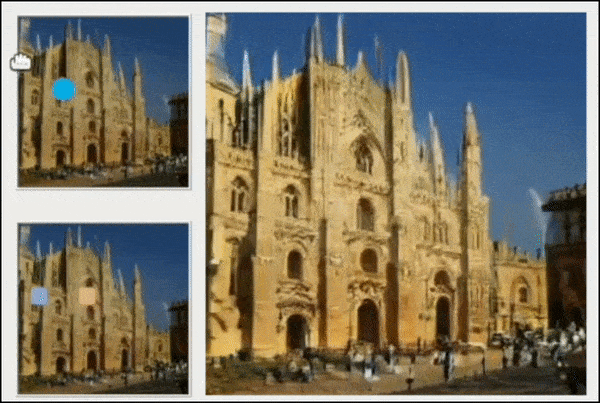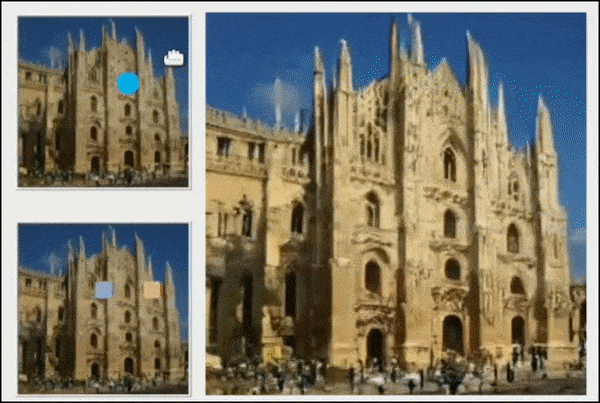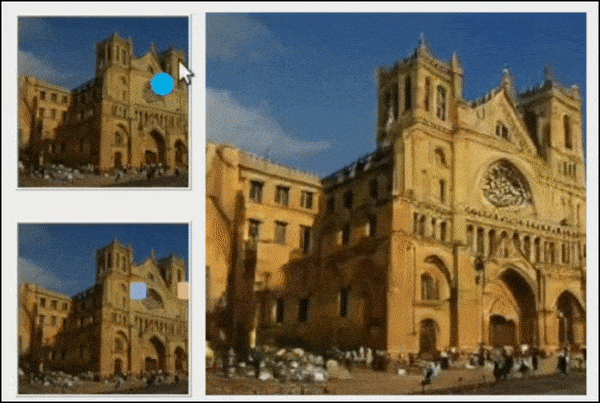
Artikkelista Improving GAN Equilibrium by Raising Spatial Awareness: uusi kehys käy läpi GAN-verkon toisinaan arvoituksellista latenttia avaruutta ja tarjoaa vuorovaikutteista ohjausta kuvasynteesiarkkitehtuurille. Lähde: https://genforce.github.io/eqgan/
Vertauskuvallisesti kyse on erosta yhden arkisen Lontoon keskustaan johtavan työmatkareitin opettelun ja vaivalloisen The Knowledge -kokeeseen valmistautumisenvälillä.
Tuloksena on korkean tason ominaisuuksien kokoelma opetetun mallin latentissa avaruudessa. Korkean tason ominaisuuden semanttinen tunniste voisi olla henkilö. Ominaisuutta tarkentamalla voidaan löytää muita opittuja piirteitä, kuten mies ja nainen. Alemmilla tasoilla alapiirteet voivat jakautua esimerkiksi vaaleahiuksisuuteen ja valkoihoisuuteen.
Ominaisuuksien kietoutuminen on merkittävä ongelma GAN-verkkojen ja kooderi/dekooderi-kehysten latentissa avaruudessa: onko GAN-verkon tuottaman naiskasvon hymy latentissa avaruudessa osa hänen identiteettiinsä kietoutunutta ominaisuutta vai rinnakkainen haara?

GAN-verkolla tuotettuja kasvoja thispersondoesnotexist-palvelusta. Lähde: https://this-person-does-not-exist.com/en
Parin viime vuoden aikana on syntynyt yhä enemmän tätä koskevia tutkimushankkeita. Ne saattavat avata tien GAN-verkon latentin avaruuden yksittäisten ominaisuuksien Photoshop-tyyliseen muokkaukseen, mutta tällä hetkellä monet muunnokset ovat käytännössä kaikki tai ei mitään -paketteja. Esimerkiksi NVIDIAn loppuvuonna 2021 julkaisema EditGAN saavuttaa korkean tulkittavuuden tason latentissa avaruudessa käyttämällä semanttisia segmentointimaskeja.
Yleisiä käyttötapoja
Sen lisäksi, että GAN-verkot osallistuvat suosittuihin deepfake-videoihin tosiasiassa melko rajallisesti, kuva- ja videopainotteiset GAN-verkot ovat lisääntyneet viimeisten neljän vuoden aikana ja kiehtoneet tutkijoita sekä yleisöä. Uusien julkaisujen huimaa tahtia on vaikea seurata, mutta GitHubin Awesome GAN Applications -tietovarasto pyrkii tarjoamaan kattavan luettelon.
Generatiiviset kilpailevat verkot voivat teoriassa johtaa ominaisuuksia mistä tahansa hyvin määritellystä aihealueesta, myös tekstistä.
3: Tukivektorikone (SVM)
Alun perin vuonna 1963 kehitetty tukivektorikone (SVM) on keskeinen algoritmi, joka esiintyy usein uusissa tutkimuksissa. SVM:n vektorit kuvaavat aineiston pisteiden suhteellista sijoittumista, kun taas tukivektorit rajaavat eri ryhmien, ominaisuuksien tai piirteiden välisiä rajoja.

Tukivektorit määrittävät ryhmien väliset rajat. Lähde: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Näin muodostuvaa rajaa kutsutaan nimellä hyperplane eli hypertaso.
Alhaisilla ominaisuustasoilla SVM on kaksiulotteinen (kuva yllä), mutta tunnistettujen ryhmien tai tyyppien määrän kasvaessa siitä tulee kolmiulotteinen.

Pisteiden ja ryhmien syvempi järjestely edellyttää kolmiulotteista SVM:ää. Lähde: https://cml.rhul.ac.uk/svm.html
Yleisiä käyttötapoja
Koska tukivektorikoneet voivat käsitellä tehokkaasti monenlaisia korkeaulotteisia aineistoja niiden tyypistä riippumatta, niitä käytetään laajalti koneoppimisen eri osa-alueilla, kuten deepfake-väärennösten tunnistuksessa, kuvien luokittelussa, vihapuheen luokittelussa, DNA-analyysissä ja populaatiorakenteen ennustamisessasekä monissa muissa tehtävissä.
4: K-means-klusterointi
Klusterointi on yleisesti ohjaamattoman oppimisen menetelmä, joka pyrkii luokittelemaan aineiston pisteitä tiheyden estimoinnin avullaja muodostamaan kartan tutkittavan aineiston jakaumasta.

K-means-klusterointi tunnistaa aineistosta segmenttejä, ryhmiä ja yhteisöjä. Lähde: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-means-klusteroinnista on tullut tämän lähestymistavan suosituin toteutus. Se kokoaa aineiston pisteet erillisiksi K-ryhmiksi, jotka voivat paljastaa väestöryhmiä, verkkoyhteisöjä tai muita raakadatassa piileviä ryhmittymiä.

K-means-analyysissä muodostuvia klustereita. Lähde: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
K-arvo itsessään ratkaisee prosessin hyödyllisyyden ja klusterin optimaalisen arvon määrittämisen. Aluksi K-arvo määrätään satunnaisesti ja sen ominaisuuksia sekä vektoripiirteitä verrataan naapureihin. Satunnaisella arvolla varustettua datapistettä eniten muistuttavat naapurit liitetään sen klusteriin iteratiivisesti, kunnes aineistosta on saatu kaikki prosessin mahdollistamat ryhmät.
Klusterien eri arvojen neliövirheen eli kustannuksen kuvaaja paljastaa aineiston kyynärpääpisteen :

Kyynärpääpiste klusterikuvaajassa. Lähde: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Kyynärpääpiste muistuttaa käsitteellisesti sitä, kuinka häviö tasoittuu ja parannukset pienenevät opetuskerran lopulla. Se kuvaa kohtaa, jossa ryhmien välille ei enää ilmesty uusia eroja. Tällöin voidaan siirtyä dataputken seuraaviin vaiheisiin tai raportoida tulokset.
Yleisiä käyttötapoja
K-means-klusterointi on keskeinen asiakasanalyysin teknologia, sillä se tarjoaa selkeän ja selitettävän tavan muuttaa suuria kaupallisia tietoaineistoja väestöryhmiä koskeviksi havainnoiksi ja myyntiliideiksi.
Lisäksi K-means-klusterointia käytetään esimerkiksi maanvyörymien ennustamiseen, lääketieteellisten kuvien segmentointiin, kuvasynteesiin GAN-verkoilla, asiakirjojen luokitteluunja kaupunkisuunnitteluunsekä moniin muihin mahdollisiin ja jo toteutettuihin sovelluksiin.
5: Satunnaismetsä
Satunnaismetsä on yhdistelmäoppimisen menetelmä, joka laskee päätöspuiden joukon tuloksista keskiarvon ja muodostaa näin kokonaisennusteen.

Lähde: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Vaikka aiheeseen olisi tutustunut vain katsomalla Paluu tulevaisuuteen -trilogian, päätöspuu on melko helppo hahmottaa: edessä on useita polkuja, joista jokainen haarautuu uuteen lopputulokseen ja edelleen uusiin mahdollisiin polkuihin.
Esimerkiksi vahvistusoppimisessapolulta voi perääntyä ja aloittaa uudelleen aiemmasta tilanteesta, kun taas päätöspuut sitoutuvat kulkemiinsa reitteihin.
Satunnaismetsäalgoritmi siis käytännössä hajauttaa päätöksiä koskevat panokset. Sitä kutsutaan satunnaiseksi, koska se tekee ad hoc -valintoja ja havaintoja ymmärtääkseen päätöspuujoukon tulosten mediaanista summaa.
Koska satunnaismetsä ottaa huomioon monia tekijöitä, sen muuntaminen havainnolliseksi kuvaajaksi voi olla vaikeampaa kuin yksittäisen päätöspuun, mutta se on todennäköisesti selvästi tuottavampi.
Päätöspuut ovat alttiita ylisovittamiselle: saadut tulokset koskevat juuri kyseistä aineistoa eivätkä välttämättä yleisty. Satunnaismetsän satunnainen datapisteiden valinta torjuu tätä taipumusta ja tuo esiin merkityksellisiä, hyödyllisiä ja edustavia suuntauksia.

Päätöspuuregressio. Lähde: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Yleisiä käyttötapoja
Kuten monet tämän listan algoritmit, satunnaismetsä toimii tyypillisesti aineiston varhaisen vaiheen lajittelijana ja suodattimena, ja sitä esiintyy siksi jatkuvasti uusissa tutkimuksissa. Käyttötapoja ovat esimerkiksi magneettikuvien synteesi, Bitcoinin hinnan ennustaminen, väestönlaskentatietojen segmentointi, tekstin luokittelu ja luottokorttipetosten tunnistaminen.
Koska satunnaismetsä toimii koneoppimisarkkitehtuurien alemmalla tasolla, se voi parantaa myös muiden matalan tason menetelmien ja visualisointialgoritmien suorituskykyä. Näitä ovat esimerkiksi induktiivinen klusterointi, ominaisuusmuunnokset, tekstiasiakirjojen luokittelu harvojen ominaisuuksien avullasekä dataputkien esittäminen.
6: Naiivi Bayes
Tiheyden estimointiin (ks. kohta 4edellä) yhdistetty naiivi Bayes -luokitin on tehokas mutta suhteellisen kevyt algoritmi, joka arvioi todennäköisyyksiä aineiston laskettujen ominaisuuksien perusteella.

Ominaisuuksien välisiä suhteita naiivi Bayes -luokittimessa. Lähde: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
Nimitys naiivi viittaa Bayesin teoreeman oletukseen, jonka mukaan ominaisuudet eivät liity toisiinsa. Tätä kutsutaan nimellä ehdollinen riippumattomuus. Tästä näkökulmasta ankan tavoin käveleminen ja puhuminen eivät vielä riitä osoittamaan, että kyseessä on ankka, eikä ilmeisiä oletuksia tehdä ennenaikaisesti.
Tällainen tieteellinen ja tutkiva tarkkuus olisi liiallista tilanteessa, jossa voidaan käyttää maalaisjärkeä. Se on kuitenkin arvokas lähtökohta koneoppimisaineiston monien epäselvyyksien ja mahdollisesti toisiinsa liittymättömien korrelaatioiden tutkimisessa.
Alkuperäisessä Bayes-verkossa ominaisuuksia arvioidaan pisteytysfunktioilla, joihin kuuluvat lyhin kuvauspituus ja Bayes-pisteytys. Ne voivat rajoittaa aineistoa datapisteiden välisten arvioitujen yhteyksien ja niiden suuntien perusteella.
Naiivi Bayes -luokitin sitä vastoin olettaa kohteen ominaisuudet riippumattomiksi ja laskee sen jälkeen Bayesin teoreemalla kohteen todennäköisyyden sen ominaisuuksien perusteella.
Yleisiä käyttötapoja
Naiivi Bayes -suodattimia käytetään yleisesti esimerkiksi sairauksien ennustamiseen ja asiakirjojen luokitteluun, roskapostin suodatukseen, tunnesävyjen luokitteluun, suosittelujärjestelmissäsekä petosten tunnistamiseenja moniin muihin sovelluksiin.
7: K lähintä naapuria (KNN)
Yhdysvaltain ilmavoimien ilmailulääketieteen koulu esitti ensimmäisen kerran vuonna 1951menetelmän, jonka täytyi sopeutua 1900-luvun puolivälin tietokoneiden tasoon. K lähintä naapuria (KNN) on kevyt algoritmi, joka esiintyy yhä näkyvästi sekä tieteellisissä artikkeleissa että yksityisen sektorin koneoppimistutkimuksessa.
KNN:ää kutsutaan laiskaksi oppijaksi, koska se käy aineiston kattavasti läpi arvioidakseen datapisteiden välisiä suhteita sen sijaan, että sen käyttö edellyttäisi täysimittaisen koneoppimismallin opettamista.

KNN-ryhmittely. Lähde: https://scikit-learn.org/stable/modules/neighbors.html
Vaikka KNN:n arkkitehtuuri on kevyt, sen järjestelmällinen toimintatapa vaatii huomattavasti luku- ja kirjoitusoperaatioita. Käyttö erittäin suurissa aineistoissa voi olla ongelmallista ilman apumenetelmiä, kuten pääkomponenttianalyysiä (PCA), joka voi muuntaa monimutkaiset ja suuret aineistot edustaviksi ryhmittymiksi , jotka KNN voi käydä läpi pienemmällä vaivalla.
Eräs tuore tutkimus arvioi useiden työntekijän lähtöä ennustavien algoritmien tehokkuutta ja taloudellisuutta. Seitsemänkymmentävuotias KNN osoittautui yhä uudempia kilpailijoita paremmaksi tarkkuuden ja ennustuskyvyn kannalta.
Yleisiä käyttötapoja
KNN ei tunnetusta käsitteellisestä ja toteutuksellisesta yksinkertaisuudestaan huolimatta ole jäänyt 1950-luvulle: siitä kehitettiin syviin neuroverkkoihin keskittyvämpi lähestymistapa Pennsylvanian osavaltionyliopiston vuoden 2018 ehdotuksessa. Se on edelleen keskeinen varhaisen vaiheen prosessi tai jälkikäsittelyn analyysityökalu monissa paljon monimutkaisemmissa koneoppimiskehyksissä.
Eri kokoonpanoissa KNN:ää on käytetty esimerkiksi verkossa tehtävään allekirjoitusten tarkistamiseen, kuvien luokitteluun, tekstinlouhintaan, satojen ennustamiseenja kasvojentunnistukseensekä muihin sovelluksiin ja järjestelmien osiin.

Opetuksessa oleva KNN-pohjainen kasvojentunnistusjärjestelmä. Lähde: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markovin päätösprosessi (MDP)
Amerikkalaisen matemaatikon Richard Bellmanin vuonna 1957 esittelemäMarkovin päätösprosessi (MDP) on yksi vahvistusoppimisen arkkitehtuurien keskeisimmistä rakennuspalikoista. Se on itsenäinen käsitteellinen algoritmi, josta on mukautettu lukuisia muita algoritmeja ja jota esiintyy jatkuvasti nykyisessä tekoäly- ja koneoppimistutkimuksessa.
MDP tutkii data-ympäristöä arvioimalla nykyistä tilaansa eli sijaintiaan aineistossa ja päättämällä sen perusteella, mitä solmua tutkitaan seuraavaksi.

Lähde: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Perusmuotoinen Markovin päätösprosessi asettaa lyhyen aikavälin edun toivottavampien pitkän aikavälin tavoitteiden edelle. Siksi se liitetään yleensä laajempaan vahvistusoppimisen politiikka-arkkitehtuuriin. Siihen kohdistetaan usein rajoittavia tekijöitä, kuten diskontattu palkkio ja muita ympäristömuuttujia, jotka estävät sitä tavoittelemaan välitöntä päämäärää ottamatta huomioon laajempaa toivottua lopputulosta.
Yleisiä käyttötapoja
MDP:n perustason käsite on yleinen sekä koneoppimisen tutkimuksessa että käytännön toteutuksissa. Sitä on ehdotettu esimerkiksi IoT-tietoturvan puolustusjärjestelmiin, kalastukseenja markkinaennusteisiin.
Sen lisäksi, että MDP soveltuu ilmeisellä tavalla shakkiin ja muihin tarkasti peräkkäisiin peleihin, se on luonteva vaihtoehto myös robottijärjestelmien proseduraaliseen opetukseen, kuten alla olevasta videosta nähdään.
9: Termifrekvenssi ja käänteinen dokumenttifrekvenssi
Termifrekvenssi (TF) saadaan jakamalla sanan esiintymiskertojen määrä dokumentissa dokumentin sanojen kokonaismäärällä. Jos esimerkiksi sana sinetti esiintyy kerran tuhannen sanan artikkelissa, sen termifrekvenssi on 0,001. TF on yksinään varsin hyödytön sanan merkityksen mittari, koska vähämerkityksiset englannin sanat, kuten a, and, theja it, hallitsevat esiintymismääriä.
Käänteinen dokumenttifrekvenssi (IDF) pyrkii tuottamaan termille merkityksellisen arvon laskemalla sanan TF:n useista aineiston dokumenteista ja antamalla pienen arvon hyvin yleisille sulkusanoille, kuten artikkeleille. Näin syntyvät ominaisuusvektorit normalisoidaan kokonaisiksi arvoiksi ja jokaiselle sanalle määrätään sopiva paino.

TF-IDF painottaa termien merkitystä niiden useissa dokumenteissa esiintymisen perusteella. Harvinaisempi esiintyminen kertoo merkittävyydestä. Lähde: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Vaikka tämä estää semanttisesti tärkeitä sanoja katoamasta poikkeamahavaintoina, frekvenssipainon kääntäminen ei automaattisesti tarkoita, että harvinainen termi ei olisi poikkeamahavainto, sillä jotkin asiat ovat harvinaisia ja arvottomia. Harvinaisen termin on siis osoitettava arvonsa laajemmassa arkkitehtuurissa esiintymällä useissa aineiston dokumenteissa, vaikka sen esiintymistiheys yksittäisessä dokumentissa olisi pieni.
Huolimatta iästäänTF-IDF on tehokas ja suosittu menetelmä luonnollisen kielen käsittelykehysten alustaviin suodatusvaiheisiin.
Yleisiä käyttötapoja
Koska TF-IDF on ollut ainakin jossakin roolissa Googlen pitkälti salaisen PageRank-algoritmin kehityksessä viimeisten kahdenkymmenen vuoden aikana, siitä on tullut erittäin laajasti käytetty manipuloiva hakukoneoptimoinnin keino huolimatta John Muellerin vuonna 2019 antamasta kiistosta sen merkityksestä hakutuloksille.
PageRankin salaisuuden vuoksi ei ole selvää näyttöä siitä, että TF-IDF ei nykyisin olisi tehokas keino nousta Googlen sijoituksissa. IT-ammattilaisten viimeaikainen kiivas keskustelu viittaa yleiseen käsitykseen, oikeaan tai väärään, että termien väärinkäyttö saattaa yhä parantaa hakukonenäkyvyyttä. Tosin myös syytökset määräävän markkina-aseman väärinkäytöstä ja liiallinen mainonta hämärtävät tämän teorian rajoja.
10: Stokastinen gradienttilaskeutuminen
Stokastinen gradienttilaskeutuminen (SGD) on yhä suositumpi tapa optimoida koneoppimismallien opetusta.
Gradienttilaskeutuminen on menetelmä mallin opetuksen aikana tapahtuvan paranemisen optimointiin ja määrälliseen arviointiin.
Tässä gradientti tarkoittaa alaspäin viettävää kaltevuutta eikä väriliukumaa (katso kuva alla). Vasemmalla olevan mäen korkein kohta kuvaa opetuksen alkua. Tässä vaiheessa malli ei ole vielä nähnyt koko aineistoa kertaakaan eikä oppinut riittävästi aineiston välisistä suhteista tehokkaiden muunnosten tuottamiseen.

Gradienttilaskeutuminen FaceSwapin opetuskerrassa. Kuvasta nähdään, että opetus pysyi tasanteella jonkin aikaa jälkipuoliskolla mutta jatkoi lopulta laskeutumista kohti hyväksyttävää konvergenssia.
Alin kohta oikealla kuvaa konvergenssia eli tilaa, jossa malli on annetuilla rajoituksilla ja asetuksilla niin tehokas kuin mahdollista.
Gradientti toimii tallenteena ja ennusteena virhetason eli aineiston suhteiden mallinnustarkkuuden sekä painojen eli oppimiseen vaikuttavien asetusten välisestä erosta.
Tätä edistymisen tallennetta voidaan käyttää ohjaamaan oppimisnopeuden aikatauluaeli automaattista prosessia, joka ohjaa arkkitehtuuria muuttumaan hienojakoisemmaksi ja tarkemmaksi, kun alkuvaiheen epämääräiset yksityiskohdat muuttuvat selkeiksi suhteiksi ja kuvauksiksi. Gradienttihäviö antaa näin ajantasaisen kartan siitä, mihin opetuksen tulisi edetä ja millä tavalla.
Stokastisen gradienttilaskeutumisen uutuus on mallin parametrien päivittäminen jokaisen opetusesimerkin kohdalla iteraatiota kohti, mikä yleensä nopeuttaa konvergenssia. Erittäin suurten aineistojen yleistyessä SGD:n suosio on kasvanut yhtenä tapana vastata niiden aiheuttamiin logistisiin haasteisiin.
Toisaalta SGD:llä on haitallisia vaikutuksia ominaisuuksien skaalaamiseen, ja se saattaa tarvita tavallista gradienttilaskeutumista useampia iteraatioita saman tuloksen saavuttamiseen. Tämä edellyttää lisäsuunnittelua ja lisää parametreja.
Yleisiä käyttötapoja
Mukautettavuutensa ansiosta ja puutteistaan huolimatta SGD:stä on tullut suosituin neuroverkkojen sovittamisen optimointialgoritmi. Uusissa tekoäly- ja koneoppimistutkimuksissa yleistyvä valinta on Adaptive Moment Estimation -optimoija (ADAM), joka esiteltiin vuonna 2015.
ADAM mukauttaa oppimisnopeutta dynaamisesti kullekin parametrille ja ottaa myös aiempien päivitysten tulokset huomioon seuraavassa kokoonpanossa eli hyödyntää momenttia. Lisäksi siihen voidaan yhdistää uudempia kehityssuuntia, kuten Nesterovin momentti.
Joidenkin mielestä momentin käyttö voi kuitenkin nopeuttaa ADAMin ja vastaavien algoritmien kulkua kohti epäoptimaalista lopputulosta. Kuten suuressa osassa koneoppimistutkimuksen kärkeä, myös SGD:n kehitys on edelleen kesken.
Julkaistu ensimmäisen kerran 10. helmikuuta 2022. Muokattu 10. helmikuuta klo 20.05 EET: muotoilu.


