

AI-mallit ja alustat
SEER: Läpimurto itseohjatuissa konenäkömalleissa

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatFacebookin SEER-malli oppii miljardista satunnaisesta internet-kuvasta ilman merkintöjä…
Näytä lisää
- Facebookin SEER-malli oppii miljardista satunnaisesta internet-kuvasta ilman merkintöjä tai kuratointia.
- Itseohjautuva oppiminen kuten SEER välttää merkityn datan kalliin ja työvoimavaltaisen tarpeen.
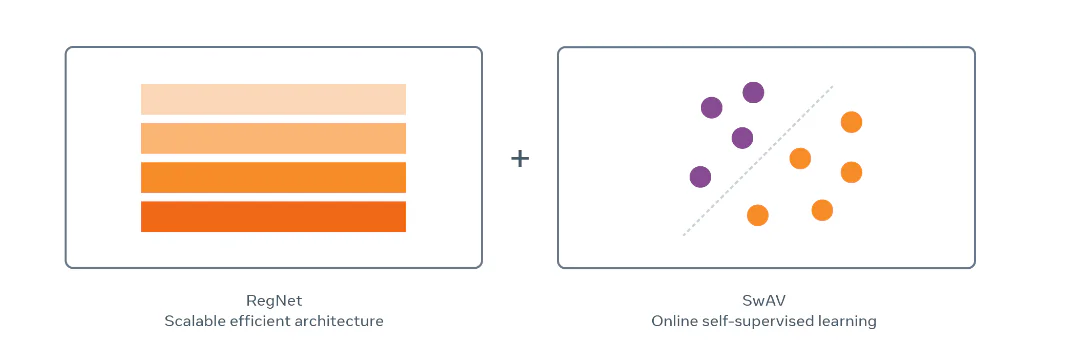
- Malli hyödyntää RegNetY-arkkitehtuuria ja SwAV-klusterointia saavuttaakseen skaalautuvuuden ja tehokkuuden.
Viimeisen vuosikymmenen aikana tekoäly (AI) ja koneoppiminen (ML) ovat edistyneet valtavasti. Nykyään ne ovat tarkempia, tehokkaampia ja kyvykkäämpiä kuin koskaan aiemmin. Nykyaikaiset tekoäly- ja koneoppimismallit voivat tunnistaa esineitä kuvista tai videosta täsmällisesti ja luoda tekstiä ja puhetta, joka vastaa ihmisen älykkyyttä.
Nykyiset tekoäly- ja koneoppimismallit riippuvat voimakkaasti merkitystä koulutusaineistosta, joka opettaa niille, miten tulkita teksti, tunnistaa esineitä kuvista tai videosta ja suorittaa muita tehtäviä.
Vaikka tekoäly- ja koneoppimismallit ovat tehokkaita, ne eivät ole täydellisiä, ja tutkijat pyrkivät kehittämään malleja, jotka voivat oppia ilman merkittyjä tai annotoituja aineistoja. Tämä lähestymistapa tunnetaan itseohjattuna oppimisena, ja se on yksi tehokkaimmista tavoista kehittää koneoppimis- ja tekoälymalleja, joilla on ”arkijärki” tai taustatieto ratkaista ongelmia, jotka ovat nykyisten tekoälymallien ulottumattomissa.
Itseohjattu oppiminen on jo osoittanut tuloksia luonnollisen kielen prosessoinnissa, sillä se on mahdollistanut suurten mallien kouluttamisen valtavalle aineistolle ja johtanut useisiin läpimurtoihin luonnollisen kielen päättelyn, konekääntämisen ja kysymyksiin vastaamisen aloilla.
Facebookin (META ) kehittämä SEER-malli pyrkii maksimoimaan itseohjatun oppimisen mahdollisuuksia konenäön alalla. SEER eli SElf-supERvised on itseohjattu konenäön oppimismalli, jolla on yli miljardi parametriä, ja se pystyy löytämään kuvioita ja oppimaan jopa satunnaisesta internetistä kerätystä kuvajoukosta ilman asianmukaisia annotaatioita tai luokkamerkintöjä.
Itseohjatun oppimisen tarve konenäössä
Aineiston annotointi tai aineiston merkitseminen on esikäsittelyvaihe tekoäly- ja koneoppimismallien kehittämisessä. Aineiston annotointiprosessi tunnistaa raakaa aineistoa, kuten kuvia tai videoframeja, ja lisää aineistoon merkit, jotka määrittävät aineiston kontekstin mallille. Nämä merkinnät mahdollistavat tarkkojen ennusteiden tekemisen aineistosta.
Yksi suurimmista haasteista, joita kehittäjät kohtaavat konenäkömallien kehittämisessä, on laadukkaiden annotoitujen aineistojen löytäminen. Nykyiset konenäön mallit riippuvat näistä merkityistä aineistoista oppiakseen tunnistamaan esineitä kuvista.
Aineiston annotointi ja sen käyttö konenäön malleissa asettavat seuraavat haasteet:
Aineiston laadun hallinta
Todennäköisesti suurin haaste on saada laadukkaita aineistoja jatkuvasti, sillä laadukkaat aineistot, joissa on asianmukaiset merkinnät ja selkeät kuvat, johtavat parempaan oppimiseen ja tarkempiin malleihin. Kuitenkin laadukkaiden aineistojen löytäminen on haasteellista.
Työvoiman hallinta
Aineiston merkitseminen liittyy usein työvoiman hallintaan, sillä suuri määrä työntekijöitä tarvitaan suurten jäsentämättömien ja merkitsemättömien aineistomäärien käsittelyyn ja merkitsemiseen ja laadun varmistamiseen. On tärkeää, että kehittäjät löytävät tasapainon laadun ja määrän välillä aineiston merkitsemisessä.
Taloudelliset rajoitukset
Todennäköisesti suurin haaste on aineiston merkitsemiseen liittyvät taloudelliset rajoitukset, sillä aineiston merkitseminen on usein merkittävä osa koko projektin kustannuksista.
Kuten voidaan nähdä, aineiston annotointi on suuri haaste konenäön mallien kehittämisessä, erityisesti kehittäessä monimutkaisia malleja, jotka vaativat suuria määriä koulutusaineistoa. Tämä on syynä, miksi konenäön teollisuus tarvitsee itseohjattua oppimista kehittääkseen monimutkaisia ja edistyneitä konenäön malleja, jotka pystyvät ratkaisemaan tehtäviä, jotka ovat nykyisten mallien ulottumattomissa.
On jo olemassa useita itseohjattuja oppimismalleja, jotka ovat suorittaneet hyvin kontrolloiduissa ympäristöissä, pääasiassa ImageNet-aineistolla. Vaikka nämä mallit saattavat suoriutua hyvin, ne eivät täytä itseohjatun oppimisen perusvaatimukseen konenäössä: oppia mistä tahansa rajattomasta aineistosta tai satunnaisesta kuvasta, eikä vain tarkasti määritellystä aineistosta. Ihanteellisesti toteutettuna itseohjattu oppiminen voi auttaa kehittämään tarkempia ja kyvykkäämpiä konenäkömalleja, jotka ovat myös kustannustehokkaita ja toteuttamiskelpoisia.
SEER-malli: Johdanto
Viimeaikaiset trendit tekoäly- ja koneoppimisteollisuudessa ovat osoittaneet, että esikoulutuslähestymistavat, kuten puoliohjattu, heikosti ohjattu ja itseohjattu oppiminen, voivat parantaa suorituskykyä useimmissa syvissä oppimismalleissa jatkotehtävissä.
On kaksi tärkeää tekijää, jotka ovat vaikuttaneet näiden syvien oppimismallien suorituskyvyn parantamiseen.
Esikoulutus suurilla aineistoilla
Esikoulutus suurilla aineistoilla johtaa yleensä parempaan tarkkuuteen ja suorituskykyyn, sillä se altistaa mallin laajalle aineistolle. Suuri aineisto mahdollistaa mallin ymmärtää aineistossa olevia kuvioita paremmin, mikä johtaa lopulta siihen, että malli suorittaa paremmin todellisissa tilanteissa.
Jotkut parhaiten suorittavat mallit, kuten GPT-3-kielimalli ja Wav2vec 2.0-puhetunnistusmalli, on koulutettu suurilla aineistoilla. GPT-3-kielimalli käyttää esikoulutusaineistoa, jossa on yli 300 miljardia sanaa, kun taas Wav2vec 2.0-puhetunnistusmalli käyttää aineistoa, jossa on yli 53 000 tuntia äänen aineistoa.
Mallit suurella kapasiteetilla
Mallit, joilla on suurempi määrä parametreja, usein johtavat tarkempiin tuloksiin, sillä suurempi määrä parametreja mahdollistaa mallin keskittyä aineistossa oleviin kohteisiin, jotka ovat välttämättömiä, eikä häiriöihin tai meluun aineistossa.
Kehittäjät ovat aiemmin yrittäneet kouluttaa itseohjattuja oppimismalleja merkitsemättömillä tai kuratoimattomilla aineistoilla, mutta pienemmällä aineistolla, joka sisälsi vain muutaman miljoonan kuvan. Voisivatko itseohjattut oppimismallit johtaa korkeaan tarkkuuteen, kun ne koulutetaan suurella määrällä merkitsemätöntä ja kuratoimatonta aineistoa? Tämä on juuri se kysymys, jonka SEER-malli pyrkii vastaamaan.
SEER-malli on syvä oppimisen kehys, joka pyrkii rekisteröimään internetissä olevia kuvia riippumatta kuratoiduista tai merkityistä aineistoista. SEER-kehys mahdollistaa kehittäjien kouluttaa suuria ja monimutkaisia koneoppimismalleja satunnaisilla aineistoilla ilman valvontaa, eli malli analysoi aineiston ja oppii kuvioita ja tietoa ilman lisättyä manuaalista syöttöä.
SEER-mallin lopullinen tavoite on auttaa kehittämään strategioita esikoulutusprosessiin, joka käyttää kuratoimatonta aineistoa saavuttamaan huipputason suorituskykyä siirtymisoppimisessa. Lisäksi SEER-malli pyrkii luomaan järjestelmiä, jotka voivat jatkuvasti oppia loputtomasta aineistovirrasta itseohjatulla tavalla.
SEER-kehys kouluttaa suurikapasiteettisia malleja miljardien satunnaisista ja rajoittamattomista internetistä poimittujen kuvien avulla. Nämä mallit, jotka on koulutettu näillä kuvilla, eivät riipu kuvien metatiedoista tai annotaatioista koulutuksen aikana, eikä aineistoa suodateta tai kuratoida.
SEER-kehys ja RegNet: Mitä yhteistä?
Analysoitaessa SEER-mallia, se keskittyy RegNet-arkkitehtuuriin, jossa on yli 700 miljoonaa parametriä, mikä on yhtäpitävää SEER-mallin tavoitteen kanssa itseohjatusta oppimisesta kuratoimattomilla aineistoilla kahdesta tärkeästä syystä:
- Ne tarjoavat täydellisen tasapainon suorituskyvyn ja tehokkuuden välillä.
- Ne ovat erittäin joustavia ja voivat skaalautua useiden parametrejen määrään.

SEER-kehys: Aikaisemmat työt eri aloilta
SEER-kehys pyrkii tutkimaan itseohjatun oppimisen rajoja suurten mallirakenteiden kouluttamisessa kuratoimattomilla tai merkitsemättömillä aineistoilla itseohjatulla oppimisella, ja malli hakee inspiraatiota aiemmista töistä alalla.
Valvomaton esikoulutus visuaalisille ominaisuuksille
Itseohjattu oppiminen on jo toteutettu konenäössä menetelmien avulla, jotka käyttävät autoenkoodereita, instanssitason erottelua, tai klusterointia. Viimeaikaisissa tutkimuksissa on osoitettu, että esikoulutusmallit, jotka käyttävät kontrastiivista oppimismenetelmää, voivat suorittaa paremmin kuin valvottu oppiminen jatkotehtävissä.
Visuaalisten piirteiden ohjaamattoman oppimisen tärkein havainto on, että suodatetulla datalla koulutettaessa ohjattuja luokkamerkintöjä ei tarvita. SEER-malli pyrkii tutkimaan, voivatko mallit oppia tarkkoja edustuksia, kun suuria mallirakenteita koulutetaan suurella määrällä kuratoimatonta, merkitsemätöntä ja satunnaisia kuvia.
Visuaalisten ominaisuuksien oppiminen suuressa mittakaavassa
Aikaisemmat mallit ovat hyötyneet esikoulutuksesta suurilla merkityillä aineistoilla heikosti ohjatulla, ohjatulla ja puoliohjatulla oppimisella miljoonien suodatettujen kuvien avulla. Lisäksi mallianalyysi on osoittanut, että esikoulutus suurilla aineistoilla usein johtaa parempaan tarkkuuteen verrattuna koulutukseen alusta alkaen.
Kuitenkin esikoulutus suuressa mittakaavassa usein riippuu aineiston suodatusvaiheista, jotka tekevät kuvat yhtenäisiksi kohdekäsitteiden kanssa. Nämä suodatusvaiheet käyttävät joko ennustuksia esikoulutetusta luokittelijasta tai hashtag-merkintöjä, jotka ovat usein ImageNet-luokkien synonyymejä. SEER-malli toimii eri tavalla, sillä se pyrkii oppimaan ominaisuuksia minkä tahansa satunnaisen kuvan avulla, eikä koulutusaineistoa kuratoida määrättyjen ominaisuuksien tai käsitteiden mukaan.
Kuvatunnistusarkkitehtuurien skaalautuminen
Mallit hyötyvät suurten arkkitehtuuriensa kouluttamisesta paremman laadun visuaalisille ominaisuuksille. On tärkeää kouluttaa suuria arkkitehtuureja, kun esikoulutus suuressa mittakaavassa on tärkeää, sillä malli, jolla on rajoitettu kapasiteetti, usein alisovittuu. Tämä on erityisen tärkeää, kun esikoulutus tehdään kontrastiivisen oppimismenetelmän avulla, sillä malli on oppinut erottamaan aineiston instansseja, jotta se voi oppia paremmin visuaalisia edustuksia.
Kuitenkin kuvatunnistuksen arkkitehtuurin skaalautuminen vaatii enemmän kuin vain syvyyden ja leveyden muuttamista, ja suuren kapasiteetin mallin rakentamiseen vaaditaan paljon kirjallisuutta. SEER-malli osoittaa RegNets-malliperheen hyödyt itseohjatun oppimisen käytössä suuressa mittakaavassa.
SEER: Menetelmät ja komponentit
SEER-kehys käyttää useita menetelmiä ja komponentteja esikoulutuksen aikana visuaalisten edustusten oppimiseen. SEER-kehyksen keskeiset menetelmät ja komponentit ovat RegNet ja SwAV. Tarkastellaan niitä lyhyesti:
Itseohjattu esikoulutus SwAV:llä
SEER-kehys koulutetaan SwAV:llä, joka on online-itseohjattu oppimismenetelmä. SwAV on online-klusterointimenetelmä, jota käytetään kouluttamaan convnets-kehys ilman annotaatioita. SwAV-kehys toimii kouluttamalla upotusta, joka tuottaa klusterin määrityksiä johdonmukaisesti eri näkymien välillä samasta kuvasta. Järjestelmä oppii semanttisia edustuksia etsimällä klustereita, jotka ovat invariantteja datan muokkauksille.
Käytännössä SwAV-kehys vertaa eri näkymien ominaisuuksia niiden itsenäisten klusterin määritysten avulla. Jos nämä määritykset havaitsevat samat tai samanlaiset ominaisuudet, on mahdollista ennustaa yhden kuvan määritys toisen näkymän ominaisuuksien avulla.
SEER-malli käyttää K-klustereita, ja kuhunkin klusteriin liittyy opittava d-ulotteinen vektori vk. Kuvien erässä, joka sisältää B-kuvia, kunkin kuvan i on muunnettu kahteen eri näkymään: xi1 ja xi2. Näkymistä poimitaan sitten piirteet konvoluutioverkolla, ja se johtaa kahteen joukkoon ominaisuuksia: (f11, …, fB2), ja (f12, … , fB2). Kunkin ominaisuusjoukon on määritetty itsenäisesti klusterin määrityksiin Optimal Transport -ratkaisijan avulla.
Optimal Transport -ratkaisija varmistaa, että ominaisuudet jaetaan tasaisesti klustereiden kesken, ja se auttaa välttämään triviaalisia ratkaisuja, joissa kaikki edustukset on kartoitettu yhteen prototyyppiin. Tuloksena oleva määritys on sitten vaihdettu kahden joukon välillä: klusterin määritys yi1 näkymälle xi1 tulee ennustaa käyttäen ominaisuusjoukkoa fi2 näkymälle xi2, ja päinvastoin.
Prototyyppipainot ja convnet on koulutettu vähentämään tappiota kaikille esimerkeille. Klusterin ennustustappio l on käytännössä piirteen f ja prototyyppien pistetuloista lasketun softmax-jakauman ja klusterimäärityksen välinen ristientropia.

RegNetY: Skaalautuva malliperhe
Mallikapasiteetin ja aineiston skaalaaminen vaatii arkkitehtuureja, jotka ovat tehokkaita sekä muistin että ajankäytön suhteen, ja RegNets-kehys on malliperhe, joka on suunniteltu tähän tarkoitukseen.
RegNet-malliperhe on määritelty convnets-arkkitehtuureilla, joissa on 4 vaihetta, ja kussakin vaiheessa on sarja identtisiä blokkeja, ja varmistetaan, että blokin rakenne säilyy kiinteänä, pääasiassa residual-bottleneck-blokin.
SEER-kehys keskittyy RegNetY-arkkitehtuuriin ja lisää Squeeze-and-Excitation-mekanismin RegNets-arkkitehtuuriin parantamaan sen suorituskykyä. Lisäksi RegNetY-mallilla on viisi parametria, jotka auttavat etsimään hyviä instansseja kiinteällä määrällä FLOPs, jotka kuluttavat kohtuullisia resursseja. SEER-malli pyrkii parantamaan tuloksiaan toteuttamalla RegNetY-arkkitehtuurin suoraan itseohjatussa esikoulutustehtävässä.
RegNetY 256GF -arkkitehtuuri: SEER-malli keskittyy pääasiassa RegNetY 256GF -arkkitehtuuriin RegNetY-perheessä, ja sen parametri käyttää RegNets-arkkitehtuurin skaalautumissääntöä. Parametrit on kuvattu seuraavasti.

RegNetY 256GF -arkkitehtuuri on 4-vaiheinen, ja vaiheleveydet ovat (528, 1056, 2904, 7392), ja vaiheiden syvyydet ovat (2,7,17,1), mikä johtaa yli 696 miljoonaan parametriin. Kouluttaessa 512 V100 32GB NVIDIA -näytönohjaimella, kunkin iteraation kestää noin 6125 ms eräkoossa 8 704 kuvaa. Kouluttaessa mallia aineistolla, jossa on yli miljardi kuvaa, eräkoossa 8 704 kuvaa yli 512 GPU:lla, vaaditaan 114 890 iteraatiota, ja koulutus kestää noin 8 päivää.
Optimointi ja koulutus suuressa mittakaavassa
SEER-malli ehdottaa useita sopeutumisia kouluttaa itseohjattuja menetelmiä soveltamaan ja sopeuttaa nämä menetelmät suurella mittakaavalla. Nämä menetelmät ovat:
- Oppimisnopeuden aikataulu.
- Muistin kulutuksen vähentäminen GPU:lla.
- Koulutusnopeuden optimointi.
- Esikoulutusaineiston suuri mittakaava.
Tutustumme niihin lyhyesti.
Oppimisnopeuden aikataulu
SEER-malli tutkii mahdollisuutta käyttää kahta oppimisnopeusaikataulua: kosinimuotoista oppimisnopeusaikataulua ja kiinteää oppimisnopeusaikataulua.
Kosinimuotoinen oppimisnopeus on käytetty vertaamaan eri malleja reilusti, ja se sopeutuu päivitysten määrään. Kuitenkin kosinimuotoinen oppimisnopeus ei sopeudu suurelle mittakaavalle, koska se painottaa kuvia, kun ne nähdään koulutuksen aikana, ja se käyttää täysiä päivityksiä aikatauluttamiseen.
Kiinteä oppimisnopeus pitää oppimisnopeuden kiinteänä, kunnes tappio ei laske, ja sitten oppimisnopeus jaetaan kahdella. Analyysi osoittaa, että kiinteä oppimisnopeus toimii paremmin, koska siinä on enemmän joustavuutta koulutuksen tekemiseen. Kuitenkin, koska malli koulutetaan vain yhdellä miljardilla kuvalla, se käyttää kosinimuotoista oppimisnopeusaikataulua kouluttaessaan suurinta mallia, RegNet 256GF:iä.
Muistin kulutuksen vähentäminen GPU:lla
Malli pyrkii myös vähentämään GPU:n muistikulutusta käyttämällä sekoitettua tarkkuutta ja gradienttien tarkistuspisteytystä. Malli käyttää NVIDIA Apex -kirjaston O1-optimointitason suorittamaan operaatioita, kuten konvoluutioita ja GEMM:ejä, 16-bittisessä liukulukumuodossa. Malli käyttää myös PyTorchin gradient checkpointing -toteutusta, joka säästää muistia lisälaskennan kustannuksella.
Lisäksi malli hylkää eteenpäinlaskennan väliaktivaatiot ja laskee ne uudelleen taaksepäinlaskennan aikana.
Koulutusnopeuden optimointi
Sekoitetun tarkkuuden käyttäminen muistin käytön optimointiin on lisäksi hyödyllistä, koska kiihdyttimet hyötyvät FP16:n pienemmästä koosta verrattuna FP32:een, mikä parantaa läpimenoa muistin kaistanleveyden pullonkaulassa.
SEER-malli synkronoi myös BatchNorm-kerroksen GPU:iden välillä luomalla prosessiryhmät sen sijaan, että käytettäisiin globaalia synkronointia, joka yleensä kestää enemmän aikaa. Lopulta data loader, jota SEER-malli käyttää, hakee enemmän koulutuserää, mikä johtaa suurempaan määrään dataa, joka suoritetaan verrattuna PyTorchin data loaderiin.
Esikoulutusaineisto suuressa mittakaavassa
SEER-malli käyttää yli miljardi kuvaa esikoulutuksessa, ja se käyttää data loaderia, joka ottaa satunnaisia kuvia suoraan internetistä ja Instagramista. Koska SEER-malli kouluttaa nämä kuvat villinä ja online, se ei sovella niille esikäsittelyä eikä kuratoimista prosesseja, kuten de-duplikaatiota tai hashtag-suodatusta.
On huomattava, että aineisto ei ole staattinen, ja aineistossa olevat kuvat päivitetään joka kolmas kuukausi. Kuitenkin aineiston päivittäminen ei vaikuta mallin suorituskykyyn.
SEER-mallin toteutus
SEER-malli kouluttaa RegNetY 256GF:n SwAV:llä kuudella rajauksella kustakin kuvasta: kahdella 224 pikselin ja neljällä 96 pikselin rajauksella. Esikoulutusvaiheessa malli käyttää 3-kerroksista MLP:ä (Multi-Layer Perceptron) projektiopäillä, joiden ulottuvuudet ovat 10444×8192, 8192×8192 ja 8192×256.
Mallin sijaan, että käytettäisiin BatchNorm-kerroksia päässä, SEER-malli käyttää 16 000 prototyyppiä, joiden lämpötila on asetettu 0,1:een. Sinkhorn-säännöstysparametri on asetettu 0,05:een, ja se suorittaa 10 iteraatiota algoritmiin. Malli synkronoi myös BatchNorm-tilastot GPU:iden välillä ja luo useita prosessiryhmiä, kooltaan 64, synkronointia varten.
Lisäksi malli käyttää LARS (Layer-wise Adaptive Rate Scaling) -optimointia, painojen vaimennusta 10-5, aktivaatioiden tarkistuspisteytystä ja O1-sekoitettua tarkkuuden optimointia. Malli koulutetaan stokastisella gradienttilaskeumalla, eräkoossa 8192 satunnaisella kuvalla, jakautuneena 512 NVIDIA GPU:lle, mikä johtaa 16 kuvaa GPU:lle.
Oppimisnopeus nostetaan lineaarisesti 0,15:stä 9,6:een ensimmäisten 8 000 koulutuspäivityksen aikana. Lämmittelyn jälkeen malli seuraa kosinista oppimisnopeusaikataulua, joka laskee loppuarvoon 0,0096. Kaiken kaikkiaan SEER-malli kouluttaa yli miljardi kuvaa 122 000 iteraatiolla.
SEER-kehys: Tulokset
Itseohjatun esikoulutuksen lähestymistavan tuottamien ominaisuuksien laatu tutkitaan ja analysoidaan useilla eri mittareilla ja jatkotehtävissä. Malli ottaa myös huomioon vähäisen esimerkkimäärän asetelmat, joissa on rajoitettu pääsy kuviin ja niiden luokkamerkintöihin jatkotehtävissä.
Suuren esikoulutetun mallin hienosäätö
Mallin mittaa esikoulutetuilla malleilla, jotka on siirretty ImageNet-mittariin objektien luokitteluun. Tulokset suurten esikoulutettujen mallien hienosäätössä määritetään seuraavilla parametreillä.
Kokeelliset asetukset
Malli kouluttaa 6 RegNet-arkkitehtuuria eri kapasiteeteilla, nimittäin RegNetY- {8,16,32,64,128,256}GF, yli miljardin satunnaisen ja julkisen Instagram-kuvan kanssa SwAV:llä. Mallit siirretään sitten hienosäätöä varten kuvien luokitteluun ImageNetissä, joka käyttää yli 1,28 miljoonaa standardikoulutuskuvaa, ja siinä on yli 50 000 kuvan standardivalidointijoukko arviointia varten.
Malli soveltaa samoja datan augmentointitekniikoita kuin SwAV, ja hienosäätöä 35 epookin ajan SGD-optimoinnilla (Stokastinen Gradient Descent) eräkoossa 256:lla, oppimisnopeudella 0,0125, joka pienennetään kymmenesosaan 30 epookin jälkeen, liikemäärällä 0,9 ja painojen vaimennuksella 10-4. Malli raportoi top-1-tarkkuuden validointijoukossa käyttäen keskeltä otettua rajausta 224×224.
Vertailu muihin itseohjattuihin esikoulutuslähestymistapoihin
Seuraavassa taulukossa vertaillaan suurinta esikoulutettua mallia RegNetY-256GF:ä olemassa oleviin esikoulutettuihin malleihin, jotka käyttävät itseohjattua oppimislähestymistapaa.

Kuten voidaan nähdä, SEER-malli palauttaa top-1-tarkkuuden 84,2 %:na ImageNetissä, ja ylittää SimCLRv2:n tuloksen, parhaimman olemassa olevan esikoulutetun mallin, 1 %:lla.
Lisäksi seuraava kuva vertaa SEER-kehystä malleihin, joilla on eri kapasiteetit. Kuten voidaan nähdä, riippumatta mallin kapasiteetista, yhdistämällä RegNet-kehys SwAV:hen, saadaan tarkat tulokset esikoulutuksessa.

SEER-malli on esikoulutettu satunnaisilla kuvilla, ja niissä on RegNet-arkkitehtuuri ja itseohjattu oppimismenetelmä SwAV. SEER-malli vertaillaan SimCLRv2- ja ViT-malleihin, joissa on eri verkkoarkkitehtuureja. Lopulta malli siirretään ImageNet-aineistolle, ja top-1-tarkkuus ilmoitetaan.
Mallin kapasiteetin vaikutus
Mallin kapasiteetilla on merkittävä vaikutus esikoulutuksen suorituskykyyn, ja seuraava kuva vertaa sitä, kun koulutetaan alusta alkaen.

Voidaan selvästi nähdä, että esikoulutettujen mallien top-1-tarkkuus on korkeampi kuin mallien, jotka on koulutettu alusta alkaen, ja ero kasvaa, kun parametreja lisätään. On myös selvää, että vaikka mallin kapasiteetti hyödyttää sekä esikoulutettuja että koulutettuja malleja, vaikutus on suurempi esikoulutetuilla malleilla, kun on kyse suuresta määrästä parametreja.
Mahdollinen syy sille, miksi mallin koulutus alusta alkaen voi johtaa ylioppimiseen, kun koulutetaan ImageNet-aineistolla, on aineiston pieni koko.
Oppiminen vähäisellä esimerkkimäärällä
Oppiminen vähäisellä esimerkkimäärällä tarkoittaa arvioimista SEER-mallin suorituskykyä vähäisen esimerkkimäärän asetelmissa, eli käyttäen vain osaa koko aineistosta kuviin ja niiden luokkamerkintöihin.
Kokeelliset asetukset
SEER-kehys käyttää kahta aineistoa vähäisen esimerkkimäärän oppimiseen: Places205 ja ImageNet. Lisäksi malli olettaa, että on rajoitettu pääsy aineistoon siirtymisoppimisen aikana sekä kuvien että niiden merkintöjen suhteen. Tämä rajoitettu pääsy on erilainen kuin oletusarvoinen asetus itseohjatussa oppimisessa, jossa malli on päässyt koko aineistoon, mutta pääsy kuvien merkintöihin on rajoitettu.
Tulokset Places205-aineistolla
Seuraava kuva osoittaa, miten esikoulutusmalli toimii eri osuuksilla Places205-aineistosta.

Lähestymistapa on verrattu esikoulutukseen ImageNet-aineistolla valvonnassa samalla RegNetY-128 GF -arkkitehtuurilla. Tulokset verrannaisuudesta ovat yllättäviä, sillä voidaan nähdä, että on vakaa voitto noin 2,5 %:n top-1-tarkkuudessa riippumatta siitä, kuinka paljon koulutusaineistoa on käytettävissä hienosäätöä varten Places205-aineistolla.
Ero, joka havaitaan valvotun ja itseohjatun esikoulutuksen välillä, voidaan selittää aineiston luonteen erona, sillä ominaisuudet, jotka malli oppii satunnaisista kuvista, voivat olla sovellettavampia luokitteluun. Lisäksi epäyhtenäinen jakautuminen taustalla olevista käsitteistä voi olla etu esikoulutukselle epätasapainoisella aineistolla, kuten Places205.
Tulokset ImageNetissä

Yllä oleva taulukko vertaa lähestymistapaa SEER-mallissa itseohjattuihin esikoulutuslähestymistapoihin ja puoliohjattuihin lähestymistapoihin vähäisen esimerkkimäärän oppimisessa. On huomattava, että kaikki nämä menetelmät käyttävät kaikkia 1,2 miljoonaa kuvaa ImageNet-aineistosta esikoulutukseen, ja ne rajoittavat vain pääsyn kuvien merkintöihin.
Toisaalta SEER-mallin lähestymistapa sallii sen nähdä vain 1-10 %:n ImageNet-aineistosta. Vaikka verkot ovat nähneet enemmän kuvia samasta jakautumisesta esikoulutuksen aikana, se hyödyttää näitä lähestymistapoja paljon. Mutta mitä on hämmästyttävää, on se, että vaikka SEER-malli näkee vain 1-10 %:n ImageNet-aineistosta, se on silti kykenevä saavuttamaan top-1-tarkkuuden noin 80 %:n, mikä on vain hieman alempi kuin edellä mainittujen lähestymistapojen tarkkuus.
Mallin kapasiteetin vaikutus
Seuraava kuva käsittelee mallin kapasiteetin vaikutusta vähäisen esimerkkimäärän oppimisessa: 1 %, 10 % ja 100 %:ssa ImageNet-aineistosta.

Voidaan nähdä, että kapasiteetin lisääminen voi parantaa mallin tarkkuutta, kun pääsy kuviin ja niiden luokkamerkintöihin vähenee aineistossa.
Siirto muihin mittareihin
Jotta voidaan arvioida SEER-mallin suorituskykyä tarkemmin, esikoulutetut ominaisuudet siirretään muihin jatkotehtäviin.
Kuvanluokittelun lineaarinen arviointi

Yllä oleva taulukko vertaa SEER:n esikoulutetun RegNetY-256GF:n ja RegNetY128-GF:n ominaisuuksia, jotka on esikoulutettu ImageNet-aineistolla samalla arkkitehtuurilla valvonnassa ja ilman valvontaa. Ominaisuuksien laatu arvioidaan jäädyttämällä painot ja käyttämällä lineaarista luokittelijaa ominaisuuksien päällä koulutusjoukkoa jatkotehtävissä. Seuraavat mittarit otetaan huomioon prosessissa: Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) ja Pascal VOC (VOC).
Havaitseminen ja segmentointi
Seuraava kuva vertaa esikoulutettuja ominaisuuksia havaitsemisessa ja segmentoinnissa ja arvioi niitä.

SEER-kehys kouluttaa Mask-RCNN-mallin COCO-mittarilla esikoulutetuilla RegNetY-64GF- ja RegNetY-128GF-malleilla. Molemmat arkkitehtuuri ja jatkotehtävät osoittavat, että SEER:n itseohjattu esikoulutuslähestymistapa ylittää valvotun koulutuksen 1,5-2 AP-pistettä.
Vertailu heikosti ohjattuun esikoulutukseen
Useimmat internetissä olevat kuvat sisältävät metatietoa, kuten alt-tekstiä, kuvauksia tai sijainteja, jotka voivat antaa etua esikoulutuksen aikana. Aikaisemmat tutkimukset ovat osoittaneet, että kuratoidun tai merkityn hashtag-joukon ennustaminen voi parantaa opittujen visuaalisten piirteiden laatua. Tämä lähestymistapa edellyttää kuitenkin kuvien suodattamista ja toimii parhaiten vain silloin, kun tekstimuotoista metatietoa on saatavilla.
Seuraava kuva vertaa ResNetXt101-32dx8d-arkkitehtuurin esikoulutusta satunnaisilla kuvilla saman arkkitehtuurin esikoulutuksella merkityillä kuvilla ja metadataa ja ilmoittaa top-1-tarkkuuden molemmille.

Voidaan nähdä, että vaikka SEER-kehys ei käytä metatietoa esikoulutuksen aikana, sen tarkkuus on vertailukelpoinen malleihin, jotka käyttävät metatietoa esikoulutukseen.
Poistotutkimukset
Poistotutkimus tehdään arvioidakseen tietyn komponentin vaikutusta mallin kokonaisuuteen. Poistotutkimus suoritetaan poistamalla komponentti mallista kokonaan ja ymmärtämällä, miten malli suorittaa. Se antaa kehittäjille yleiskatsauksen komponentin vaikutuksesta mallin suorituskykyyn.
Mallin arkkitehtuurin vaikutus
Mallin arkkitehtuuri vaikuttaa merkittävästi mallin suorituskykyyn, erityisesti, kun mallia skaalataan tai esikoulutusaineiston määrityksiä muutetaan.
Seuraava kuva osoittaa, miten arkkitehtuurin muuttaminen vaikuttaa esikoulutettujen ominaisuuksien laatuun, kun arvioidaan lineaarisesti ImageNet-aineistoa. Ominaisuuksia voidaan tutkia suoraan, koska arviointi ei suosi mallia, joka palauttaa korkean tarkkuuden, kun se on koulutettu alusta alkaen ImageNet-aineistolla.

Voidaan nähdä, että ResNeXts- ja ResNet-arkkitehtuureilla ominaisuudet, jotka saadaan toiseksi viimeisestä kerroksesta, toimivat paremmin nykyisissä asetuksissa. Toisaalta RegNet-arkkitehtuuri ylittää muut arkkitehtuuri.
Kaiken kaikkiaan voidaan todeta, että kapasiteetin lisääminen parantaa ominaisuuksien laatua, ja on logaritminen voitto mallin suorituskyvyssä. On myös selvää, että kapasiteetin lisääminen johtaa suurempaan suorituskykyyn.
Esikoulutusaineiston skaalautuminen
On kaksi pääsyytä, miksi kouluttaminen suuremmalla aineistolla voi parantaa visuaalisten ominaisuuksien laatua, jotka malli oppii: enemmän yksilöllisiä kuvia ja enemmän parametreja. Tutustumme näihin syihin lyhyesti.
Yksilöllisten kuvien määrän lisääminen

Yllä oleva kuva vertaa kahta eri arkkitehtuuria, RegNet8 ja RegNet16, joilla on sama määrä parametreja, mutta ne on koulutettu eri määrällä yksilöllisiä kuvia. SEER-kehys kouluttaa mallit päivityksille, jotka vastaavat yhtä epookkia miljardille kuvalle tai lähdetekstin mukaan 32 epookkia 32 yksilölliselle kuvalle, ja käyttää yhtä kosinin puoliaaltoa noudattavaa oppimisnopeusaikataulua.
Voidaan nähdä, että mallin suorituskyky on parempi, kun sille annetaan enemmän yksilöllisiä kuvia. Tässä tapauksessa malli suorittaa hyvin, kun sille annetaan yksilöllisiä kuvia, enemmän kuin ImageNet-aineistossa on kuvia.
Lisää parametreja
Seuraava kuva osoittaa mallin suorituskyvyn, kun se koulutetaan miljardilla kuvalla RegNet-128GF-arkkitehtuurilla. Voidaan nähdä, että suorituskyky paranee jatkuvasti, kun parametreja lisätään.

Itseohjattu konenäkö todellisissa maailman tilanteissa
Tähän asti olemme käsitelleet, miten itseohjattu oppiminen ja SEER-malli toimivat teoriassa. Nyt katsotaan, miten itseohjattu konenäkö toimii todellisissa maailman tilanteissa, ja miksi SEER on tulevaisuuden itseohjattu konenäkö.
SEER-malli kilpailee työn kanssa, jota on tehty luonnollisen kielen prosessoinnin alalla, jossa huipputason mallit käyttävät lähdetekstin mukaan biljoonia aineistoja ja parametreja sekä biljoonia sanoja tekstiä esikoulutuksessa. Suorituskyky jatkotehtävissä yleensä paranee, kun syötteen aineiston määrää lisätään, ja sama pätee myös konenäön tehtäville.
Mutta itseohjatun oppimisen käyttäminen luonnollisen kielen prosessoinnissa on erilainen kuin itseohjatun oppimisen käyttäminen konenäössä. Se johtuu siitä, että kun käsitellään tekstiä, semanttiset käsitteet jaetaan usein yksittäisiin sanoihin, mutta kun käsitellään kuvia, mallin on päättävä, mihin käsitteeseen kukin pikseli kuuluu.
Lisäksi eri kuvat voivat olla eri näkemyksiä, ja vaikka useat kuvat voivat sisältää saman kohteen, käsite voi vaihdella merkittävästi. Esimerkiksi tietokuvassa, jossa on kissa. Vaikka pääkohteena oleva kissa on yhteinen kaikissa kuvissa, käsite voi vaihdella merkittävästi, kun kissa on seisovassa asennossa yhdessä kuvassa, leikkii pallon kanssa toisessa kuvassa jne. Koska kuvat usein sisältävät vaihtelevia käsitteitä, on tärkeää, että malli näkee suuren määrän kuvia ymmärtääkseen nämä erot saman käsitteen ympärillä.
Onnistuneen mallin skaalautuminen, jotta se toimii tehokkaasti suurten ja monimutkaisten kuvien kanssa, vaatii kaksi komponenttia:
- Konvoluutioneuroverkko (CNN), joka on tarpeeksi suuri oppiakseen visuaaliset käsitteet suurelta kuvien aineistolta.
- Algoritmi, joka voi oppia kuvioita suurelta määrältä kuvia ilman merkintöjä, annotaatioita tai metatietoa.
SEER-malli pyrkii soveltamaan nämä komponentit konenäön alalle. SEER-malli pyrkii hyödyntämään edistystasoa, jonka SwAV on saavuttanut, itseohjatussa oppimisessa, joka käyttää online-klusterointia ryhmitelläkseen tai pariksi kuvat, joilla on rinnakkaiset visuaaliset käsitteet, ja hyödyntääkseen nämä samankaltaisuudet tunnistamaan paremmin kuvioita.
SwAV-arkkitehtuurin avulla SEER-malli pystyy tekemään itseohjatun oppimisen konenäössä paljon tehokkaammaksi ja vähentämään koulutusaikaa jopa 6-kertaisesti.
Lisäksi kouluttaminen suuressa mittakaavassa, tässä mittakaavassa yli miljardi kuvaa, vaatii mallin arkkitehtuurin, joka on tehokas sekä ajassa että muistissa, ja RegNets-mallit ovat ConvNets-malleja, jotka voivat lähdetekstin mukaan skaalautua biljooniin parametreihin ja voidaan optimoida muistirajoitusten ja ajankäytön mukaan.
Johtopäätös: Itseohjattu tulevaisuus
Itseohjattu oppiminen on ollut merkittävä aihe tekoäly- ja koneoppimisteollisuudessa jo jonkin aikaa, koska se mahdollistaa tekoälymallien oppimisen suoraan suurelta määrältä satunnaisesti internetistä löytyvää aineistoa, ilman huolellisesti kuratoiduista ja merkityistä aineistoja, joiden ainoa tarkoitus on kouluttaa tekoälymalleja.
Itseohjattu oppiminen on tärkeä tekoälyn ja koneoppimisen tulevaisuudelle, koska sillä on potentiaalia sallia kehittäjien luoda tekoälymalleja, jotka sopeutuvat hyvin todellisiin maailman tilanteisiin ja joilla on monia käyttötarkoituksia eikä vain yhtä tiettyä tarkoitusta, ja SEER on merkittävä askel itseohjatun oppimisen toteuttamisessa konenäön alalla.
SEER-malli ottaa ensimmäisen askeleen konenäön teollisuuden muuttamiseen ja vähentää riippuvuutta merkityistä aineistoista. SEER-malli pyrkii poistamaan aineiston annotoinnin tarpeen, jolloin kehittäjät voivat työskennellä monipuolisten ja suurten aineistojen kanssa. SEER:n toteutus on erityisen hyödyllinen kehittäjille, joiden mallit käsittelevät aloja, joilla kuvia tai metatietoa on rajallisesti saatavilla, kuten lääketiedettä.
Lisäksi ihmisten tekemien annotaatioiden poistaminen sallii kehittäjien kehittää ja ottaa käyttöön malleja nopeammin, mikä mahdollistaa nopeamman ja tarkemman reagoinnin nopeasti muuttuviin tilanteisiin.


