
AI-mallit ja alustat
Monimodaalinen tekoäly kehittyy: ChatGPT saa näön GPT-4V:n avulla

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Tekoälyn kehittäminen ihmisen kaltaiseksi on jatkuva prosessi, ja OpenAI:n GPT-mallit ovat jatkuvasti venyneet rajojaan. GPT-4 pystyy nyt vastaanottamaan sekä teksti- että kuvapohjaisia syötteitä.
Monimodaalisuus generatiivisessa tekoälyssä tarkoittaa mallin kykyä tuottaa erilaisia tulosteita, kuten tekstiä, kuvia tai ääntä, syötteen perusteella. Nämä mallit, jotka on koulutettu tietyn tyyppisille tiedoille, oppivat piilevät mallit ja tuottavat samankaltaisia uusia tietoja, rikastuttaen tekoälysovelluksia.
Viimeaikaiset edistysaskeleet monimodaalisessa tekoälyssä
Yksi merkittävä askel tässä alalla on DALL-E 3:n integroiminen ChatGPT:hen, merkittävä parannus OpenAI:n teksti-kuvateknologiassa. Tämä yhdistelmä mahdollistaa suljemman vuorovaikutuksen, jossa ChatGPT auttaa luomassa tarkkoja syötteitä DALL-E 3:lle, muuttaen käyttäjien ideat eläviksi tekoälytaiteiksi. Käyttäjät voivat suoraan vuorovaikuttaa DALL-E 3:n kanssa, mutta ChatGPT:n lisääminen prosessiin tekee tekoälytaiteen luomisen paljon käyttäjäystävällisemmäksi.
Lisätietoa DALL-E 3:sta ja sen integroimisesta ChatGPT:hen täältä. Tämä yhteistyö ei ainoastaan näytä monimodaalisen tekoälyn edistymistä, vaan myös tekee tekoälytaiteen luomisesta helppoa käyttäjille.

Google esitteli terveydenhuoltoon keskittyvän Med-PaLM M:n kesäkuussa. Se on monimodaalinen generatiivinen malli, joka on taitava koodaamaan ja tulkitsemaan erilaisia biolääketieteellisiä tietoja. Tämä saavutettiin hienosäätämällä PaLM-E-kielimallia, jotta se soveltuisi lääketieteellisiin aloihin avoimen lähdekoodin mittauksella, MultiMedBenchillä. Tämä mittaus koostuu yli miljoonasta näytteestä seitsemästä biolääketieteellisestä tietotyypistä ja 14 tehtävästä, kuten lääketieteellisistä kysymyksistä ja röntgenraporttien luomisesta.
Monet eri alat omaksuvat innovatiivisia monimodaalisia tekoälytyökaluja liiketoiminnan laajentamiseen, prosessien sujuvoittamiseen ja asiakasviestinnän parantamiseen. Ääni-, video- ja tekstitekoälyn edistysaskeleet ajavat monimodaalisen tekoälyn kasvua.
Yritykset etsivät monimodaalisia tekoälysovelluksia, jotka voivat uudistaa liiketoimintamalleja ja prosesseja, avaamalla kasvumahdollisuuksia koko generatiivisen tekoälyekosysteemin läpi, aina tietotyökaluista uusiin tekoälysovelluksiin.
GPT-4:n julkaisun jälkeen maaliskuussa jotkut käyttäjät huomasivat, että sen vastauslaatu heikkeni ajan myötä, mikä on huolenaihe, jota myös merkittävät kehittäjät ja OpenAI:n foorumit ovat korostaneet. Aluksi OpenAI hylkäsi tämän, mutta myöhempi tutkimus vahvisti ongelman. Se paljasti, että GPT-4:n tarkinheitko laski 97,6 prosentista 2,4 prosenttiin maaliskuun ja kesäkuun välillä, osoittaen, että vastauslaatu heikkeni mallin päivitysten myötä.

ChatGPT (sininen) & tekoäly (punainen) Google-hakutrendi
Open AI:n ChatGPT:n ympärillä vallitseva kohu on taas täällä. Se tulee nyt näkökyvyn ominaisuudella GPT-4V, joka mahdollistaa GPT-4:lle kuvien analysoinnin. Tämä on uusin ominaisuus, joka on avattu käyttäjille.
Kuvien analysoinnin lisääminen suuriin kielimalleihin (LLM) kuten GPT-4 on jotain, mitä jotkut pitävät suurena askelena tekoälyn tutkimuksessa ja kehittämisessä. Tällainen monimodaalinen LLM avaa uusia mahdollisuuksia, vie kielimallit tekstistä eteenpäin ja tarjoaa uusia käyttöliittymiä ja ratkaisee uusia tehtäviä, luoden käyttäjille uusia kokemuksia.
GPT-4V:n koulutus valmistui vuonna 2022, ja varhainen pääsy avattiin maaliskuussa 2023. GPT-4V:n visuaalinen ominaisuus perustuu GPT-4-teknologiaan. Koulutusprosessi säilyi samana. Aluksi malli koulutettiin ennustamaan seuraavaa sanaa tekstissä valtavalla teksti- ja kuvatietojoukolla eri lähteistä, mukaan lukien internet.
Myöhemmin se hienosäädettiin lisätietojen avulla, käyttäen vahvistusoppimisesta palautetta (RLHF) -menetelmää, jotta se tuottaisi sellaisia tuloksia, joita ihmiset pitävät miellyttävinä.
GPT-4:n näkökyvyn mekaniikka
GPT-4:n merkittävät visuaaliset kielitaidot, vaikka vaikuttavat, perustuvat pinnan alla oleviin menetelmiin.
Tutkimalla tätä hypoteesia, esiteltiin uusi visuaalinen kielimalli, MiniGPT-4, joka hyödyntää edistynyttä LLM:ää nimeltä Vicuna. Tämä malli käyttää visuaalista koodaajaa, jossa on esikoulutetut komponentit visuaaliselle havainnolle, ja se koodaa visuaaliset piirteet Vicuna-kielimallin kanssa yhden projektiokerroksen kautta. MiniGPT-4:n arkkitehtuuri on yksinkertainen mutta tehokas, ja se keskittyy visuaalisten ja kielten ominaisuuksien kohdistamiseen visuaalisen vuorovaikutuksen parantamiseksi.
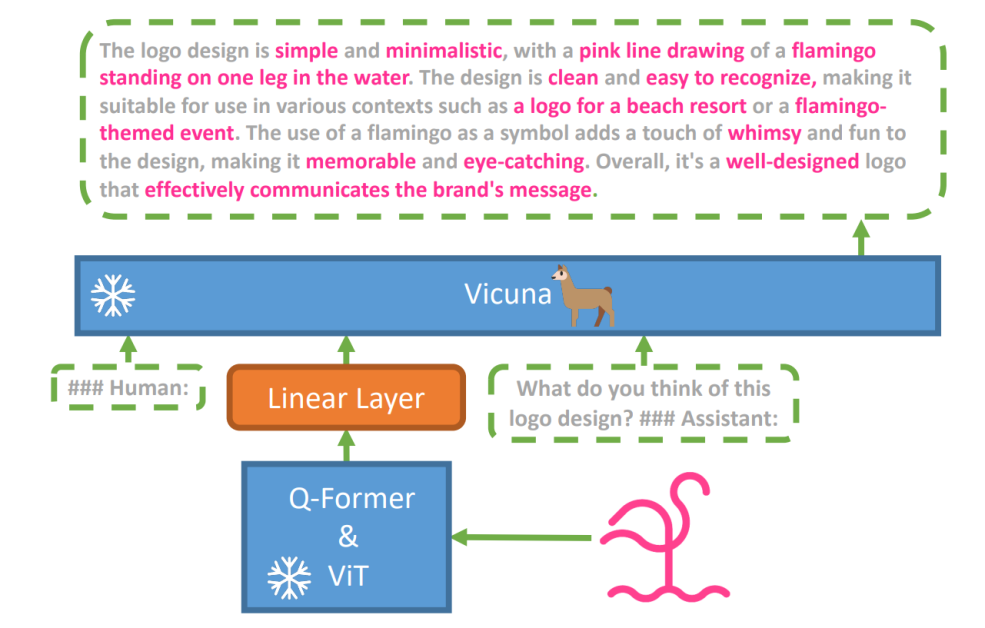
MiniGPT-4:n arkkitehtuuri sisältää visuaalisen koodaajan, jossa on esikoulutetut ViT- ja Q-Former-komponentit, yhden lineaarisen projektiokerroksen ja edistyneen Vicuna-kielimallin.
Autoregressiivisten kielimallien trendi visuaalisissa tehtävissä on myös kasvanut, hyödyntäen cross-modaalista siirtymää tietojen jakamiseen kielen ja monimodaalisten alojen välillä.
MiniGPT-4 siltaa visuaalisen ja kielten alojen välillä kohdistamalla visuaalista tietoa esikoulutetusta visuaalisesta koodaajasta edistyneeseen LLM:ään. Malli käyttää Vicunaa kielidekooderina ja seuraa kaksivaiheista koulutuslähestymistapaa. Aluksi se koulutetaan suurella kuvatekstipareja sisältävällä tietojoukolla, jotta se ymmärtäisi visuaalisen kielen tiedot, ja sitten se hienosäätetään pienemmällä, laadukkaammalla tietojoukolla, jotta se parantaisi tulosten luotettavuutta ja käytettävyyttä.
Parantamaan MiniGPT-4:ssä generoidun kielen luonnollisuutta ja käytettävyyttä, tutkijat kehittivät kaksivaiheisen kohdistusprosessin, joka ratkaisi visuaalisen kielen kohdistamisen puutteen. He loivat erityisen tietojoukon tätä tarkoitusta varten.
Aluksi malli generoi yksityiskohtaisia kuvauksia syötteenä annetuista kuvista, ja se paransi yksityiskohtaisuutta käyttämällä Vicuna-kielimallin muotoon sopivaa vuorovaikutusohjetta. Tämä vaihe pyrki tuottamaan kattavampia kuvauksia.
Alkuperäinen kuvauksenvaihe:
###Ihminen: <Kuva><Kuvan ominaisuus></Kuva>Kuvaa tätä kuvaa yksityiskohtaisesti. Kerro kaikki yksityiskohdat. Kerro kaikki mitä näet. ###Avustaja:
Tiedon jälkikäsittelyssä korjattiin mahdolliset epäjohdonmukaisuudet tai virheet generoiduissa kuvauksissa käyttäen ChatGPT:tä, ja sitten manuaalinen verifiointi varmisti korkean laadun.
Toisen vaiheen hienosäätöohje:
###Ihminen: <Kuva><Kuvan ominaisuus></Kuva><Ohje>###Avustaja:
Tämä tutkimus avaa ikkunan ymmärtämään monimodaalisen generatiivisen tekoälyn, kuten GPT-4:n, mekaniikkaa, ja valottaa, miten visuaalinen ja kielten modaalit voidaan tehokkaasti yhdistää, jotta voidaan generoida yhtenäisiä ja kontekstuaalisesti rikkaita tulosteita.
GPT-4:n näkökyvyn tutkiminen
Kuvien alkuperän määrittäminen ChatGPT:n avulla
GPT-4:n näkökyky parantaa ChatGPT:n kykyä analyysoida kuvia ja määrittää niiden maantieteellinen alkuperä. Tämä ominaisuus siirtää käyttäjien vuorovaikutuksen pelkästä tekstistä teksti- ja visuaalisen sisällön yhdistelmään, ja se on kätevä työkalu niille, jotka ovat uteliaita eri paikoista kuvatietojen kautta.

Kysymys ChatGPT:ltä, missä maamerkki on kuvattu
Monimutkaiset matemaattiset käsitteet
GPT-4:n näkökyky erottuu siinä, että se pystyy syventymään monimutkaisiin matemaattisiin käsitteisiin analysoimalla graafisia tai käsin kirjoitettuja ilmaisuja. Tämä ominaisuus on hyödyllinen työkalu niille, jotka haluavat ratkaista monimutkaisia matemaattisia ongelmia, ja se tekee GPT-4:n näkökyvystä merkittävän apuvälineen koulutuksessa ja akateemisissa piireissä.

Kysymys ChatGPT:ltä monimutkaisen matemaattisen käsitteen ymmärtämisestä
Käsin kirjoitettujen syötteiden muuntaminen LaTeX-koodiksi
Yksi GPT-4V:n merkittävimmistä ominaisuuksista on sen kyky kääntää käsin kirjoitetut syötteet LaTeX-koodiksi. Tämä ominaisuus on erityisen hyödyllinen tutkijoille, akateemikoille ja opiskelijoille, jotka usein tarvitsevat muuttaa käsin kirjoitetut matemaattiset ilmaisut tai tekniset tiedot digitaaliseen muotoon. Käsin kirjoitettujen ja LaTeX-koodin välisen muunnoksen ansiosta asiakirjojen digitalisointi laajenee, ja teknisen kirjoittamisen prosessi yksinkertaistuu.

GPT-4V:n kyky muuttaa käsin kirjoitetut syötteet LaTeX-koodiksi
Taulukoiden yksityiskohtien poimiminen
GPT-4V osoittaa taituruutta taulukoiden yksityiskohtien poimimisessa ja niihin liittyvien kysymysten ratkaisemisessa, mikä on tärkeä apuväline data-analyysissä. Käyttäjät voivat hyödyntää GPT-4V:tä taulukoiden läpikäymiseen, avainhuomiosten keräämiseen ja kysymysten ratkaisemiseen, mikä tekee siitä vahvan työkalun data-analyytikoille ja muille ammattilaisille.

GPT-4V ymmärtää taulukoiden yksityiskohdat ja vastaa niihin liittyviin kysymyksiin
Visuaalisen osoittamisen ymmärtäminen
GPT-4V:n ainutlaatuinen kyky ymmärtää visuaalista osoittamista lisää uuden ulottuvuuden käyttäjien vuorovaikutukseen. Visuaalisten vihjeiden ymmärtämisen kautta GPT-4V voi vastata kysymyksiin kontekstuaalisella ymmärryksellä.

GPT-4V osoittaa ainutlaatuista kykyä ymmärtää visuaalista osoittamista
Yksinkertaisten mock-up -sivustojen luominen piirroksen avulla
Innoittuneena tästä viestistä, yritin luoda unite.ai-sivuston mock-upin.
Vaikka lopputulos ei täysin vastannut alkuperäistä visiotaani, tässä on saavutettu tulos.

ChatGPT Vision -pohjainen HTML-etusivu
GPT-4V(ision) -ominaisuuden rajoitukset ja virheet
GPT-4V:n analysointiin Open AI:n tiimi suoritti laadullisia ja määrällisiä arvioita. Laadullisiin arvioihin kuului sisäiset testit ja ulkoisten asiantuntijoiden arviot, kun taas määrälliset arviot mitättiin mallin kieltäytymisiä ja tarkinheitkoja eri skenaarioissa, kuten haitallisen sisällön tunnistamisessa, demografioiden tunnistamisessa, yksityisyyskysymyksissä, geolokalisoinnissa, kyberturvallisuudessa ja monimodaalisissa vankilajärjestelmissä.
Kuitenkin malli ei ole täydellinen.
Tutkimus korostaa GPT-4V:n rajoituksia, kuten virheellisiä johtopäätöksiä ja puuttuvia tekstejä tai merkkejä kuvissa. Se voi luulla tai kekstiä tosiasioita. Erityisesti se ei sovellu vaarallisten aineiden tunnistamiseen kuvissa, usein tunnistamatta niitä väärin.
Lääketieteellisissä kuvissa GPT-4V voi antaa epäjohdonmukaisia vastauksia ja puuttuu tietämystä lääketieteellisistä käytännöistä, mikä voi johtaa mahdollisiin väärään diagnoosiin.

Epäluotettava suoritus lääketieteellisissä tarkoituksissa (Lähde)
Se ei myöskään ymmärrä tiettyjen viharikosten symboleja ja voi tuottaa sopimatonta sisältöä visuaalisten syötteiden perusteella. OpenAI neuvoo vastaan käyttämästä GPT-4V:tä kriittisissä tulkinnassa, erityisesti lääketieteellisissä tai arkaluontoisissa yhteyksissä.
Yhteenveto

Luotu Fast Stable Diffusion XL:llä https://huggingface.co/spaces/google/sdxl
GPT-4 Vision (GPT-4V) -ominaisuuden saapuminen tuo joukon uusia mahdollisuuksia ja uusia haasteita. Ennen sen julkaisua on tehty paljon työtä riskien, erityisesti kuvissa esiintyvien henkilöiden, minimointiin. On vaikuttavaa nähdä, miten GPT-4V on edennyt, osoittaen paljon lupaavia piirteitä haastavilla aloilla, kuten lääketieteessä ja tieteessä.
Nyt on suuria kysymyksiä esillä. Esimerkiksi, pitäisikö nämä mallit pystyä tunnistamaan kuuluisia henkilöitä kuvista? Pitäisikö ne arvata henkilön sukupuolta, rotua tai tunteita kuvan perusteella? Ja pitäisikö olla erityisiä säätöjä avustamaan näkövammaisia? Nämä kysymykset avaavat kanin kolon yksityisyydestä, reiluudesta ja siitä, miten tekoäly tulisi sovittaa elämäämme, ja siitä, mistä kaikki tulisi olla osa.


