
AI-mallit ja alustat
Mistral AI: Asettaa uudet mittapuut avoimessa lähdekoodin tilassa

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Suuret kielen mallit (LLM) ovat viime aikoina nousseet keskiöön, kiitos esimerkiksi ChatGPT:n. Kun Meta esitteli Llama-mallejaan, se herätti uuden kiinnostuksen avoimia LLM-malleja kohtaan. Tavoitteena on luoda edullisia, avoimia LLM-malleja, jotka ovat yhtä hyviä kuin huipputason mallit, kuten GPT-4, mutta ilman kalliita kustannuksia tai monimutkaisuutta.
Tämä edullisuuden ja tehokkuuden yhdistelmä avasi uusia mahdollisuuksia tutkijoille ja kehittäjille, ja loi uuden aikakauden teknologisen kehityksen luonnollisen kielen prosessoinnissa.
Viime aikoina generatiivisen tekoälyn startup-yritykset ovat menestyneet rahoituksessa. Yhdessä keräsi 20 miljoonaa dollaria, tavoitteenaan muodostaa avoimia tekoälymalleja. Anthropic keräsi vaikuttavan 450 miljoonan dollarin sijoituksen, ja Cohere, joka on yhteistyössä Google Cloudin kanssa, keräsi 270 miljoonaa dollaria kesäkuussa tänä vuonna.
Johdanto Mistral 7B:in

Mistral AI, joka on perustettu Pariisiin ja jonka perustajat ovat Google DeepMindin ja Metan entisiä työntekijöitä, ilmoitti ensimmäisestä suuresta kielen mallistaan: Mistral 7B. Tätä mallia voi ladata kuka tahansa GitHubista tai 13,4-gigatavun torrentin kautta.
Tämä startup onnistui keräämään ennätyksellisen suuren alkurahoituksen ennen kuin heillä oli tuotetta markkinoilla. Mistral AI:n ensimmäinen malli, jossa on 7 miljardia parametriä, ylittää Llama 2 13B:n suorituskyvyn kaikissa testeissä ja Llama 1 34B:n useissa mittareissa.
Vertailussa muihin malleihin, kuten Llama 2:een, Mistral 7B tarjoaa samanlaisia tai parempia ominaisuuksia vähemmällä laskennalllisella kuormalla. Perusmallit, kuten GPT-4, voivat saavuttaa enemmän, mutta ne ovat kalliimpia ja vähemmän käyttäjäystävällisiä, koska ne ovat pääasiassa saatavilla API:n kautta.
KoodausTehtävissä Mistral 7B antaa CodeLlama 7B:lle vastaavan suorituskyvyn. Lisäksi se on riittävän kompakti, 13,4 GB, juostaakseen standardikoneilla.
Lisäksi Mistral 7B Instruct, joka on säätelty erityisesti ohjausaineistoille Hugging Facen kanssa, on osoittanut erinomaista suorituskykyä. Se ylittää muita 7B-malleja MT-Benchillä ja on tasavertainen 13B-keskustelumallejen kanssa.

Hugging Face Mistral 7B Esimerkki
Suorituskyvyn vertailu
Yksityiskohtaisessa suorituskyvyn analyysissä Mistral 7B mitattiin Llama 2 -mallien kanssa. Tulokset olivat selvät: Mistral 7B ylittää merkittävästi Llama 2 13B:n kaikissa mittareissa. Se vastaa erityisesti Llama 34B:n suorituskykyä, erityisesti koodi- ja päättelymittareissa.
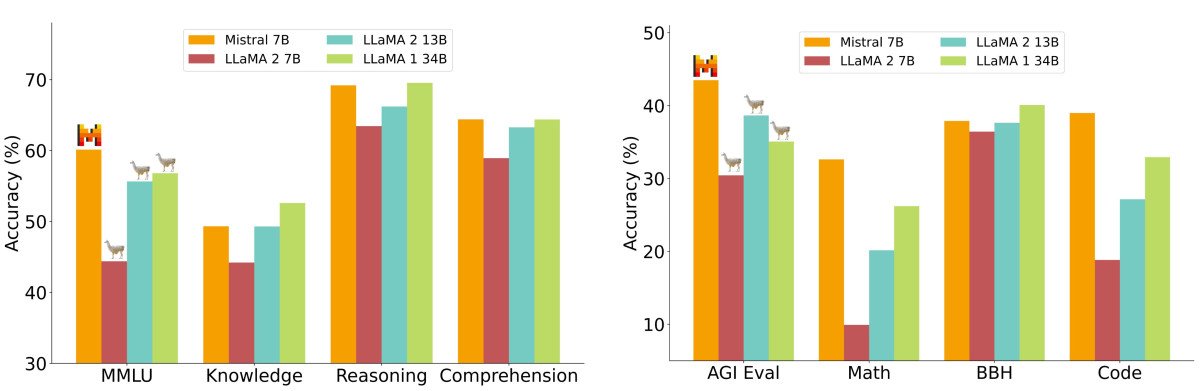
Mittaukset jaettiin useisiin luokkiin, kuten yleinen älykkyys, maailman tietäminen, lukemisen ymmärtäminen, matematiikka ja koodi. Erityisen merkittävä havainto oli Mistral 7B:n kustannus-suorituskyky-mittari, jota kutsutaan “vastineen mallikoko”. Päättely- ja ymmärtämisalueilla Mistral 7B osoitti suorituskykyä, joka vastaa Llama 2 -mallia, joka on kolme kertaa suurempi, mikä merkitsee mahdollista muistin säästöä ja suorituskyvyn parantamista. Kuitenkin tietomittauksissa Mistral 7B oli linjassa Llama 2 13B:n kanssa, mikä johtunee sen parametrirajoituksista, jotka vaikuttavat tietojen pakkaamiseen.
Mikä tekee Mistral 7B -mallista paremman kuin useimmat muut kielen mallit?
Yksinkertaistamalla huomiomekanismit
Huomiomekanismin yksityiskohdat ovat teknisiä, mutta perusidea on suhteellisen yksinkertainen. Kuvittele lukemista ja tärkeiden lauseiden korostamista; tämä on vastaavaa, miten huomiomekanismit “korostavat” tai antavat tärkeyden tiettyihin datakohtiin järjestyksessä.
Kielen mallien kontekstissa nämä mekanismit mahdollistavat mallille keskittyä tärkeimpiin osiin syöteaineistosta, varmistaen, että tuloste on yhtenäinen ja kontekstuaalisesti tarkka.
Standarditransformaatoreissa huomioarvot lasketaan kaavalla

Transformers Attention Formula
kaavaan liittyy tärkeä askel – Q- ja K-matriisin matriisikertolasku. Haaste tässä on, että kun järjestyksen pituus kasvaa, molemmat matriisit laajenevat vastaavasti, johtaen laskennallisesti vaativaan prosessiin. Tämä skaalautuvuusongelma on yksi pääsyy, miksi standarditransformaatort on hitaampi, erityisesti kun käsitellään pitkiä järjestyksiä.

Monikysymyshuomio (MQA) nopeuttaa asioita käyttämällä yhtä “avain-arvo” -päitä, mutta toisinaan uhraa laadun. Nyt voit ihmetellä, miksi ei yhdistä MQA:n nopeutta monipäisen huomion laatuun? Siinä kohtaa tulee Ryhmitelty kysymyshuomio (GQA).
Ryhmitelty kysymyshuomio (GQA)

Ryhmitelty kysymyshuomio
GQA on välimuoto. Sen sijaan, että käytettäisiin vain yhtä tai useita “avain-arvo” -päitä, se ryhmittelee ne. Tällä tavoin GQA saavuttaa suorituskyvyn, joka on lähellä yksityiskohtaista monipäistä huomiota, mutta MQA:n nopeudella. Malleille, kuten Mistral, tämä tarkoittaa tehokasta suorituskykyä ilman liian suurta laadun uhraamista.
Liukuvan ikkunan huomio (SWA)

Liukuvan ikkunan menetelmä on toinen tapa prosessoida huomiojärjestyksiä. Tämä menetelmä käyttää kiinteän kokoista huomioikkunaa kunkin tokenin ympärillä järjestyksessä. Useiden kerrosten pinoutuessa tällainen ikkunallinen huomio antaa lopulta yleiskuvan koko syöteaineistosta. Tämä mekanismi on vastaava kuin konvoluutioneuraaliverkkoihin (CNN) havaittavat reseptorikentät.
Toisaalta Longformer-mallin “dilatoitu liukuvan ikkunan huomio” laskee vain muutaman -matriisin diagonaaleja. Tämä muutos johtaa muistiin käytön kasvamiseen lineaarisesti eikä neliöllisesti, mikä tekee siitä tehokkaamman menetelmän pidempien järjestyksien käsittelyyn.
Mistral AI:n läpinäkyvyys vs. turvallisuus huolenaiheita hajauttamisessa
Mistral AI korosti ilmoituksessaan läpinäkyvyyttä seuraavasti: “Ei temppuja, ei omistaja-aineistoja.” Mutta samalla heidän ainoa saatavilla oleva malli tällä hetkellä, ‘Mistral-7B-v0.1’, on esikoulutettu perusmalli, joten se voi generoida vastauksen mihin tahansa kysymykseen ilman moderointia, mikä herättää potentiaalisia turvallisuus huolenaiheita. Vaikka mallit, kuten GPT ja Llama, ovat mekanismeja, jotka havaitsevat, milloin vastata, Mistralin täysin hajautettu luonne voi olla hyväksikäytettävissä pahantahtoisille toimijoille.
Kuitenkin suurten kielen mallien hajauttaminen on myös ansioita. Vaikka jotkut voivat väärinkäyttää sitä, ihmiset voivat hyödyntää sen voimaa yhteiskunnalliseen hyvään ja tehdä älymystä kaikkien saataville.
Toimeenpanon joustavuus
Yksi korkeista ominaisuuksista on, että Mistral 7B on saatavilla Apache 2.0 -lisenssillä. Tämä tarkoittaa, että siihen ei ole oikeudellisia esteitä – olit sitten henkilökohtainen käyttäjä, suuri yritys tai jopa hallituksen virasto. Sinun tarvitsee vain oikea järjestelmä ajaa sitä, tai sinun on ehkä sijoitettava pilviresursseihin.
Vaikka on olemassa muita lisenssejä, kuten yksinkertaisempi MIT-lisenssi ja yhteisöllinen CC BY-SA-4.0, joka edellyttää kunnioitusta ja samanlaista lisenssiä johdannaisille, Apache 2.0 tarjoaa vankkan perustan suurten hankkeiden toteuttamiseen.
Lopputuletukset
Avoimien suurten kielen mallien, kuten Mistral 7B, nousu merkitsee ratkaisevaa muutosta tekoälyteollisuudessa, ja se tekee korkealaatuiset kielen mallit laajemmin saataville. Mistral AI:n innovatiiviset lähestymistavat, kuten Ryhmitelty kysymyshuomio ja Liukuvan ikkunan huomio, lupaavat tehokasta suorituskykyä ilman liian suurta laadun uhraamista.
Vaikka Mistralin hajautettu luonne asettaa tiettyjä haasteita, sen joustavuus ja avoimen lähdekoodin lisenssi korostavat mahdollisuuksia tekoälyn demokratisoimiseksi. Kun maisema kehittyy, fokus siirtyy vääjämättä tasapainottamaan näiden mallien voimaa eettisillä huomioilla ja turvallisuusmekanismeilla.
Mistralin seuraava askel? 7B-malli oli vasta alku. Tiimi aikoo lansia vielä suurempia malleja pian. Jos nämä uudet mallit vastaavat 7B-mallin suorituskykyä, Mistral voi nousta nopeasti alan johtavaksi toimijaksi, kaiken kaikkiaan ensimmäisen vuoden aikana.


