
Andersonin kulma
Liimaako DALL-E 2 vain asioita yhteen ymmärtämättä niiden suhteita?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Keskeiset kohdatDALL-E 2 ei kykene toistamaan perustason spatiaalisia suhteita, kuten 'sisällä' tai…
Näytä lisää
- DALL-E 2 ei kykene toistamaan perustason spatiaalisia suhteita, kuten 'sisällä' tai 'päällä', tuottamissaan kuvissa.
- Vain 22 prosenttia DALL-E 2:n kuvista vastasi niiden kehotteita 169 osallistujan tutkimuksessa.
- Järjestelmän suhteellisuusvirheet pahenevat, kun harjoitusdatasta puuttuu esimerkkejä kuvatusta tapahtumasta.
Harvardin yliopiston uusi tutkimus viittaa siihen, että OpenAI:n otsikoihin noussut tekstistä kuviksi -järjestelmä DALL-E 2: lla on merkittäviä vaikeuksia jopa vauvojen ymmärtämien suhteiden toistamisessa sen koostamissa kuvissa, huolimatta monien tuotoksien loistavasta sofistikoitumisesta.
Tutkijat suorittivat käyttäjätutkimuksen, johon osallistui 169 joukkoistettua osallistujaa, jotka esiteltiin DALL-E 2: n kuvia, jotka perustuivat ihmisen perustaviin suhteita koskevan semantiikan periaatteisiin, yhdessä tekstikehotteilla, jotka loivat ne. Kun kysyttiin, ovatko kehotteet ja kuvat liittyneitä, alle 22 %: lla kuvista katsottiin olevan merkityksellisiä niiden liittyviin kehotteisiin nähden, jopa hyvin yksinkertaisissa suhteissa, joita DALL-E 2: ta pyydettiin visualisoimaan.

Kuvakaappaus uuden tutkimuksen kokeista. Osallistujien tehtävänä oli valita kaikki kehotetta vastaavat kuvat. Käyttöliittymän alareunan huomautuksesta huolimatta kaikki kuvat oli todellisuudessa tuotettu näytetystä kehotteesta, mitä osallistujat eivät tienneet. Lähde: https://arxiv.org/pdf/2208.00005.pdf
Tulokset osoittavat myös, että DALL-E: n ilmeinen kyky yhdistää erilaisia elementtejä saattaa vähentyä, kun nämä elementit ovat vähemmän todennäköisiä tapahtuvan järjestelmän todellisessa koulutusaineistossa.
Esimerkiksi kuvat kehotteelle “lapsi koskettaa kulhoa” saivat 87 %: n vastaavuuden (ts. osallistujat klikkasivat useimmat kuvat merkityksellisiksi kehotteeseen nähden), kun taas samanlaiset fotorealistiset renderöinnit “apina koskettaa iguaania” saivat vain 11 %: n vastaavuuden:

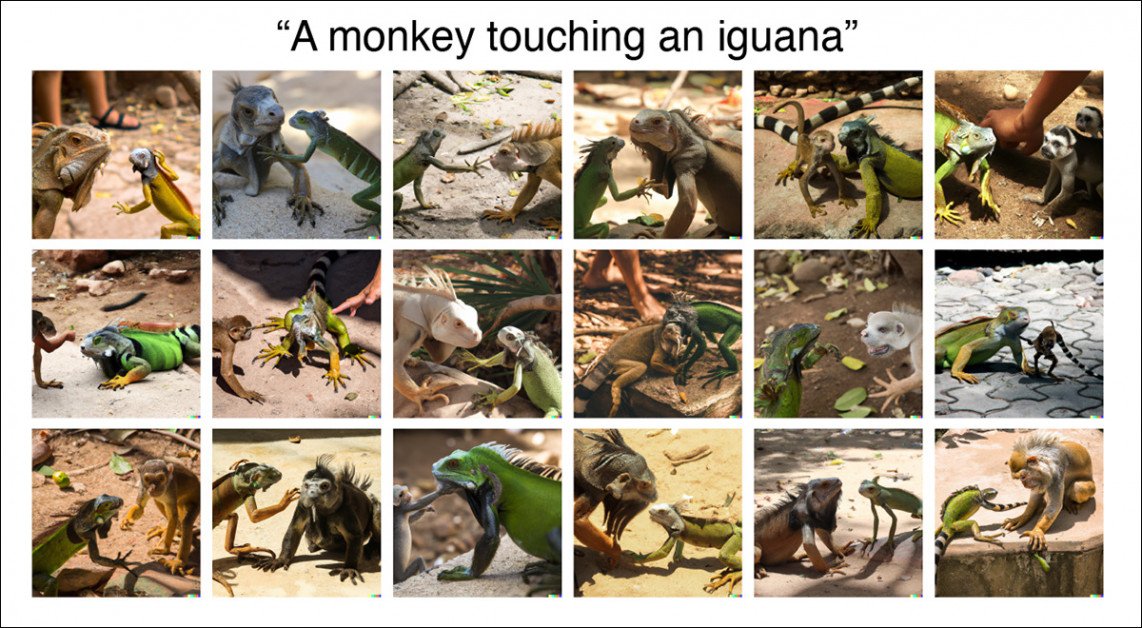
DALL-E 2: n vaikeus kuvata epätodennäköistä tapahtumaa ‘apina koskettaa iguaania’, joka johtunee siitä, että se ei ole yleinen, tai mahdollisesti ei ole olemassa koulutusaineistossa.
Toisessa esimerkissä DALL-E 2 usein tekee virheitä koossa ja jopa lajissa, luultavasti johtuen aineiston puutteesta, joka esittää tätä tapahtumaa. Sen sijaan on luonnollista odottaa suuren määrän koulutusvalokuvia, jotka liittyvät lapsiin ja ruokaan, ja että tämä alaluokka on hyvin kehittynyt.
DALL-E: n vaikeus yhdistää voimakkaasti kontrastisia kuvaelementtejä osoittaa, että yleisö on tällä hetkellä niin lumottu järjestelmän fotorealistisista ja laajasti tulkittavista kyvyistä, ettei ole kehittänyt kriittistä silmää tapauksiin, joissa järjestelmä on käytännössä vain liimannut yhden elementin irrallisesti toisen päälle, kuten näissä esimerkeissä virallisen DALL-E 2: n sivustolta:
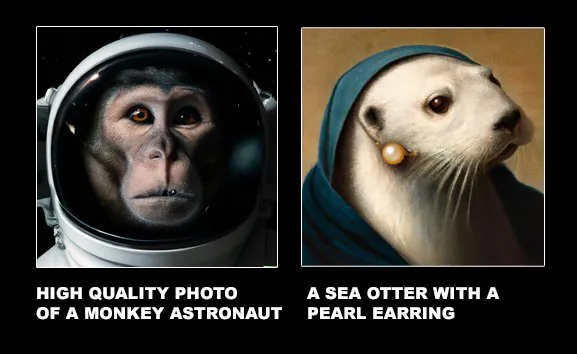
Leikkaa ja liimaa -synteesi viralliselta DALL-E 2: n sivustolta. Lähde: https://openai.com/dall-e-2/
Uusi tutkimus toteaa*:
‘Suhteiden ymmärtäminen on ihmisälykkyyden olennainen osa, joka ilmenee varhain kehityksessä ja jota muodostetaan nopeasti ja automaattisesti havainnoinnissa.
‘DALL-E 2: n vaikeus jopa perustason tilasuhteissa (kuten sisällä, päällä, alla) osoittaa, että se ei ole oppinut edes sellaisia edustuksia, jotka sallivat ihmisille joustavan ja luotettavan maailman jäsentämisen.
‘Tämän vaikeuden suora tulkinta on, ettei DALL-E 2:n kaltaisilla järjestelmillä vielä ole kykyä muodostaa kokonaisuuksia ymmärtämällä niiden osien välisiä suhteita.’
Tutkijat ehdottavat, että teksti-ohjattujen kuvien generointijärjestelmiä, kuten DALL-E-sarjaa, voitaisiin parantaa hyödyntämällä algoritmeja, jotka ovat yleisiä robotiikassa, jotka mallintavat identiteettejä ja suhteita samanaikaisesti, johtuen siitä, että agentin on todella oltava vuorovaikutuksessa ympäristön kanssa sen sijaan, että se vain tuottaisi sekoituksen erilaisista elementeistä.
Toinen lähestymistapa, joka on nimeltään CLIPort, käyttää samaa CLIP-mekanismia, jota käytetään laadun arvioinnissa DALL-E 2: ssä:
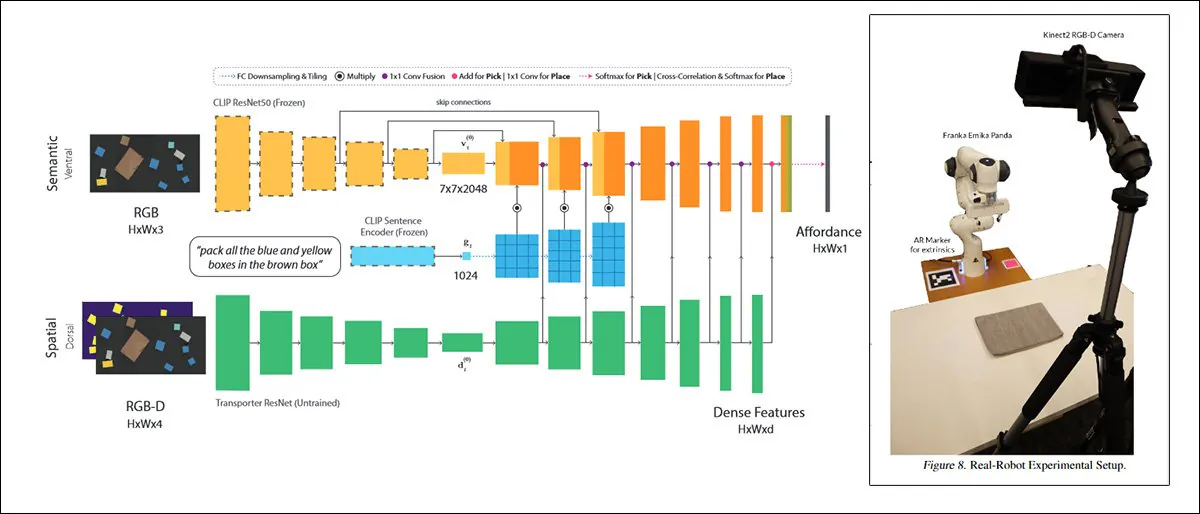
CLIPort, Washingtonin yliopiston ja NVIDIAn vuoden 2021 yhteistyöhanke, käyttää CLIP: iä käytännöllisessä asiayhteydessä, jossa järjestelmien on opittava ymmärtämään fyysisiä suhteita. Tämä kannustin puuttuu DALL-E 2:sta ja muista ‘fantastisista’ kuvasynteesijärjestelmistä. Lähde: https://arxiv.org/pdf/2109.12098.pdf
Tutkijat ehdottavat myös, että “toinen uskottava parannus” voisi olla kuvasynteesijärjestelmien, kuten DALL-E:n, arkkitehtuuriin lisättäisiin multiplikatiivisia vaikutuksia yhteen laskentakerrokseen. Näin suhteita voitaisiin laskea biologisten järjestelmien tiedonkäsittelykyvyn innoittamalla tavalla.
Uusi tutkimus on nimeltään Testing Relational Understanding in Text-Guided Image Generation, ja se on tehty Colin Conwellin ja Tomer D. Ullmanin toimesta Harvardin yliopiston psykologian laitoksella.
Ylittämällä varhaisen kritiikin
Komentoiden DALL-E 2: n realismin ja eheyyden taikatemppua, tutkijat mainitsevat aiemmat tutkimukset, jotka ovat havainneet puutteita DALL-E-tyyppisissä generatiivisissa kuvajärjestelmissä.
Kesäkuussa tämän vuoden aikana, UoC Berkeley huomautti DALL-E: n vaikeuden käsittelyssä heijastuksia ja varjoja; samassa kuussa, Etelä-Korean tutkimus tutki DALL-E 2 -tyyppisen tuotoksen “yksilöllisyyttä” ja alkuperäisyyttä kriittisellä silmällä; alustava analyysi DALL-E 2 -kuvista, pian julkaisun jälkeen, NYU: n ja Texasin yliopiston toimesta, osoitti useita ongelmia koostumisessa ja muissa DALL-E 2 -kuvien olennaisissa tekijöissä; ja viime kuussa, yhteistyö Illinoisin yliopiston ja MIT: n välillä tarjosi ehdotuksia arkkitehtuurin parantamiseksi näissä järjestelmissä koostumisen suhteen.
Tutkijat mainitsevat myös, että DALL-E: n kehittäjät, kuten Aditya Ramesh, ovat myöntäneet järjestelmän ongelmat ominaisuuksien sitomisessa kohteisiin, suhteellisessa koossa, tekstissä ja muissa haasteissa.
Google:n kilpailevan kuvasynteesijärjestelmän Imagen kehittäjät ovat ehdottaneet DrawBench -vertailujärjestelmää, joka arvioi kuvan tarkkuutta eri järjestelmissä erilaisin mittarein.
Sen sijaan uuden tutkimuksen tekijät ehdottavat, että parempi tulos saataisiin, jos ihmisten arvioita käytettäisiin algoritmisten keskinäismittareiden sijaan syntyneiden kuvien arviointiin, jotta voidaan määrittää, missä heikkoudet ovat ja mitä voitaisiin tehdä niiden korjaamiseksi.
Tutkimus
Tutkimuksessa tutkijat perustivat lähestymistapansa psykologisiin periaatteisiin ja pyrkivät vetäytymään nykyisestä kiinnostuksen aallosta promptin suunnittelussa (joka on käytännössä myöntymys DALL-E 2: n puutteista, tai vastaavaa järjestelmää), tutkimaan ja mahdollisesti osoittamaan rajoituksia, jotka tekevät nämä kiertotavat välttämättömiksi.
Tutkimus toteaa:
‘Tämä työ keskittyy joukkoon 15 perussuhdetta, jotka on aiemmin kuvattu, tutkittu tai ehdotettu kognitiivisessa, kehityksellisessä tai kielellisessä kirjallisuudessa. Joukko sisältää sekä konkreettisia tilasuhteita (kuten ’X on Y: llä’) että abstraktimpia toimijoiden välisiä suhteita (kuten ’X auttaa Y: tä’).
‘Kutsut on tarkoituksella yksinkertaisia, ilman attribuutin monimutkaisuutta tai yksityiskohtaisuutta. Eli emme käytä kehotetta kuten ’aasi ja mustekala pelaavat peliä. Aasi pitää köyden toisesta päästä ja mustekala toisesta. Aasi pitää köyttä suussaan. Kissa hyppää köyden yli’, vaan ’laatikko on veitsen päällä’.
‘Yksinkertaisuus edelleen sisältää laajan valikoiman suhteita eri alueilta ihmisen psykologiasta, ja tekee mahdolliseksi potentiaalisen mallin epäonnistumisen selkeäksi ja spesifiseksi.’
Tutkijat rekrytoivat 169 osallistujaa Prolificista, kaikki Yhdysvalloissa, keski-iän ollessa 33, ja 59 % naisia.
Osallistujat esiteltiin 18 kuvaa, jotka oli järjestetty 3×6 -ruudukkoon, kehote yläreunassa ja varoitus alareunassa, jossa sanottiin, että kaikki, jotkut tai mikään kuvista eivät välttämättä olleet generoituja näytetystä kehotteesta, ja heidät pyydettiin valitsemaan kuvat, jotka he kokivat liittyvän tähän tapaan.
Kuvat, jotka esiteltiin yksilöille, perustuivat kielellisiin, kehityksellisiin ja kognitiivisiin kirjallisuuteen, ja koostuivat kahdeksasta fyysisestä ja seitsemästä “agenteista” suhteesta (tämä tulee selvemmäksi hetken kuluttua).
Fyysiset suhteet
sisällä, päällä, alla, peittäen, lähellä, peitettynä, roikkuu yläpuolella, ja sidottu siihen.
Toimijoiden väliset suhteet
työntää, vetää, koskettaa, lyö, potkaisee, auttaa, ja estää.
Kaikki nämä suhteet perustuivat aiemmin mainittuihin muihin kuin tietojenkäsittelytieteellisiin tutkimusaloihin.
Kaksitoista entiteettiä johdettiin kehotteiden käyttöön, kuusi objektia ja kuusi agenttia:
Objektit
laatikko, sylinteri, peitto, kulho, teekuppi, ja veitsi.
Agentit
mies, nainen, lapsi, robotti, apina, ja iguaani.
(Tutkijat myöntävät, että iguaanin sisällyttäminen, joka ei ole keskeinen osa kuivaa sosiologista tai psykologista tutkimusta, oli hauska lisä)
Jokaiselle suhteelle luotiin viisi erilaista kehotetta satunnaistamalla kaksi entiteettiä viisi kertaa, mikä johti 75 yhteensä kehotteeseen, joista jokainen esitettiin DALL-E 2: lle, ja joista jokaiselle annettiin 18 alkuperäistä kuvaa, ilman muutoksia tai toista yritystä.
Tulokset
Tutkimus toteaa*:
‘Osallistujat ilmoittivat keskimäärin vähäistä vastaavuutta DALL-E 2: n kuvien ja kehotteiden välillä, keskiarvon ollessa 22,2 % [18,3, 26,6] 75 erillisen kehotteen yli.
‘Toimijoiden suhteita kuvaavat kehotteet, joilla oli keskiarvo 28,4 % [22,8, 34,2] 35 kehotteen yli, tuottivat suuremman vastaavuuden kuin fyysiset kehotteet, joilla oli keskiarvo 16,9 % [11,9, 23,0] 40 kehotteen yli.’

Tutkimuksen tulokset. Pisteet mustalla osoittavat kaikki kehotteet, ja väri erottaa, onko kutsu agenteja vai fyysistä (ts. objektia).
Vertailemaan eroa ihmisen ja algoritmisen näkemyksen välillä kuvissa, tutkijat suorittivat renderöinnit OpenAI: n avoimen lähdekoodin ViT-L/14 CLIP-pohjaisella kehykkeellä. Keskiarvon laskemisen jälkeen he löysivät “kohtalaisen suhteen” kahden tuloksen joukon välillä, mikä on ehkä yllättävää, ottaen huomioon, kuinka paljon CLIP itse auttaa kuvien generoimisessa.

CLIP (ViT-L/14) -vertailun tulokset ihmisten vastauksiin.
Tutkijat ehdottavat, että muut mekanismit arkkitehtuurissa, ehkä yhdistettynä sattumaan tai puutteeseen koulutusaineistossa, voivat selittää, miten CLIP voi tunnistaa DALL-E: n rajoitukset ilman, että se pystyy aina tekemään paljon sen parantamiseksi.
Tutkijat päättelevät, että DALL-E 2: lla on vain nimellinen kyky tuottaa kuvia, jotka sisältävät suhdeymmärryksen, joka on perustava osa ihmisen älykkyyttä, joka kehittyy meissä hyvin varhain.
‘Se, että järjestelmät kuten DALL-E 2 eivät kykene kompositionaalisuuteen, voi tulla yllätyksenä kenelle tahansa, joka on nähnyt DALL-E 2: n vaikuttavat vastaukset kehotteisiin kuten ’sarjakuva pienestä daikon-retiisistä balettihameessa ulkoiluttamassa villakoiraa’. Kutsut kuten nämä usein tuottavat järkevän approksimaation koostumiskäsitteestä, jossa kaikki kehotteen osat ovat läsnä ja oikeassa paikassa.
‘Kompositionaalisuus ei kuitenkaan tarkoita vain kykyä liimata asioita yhteen, vaikka niitä ei olisi koskaan nähty yhdessä. Kompositionaalisuus edellyttää niiden sääntöjen ymmärtämistä, jotka sitovat asiat yhteen. Suhteet ovat tällaisia sääntöjä.’
Mies puraisee T-Rexiä
Mielipide OpenAI:n avatessa DALL-E 2:n yhä suuremmalle käyttäjäjoukolle sen viimeaikaisen beta-monetisoinnin jälkeen, ja koska nyt on maksettava useimpien generointien osalta, DALL-E 2: n suhdeymmärryksen puutteet saattavat tulla ilmi, kun jokainen “epäonnistunut” yritys on taloudellisesti painava, eikä korvauksia ole saatavilla.
Nämä, jotka saivat kehotteen hieman aikaisemmin, ovat ehtineet tarkastella järjestelmää ja heillä oli viime aikoihin asti myös enemmän vapautta kokeilla sitä, ja ovat havainneet joitakin “suhdevirheitä”, joita DALL-E 2 voi tuottaa.
Esimerkiksi Jurassic Park -fani voi havaita, että on hyvin vaikea saada dinosauruksen jahtaamaan henkilöä DALL-E 2: ssä, vaikka käsite “jahtaa” ei näytä olevan DALL-E 2: n sensuurijärjestelmässä, ja vaikka dinosaurusten pitkä historia elokuvissa pitäisi tarjota runsaasti koulutusaineistoa (ainakin trailerien ja mainoskuvien muodossa) tälle muuten mahdottomalle kohtaamiselle lajien välillä.
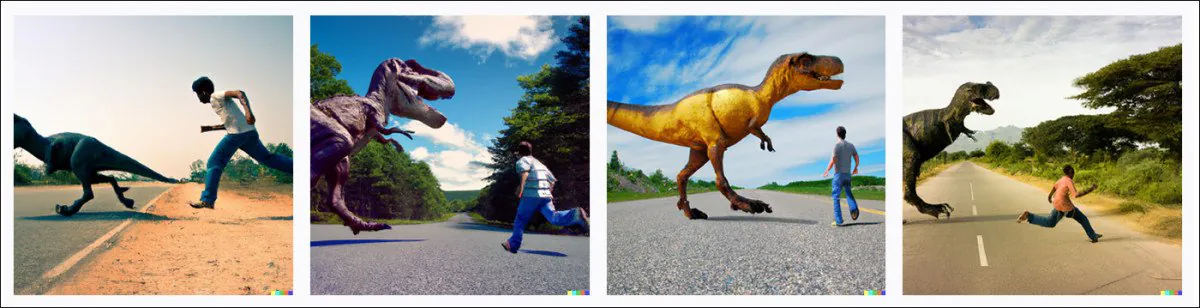
Tyypillinen DALL-E 2 -vastaus kehotteelle ‘Värikuvaa T-Rexin jahtaamasta miestä tiellä’. Lähde: DALL-E 2
Olen löytänyt, että yllä olevat kuvat ovat tyypillisiä muunnelmille «[dinosaurus] jahtaa [ihmistä]» -kehotteeseen, ja että mikään kehotteen yksityiskohtaisuus ei voi saada T-Rexiä tottelemaan. Ensimmäisessä ja toisessa kuvassa mies (melko) jahtaa T-Rexiä; kolmannessa hän lähestyy sitä turvallisuudesta piittaamatta; ja viimeisessä kuvassa hän juoksee rinnakkain suuren pedon kanssa. Noin 10-15 yrityksellä tämän teeman parissa olen löytänyt, että dinosaurus on yhtä lailla hajamielinen vastaavalla tavalla.
On mahdollista, että ainoa koulutusaineisto, johon DALL-E 2 pystyi käyttämään, oli «mies taistelee dinosauruksen kanssa», vanhempien elokuvien mainoskuvista, kuten One Million Years B.C. (1966), ja että Jeff Goldblumin kuuluisa pakoretki kuningaspedon luota on yksittäinen poikkeama siinä pienessä aineistossa.
* Minun muunnos tutkijoiden sisäisistä viittauksista hyperlinkkeihin.
Julkaistu ensimmäisen kerran 4. elokuuta 2022.





