Andersonin kulma
Mistä tietää, tuottavatko kuvasynteesijärjestelmät aidosti omaperäistä materiaalia

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Keskeiset kohdatKAISTin ja NAVERin Rarity Score mittaa kuvan omaperäisyyttä lähimpien naapurien…
Näytä lisää
- KAISTin ja NAVERin Rarity Score mittaa kuvan omaperäisyyttä lähimpien naapurien etäisyyksien avulla.
- Olemassa olevat mittarit, kuten Truncation Trick, suosivat aitoutta uutuuden sijaan generoiduissa kuvissa.
- Rarity Score voisi tunnistaa todella kekseliäitä tuotoksia järjestelmistä, kuten DALL-E 2.
Eteläkorealainen tutkimus ehdottaa menetelmää sen selvittämiseksi, tuottavatko kuvasynteesijärjestelmät aidosti uusia kuvia vai vain vähäisiä muunnelmia koulutusaineistosta. Jälkimmäinen voisi vesittää tällaisten arkkitehtuurien tavoitteen tuottaa uusia ja omaperäisiä kuvia.
Tutkimuksen mukaan jälkimmäinen on hyvin usein totta, koska koulutuksen aikana generointikykyä parantavat nykyiset mittarit suosivat väistämättä kuvia, jotka ovat suhteellisen lähellä aineiston aitoja lähdekuvia.
Jos generoitu kuva on visuaalisesti lähellä lähdeaineistoa, se saa todennäköisesti paremman arvion aitoudesta kuin omaperäisyydestä: se on uskollinen lähteelle, vaikkei kovin kekseliäs.
Alalla, jonka oikeudelliset seuraukset ovat sen nuoruuden vuoksi vielä epäselviä, tästä voi tulla merkittävä oikeudellinen kysymys, jos kaupallistettu synteettinen kuvamateriaali ei eroa riittävästi usein tekijänoikeudella suojatusta lähdeaineistosta, jonka nykyisin sallitaan levitä tutkimukseen suosittujen verkosta kerättyjen aineistojen muodossa. Tällaisten tulevien loukkausvaatimusten mahdollisuus on noussut esiin melko äskettäin Microsoftin GitHub Co-Pilot -tekoälyn yhteydessä.
OpenAI:n DALL-E 2, Googlen Imagen ja kiinalainen CogView sekä vaatimattomampi DALL-E mini tuottavat yhä yhtenäisempiä ja semanttisesti johdonmukaisempia kuvia. Niiden tuotosten omaperäisyyden luotettavaan testaamiseen on kuitenkin hyvin vähän jälkikäteisiä keinoja.
Suosituimpien uusien DALL-E 2 -kuvien hakeminen johtaa hakukoneesta riippuen usein vain saman kuvan muihin kopioihin.

Kokonaisen yhdeksän DALL-E 2 -kuvan ryhmän lataaminen johtaa vain uusiin vastaaviin ryhmiin, koska ruudukkorakenne on hallitsevin piirre. Ensimmäisen kuvan erottaminen ja lataaminen (tästä Twitter-julkaisusta 8. kesäkuuta 2022, Weird Dall-E Generations -tililtä) saa Googlen keskittymään kuvan koripalloon ja johtaa kuvahaun semanttiseen umpikujaan. Saman kuvan kohdalla Yandex näyttää sentään todella purkavan pikselirakennetta ja vertaavan piirteitä.
Yandex käyttää Googlea todennäköisemmin kuvan varsinaisia piirteitä eli kuvasta johdettuja tai laskettuja ominaisuuksia, ei välttämättä ihmisten kasvonpiirteitä, ja visuaalisia eikä semanttisia ominaisuuksia etsiessään samankaltaisia kuvia. Kaikilla kuvahakukoneilla on silti jonkinlaisia tavoitteita tai käytäntöjä, jotka voivat vaikeuttaa lähde>generoitu-plagioinnin tunnistamista verkkohauilla.
Generatiivisen mallin koulutusaineisto ei myöskään välttämättä ole kokonaan julkinen, mikä vaikeuttaa tuotosten alkuperäisyyden tutkintaa entisestään.
Kun yhdellä Googlen Imagen-sivuston synteettisistä kuvista tehdään kuvahaku, Google ei löydä kuvan aiheeseen verrattavaa sisältöä katsomalla kuvaa ja etsimällä puolueettomasti samankaltaisia kuvia. Se on jälleen kiinnittynyt merkityssisältöön: tämän Imagen-kuvan hakua ei voi tehdä puhtaasti kuvapohjaisesti ilman, että hakusanoiksi lisätään rajoittava parametri «imagen google»:

Yandex puolestaan löytää runsaasti samankaltaisia tai ainakin visuaalisesti liittyviä todellisen maailman kuvia harrastajataiteilijoilta:

Olisi parempi, jos kuvasynteesijärjestelmien tuotosten uutuutta tai omaperäisyyttä voisi mitata ilman piirteiden poimimista jokaisesta verkossa olleesta kuvasta mallin koulutushetkellä tai suljetuista aineistoista, joissa voi olla tekijänoikeudella suojattua sisältöä.
Korea Advanced Institute of Science and Technologyn Kim Jaechul Graduate School of AI -yksikön (KAIST AI) tutkijat ovat tähän liittyen kehittäneet maailmanlaajuisen ICT- ja hakuyhtiö NAVER Corpin kanssa harvinaisuuspisteytyksen (Rarity Score), joka voi auttaa tunnistamaan kuvasynteesijärjestelmien omaperäisemmät tuotokset.

Kuvat on generoitu StyleGAN-FFHQ:lla. Sarakkeet etenevät vasemmalta oikealle huonoimmista parhaisiin tuloksiin. Truncation trick -mittarilla ja realismimittarilla on omat painotuksensa, kun taas uusi harvinaisuuspisteytys (ylärivi) etsii yhtenäisiä mutta omaperäisiä kuvia pelkän yhtenäisyyden sijaan. Artikkelin kuvakokorajoitusten vuoksi tarkemmat ja suuremman resoluution tulokset kannattaa katsoa alkuperäisestä tutkimuksesta. Lähde: https://arxiv.org/pdf/2206.08549.pdf
Uusi tutkimus on nimeltään Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images (Harvinaisuuspisteytys: uusi mittari synteettisten kuvien epätavallisuuden arviointiin), ja sen tekijöinä on kolme KAISTin ja kolme NAVER Corpin tutkijaa.
Halpaa temppua pidemmälle
Uusi tutkimus pyrkii parantamaan aiempia mittareita, joihin kuuluu brittiläisen Heriot-Watt-yliopiston ja Googlen DeepMindin yhteistyössä vuonna 2019 ehdottama Truncation trick.
Truncation trick käyttää näytteenotossa eri latenttia jakaumaa kuin generatiivisen mallin koulutuksessa.
Menetelmän kehittäjät yllättyivät sen toimivuudesta, mutta myöntävät alkuperäisessä tutkimuksessa, että se vähentää tuotosten monimuotoisuutta. Silti siitä on tullut tehokas ja suosittu tapa saada aidolta näyttäviä tuloksia. Sitä voisi kutsua halvaksi tempuksi: tulokset eivät todella omaksu kaikkia aineiston mahdollisuuksia ja saattavat muistuttaa lähdeaineistoa toivottua enemmän.
Uuden tutkimuksen tekijät toteavat:
«Menetelmän tarkoitus ei ole generoida koulutusaineistojen harvinaisia näytteitä vaan syntetisoida tyypillisiä kuvia vakaammin. Oletamme, että nykyiset generatiiviset mallit voisivat tuottaa todellisen aineistojakauman kannalta rikkaampia näytteitä, jos generaattori saataisiin tuottamaan tehokkaasti harvinaisia näytteitä.»
Perinteisiä mittareita, kuten Frechet Inception Distancea (FID), joka joutui voimakkaan kritiikin kohteeksi joulukuussa 2021, inception scorea (IS) ja Kernel Inception Distancea (KID) käytetään yleisesti generatiivisen mallin koulutuksen edistymismittareina. Tekijät kommentoivat tätä edelleen*:
«Tämä oppimistapa ohjaa generaattoria olemaan tuottamatta paljon harvinaisia, omaleimaisia ja vahvapiirteisiä näytteitä, joiden osuus aitojen kuvien jakaumasta on pieni. Julkisten aineistojen harvinaisia näytteitä ovat esimerkiksi erilaisia asusteita käyttävät ihmiset FFHQ-aineistossa, AFHQ:n valkoiset eläimet ja Metfacesin epätavalliset patsaat.
«Kyky generoida harvinaisia näytteitä on tärkeä paitsi siksi, että se liittyy generatiivisten mallien äärirajoihin, myös siksi, että ainutlaatuisuudella on merkitystä luovissa sovelluksissa, kuten virtuaali-ihmisissä.
«Monien viimeaikaisten tutkimusten laadulliset tulokset sisältävät kuitenkin harvoin näitä harvinaisia esimerkkejä. Arvelemme, että vastakkaisen oppimisen luonne pakottaa generoitujen kuvien jakauman muistuttamaan koulutusaineiston jakaumaa. Selvästi yksilöllisten tai harvinaisten kuvien osuus mallien tuotoksista jää siten pieneksi.»
Menetelmä
Tutkijoiden uusi harvinaisuuspisteytys soveltaa aiemmissa töissä esitettyä ajatusta: K:n lähimmän naapurin menetelmän (KNN) käyttöä kuvaamaan kuvasynteesijärjestelmän aitojen koulutusnäytteiden ja synteettisten tuotosten joukkoja.
Tekijät esittävät uudesta analyysimenetelmästä:
«Oletamme tavallisten näytteiden olevan lähellä toisiaan, kun taas ainutlaatuiset ja harvinaiset näytteet sijaitsevat piirreavaruudessa harvassa.»
Yllä oleva tuloskuva esittää lähimmän naapurin etäisyydet (NND) pienimmästä suurimpaan StyleGAN-arkkitehtuurissa, joka on koulutettu FFHQ-aineistolla.
«Kaikissa aineistoissa pienimmän NND:n näytteet ovat edustavia ja tyypillisiä kuvia. Suurimman NND:n näytteet puolestaan ovat hyvin yksilöllisiä ja poikkeavat merkittävästi pienimmän NND:n tyypillisistä kuvista.»
Teoriassa generatiivista järjestelmää voisi ohjata puhtaasta jäljittelystä kekseliäämmäksi käyttämällä uutta mittaria erottelijana tai osana monimutkaisempaa erottelija-arkkitehtuuria. Samalla voitaisiin säilyttää uskottavan kuvantuotannon kannalta tärkeiden käsitteiden yhtenäisyys, kuten mies, nainen, auto, kirkko ja niin edelleen.
Vertailut ja kokeet
Tutkijat vertasivat kokeissa harvinaisuuspisteytyksen suorituskykyä Truncation trickiin ja NVIDIAn vuoden 2019 realismipisteytykseen. He havaitsivat, että lähestymistapa pystyi erottamaan ainutlaatuisia tuloksia useissa arkkitehtuureissa ja aineistoissa.
Tutkimuksen tulokset ovat liian laajat tähän sisällytettäviksi, mutta tutkijat näyttävät osoittaneen menetelmän tunnistavan harvinaisuutta sekä aidoissa lähdekuvissa että generoiduissa kuvissa:
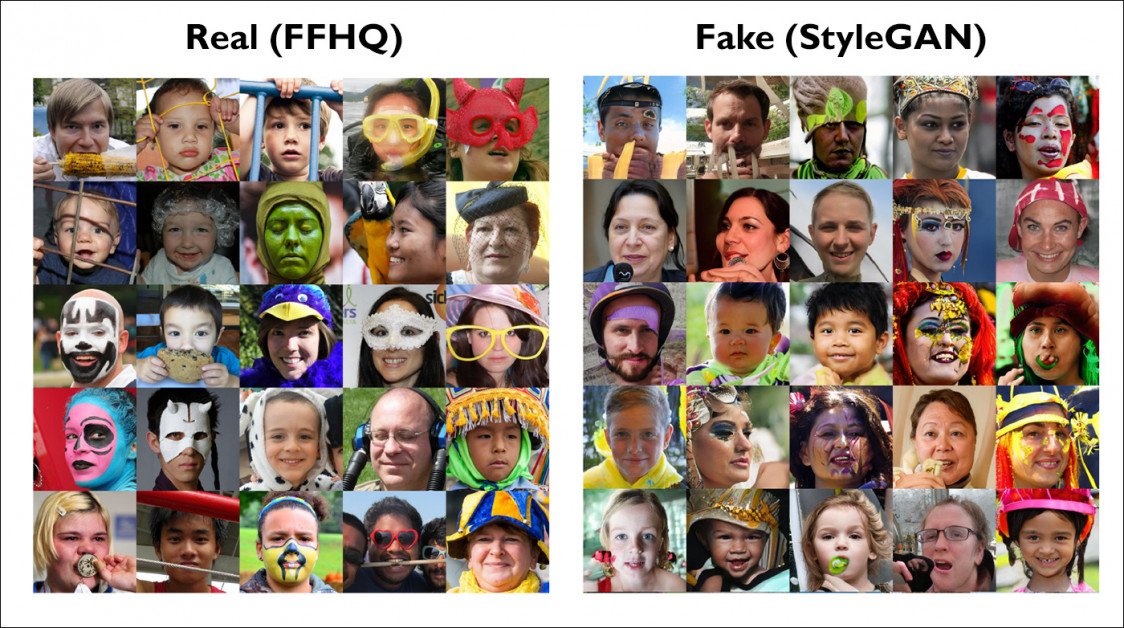
Valikoituja esimerkkejä tutkimuksen laajoista visuaalisista tuloksista; lisätietoja on yllä olevassa lähteessä. Vasemmalla on FFHQ:n aitoja esimerkkejä, joilla on alkuperäisessä aineistossa hyvin vähän läheisiä naapureita, eli ne ovat uusia ja epätavallisia. Oikealla ovat StyleGANin generoimat kuvat, jotka uusi mittari tunnisti aidosti uudenlaisiksi. Artikkelin kuvakokorajoitusten vuoksi tarkemmat ja suuremman resoluution kuvat kannattaa katsoa alkuperäisestä tutkimuksesta.
Tutkijoiden mukaan harvinaisuuspisteytys mahdollistaa uudenlaisten tuotosten tunnistamisen yksittäisessä arkkitehtuurissa ja lisäksi vertailut erilaisten generatiivisten mallien, kuten autoenkooderien, VAE-mallien ja GAN-mallien, välillä.
Tutkimuksen mukaan pisteytys eroaa aiemmista mittareista keskittymällä kykyyn luoda ainutlaatuisia ja harvinaisia kuvia. Perinteiset mittarit tarkastelevat suppeammin koulutuksen aikana syntyvien tuotosten monimuotoisuutta.
Rajattuja tehtäviä laajemmin
Vaikka tutkijat testasivat rajatun alueen järjestelmiä, kuten ihmisten tai kissojen kuviin erikoistuneita generaattorin ja aineiston yhdistelmiä, harvinaisuuspisteytystä voisi soveltaa mihin tahansa kuvasynteesiin. Se voisi tunnistaa koulutusaineistosta johdettuja jakaumia käyttäviä tuotoksia sen sijaan, että aitoutta lisätään ja monimuotoisuutta vähennetään lisäämällä vieraita latentteja jakaumia tai käyttämällä muita omaperäisyydestä aitouden hyväksi tinkiviä oikoteitä.
Mittari voisi siten erottaa aidosti uusia tuotoksia esimerkiksi DALL-E-sarjan järjestelmissä vertaamalla ilmeisen poikkeavan tuloksen etäisyyttä koulutusaineistoon sekä samankaltaisilla kehotteilla tai syötteillä, kuten kuvakehotteilla, saatuihin tuloksiin.
Käytännössä emme ymmärrä selvästi, missä määrin järjestelmä on todella omaksunut visuaaliset ja semanttiset käsitteet; koulutusaineiston rajallinen tuntemus usein vaikeuttaa tätä. Menetelmä voisi silti auttaa tunnistamaan generatiivisen järjestelmän aidon inspiraation hetken: kohdan, jossa riittävä määrä syötekäsitteitä ja aineistoa synnyttää todella kekseliään tuotoksen liian johdannaisen tai lähdeaineistoa muistuttavan tuloksen sijaan.
* Olen muuttanut tekijöiden tekstinsisäiset lähdeviitteet hyperlinkeiksi.
Julkaistu ensimmäisen kerran 20. kesäkuuta 2022.