
Haastattelut
Gil Elbaz, Datagenin perustaja ja CTO – Haastattelusarja

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
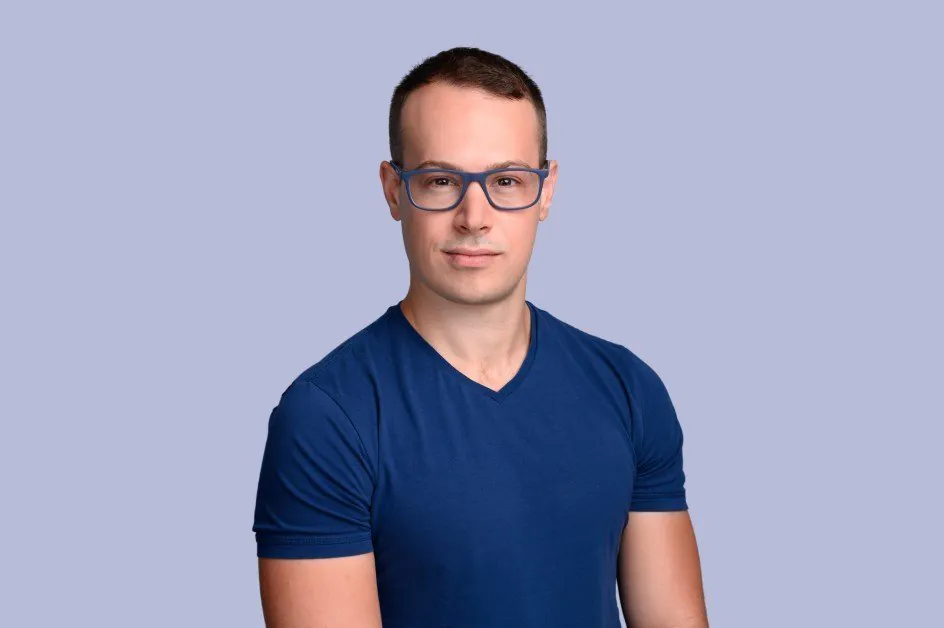
Gil Elbaz on Datagenin CTO ja perustaja, joka toimii Tel Avivissa. Hän on suorittanut B.Sc- ja M.Sc-tutkinnot Technionista. Gilin väitöskirjatutkimus keskittyi 3D-tietokoneen näkemiseen ja on julkaistu CVPR:ssä, maailman johtavassa tietokoneen näkemisen tutkimuskonferenssissa. Datagen on uranuurtaja uudessa simuloitujen datojen alalla, joka on osa syntetisiä datoja ja keskittyy valokuvamaiseen maailman ympäristön jäljittelyyn. Yritys aloitti toimintansa 18 miljoonan dollarin rahoituksella maaliskuussa 2021 ja työskentelee nykyään useiden Fortune 100 -yritysten kanssa lisätyn ja virtuaalitodellisuuden, robotiikan ja autoteollisuuden parissa, mukaan lukien useimmat Yhdysvaltain johtavat teknologiayritykset.
Mikä aluksi veti sinut robotiikan ja koneoppimisen pariin?
Tieteiskirjat, kuten Isaac Asimovin Säätiö-sarja ja iRobot, saivat minut ajattelemaan tulevaisuutta, jossa robotit ovat olennainen osa arkipäiväämme. On niin monia tylsiä ja toistuvia tehtäviä, joita ihmiset tekevät; en halunnut tehdä niitä, eikä kukaan muukaan. Koska robotiikka on teknologinen välttämättömyys, ajattelin, että suuntautuminen siihen olisi älykäs ja “tulevaisuudenvarainen” uravalinta.
Aluksi lähestyin alaa keskittyen sen fyysiseen puoleen ja suoritin mekaniikan insinöörin tutkinnon Technionista Haifasta, Israelista. Tutkinnon lopussa aloin syventyä CAD-työkalujen ja -mahdollisuuksien maailmaan. Nämä työkalut mahdollistavat mekaniikan insinöörien suunnitella rakenteita ja laitteita (kaikkea siltaa ja autoa). Näin valtavan mahdollisuuden tehdä merkittävä vaikutus ilman hitaita fyysisten iterointien tarvetta. Käytännössä nämä ohjelmat eivät olleet juuri lainkaan koneoppimista tai tietokoneen näkemistä sisältäviä, mikä olisi auttanut insinöörejä luomaan yksinkertaisempia, halvempia ja vakaampia mekaniikkaa (tämä oli vuonna 2015). Lähdin tavoittelemaan tietokoneen näkemistä 3D-tiedoissa syvällä oppimisella (erittäin uusi tuolloin) tavoitteena tehdä älykkäämpiä CAD-ohjelmia. Työskennellessäni modernin syvän oppimisen alkuaikoina, tuntui siltä, että olin osa jotain, mikä voisi olla todella suurta – samanlaista kuin internet.
Käytännössä tutkimukseni oli ensimmäinen, joka toi syvän oppimisen vallankumouksen tiedekuntaamme Technioniin. Tämä myöhemmin kehittyi tutkielmaksi, joka hyväksyttiin maailman johtavassa tietokoneen näkemisen konferenssissa, CVPR:ssä, ja lensin Havaijille CVPR 2017:een. Esitelmöinti ja tapaaminen ihmisten kanssa avasi silmäni tietokoneen näkemisen yhteisön laajuudelle (joka on nykyään vähintään 10-kertainen), tuhannet osallistujat kaikki intohimoisesti työskentelevät tutkimuksessa alalla. Tapahtuma käytännössä vahvisti suuntautumistani, osoittaen tietokoneen näkemisen voiman ja odottamattoman potentiaalin.
Voitko kertoa Datagenin synnystarinan?
Datagen perustettiin vuonna 2018 tehtävänä muuttaa tapaa, jolla tiimit hankkivat tietoja tietokoneen näkemisen verkkojen koulutukseen. Edellisenä vuonna näimme Oculus Rift -demoversion, joka koostui VR-lasista ja kädessä pidettävästä ohjaimesta. Demoesityksen jälkeen ihmettelimme, “miksi kädessä pidettävä laite tarvitaan yhdistämään virtuaalitila fyysiseen tilaan (eli seurata käsiliikettä)?” Neuroverkot olivat jo tarpeeksi kehittyneitä käsitelläkseen sen, joten mikä oli ongelma?” Ja silloin valaisi – Data! Näimme valtavan mahdollisuuden ratkaista 3D-avaruudelliset läsnäoloon liittyvät haasteet edistyneen tietokoneen näkemisen avulla. Emme keskittyneet ainoastaan VR/AR:ään, vaan otimme holistisen lähestymistavan, keskittyen ratkaisemaan näennäisesti ratkaisemattoman ongelman luoda riittävä (ja tarkin) koulutusdata mahdollistamaan todellisen maailman 3D-AI-sovellukset.
Datagen on simuloitujen datojen uranuurtaja, joka keskittyy valokuvamaiseen maailman ympäristön jäljittelyyn. Tänään työskentelemme maailman innovatiivisimpien yritysten kanssa kiihdyttääksemme ja nopeuttaaksemme heidän tietokoneen näkemisen kehitystään ja olemme saaneet tukea alan arvostetuimmilta sijoittajilta.
Voitko selittää, mitä tarkalleen ottaen on syntetistä dataa?
Syntetinen data on koulutusdataa, joka on luotu joko algoritmien avulla tai simulaation kautta, eikä se ole kerätty suoraan maailmasta. Tietokoneen näkemisen kontekstissa syntetinen data on tietokoneella luotuja kuvia liittyvine metatiedoineen, joita tarvitaan tekoälyjen koulutukseen. Koska on olemassa yksityisyyden suojeluun liittyviä ongelmia ja fyysisiä ja taloudellisia rajoituksia, on vaikea liioitella syntetisen datan merkitystä koneoppimiselle ja tekoälylle. Tuoreessa raportissa Gartner ennusti, että vuoteen 2024 mennessä suurin osa tekoäly- ja analytiikkaohjelmien kehittämiseen käytettävistä datoista on luotu keinotekoisesti.
Mitkä ovat syntetisen datan hyödyt verrattuna manuaaliseen datan keräämiseen?
Lyhyt vastaus on, että kaikki manuaalisen datan keräämisen epätoivottavat puolet voidaan poistaa prosessista – ne ovat syntetisen datan hyödyt.
Tietokoneen näkemisen koulutusdatan luominen suurissa määrin on kallista, aikaa vievää ja vaihtelevuutta rajoittaa vain se, että ihmisten sijoittaminen tiettyihin paikkoihin ja valokuvauksen on vaikea ja kallista – paljon hankalampaa kuin tehdä niin simuloitussa ympäristössä. Toinen merkittävä etu on, että manuaalisen annotoinnin tarve voidaan poistaa tehokkaasti, mikä on tylsää, aikaa vievää ja altis ihmisen virheille.
Datagen viittaa simuloituun dataan syntetisen datan alajana. Voitko selittää, mitä simuloitu data on?
Simuloitu data on syntetistä dataa, jota luodaan simulaation kautta. Käytämme GAN-eja (sekä muita edistyneitä koneoppimismenetelmiä) luomaan 3D-olioita ja asettamaan ne hyvin realistisiin 3D-simulaatioihin todellisesta maailmasta. Se näyttää ensimmäisen persoonan “virtuaalivalokuvauksen” prosessilta, mutta toimii valokuvamaisessa, fysiikkaan perustuvassa järjestelmässä. Nämä simulaatiot tuottavat visuaalista dataa (kuten se olisi kerätty todellisesta maailmasta) yhdessä täydellisen annotaatioiden joukon (fysiikka, valaistus jne.). Simuloitu data on siis syntetistä dataa, joka on valokuvamaista, kontekstuaalisesti luotua, 3D-kuvaa, kerättyä simuloitussa ympäristössä.
MITen Datagen luottaa räätälöityä simuloitua dataa?
Datagenin teknologia luottaa simuloitua dataa, joka on sekä helposti skaalattavissa että räätälöity kunkin asiakkaan tarpeisiin. Teemme niin ottaen huomioon jokaisen projektin jokaisen puolen – tietokoneen näkemisen järjestelmästä, jota käytetään, alueen demografiiseen koostumukseen, jossa se toimii. Olipa kyse sitten suoraan asiakkaiden kanssa työskentelemisestä tai heidän insinöörien omasta työstä, Datagenin prosessi alkaa määrittelemällä avainparametrit kullekin erityiselle käyttötarkoitukselle, kuten linssin määritykset, valaistus, ympäristö, demografinen jakautuma jne. Datagen käyttää GAN-eja ja muita edistyneitä työkaluja ja tekniikoita luomaan valtavan määrän varastoja, mukaan lukien kaikenlaisia asioita ihmispäiden dynaamisilla kasvojen ilmeillä kouluttaa tekoälyä emotionaaliseen analyysiin, ajoneuvojen sisätiloihin matkustajien valvontaan ja kotiympäristöihin videoneuvottelusovelluksiin, vain muutamia mainittuaksemme. Kunkin varastotyyppiä kohti Datagen esittää vaihtelua lukuisilla erillisillä akseleilla (ihonvärin ja kulmien korkeuden kaltaisilla, huonekalujen koon, värin ja muodon kaltaisilla), jotka on hienosäädetty heijastamaan kunkin sovelluksen erityisyyttä.
Kiitos näiden kykyjen, Datagenin tietojoukko on ei vain suuri ja monimuotoinen, vaan myös optimoitu koulutusjärjestelmän kouluttamiseen yksittäiseen tehtävään (tai joukkoon tehtäviä) yksittäisessä ympäristössä, jossa se on tarkoitus käyttää – ilman, että se vaarantaa skaalattavuuden. Otamme myös huomioon kunkin sovelluksen annotaatio/metadata-vaatimukset.
MITkä ovat esimerkkejä ratkaisuista robotiikassa, joissa käytetään synteettistä ja/tai simuloitua dataa?
Yksi suurimmista simuloitua dataa käyttämisen eduista robotiikassa on mahdollisuus luoda kuvia laitteista, jotka ovat vielä kehitysvaiheessa. Tällä tavoin robotti (tekoäly) ja sen keho (laitteisto) voidaan kehittää rinnakkain. Nyt koulutus voi kehittyä laitteiston mukana, eikä odotella, kunnes lopullinen tuote on täysin prototyyppi, ennen kuin voidaan aloittaa tekoälyn kehittäminen. Lisäksi, koska simuloitu data on luotu kontekstissa, on helppo ottaa huomioon robottiin ja sen ympäristöön liittyvät vuorovaikutukset. Esimerkiksi, jos kuvittelet robottia, joka poistaa viallisia tuotteita tuotantolinjalta, simuloitu data mahdollistaa datan luomisen jokaiselle fyysiselle virheelle, joka on mahdollinen tuotteessa, sekä robotin näkökulmasta, jotta voidaan tallentaa robotin liikkeen täysi alue, sen vuorovaikutus objektin kanssa, jonka se ottaa kiinni. Lisäksi 3D-metadata merkitsee, että ei ole tarpeen kärsivällisesti annotoida kuvaa toiseen, jotta robotti voi oikein tunnistaa tuotteen, virheet, sen käden tai mitään muuta sen näkökentässä.
Mitkä ovat simuloitua dataa käyttämisen sovellukset älyautossa?
Simuloitu data älyauton kehityksessä tekee siitä helppoa kehittää tietojoukkoja tiettyjen autonmallien kehittämiseen, kun ne suunnitellaan. Insinöörit voivat myös käyttää sisätilan näkemistä tehokkaammin tunnistamaan väsyneitä tai häikäistyneitä kuljettajia, jos kuljettaja on ottanut käden irti ohjauspyörästä tai mitä tahansa muita reunatapauksia, joita on otettava huomioon kuljettajan turvallisuuden vuoksi. Se myös mahdollistaa insinöörien ottaa huomioon suuremman monimuotoisuuden kuljettajissa ja matkustajissa ja esittää vaihtelua kuvakulmasta ja valaistuksesta – kaikki ilman, että se loukkaa todellisten ihmisten yksityisyyttä.
Väskään Datagen ilmoitti useista jännittävistä uusista palkkaamisista, mitä se merkitsee yrityksen tulevaisuudelle?
Viimeaikaiset lisäykset neuvonantajistoon ja johtoryhmään sisältävät alan johtavia ammattilaisia. Heidän tietämyksensä, näkemyksensä ja kokemuksensa auttavat suuntaamaan ja kiihdyttämään Datagenin kasvua, kun navigoimme alan, joka on vielä nuori ja täynnä mahdollisuuksia. Tuntemattomuuksien keskellä ei ole mitään arvokkaampaa kuin tietämys.
Onko mitään muuta, mitä haluaisit jakaa Datagenista?
Tel Avivissa toimiva Datagen on osa laajempaa taloudellista ja kulttuurista muutosta, joka on tapahtunut Israelissa, ja olemme ylpeitä siitä, että olemme osa sitä. Lyhyessä ajassa Israel (erityisesti Tel Aviv) on kasvanut merkittäväksi globaaliksi teknologiakeskukseksi, jossa on kukoistava startup-ekosysteemi ja energinen sijoittajayhteisö. Vaikka Israelia usein pidetään kyberturvaan keskittyneenä teknologiakeskuksena, tekoäly- ja datakeskeinen teknologia on kasvanut eksponentiaalisesti viime vuosina. Tänään on yli 680 tekoälyyritystä Israelissa, jotka ovat keränneet yhteensä 4,5 miljardia dollaria. Tämä räjähdysmäinen kasvu viime vuosina johtuu suurelta osin maan insinöörien ja maailmanluokan yliopistojen keskittymästä. Nämä akateemiset laitokset tarjoavat pääsyn kykyihin ja uusimpaan teknologiaan alalla. Viime kuukausina Datagen on palkannut yli 20 uutta työntekijää ja aikoo palkata lisää tiimiläisiä myyntiin ja markkinointiin, ohjelmistoihin ja DevOpsiin sekä tuoteosastoihin.
Kiitos haastattelusta, lukijat, jotka haluavat oppia lisää, voivat vierailla Datagenin sivustolla.


