
Parhaat
10 parasta AI‑verkkokaavintatyökalua (syyskuu 2026)

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Unite.AI voi saada korvauksen, kun käytät arvioimiemme tuotteiden linkkejä. Tämä ei vaikuta toimituksellisiin arvioihimme. Lue kumppanuusilmoituksemme.
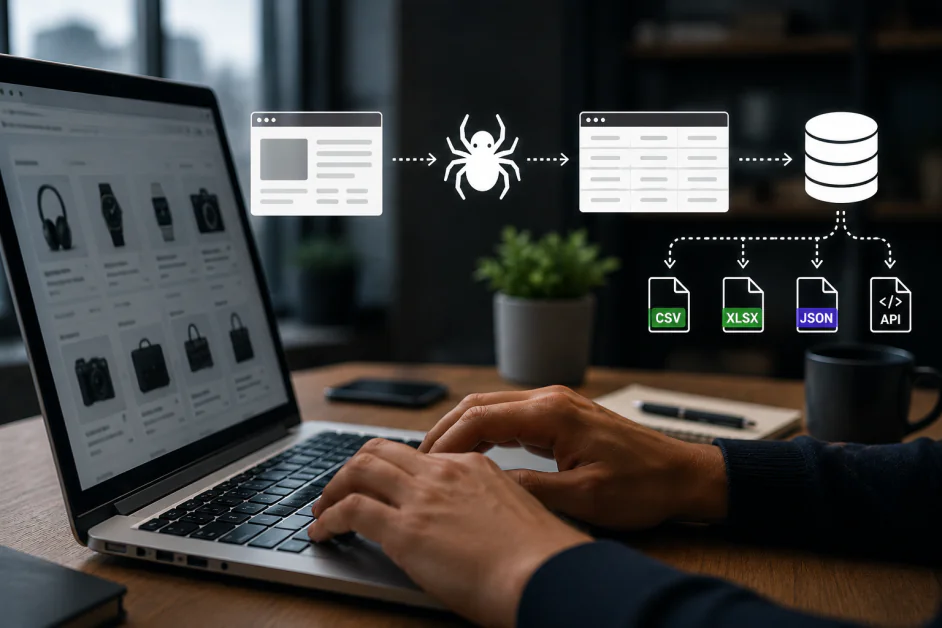
AI‑verkkokaavintatyökalut eivät ole enää pelkkiä sivunjäsennysohjelmia. Parhaat alustat auttavat tiimejä keräämään julkista verkkodataa, muuntamaan sotkuiset sivut rakenteellisiksi tietoaineistoiksi, syöttämään retrieval‑augmented generation -järjestelmiin, seuraamaan markkinoita ja tarjoamaan AI‑agentteille luotettavaa verkkokontekstia.
Tämä muutos on merkittävä, koska kaavinta on sekä arvokkaampaa että vaikeampaa tehdä hyvin. Nykyaikaiset verkkosivustot ovat dynaamisia, personoituja, voimakkaasti skriptattuja ja usein suojattuja väärinkäytösten estojärjestelmillä. Hyödyllisen kaavintatyökalun on tehtävä enemmän kuin pelkkä HTML‑nauhoitus. Sen täytyy hallita renderöinti, poimintalogiikka, ajoitus, tietojen laatu, säädökset ja siirto niihin järjestelmiin, joissa dataa todella käytetään.
Oikea valinta riippuu tehtävästä. Jotkut tiimit tarvitsevat yritystason infrastruktuuria laajoihin julkisen datan ohjelmiin. Toiset tarvitsevat LLM‑valmiin Markdown‑muodon, koodittoman robotin toistuvaan tutkimukseen, kehittäjäalustan selainautomaatioon tai erikoistuneen hakutulosten API:n. Alla olevat työkalut kattavat nämä erilaiset lähestymistavat.
Tiimimme arvioi jokaisen ratkaisun itsenäisesti, tarkastellen sen kykyjä, käytännön vahvuuksia, rajoituksia ja soveltuvuutta niihin käyttötapauksiin, jotka heijastuvat sijoituksiimme.
Parhaat AI‑verkkokaavintatyökalut vertailettu
| AI‑työkalu | Paras käyttötarkoitus | Keskeiset vahvuudet |
|---|---|---|
| Bright Data | Yritystason verkkokaavinta, välityspalvelininfrastruktuuri ja AI‑dataputket | Kaavintojen API:t, selain‑API, Scraper Studio, Web Unlocker, välityspalvelininfrastruktuuri, tietoaineistot, RAG‑työnkulut |
| Firecrawl | Verkkosivujen muuntaminen puhtaaksi, LLM‑valmiiksi sisällöksi AI‑sovelluksiin | Kaavinta, indeksointi, haku, kartoitus, seuranta, Markdown, rakenteellinen JSON, selainvuorovaikutus, API, MCP, avoin lähdekoodi |
| Apify | Kehittäjät, jotka rakentavat skaalautuvia kaavintoja, selainautomaatioita ja data‑agentteja | Toimijamarkkinapaikka, Crawlee, Playwright, Puppeteer, Selenium, ajoitus, välityspalvelimet, tietoaineistot, API:t, MCP‑integraatiot |
| Browse AI | Kooditon verkkokaavinta, sivustojen seuranta ja toistuva liiketoimintadatan keruu | AI‑robotit, point‑and‑click‑koulutus, sivustojen seuranta, ajoitettu poiminta, valmiit robotit, integraatiot |
| SearchAPI | Reaaliaikaiset SERP‑ ja hakukonetiedot AI‑, SEO‑ ja tutkimustyönkuluille | Google, Google Maps, Bing, YouTube, kauppa‑ ja uutistiedot, rakenteinen JSON, maantieteellinen kohdistus, välityspalvelimen kierto, uudelleenyritykset, MCP |
| ScrapingBee | Kehittäjäystävällinen kaavinta‑API, jossa AI‑poiminta ja JavaScript‑renderöinti | Luonnollisen kielen poiminta, rakenteinen JSON, Markdown, JavaScript‑skenaariot, välityspalvelimen kierto, kuvakaappaukset, omat API:t, CLI, MCP |
| Octoparse | Visuaalinen kooditon kaavinta dynaamisille sivustoille ja toistuville pilvitehtäville | Visuaalinen työnkulunrakentaja, AI‑automaattinen tunnistus, pilvikaavinta, mallipohjat, IP‑kierto, ajoitus, viennit, API:t |
| Oxylabs | Yritystason kaavinta‑API:t, AI‑pohjainen maadoitus ja vaikeat julkiset sivustot | Web Scraper API, AI Studio, Headless Browser, Web Unblocker, Fast Search API, rakenteiset tiedot, maantieteellinen kohdistus |
| Diffbot | Automaattinen sivuluokittelu, entiteettien poiminta ja Knowledge Graph -pääsy | Extract API, Crawl API, Knowledge Graph, entiteettien rikastus, luonnollisen kielen prosessointi, konenäkö, rakenteiset tietoaineistot |
| ScrapeGraphAI | Luonnollisen kielen poiminta rakenteisella JSON:lla ja AI‑kehysintegraatioilla | Prompt‑pohjainen poiminta, JSON‑skeemat, indeksointi, seuranta, JavaScript‑renderöinti, SDK:t, CLI, MCP, LangChain‑ ja CrewAI‑integraatiot |
Kuinka valita AI‑verkkokaavintatyökalu
Aloita määrittelemällä, millainen verkkodatan ongelma sinulla on. Jos tavoitteena on syöttää AI‑tuotteelle puhdasta verkkokontekstia, painota Markdownia, rakenteista JSON‑muotoa, indeksointikontrolleja ja retrieval‑ystävällistä ulostuloa. Jos taas tavoitteena on toistuva liiketoimintatutkimus, kooditon robotti tai visuaalinen työnkulunrakentaja voi olla nopeampi. Jos tavoitteena on laajamittainen julkisen datan keruu, etsi syvä infrastruktuuri: renderöinti, jonot, välityspalvelimen hallinta, avaus, seuranta ja luotettava toimitus.
Toinen kysymys on, kuka ylläpitää työnkulkua. Markkinointitiimi, joka seuraa kilpailijoiden sivuja, tarvitsee aivan erilaisen tuotteen kuin insinööritiimi, joka rakentaa dataputkea. Hyvät kaavintajärjestelmät tekevät poiminnoista toistettavia, mutta ne eivät poista validoinnin tarvetta. Sivustot muuttuvat, kentät siirtyvät, ja AI‑avusteinen poiminta voi kuulostaa varmalta, vaikka sivu olisi epäselvä. Paras ratkaisu on sellainen, joka sopii tiimisi tekniseen osaamiseen, tarkistusprosessiin ja säädösten noudattamiseen.
10 parasta AI‑verkkokaavintatyökalua
1. Bright Data
Bright Data on vahvin vaihtoehto, kun verkkodatan keruu on keskeinen liiketoimintajärjestelmä eikä sivuprojekti. Se yhdistää kaavinta‑API:t, selaininfrastruktuurin, välityspalvelinhallinnan, avaus-teknologian ja valmiit tietoaineistot, jotta tiimit voivat kerätä julkista verkkodataa merkittävissä mittakaavoissa ilman, että jokainen kerros täytyy koota itse.
Alusta on erityisen hyödyllinen yrityksille, jotka rakentavat markkinatiedustusta, verkkokauppaseurantaa, hakutiedustusta, AI‑koulutusaineistoja, retrieval‑augmented generation -putkia tai kilpailullisia dataproduktteja. Bright Data antaa teknisille tiimeille riittävästi hallintaa monimutkaisten työnkulkujen rakentamiseen, mutta tarjoaa myös hallinnoituja polkuja tiimeille, jotka haluavat rakenteista dataa ilman hauraan kaavintapinoon sitoutumista.
Tämä laajuus on myös ostoharkinta. Bright Data on järkevin, kun organisaatio voi osoittaa insinööri‑ tai data‑operaatioiden omistajuuden, määritellä hyväksytyt kohteet ja seurata laatua sekä kustannuksia ajan myötä. Pienemmät tiimit, joilla on kapea lista helppoja sivustoja, saattavat hyötyä kevyemmästä API:sta tai koodittomasta palvelusta, kun taas säännellyt ohjelmat tulisi sovittaa oikeudellisten ja tietosuojakatselmusten kanssa.
Plussat ja miinukset
- Laajin infrastruktuurikattavuus tässä vertailussa
- Vahva sopivuus suurille määriä ja vaikeille julkisille sivustoille
- Valmiit kaavimet ja tietoaineistot vähentävät rakennusaikaa
- Käytännöllinen AI‑dataputkille, hakutiedustukselle ja verkkokauppaseurannalle
- Enemmän infrastruktuuria kuin pienet satunnaiset projektit tarvitsevat
- Tiimit tarvitsevat edelleen selkeän datahallinnon ja kohdesivustojen säännöt
- Edistyneet käyttötapaukset vaativat teknistä asennusta ja seurantaa
2. Firecrawl
Firecrawl on rakennettu AI‑kaudelle verkkokaavinnassa. Sen sijaan, että kehittäjien täytyisi puhdistaa raakaa HTML:ää, hallita sivun renderöintiä ja normalisoida sotkuista sisältöä käsin, se muuntaa verkkosivut puhtaaksi Markdown‑muodoksi tai rakenteiseksi dataksi, joka voi syöttää agenteille, retrieval‑järjestelmille, tutkimustyökaluille ja tuote‑työnkuluille.
Vetovoima on yksinkertaisuus sovelluskerroksessa. Kehittäjät voivat kaavata sivun, indeksoida sivuston, hakea verkosta, kartoittaa URL:eja, seurata muutoksia tai pyytää rakenteellista ulostuloa paljon vähemmän putkistotyötä vaativalla tavalla kuin perinteinen kaavintapinot. Firecrawl sopii erityisesti hyvin, kun lopputuote on AI‑avustaja, tietopankki, tutkimustyönkulku tai retrieval‑augmented generation -järjestelmä.
Tiimien tulisi nähdä Firecrawl sisällönhankintakerroksena eikä koko data‑alustana. Tuotantokäyttö vaatii edelleen lähteiden rajaamista, deduplikaatiota, tuoreus‑sääntöjä, skeeman validointia ja havainnointia, kun sivustot muuttuvat. Sen arvo on suurimmillaan, kun kehittäjät haluavat tiiviin API:n ja itseisännöinnin mahdollisuuden, mutta eivät tarvitse laajaa välityspalvelin‑hallintaa tai hallittuja tietoaineistoja, joita yritystason tarjoajat tarjoavat.
Plussat ja miinukset
- Erinomainen sopivuus AI‑sovelluksille, jotka tarvitsevat puhdasta verkkokontekstia
- Markdown‑ ja rakenteellinen ulostulo vähentävät jälkikäsittelyä
- Käytännöllinen API‑pinta kaavinta, indeksointia, hakua, kartoitusta ja seurantaa varten
- Avoimen lähdekoodin vaihtoehto tarjoaa teknisille tiimeille enemmän käyttöönotto‑joustavuutta
- Ei täysi välityspalvelin‑ tai yritystason data‑infrastruktuurialusta
- Monimutkainen poiminta hyötyy silti skeeman suunnittelusta ja validoinnista
- Tiimien, joilla on tiukat säädöstarpeet, tulee tarkkaan arvioida käyttöönotto‑ ja säilytysvaihtoehdot
3. Apify
Apify on vahva valinta tiimeille, jotka haluavat sekä kehittäjäalustan että suuren markkinapaikan valmiita verkkoma automaatiotyökaluja. Sen Actor‑malli mahdollistaa kaavinten, selainautomaatioiden ja data‑työnkulkujen paketoimisen uudelleenkäytettäviksi pilvitehtäviksi, joita voidaan ajoittaa, kutsua API:lla, liittää tallennukseen ja jakaa tiimin kesken.
Kehittäjät saavat käytännöllisen polun prototyypistä tuotantoon. He voivat rakentaa Crawlee‑, Playwright‑, Puppeteer‑ tai Selenium‑pohjaisesti, tai käyttää olemassa olevia Actors, ja sitten käyttää Apify‑alustaa suoritukseen, jonoihin, välityspalvelimiin, tietoaineistoihin, webhookeihin ja integraatioihin. Tämä tekee siitä erityisen hyödyllisen tiimeille, jotka tarvitsevat toistettavia data‑tehtäviä yhden kerran kaavinnan sijaan.
Apify:n joustavuus on sekä vahvuus että vastuu. Tiimien täytyy valita luotettavat Actors, hallita versioita, seurata suorituksia ja budjetoida laskentaa, välityspalvelimia ja tallennusta, kun työkuorma kasvaa. Se sopii parhaiten kehittäjille, jotka haluavat uudelleenkäytettäviä rakennuspalikoita ja pilvioperaatiot samassa paikassa; satunnaiskäyttäjät saattavat löytää tarkoitukseen rakennetun kaavimen nopeammin opittavaksi.
Plussat ja miinukset
- Laaja markkinapaikka valmiita Actors‑tehtäviä yleisiin kohteisiin
- Vahvat kehittäjätyökalut räätälöityyn kaavintaan ja selainautomaatioon
- Sopii hyvin ajoitettuihin, toistuviin data‑keräyksen työnkulkuihin
- Crawlee‑tuki antaa teknisille tiimeille joustavan avoimen lähdekoodin perustan
- Markkinapaikan laatu vaihtelee Actor‑kohtaisesti ja käyttötapauksen mukaan
- Räätälöidyt tehtävät vaativat edelleen ylläpitoa, kun sivustot muuttuvat
- Ei‑tekniset käyttäjät saattavat suosia yksinkertaisempaa visuaalista kaavinta
4. Browse AI
Browse AI on paras liiketoimintatiimeille, jotka tarvitsevat verkkodataa mutteivät halua rakentaa kaavimia. Käyttäjät kouluttavat robotin näyttämällä, mitä kerätä, ja ajavat robotin tarpeen mukaan tai aikataulun mukaan. Tämä tekee siitä hyödyllisen kilpailijoiden seuraamiseen, listojen valvontaan, liidien keruuseen, varaston tarkkailuun tai toistuvan tutkimuksen muuttamiseksi toistuvaksi työnkuluksi.
Sen vahvuus on saavutettavuus. Browse AI antaa operaatio‑, markkinointi‑, rekrytointi‑, verkkokauppa‑ ja tutkimustiimeille käytännöllisen tavan kerätä rakenteellista dataa verkkosivuilta ilman, että insinöörit joutuvat ylläpitämään jokaista valitsinta. Se ei pyri olemaan syvin kehittäjäalusta; se pyrkii tekemään toistettavan verkkodatan keruun lähestyttäväksi.
Browse AI toimii parhaiten, kun kohde‑työnkulku voidaan demonstroida selkeästi ja tarkistaa ihmisen toimesta. Käyttäjien tulisi testata sivunumerointi, kirjautumisvaiheet, tyhjät tilat ja asettelumuutokset ennen kuin automatisointiin luotetaan päätöksenteossa. Se on vahva valinta osastoprojekteihin, mutta insinööri‑johtoiset ohjelmat saattavat tarvita tarkempaa hallintaa uudelleenyrittämisille, datasopimuksille ja käyttöönotolle.
Plussat ja miinukset
- Vahva kooditon kokemus liiketoimintakäyttäjille
- Sopii hyvin toistuvaan valvontaan ja taulukkomuotoisiin työnkulkuihin
- Point‑and‑click‑robotin koulutus on helpompaa kuin valitsinpohjainen asennus
- Hyödyllinen tiimeille, jotka tarvitsevat verkkodataa ilman insinööritukea
- Vähemmän joustava kuin kehittäjä‑ensimmäiset alustat monimutkaiseen logiikkaan
- Robotit saattavat vaatia säätöä, kun kohdesivut muuttuvat merkittävästi
- Suuret tai erittäin räätälöidyt ohjelmat voivat kasvaa koodittoman lähestymistavan ulkopuolelle
5. SearchAPI
SearchAPI on erikoistunut kaavintapalvelu tiimeille, jotka tarvitsevat ajantasaisia hakukoneiden tuloksia rakenteisena datana eikä raakina tulossivuna. Yksi API‑pinta voi palauttaa orgaaniset linkit, mainokset, uutiset, karttalistaukset, ostostulokset, tietopaneelit, People Also Ask -kysymykset, AI‑luodut hakutoiminnot ja muut tulostyypit JSON‑muodossa valitun hakukoneen mukaan.
Alusta on erityisen hyödyllinen SEO‑seurannassa, paikallisessa haun analysoinnissa, markkinatutkimuksessa, tuote‑tiedustelussa ja AI‑agenteissa, jotka tarvitsevat reaaliaikaista hakukontekstia. SearchAPI hoitaa selaimen renderöinnin, välityspalvelimen kierron, uudelleenyritykset ja CAPTCHA‑käsittelyn pyynnön takana, samalla kun lokalisointiparametrit tukevat maata, kieltä, sijaintia ja laitekohtaisia kyselyjä. Dokumentoidut moottorit ulottuvat perinteisten Google‑tulosten ulkopuolelle lähteisiin kuten Google Maps, Bing, YouTube, uutiset ja kaupalliset hakukokemukset.
SearchAPI tarjoaa myös MCP‑palvelimen, jonka avulla tuetut AI‑assistentit ja kehitysympäristöt voidaan liittää sen hakutyökaluihin. Kompromissi on erikoistuminen: tämä on vahva hakudatan kerros, ei yleinen indeksointityökalu, joka poimii satunnaisia kenttiä mistä tahansa verkkosivusta. Ostajien tulisi myös mallintaa käyttö tarkasti, koska suunnitelmat perustuvat krediitteihin, läpimeno vaihtelee tason mukaan, ja rikkaammat hakupinnat tarvitsevat edelleen skeeman tarkistuksia, kun ylävirran layoutit muuttuvat.
Plussat ja miinukset
- Palauttaa rakenteellista reaaliaikaista SERP‑dataa ilman hakukaavinten tai välityspalvelininfrastruktuurin ylläpitoa
- Tukee suuria hakukoneita, karttoja, videoita, uutisia, ostoksia ja muita erikoistuneita hakumoottoreita
- Sijainti‑, kieli‑, maa‑ ja laite‑ohjaukset sopivat ranking‑seurantaan ja markkinatutkimukseen
- API‑ ja MCP‑pääsy tekevät hakudatasta käytännöllisen sovelluksille ja AI‑agenteille
- Keskittyy hakukoneen tulostietoon eikä satunnaiseen verkkosivujen indeksointiin
- Krediittipohjaiset suunnitelmat ja läpimeno‑rajoitukset vaativat ennustamista suurille työkuormille
- Sovellusten tulisi validoida kenttiä, kun hakukoneet muuttavat tuloslayoutia
6. ScrapingBee
ScrapingBee on kehittäjäystävällinen API tiimeille, jotka haluavat kerätä ja jäsentää verkkodataa ilman headless‑selainten tai välityspalvelininfrastruktuurin ylläpitoa. Se yhdistää JavaScript‑renderöinnin, välityspalvelimen kierron, kuvakaappaukset, CSS/XPath‑poiminnan ja AI‑poimintakerroksen, joka muuntaa luonnollisen kielen pyynnöt ja kenttä‑säännöt rakenteiseksi JSON‑muodoksi.
Alusta on erityisen hyödyllinen, kun kehittäjät haluavat yhden päätepisteen sekä suoraviivaisten sivujen että interaktiivisten sivustojen käsittelyyn. JavaScript‑skenaariot voivat klikata, selata, kirjoittaa tai odottaa ennen poimintaa, kun taas Markdown‑ulostulo, omat API:t, CLI ja MCP‑integraatiot auttavat kaapattua sisältöä siirtymään analytiikkaan, automaatioon ja AI‑työnkulkuihin. ScrapingBee on helpompi ottaa käyttöön kuin täysi kaavintapino, vaikka krediittikulutus voi vaihdella premium‑välityspalvelimien, renderöinnin ja AI‑ominaisuuksien mukaan.
ScrapingBee sopii parhaiten, kun insinöörit haluavat hallitun pyyntökerroksen, mutta pitävät orkestroinnin ja datan laadun omassa sovelluksessaan. Tiimien tulisi määritellä uudelleenyritys‑säännöt, skeemat, indeksointirajat ja validointi monisivuisille tehtäville sen sijaan, että jokainen onnistunut HTTP‑vastaus katsottaisiin luotettavaksi dataksi. Visuaalinen työpöytäkaavinta on helpompi ei‑teknisille käyttäjille, mutta API‑tiimit saavat enemmän suoraa hallintaa integraatioihin ja käyttöönottoon.
Plussat ja miinukset
- Luonnollisen kielen AI‑poiminta voi palauttaa rakenteisen JSON:n ilman käsinrakennettuja valitsimia
- JavaScript‑renderöinti ja skriptatut toiminnot käsittelevät monia dynaamisia sivutyönkulkuja
- Välityspalvelimen kierto, kuvakaappaukset, Markdown‑ulostulo ja omat API:t ovat saatavilla yhden palvelun kautta
- CLI, MCP ja automaatio‑integraatiot sopivat kehittäjä‑ ja agenttityönkulkuihin
- Krediittikäyttö nousee, kun pyynnöt sisältävät AI‑poimintaa, premium‑välityspalvelimia tai JavaScript‑renderöintiä
- Tuote on API‑ensimmäinen eikä visuaalinen työpöytäkaavinta
- Monimutkaiset monisivuiset indeksoinnit vaativat edelleen orkestrointia ja laadun tarkistuksia
7. Octoparse
Octoparse on kypsä kooditon kaavinta käyttäjille, jotka haluavat visuaalisen työnkulun kehittäjäkehyksen sijaan. Se voi tunnistaa sivun tiedot, ohjata käyttäjät poimintavaiheiden läpi ja ajaa kaavintatehtäviä pilvessä, mikä tekee siitä hyödyllisen toistuvaan keruuseen verkkokauppasivustoilta, hakemistoista, listauksista, hakusivuista ja muista rakenteellisista verkkolähteistä.
Alusta on vahvimmillaan, kun tiimi tarvitsee enemmän työnkulun hallintaa kuin nopea selainlisäosan kaavinta, mutta silti haluaa välttää koodin kirjoittamista. Mallipohjat, ajoitus, pilvikaavinta, automaattiset viennit ja dynaamisten sivujen tuki tekevät Octoparse‑ratkaisusta käytännöllisen välimatkan yksinkertaisten koodittomien työkalujen ja insinööri‑johtisten kaavinta‑alustojen välillä.
Visuaalinen malli vaatii silti huolellista työnkulun suunnittelua. Tiimien tulisi testata sivunumerointi, ääretön vieritys, kirjautumistilat, kaksoiskappaleet ja virhehaarat ennen kuin luotetaan ajoitettuihin tehtäviin. Octoparse sopii analyytikoille ja operaatio‑käyttäjille, jotka voivat hallita näitä tarkistuksia, kun taas tiukat, versioituja putkia rakentavat kehittäjät saattavat suosia API‑tai koodipohjaista kehystä vahvemmalla lähdekoodin hallinnalla ja automatisoidulla testauksella.
Plussat ja miinukset
- Visuaalinen työnkulunrakentaja antaa käyttäjille enemmän hallintaa kuin yksinkertaiset yhden‑klikkauksen työkalut
- Pilvikaavinta mahdollistaa toistuvat tehtävät ilman paikallista konetta
- Mallipohjat vähentävät asetusaikaa yleisille sivustoille ja datatyypeille
- Sopii hyvin operaatio‑tiimeille, jotka tarvitsevat toistettavia rakenteisia tietoaineistoja
- Työnkulun suunnittelu voi viedä aikaa monimutkaisilla verkkosivuilla
- Vähemmän luonnollinen kehittäjätiimeille, jotka suosivat koodipohjaisia putkia
- Jatkuva seuranta on edelleen tarpeen, kun kohdesivustot muuttuvat
8. Oxylabs
Oxylabs on vahva valinta tiimeille, jotka tarvitsevat luotettavaa pääsyä julkiseen verkkodataan mittakaavassa eivätkä halua itse hallita välityspalvelimen kiertoa, renderöintiä ja anti‑block‑kerroksia. Sen Web Scraper API on suunniteltu keräämään rakenteista julkista dataa laajalta kohdevalikoimalta samalla, kun suurin osa kaavintainfrastruktuurista hoidetaan taustalla.
Yritys on myös syventänyt AI‑datatyönkulkuja AI Studio‑, Fast Search API‑, selainautomaatio‑ ja maadoituskeskeisten käyttötapausten avulla. Tämä tekee Oxylabs‑ratkaisusta relevantin organisaatioille, jotka rakentavat markkinatiedustelujärjestelmiä, hakuseurantaa, mallien maadoitusta, verkkokauppadata‑aineistoja ja agenttityönkulkuja, jotka tarvitsevat tuoretta verkkokontekstia.
Oxylabs on kaikkein houkuttelevin, kun luotettavuus, kohteen vaikeus tai maantieteellinen ulottuvuus oikeuttaa yritystason palvelun. Ostajien tulisi kartoittaa kohdesivustot, ulostulo‑vaatimukset, vasteajat ja säädösten omistajuus ennen tuotteen konfigurointia. Pienemmät projektit eivät ehkä hyödynnä alustan täyttä infrastruktuurisyvyyttä, kun taas suuret ohjelmat tarvitsevat edelleen itsenäistä laadunvalvontaa, sillä onnistunut keruu ei takaa tarkkaa normalisointia.
Plussat ja miinukset
- Vahva yritystason kaavinta‑ ja välityspalvelininfrastruktuuri
- Sopii julkisen verkkodatan putkille, jotka tarvitsevat mittakaavaa ja luotettavuutta
- AI Studio ja Fast Search API tukevat agentti‑ ja maadoitustyönkulkuja
- Sopii vaikeille dynaamisille sivustoille ja maantieteellisesti kohdistetulle keruulle
- Sopii parhaiten tiimeille, joilla on määritellyt tekniset ja säädösten vaatimukset
- Saattaa olla enemmän infrastruktuuria kuin pienet koodittomat projektit tarvitsevat
- Edistyneet työnkulut vaativat tarkkaa kohteiden valintaa ja validointia
9. Diffbot
Diffbot eroaa useimmista verkkokaavintatyökaluista, koska se keskittyy sivujen ja entiteettien ymmärtämiseen, ei pelkästään kenttien keräämiseen. Sen poimintateknologia luokittelee sivut, tunnistaa rakenteelliset entiteetit ja yhdistää verkkodatan laajempaan Knowledge Graphiin, mikä on hyödyllistä, kun tavoite on rikastettu, normalisoitu informaatio eikä pelkät raakatulokset.
Tämä tekee Diffbotista erityisen relevantin tiimeille, jotka työskentelevät entiteettitiedon, yritys‑ ja henkilötietojen, markkinatutkimuksen, Knowledge Graphin, mediaseurannan ja AI‑järjestelmien parissa, jotka tarvitsevat rakenteellisia faktoja avoimesta verkosta. Se ei ole nopea point‑and‑click‑kaavinta, vaan enemmänkin verkkoskaalan poiminta‑ ja tietokerros.
Keskeinen ostokysymys on, vastaako Diffbotin datamalli projektin tarvitsemia entiteettejä ja suhteita. Jos se vastaa, tiimit voivat välttää sivukohtaisten parserien ja rikastusputkien rakentamista alusta alkaen. Jos ei, perinteinen kaavinta voi tarjota suoremman hallinnan. Arvioinnissa tulisi sisällyttää edustavat sivut, kenttä‑kattaus, päivitystiheys, entiteettien ratkaisu ja se, miten provenance säilytetään alavirtaan.
Plussat ja miinukset
- Vahva automaattinen poiminta ja entiteettien ymmärtäminen
- Knowledge Graph -pääsy lisää kontekstia yhden sivun ulkopuolelle
- Hyödyllinen rikastukseen, tutkimukseen ja rakenteellisiin tiedonhankintatyönkulkuihin
- Sopii, kun normalisoidut entiteetit ovat tärkeämpiä kuin raakatulokset
- Vähemmän intuitiivinen yksinkertaiselle taulukkolaskenta‑kaavinnalle
- Parhaat tulokset riippuvat siitä, sopivatko Diffbot‑mallit kohde‑sisältötyyppiin
- Tiimit tarvitsevat ymmärrystä Knowledge Graphista ja API‑mallista saadakseen täyden hyödyn
10. ScrapeGraphAI
ScrapeGraphAI on suunniteltu käyttäjille, jotka haluavat kuvata tarvitsemansa data luonnollisella kielellä ja saada rakenteellisen ulostulon. Sen sijaan, että kirjoitettaisiin valitsimia jokaiselle kentälle, tiimit voivat antaa URL‑osoitteen, määritellä halutun tiedon ja käyttää AI‑avusteista poimintaa palauttaakseen puhtaan JSON:n sovelluksiin, tutkimustyönkulkuihin tai agenteille.
Se sopii hyvin kehittäjille, jotka rakentavat AI‑työnkulkuja verkkodatan ympärille, erityisesti kun poimintatehtävä muuttuu usein tai täytyy integroitua kehyksiin kuten LangChain, CrewAI, SDK:t, komentorivityökalut tai MCP‑pohjaiset ympäristöt. Keskeinen etu on joustavuus: poimintalogiikka voi olla prompt‑pohjaista eikä sidottu täysin hauraisiin sivuvalitsimiin.
Tämä joustavuus tekee validoinnista erityisen tärkeää. Tiimien tulisi määritellä skeemat, uudelleenyritys‑käyttäytyminen, todistekentät ja näyte‑tarkastus säännöt ennen tuotantokäyttöä, koska uskottava vastaus ei välttämättä ole täydellinen poiminta. ScrapeGraphAI on houkutteleva kokeiluihin ja adaptiivisiin työnkulkuihin, kun taas vakaa, suurten volyymien työ voi edelleen hyötyä deterministisistä valitsimista tai hybridimenetelmästä, jossa AI‑avustusta käytetään vain, kun sivurakenne vaihtelee.
Plussat ja miinukset
- Luonnollisen kielen poiminta on hyödyllistä muuttuviin tai tutkimuksellisiin tehtäviin
- Rakenteinen JSON‑ulostulo sopii AI‑sovelluksiin ja automaatiotyönkulkuihin
- Kehittäjä‑integraatiot tukevat agentti‑ ja orkestrointikäyttötapauksia
- Hyödyllinen, kun valitsimen ylläpito hidastaisi kokeilua
- AI‑poiminta tulee validoida ennen tuotantokäyttöä
- Prompt‑suunnittelu ja skeemat vaikuttavat ulostulon johdonmukaisuuteen
- Vähemmän sopiva tiimeille, jotka tarvitsevat täysin visuaalisen koodittoman työnkulun
Usein kysytyt kysymykset
Mikä tekee verkkokaavintatyökalusta AI‑pohjaisen?
AI‑pohjaiset kaavimet auttavat yleensä yhdellä tai useammalla neljästä tehtävästä: kenttien tunnistaminen sivulla, sivun sisällön muuntaminen rakenteelliseksi dataksi, selaimen ohjaaminen luonnollisen kielen ohjeilla tai kaapattujen sisältöjen valmistelu AI‑järjestelmiä varten. Parhaat työkalut tarvitsevat edelleen selkeitä kehotteita, skeemoja, validointia ja sääntöjä siitä, mitä dataa kerätään.
Mikä ero on kaavinnalla ja selainautomaatiossa?
Kaavinta keskittyy datan poimintaan sivuilta. Selainautomaatio ohjaa selainta klikkaamaan, selamaan, kirjautumaan, täyttämään lomakkeita, odottamaan dynaamista sisältöä tai siirtymään monivaiheiseen työnkulkuun. Monet nykyaikaiset työkalut yhdistävät molemmat, mutta ero on merkityksellinen: staattinen tuotelistaus on kaavintatehtävä, kun taas navigointia ja vuorovaikutusta vaativa työnkulku saattaa tarvita selainautomaatioita.
Mikä ulostuloformaatti on paras RAG‑järjestelmälle?
Retrieval‑augmented generation -järjestelmät toimivat parhaiten puhtaan tekstin, Markdownin, rakenteellisen JSON:n, metatietojen ja vakioituja lähde‑URL:ien kanssa. Tavoitteena ei ole pelkästään sisällön kerääminen, vaan riittävän rakenteen säilyttäminen lohkoittamista, hakua, viittausta ja laatutarkistuksia varten. Raaka HTML voi olla hyödyllinen, mutta se luo usein ylimääräistä puhdistustyötä ennen kuin data on käyttökelpoinen AI‑sovelluksessa.
Voivatko AI‑kaavimet käsitellä JavaScript‑sivustoja?
Monet pystyvät, mutta laatu riippuu tuotteesta. Jotkut työkalut renderöivät sivut selaimessa, jotkut käyttävät headless‑selainin infrastruktuuria, ja toiset luottavat poimintaan sen jälkeen, kun sivu on ladattu. JavaScript‑tuki on tärkeä verkkokaupoille, markkinapaikoille, sosiaalisille alustoille, kojelaudoille ja moderneille web‑sovelluksille, joissa hyödyllinen data ilmestyy alkuperäisen sivuvastauksen jälkeen.
Ovatko koodittomat kaavimet sopivia suuriin projekteihin?
Koodittomat kaavimet voivat olla erinomaisia toistuviin liiketoimintatyönkulkuihin, kilpailijoiden seurantaan, liiditutkimukseen ja operaatio‑tehtäviin. Suuremmat ohjelmat saattavat lopulta tarvita API‑rajapintoja, jonoja, seurantaa, välityspalvelininfrastruktuuria, versionhallintaa, datan validointia ja insinööri‑omistajuutta. Parhaat koodittomat työkalut ovat vahvimmillaan, kun työnkulku on selkeä ja tiimi haluaa nopeuden ilman räätälöidyn kaavimen rakentamista.
Onko verkkokaavinta laillista?
Verkkokaavinnan laki riippuu oikeusalueesta, kohdesivustosta, datatyypistä, pääsytavasta ja datan käyttötavasta. Julkisen verkkodatan keruu voi silti nostaa sopimus-, tietosuoja‑, immateriaalioikeus‑, kyberturvallisuus‑ ja alustan‑käytäntökysymyksiä. Tiimien tulisi tarkistaa sovellettavat lait, robots.txt ja käyttöehdot, sisäiset säädökset sekä datan herkkyys ennen kaavintaohjelman käynnistämistä.
Pitäisikö AI‑luodut poimintatulokset validoida?
Kyllä. AI voi tehdä kaavinnasta joustavampaa, mutta se voi myös lukea sivuja väärin, yhdistää kenttiä, jättää piilotetun kontekstin huomiotta tai palauttaa epäyhtenäisiä rakenteita, kun layoutit muuttuvat. Tuotantotyönkulut tulisi varustaa skeeman tarkistuksilla, näyte‑arvioilla, muutostiedotteilla, virheenkäsittelyllä ja ihmisen tarkastuksella erityisesti arkaluontoisissa päätöksissä.
Lopulliset ajatukset AI‑verkkokaavintatyökaluista
Bright Data on vahvin kokonaisvaltainen valinta tiimeille, jotka tarvitsevat vakavaa infrastruktuuria ja laajoja julkisen datan ohjelmia. Firecrawl on puhtain sopivuus AI‑sovelluksiin, jotka tarvitsevat LLM‑valmiin verkkokontekstin, kun taas Apify tarjoaa kehittäjille joustavan alustan räätälöidyille kaavimille, Actors‑tehtäville ja selainautomaatioille.
Liiketoimintatiimeille Browse AI ja Octoparse tekevät toistuvasta datankeruusta helpommin saavutettavaa ilman, että jokainen työnkulku muuttuu insinööri‑projektiksi. ScrapingBee on vahva kehittäjäystävällinen API luonnollisen kielen poimintaan, JavaScript‑renderöintiin ja rakenteelliseen ulostuloon ilman selaimen ja välityspalvelimen ylläpitoa.
SearchAPI erottuu, kun vaatimus on tuore, rakenteinen hakukone‑data SEO‑tutkimukseen, tutkimukseen tai AI‑agenteille sen sijaan, että kaavittaisiin satunnaisia verkkosivuja. Oxylabs on paras yritystason kaavinta‑API:ille ja vaikeille julkisille sivustoille, Diffbot on houkutteleva, kun entiteettien poiminta ja Knowledge Graph -konteksti ovat tärkeitä, ja ScrapeGraphAI on joustava prompt‑pohjainen poimintavaihtoehto AI‑työnkulkuihin.




