Andersonin kulma
AI-kuvamattaus, joka ymmärtää kohtauksia

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Elokuvan Alien3 (1992) vuoden 2003 DVD-julkaisun lisädokumentissa visuaalisten tehosteiden legenda Richard Edlund muisteli kauhulla fotokemialliseen maskin irrottamiseen liittynyttä ”sumopainia”. Menetelmä hallitsi visuaalisten tehosteiden työtä 1930-luvun lopulta 1980-luvun loppuun. Edlund vertasi prosessin epävarmuutta sumopainiin suhteessa digitaalisiin sini- ja vihertaustatekniikoihin, jotka yleistyivät 1990-luvun alussa. Hän on sittemmin palannut tähän vertaukseen.
Etualan elementin (kuten henkilön tai avaruusalusmallin) erottaminen taustasta, jotta leikattu kuva voidaan yhdistää taustapohjaan, toteutettiin alun perin kuvaamalla etualue tasaisen sinisen tai vihreän taustan edessä.
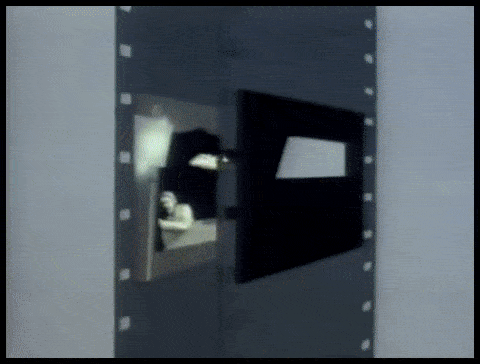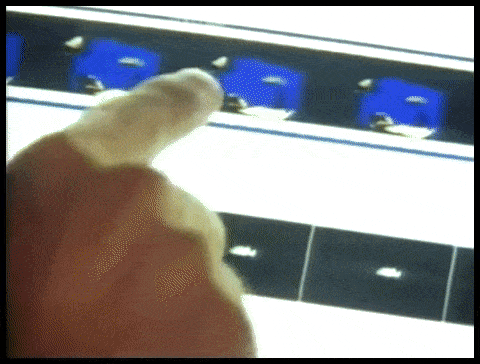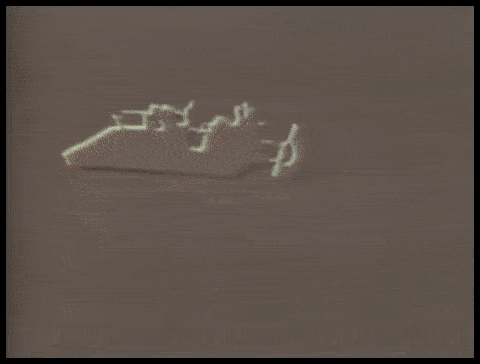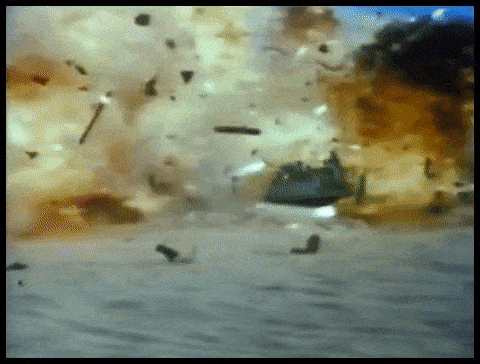
Työläitä fotokemiallisia erottamisprosesseja ILM:n VFX-otokselle ‘Return of the Jedi’ (1983).
Tuloksena syntyneessä kuvamateriaalissa taustan väri eristettiin myöhemmin kemiallisesti ja sitä käytettiin mallina etualan kohteen (tai henkilön) uudelleenvalottamiseen optisessa tulostimessa ‘kelluvana’ objektina muussa tapauksessa läpinäkyvässä filmiruudussa.
Prosessi tunnettiin nimellä color separation overlay (CSO) – vaikka termi myöhemmin yhdistettiin enemmän karkeisiin ‘Chromakey’-videotehosteisiin 1970‑ ja 1980‑luvun pienibudjettitelevisiossa, jotka toteutettiin analogisilla eikä kemiallisilla tai digitaalisilla keinoilla.

Color Separation Overlay -demo vuodelta 1970 brittiläiseen lastenohjelmaan ‘Blue Peter’. Lähde: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Joka tapauksessa, olipa kyseessä elokuva- tai videomateriaali, sen jälkeen eristettyä materiaalia voitiin lisätä mihin tahansa muuhun materiaaliin.
Vaikka Disneyn huomattavasti kalliimpi ja omaan käyttöön tarkoitettu natriumhöyrymenetelmä (joka perustui erityisesti keltaiseen väriin, ja sitä käytettiin Alfred Hitchcockin vuoden 1963 kauhuelokuvassa The Birds) tarjosi paremman tarkkuuden ja terävämmät mattaukset, photokemiallinen erottaminen pysyi työläänä ja epäluotettavana.

Disneyn oma natriumhöyrymenetelmä vaati taustoja lähellä keltaista spektrin päätä. Tässä Angela Lansbury on roikkuva naruilla VFX-painotteisen kohtauksen tuotannossa elokuvassa ‘Bedknobs and Broomsticks’ (1971). Lähde
Digitaalisen mattauksen ulkopuolella
1990‑luvuilla digitaalinen vallankumous poisti kemikaalit, mutta ei tarvetta vihreille ruuduille. Nyt oli mahdollista poistaa vihreä (tai mikä tahansa väri) tausta etsimällä pikseleitä, jotka kuuluvat kyseisen värin toleranssialueeseen, esimerkiksi Photoshopin kaltaisessa pikselieditoriohjelmistossa, sekä uudessa videokompositointiohjelmistossa, joka pystyi automaattisesti poimimaan värilliset taustat. Lähes yhdessä yössä kuusikymmentä vuotta optisen tulostuksen alaa jäi historiaan.
Viimeiset kymmenen vuotta GPU‑kiihdytetyn tietokonenäön tutkimusta ovat viemässä mattauksen kolmannelle aikakaudelle, asettaen tutkijoille tehtävän kehittää järjestelmiä, jotka pystyvät erottamaan korkealaatuisia mattauksia ilman vihreitä ruutuja. Jo Arxivissa julkaistaan viikoittain artikkeleita, jotka käsittelevät koneoppimiseen perustuvia etualan erottamisen innovaatioita.
Meidät kuviin
Tämä akateemisen ja teollisuuden kiinnostuksen keskus AI‑erottamisessa on jo vaikuttanut kuluttajamarkkinoihin: karkeat mutta toimivat toteutukset ovat meille kaikille tuttuja esimerkiksi Zoom– ja Skype-suodattimien muodossa, jotka voivat korvata olohuoneen taustat trooppisilla saarilla ym. videokonferenssipuheluissa.
Kuitenkin parhaat mattaukset vaativat edelleen vihreän ruudun, kuten Zoom totesi viime keskiviikkona.

Vasemmalla mies vihreän ruudun edessä, jonka hiukset on Zoomin virtuaalitaustatoiminnolla eristetty hyvin. Oikealla nainen tavallisen kotiympäristön edessä, jonka hiukset on erotettu algoritmisesti, vähemmän tarkasti ja suuremmalla laskentateholla. Lähde: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Zoom‑tukialustan lisäpostaus varoittaa, että vihreää ruutua käyttämätön erottaminen vaatii myös suurempaa laskentatehoa tallennuslaitteelta.
Tarve poistaa se
Laatu-, kannettavuus- ja resurssitehokkuusparannukset ‘luonnossa’ toimivissa mattauksen erottamisjärjestelmissä (eli ihmisten erottaminen ilman vihreitä ruutuja) ovat merkityksellisiä monille aloille ja käyttötarkoituksille pelkkien videokonferenssisuodattimien lisäksi.
Aineistojen kehittämisessä parantunut kasvo-, koko pään- ja koko kehon tunnistus tarjoaa mahdollisuuden varmistaa, että ylimääräiset taustaelementit eivät päädy koulutettaviksi tietokonevision malleiksi ihmiskohteista; tarkempi erottaminen parantaisi merkittävästi semanttisen segmentoinnin tekniikoita, jotka on suunniteltu erottamaan ja yhdistämään eri alueita (esim. ‘kissa’, ‘henkilö’, ‘vene’), ja parantaisi VAE– ja transformer-pohjaisten kuvageneraattorijärjestelmien, kuten OpenAI:n uuden DALL-E 2, suorituskykyä; ja paremmat erottamisalgoritmit vähentäisivät kalliiden manuaalisten rotoskooppaus-toimenpiteiden tarvetta kalliissa VFX-putkistoissa.
Itse asiassa monimodaalisten (yleensä teksti/kuva) menetelmien nousu, joissa esimerkiksi ‘kissa’ koodataan sekä kuvana että siihen liittyvinä tekstiviitteinä, on jo läpäissyt kuvankäsittelyn. Yksi tuore esimerkki on Text2Live-arkkitehtuuri, joka käyttää monimodaalia (teksti/kuva) koulutusta luodakseen videoita, muun muassa kristallijoutsenet ja lasikirahvit, muiden lukemattomien mahdollisuuksien joukossa.
Kohtausälykäs AI-mattaus
Merkittävä osa AI-pohjaista automaattista mattaus -tutkimusta on keskittynyt reunojen tunnistamiseen ja pikselipohjaisten ryhmien arviointiin kuvan tai videokehys sisällä. Uusi Kiinan tutkimus tarjoaa sen sijaan erottamisputken, joka parantaa rajaamista ja mattauksen laatua hyödyntämällä tekstipohjaisia kuvauksia kohtauksesta (monimodaalinen lähestymistapa, joka on saanut jalansijaa tietokonevision tutkimussektorilla viimeisten 3–4 vuoden aikana), väittäen parantaneensa aiempia menetelmiä monin tavoin.

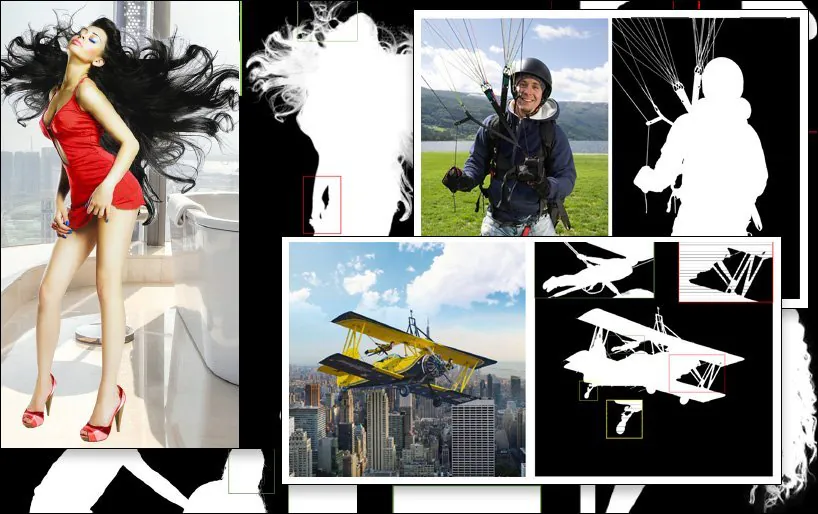
Esimerkki SPG-IM-erottamisesta (viimeinen kuva, oikeassa alakulmassa), verrattuna kilpaileviin aikaisempiin menetelmiin. Lähde: https://arxiv.org/pdf/2204.09276.pdf
Erottamistutkimuksen alasektorin kohtaama haaste on tuottaa työnkulkuja, jotka vaativat mahdollisimman vähän manuaalista merkintää ja ihmisen puuttumista – ihannetapauksessa ei lainkaan. Kustannusvaikutusten lisäksi uuden paperin tutkijat havainnoivat, että ulkoistettujen joukkoistustyöntekijöiden tekemät merkinnät ja manuaaliset segmentoinnit eri kulttuureissa voivat aiheuttaa kuvien merkintöjen tai segmenttien erilaisuutta, mikä johtaa epäjohdonmukaisiin ja epätyydyttäviin algoritmeihin.
Yksi esimerkki tästä on subjektiivinen tulkinta siitä, mitä ‘etualan kohde’ määrittelee:

Uudesta paperista: aikaisemmat menetelmät LFM ja MODNet (‘GT’ tarkoittaa Ground Truthia, ‘ihanteellinen’ tulos, joka usein saavutetaan manuaalisesti tai ei-algoritmisilla menetelmillä), tarjoavat erilaisia ja vaihtelevasti tehokkaita määritelmiä etualuesisällölle, kun taas uusi SPG-IM-menetelmä rajailee ‘läheistä sisältöä’ tarkemmin kohtauskontekstin avulla.
Tämän ratkaisemiseksi tutkijat ovat kehittäneet kaksivaiheisen putken nimeltä Situational Perception Guided Image Matting (SPG-IM). Kaksivaiheinen enkooderi/dekooderi-arkkitehtuuri koostuu Situational Perception Distillation (SPD) -osasta ja Situational Perception Guided Matting (SPGM) -osasta.

SPG-IM-arkkitehtuuri.
Aluksi SPD esikouluttaa visuaalisten piirteiden muuntamista tekstuaalisiksi piirteiksi, luoden kuviin sopivia kuvatekstejä. Tämän jälkeen etualan maskin ennustus mahdollistetaan yhdistämällä putki uuteen saliency‑ennustetekniikkaan.
Sitten SPGM tuottaa arvioidun alfa‑mattauksen raakan RGB‑kuvasyötteen ja ensimmäisessä moduulissa saadun maskin perusteella.
Tavoitteena on tilanteen havaitsemisen ohjaus, jossa järjestelmä ymmärtää kuvan kontekstin, mahdollistaen esimerkiksi monimutkaisen hiusten erottamisen taustasta tunnettujen tehtävän erityispiirteiden perusteella.

Alla olevassa esimerkissä SPG-IM ymmärtää, että köydet ovat olennaisia ‘laskuvarjolle’, kun MODNet ei pysty säilyttämään ja määrittelemään näitä yksityiskohtia. Samoin yllä, leikkikentän rakenteen kokonaisuus katoaa satunnaisesti MODNetissä.
Uusi paperi on nimeltään Situational Perception Guided Image Matting, ja sen ovat laatineet tutkijat OPPO Research Institute -laitoksesta, PicUp.ai:sta ja Xmotorsista.
Älykkäät automatisoidut mattaukset
SPG-IM tarjoaa myös Adaptive Focal Transformation (AFT) -tarkennusverkon, joka pystyy käsittelemään paikallisia yksityiskohtia ja globaalia kontekstia erikseen, mahdollistaen ‘älykkäät mattaukset’.

Kohtauksen kontekstin ymmärtäminen, tässä tapauksessa ‘tyttö hevosen kanssa’, voi mahdollisesti tehdä etualan erottamisesta helpompaa kuin aikaisemmat menetelmät.
Paperin mukaan:
‘Uskomme, että visuaaliset esitykset visuaali‑tekstitehtävästä, esim. kuvatekstien tuottaminen, keskittyvät semanttisesti kattavampiin signaaleihin kohde‑kohde ja kohde‑ympäristö -suhteissa, luoden kuvauksia, jotka kattavat sekä globaalin tiedon että paikalliset yksityiskohdat. Lisäksi, verrattuna kalliiseen pikselimerkintään kuvamattauksessa, tekstimuotoisia merkintöjä voidaan kerätä suuria määriä erittäin alhaisilla kustannuksilla.’
SPD-haara arkkitehtuurissa on yhteisessä esikoulutuksessa Michiganin yliopiston VirTex-transformeripohjaisen tekstidekooderin kanssa, joka oppii visuaalisia esityksiä semanttisesti tiiviistä kuvateksteistä.

VirTex kouluttaa yhdessä ConvNet‑verkkoa ja Transformereita kuva‑kuvateksti‑parien avulla, ja siirtää saadut oivallukset alavirtaisiin näkötehtäviin, kuten objektin tunnistukseen. Lähde: https://arxiv.org/pdf/2006.06666.pdf
Muiden testien ja ablaatiotutkimusten ohella tutkijat testasivat SPG-IM:n verrattuna huipputason trimap-pohjaisiin menetelmiin Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA ja Semantic Image Matting (SIM).
Muita testattuja aikaisempia kehyksiä olivat trimap‑vapaat lähestymistavat LFM, HAttMatting ja MODNet. Reilua vertailua varten testimenetelmät mukautettiin eri metodologioiden perusteella; jos koodia ei ollut saatavilla, paperin tekniikat toteutettiin kuvaillun arkkitehtuurin mukaan.
Uusi paperi toteaa:
‘SPG-IM ylittää kaikki kilpailevat trimap‑vapaat menetelmät ([LFM], [HAttMatting] ja [MODNet]) selvästi. Samalla mallimme osoittaa merkittävää ylivoimaa huipputason (SOTA) trimap‑pohjaisiin ja maski‑ohjattuihin menetelmiin kaikissa neljässä mittarissa julkisissa aineistoissa (Composition-1K, Distinction-646 ja Human-2K), sekä Multi-Object-1K‑vertailussa.’
Ja jatkaa:
‘On selvästi havaittavissa, että menetelmämme säilyttää hienovaraiset yksityiskohdat (esim. hiusten kärjet, läpinäkyvät tekstuurit ja reunat) ilman trimapin ohjausta. Lisäksi verrattuna muihin kilpaileviin trimap-vapaisiin malleihin, SPG-IM säilyttää paremman globaalin semanttisen eheyden.’


Ensimmäinen julkaisu 24. huhtikuuta 2022.