
Andersonin kulma
Ajallisesti yhtenäinen tekoälyvideon muokkaus tekstiohjauksella

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatText2Live mahdollistaa yhtenäiset videomuokkaukset tekstikehotteista ilman…
Näytä lisää
- Text2Live mahdollistaa yhtenäiset videomuokkaukset tekstikehotteista ilman kehyskohtaista käsittelyä.
- Järjestelmä käyttää neuroverkkoon perustuvaa kerrosatlasta soveltaakseen muokkauksia kerran koko videoaikajanalle.
- Text2Live automatisoi maskauksen ja kompositoinnin, poistaen tarpeen rotoskooppaukselle tai vihertöille.
Vaikka ammattimainen VFX-yhteisö on kiinnostunut – ja toisinaan tuntee olonsa hieman uhatuksi – uusista innovaatioista kuvan ja videon synteesissä, useimpien tekoälypohjaisten videonmuokkaushankkeiden puutteellinen ajallinen jatkuvuus rajoittaa monia näistä pyrkimyksistä “psykedeeleiseen” sfääriin, jossa on hohtavia ja nopeasti muuttuvia tekstureja ja rakenteita, epäjohdonmukaisia efektejä ja sellaista karkeaa teknologiaa, joka muistuttaa fotokemiallista aikakautta visuaalisissa efekteissä.
Jos haluat muuttaa jotain erittäin tarkkaa videossa, joka ei kuulu deepfake-väärennösten (ts. asettamalla uusi identiteetti olemassa olevaan henkilön kuvamateriaaliin) alueeseen, useimmat nykyiset ratkaisut toimivat hyvin rajoitetuin ehdoin tuotannonlaadukkaiden visuaalisten efektien osalta.
Yksi poikkeus on Weizmannin tiedeinstituutin tutkijoiden löyhän yhteistyöryhmän jatkuva työ. Vuonna 2021 kolme tutkijaa yhdessä Adoben kanssa julkisti uuden menetelmän videon hajottamiseksi ja yhtenäisen sisäisen kartoituksen – kerroksellisen neuroatlaksen – lisäämiseksi koostettuun tuotokseen, joka sisältää alfakanavat ja aikajatkuvan tuloksen.
(ADBE )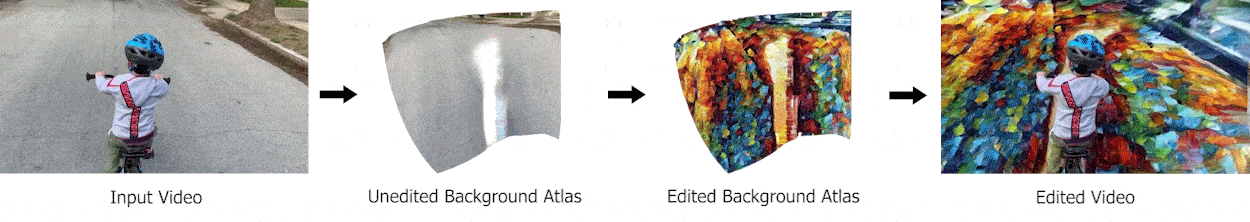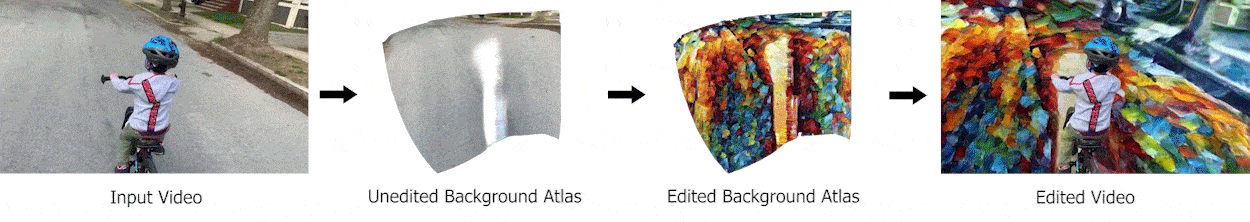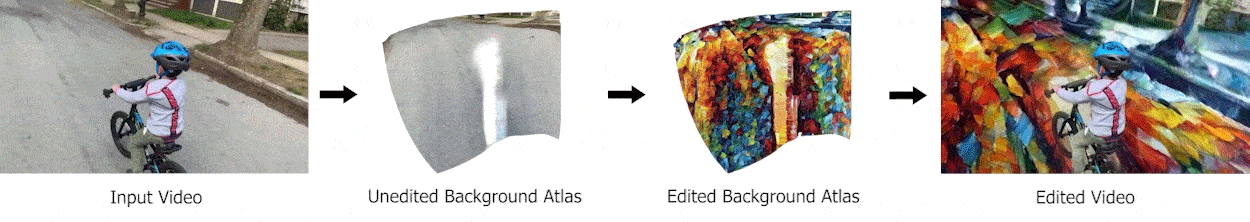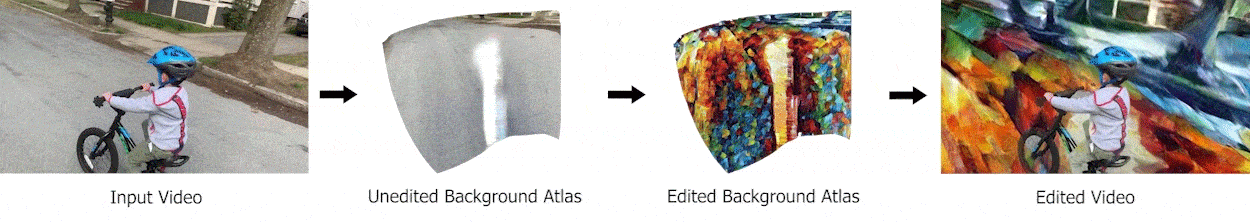
Vuoden 2021 tutkimuksesta: lähdevideon koko tieosuuden arvioitua esitystä muokataan neuroverkolla tavalla, joka perinteisesti vaatisi runsaasti rotoskooppausta ja liikkeensovitusta. Koska eri verkot käsittelevät taustan ja etualan, maskit ovat aidosti «automaattisia». Lähde: https://layered-neural-atlases.github.io/
Vaikka se kuuluu optisen virran alueeseen VFX-tuotantoketjuissa, kerroksellinen atlas ei ole suoraan verrattavissa perinteisiin CGI-työvirtoihin, koska se muodostaa “aikajatkuvan tekstuurikartan”, jota voidaan tuottaa ja muokata perinteisillä ohjelmistomenetelmillä. Edellä olevan kuvan toisessa kuvassa tien pinnan tausta on edustettu (kuvaannollisesti) koko videon ajan. Tämän peruskuvan muuttaminen (kolmas kuva vasemmalta kuvassa) tuottaa johdonmukaisen muutoksen taustassa.
Yllä olevat kuvat «auki levitetystä» atlaksesta esittävät vain yksittäisiä tulkittuja ruutuja. Kohdevideon ruutuihin tehdyt yhtenäiset muutokset kartoitetaan takaisin alkuperäisiin ruutuihin niin, että tarvittavat peittymiset ja muut kohtauksen efektit, kuten varjot ja heijastukset, säilyvät.
Ydinarkkitehtuuri käyttää monikerroksista perseptronia (MLP) esittämään auki levitetyt atlasset, alfakanavat ja kartoitukset. Kaikki optimoidaan yhdessä täysin kaksiulotteisessa avaruudessa, joten NeRF-tyyppistä ennakkotietoa 3D-geometrian pisteistä, syvyyskarttoja tai vastaavia CGI-rakenteita ei tarvita.
Yksittäisten objektien viiteatlas voidaan myös luotettavasti muuttaa:
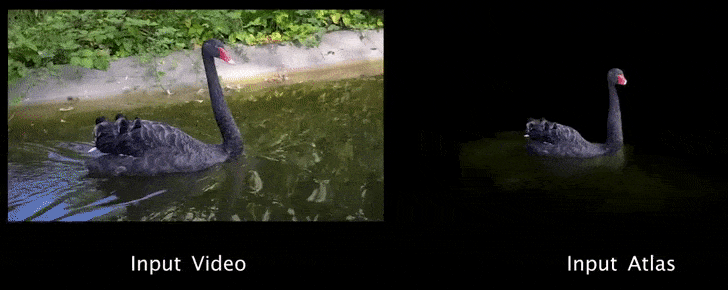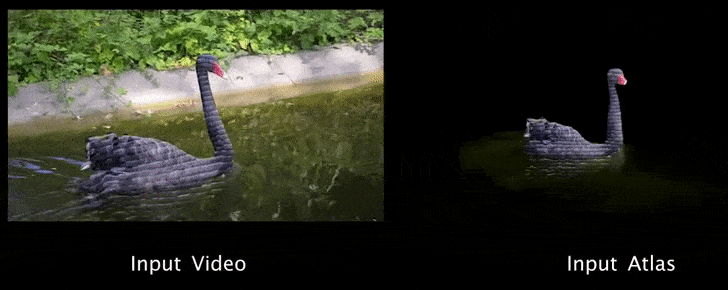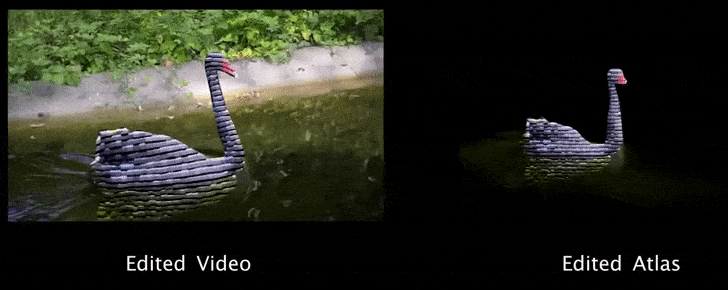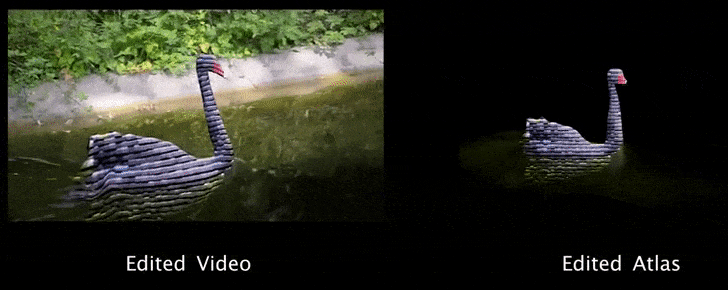
Johdonmukainen muutos liikkuvaan objektiin vuoden 2021 kehyksessä. Lähde: https://www.youtube.com/watch?v=aQhakPFC4oQ
Vuoden 2021 järjestelmä yhdistää geometrian kohdistuksen, liikkeensovituksen, kartoituksen, uudelleenteksturoinnin ja rotoskooppauksen yhdeksi erilliseksi neuroverkkoprosessiksi.
Text2Live
Vuoden 2021 tutkimuksen kolme alkuperäistä tutkijaa, yhdessä NVIDIA (NVDA ) -tutkimuksen kanssa, ovat mukana uudessa innovaatiossa, joka yhdistää kerroksellisten atlaksien voiman teksti-ohjatun CLIP-tekniikan kanssa, joka on palannut julkisuuteen tällä viikolla OpenAI:n julkaisemisen myötä DALL-E 2 -kehykselle.
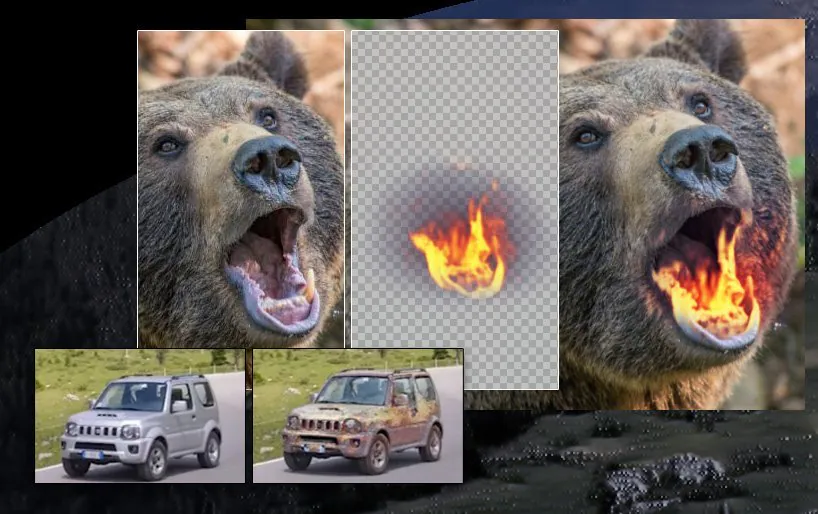
Uusi arkkitehtuuri, joka on nimeltään Text2Live, sallii loppukäyttäjän luoda paikallisia muokkauksia todelliseen videomateriaaliin tekstipohjaisilla ohjauksilla:
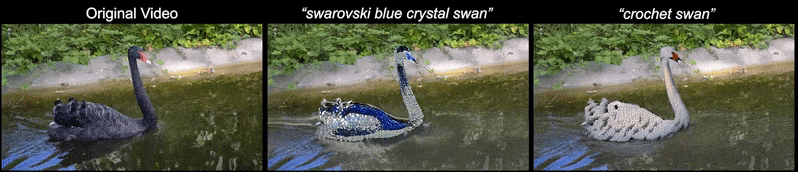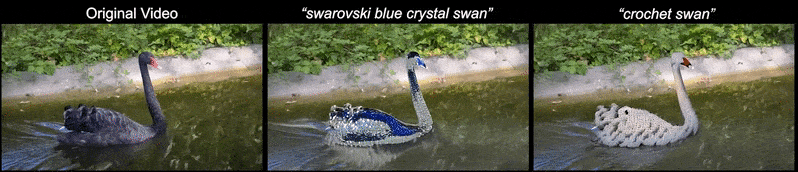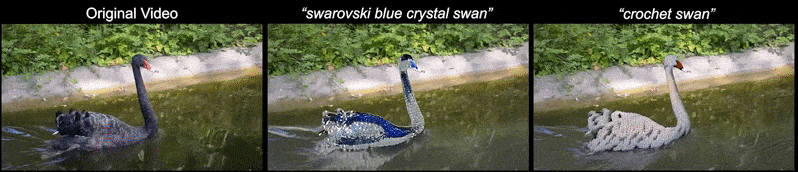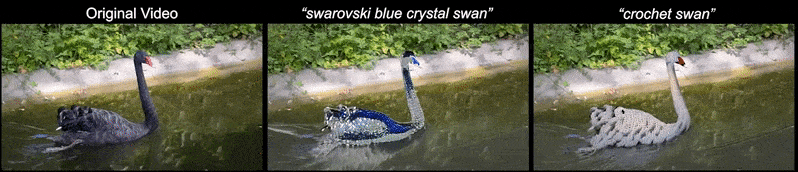
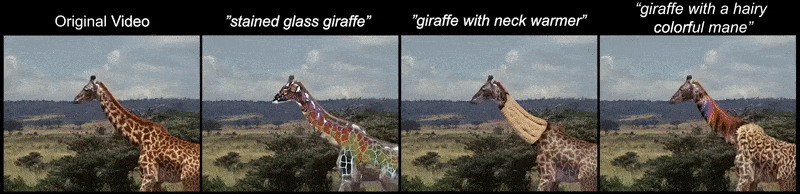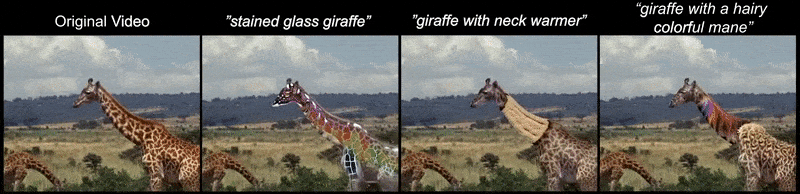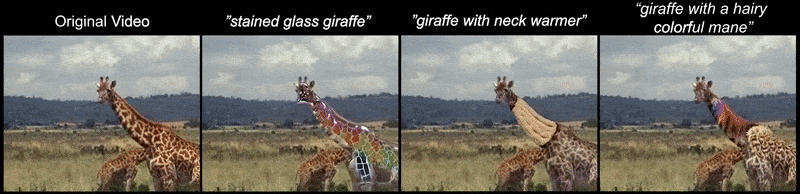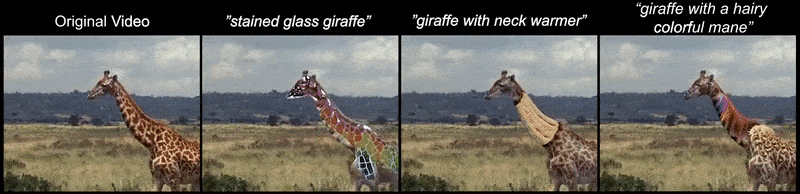
Kaksi esimerkkiä etualueen editoinnista. Alkuperäiset videot paremmalla resoluutiolla ja tarkkuudella ovat osoitteessa https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live mahdollistaa semanttisen ja hyvin paikallisen muokkauksen ilman esikoulutettua generaattoria hyödyntämällä sisäistä tietokantaa, joka on ominainen juuri muokattavalle videoleikkeelle.

Tausta- ja etualueen (objektin) muunnokset Text2Liven alla. Lähde: https://text2live.github.io/sm/pages/video_results_atlases.html
Tekniikka ei vaadi käyttäjän tarjoamaa maskia, kuten tavallisessa rotoskooppaus- tai green screen -työnkulussa, vaan arvioi relevanssikartat alustustekniikalla, joka pohjautuu vuoden 2021 tutkimuksesta Tel Avivin yliopiston tietojenkäsittelytieteen koulusta ja Facebook AI Research (FAIR):sta.

Transformer-pohjaisen yleisen tarkkaavaisuusmallin tuottamat kartat.
Uusi tutkimus on nimeltään Text2LIVE: Teksti-ohjattu kerroksellinen kuva- ja videon editointi. Alkuperäiseen vuoden 2021 tiimiin ovat liittyneet Weizmannin Omer Bar-Tal ja NVIDIA Researchin Yoni Kasten.
Arkkitehtuuri
Text2Live koostuu generoijasta, joka on koulutettu yksittäiselle syötekuvalle ja kohde-tekstiohjauksille. 400 miljoonalla teksti–kuva-parilla esikoulutettu kontrastiivinen kieli–kuva-malli (CLIP) tarjoaa siihen liittyvän visuaalisen aineiston, jonka avulla käyttäjän antamat muunnokset voidaan tulkita.

Generaattori ottaa vastaan syötekuvan eli ruudun ja tuottaa kohde-RGBA-kerroksen, joka sisältää värin ja peittävyyden tiedon. Tämä kerros yhdistetään alkuperäiseen kuvamateriaaliin lisämuokkauksilla.

Tuotetun RGBA-kerroksen alfakanava mahdollistaa sisäisen kompositoinnin ilman perinteisiä työnkulkuja, jotka käyttävät After Effectsin kaltaisia pikselipohjaisia ohjelmistoja.
Oppimalla kohdevideoon tai -kuvaan liittyvistä sisäisistä kuvista Text2Live välttää tarpeen joko kääntää syötekuva Generative Adversarial Networkin (GAN) latenttiavaruuteen, joka on tällä hetkellä kaukana riittävästä tarkkuudesta tuotannonlaadukkaiden videon editoinnin vaatimusten osalta, tai käyttää difuusiomallia, joka on tarkempi ja paremmin säädettävissä, mutta ei voi ylläpitää uskollisuutta kohde-videolle.

Erilaisia Text2Liven tekstikehotteisiin perustuvia muunnoksia.
Aikaisemmat lähestymistavat ovat käyttäneet muutosten levittämiseen perustuvia menetelmiä tai optisen virran perusteisia lähestymistapoja. Koska nämä tekniikat ovat jossain määrin kehyspohjaisia, kumpikaan ei pysty säilyttämään muokkausten ulkoasua ajallisesti yhtenäisenä tulosvideossa. Neuronaalinen kerroksellinen atlas tarjoaa yksittäisen avaruuden, jossa muutokset voidaan kohdistaa, ja ne voidaan pitää uskollisina tehtyyn muutokseen videon edetessä.
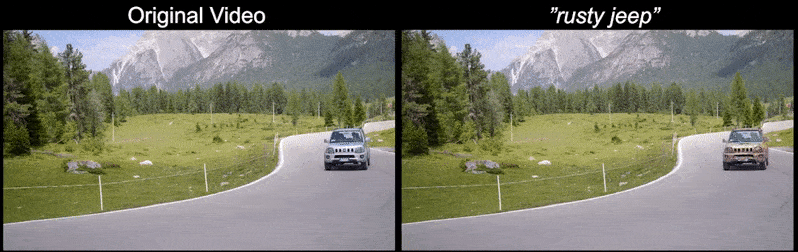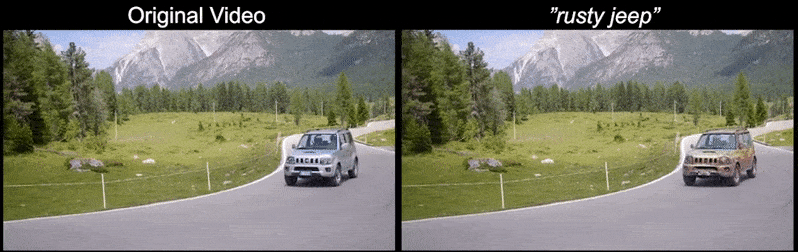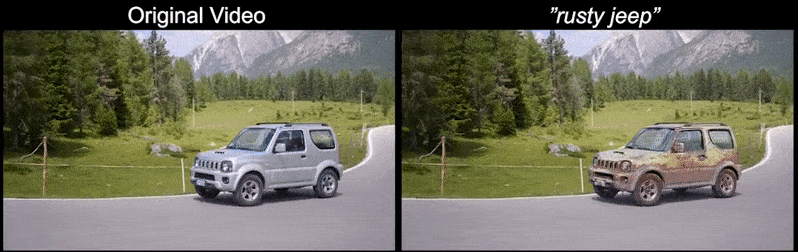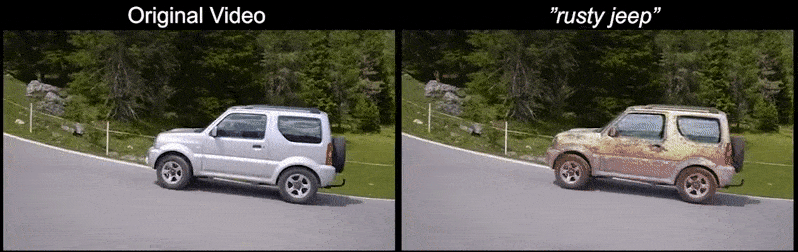
Ei «väreilyä» tai satunnaisia hallusinaatioita: Text2Live saa tulkinnan teksti-ohjauksesta «rusty jeep» eli «ruosteinen jeeppi», ja soveltaa sitä kerran neuronaaliseen kerrokselliseen atlas-objektiin videossa, sen sijaan, että aloittaisi muunnoksen uudelleen jokaiselle tulkittavalle kehykselle.

Text2Liven johdonmukainen muunnos Jeepistä ruostuneeksi romuksi.
Text2Live on lähempänä läpimurtoa AI-pohjaisessa kompositiossa, eikä niinkään teksti-kuva-avaruudessa, joka on herättänyt paljon huomiota tällä viikolla OpenAI:n toisen sukupolven DALL-E-kehyksen julkaisemisen myötä (joka voi sisällyttää kohdekuvia muunnosprosessiin mutta jonka kyky muokata valokuvaa suoraan on rajallinen; lisäksi sitä rajoittavat lähdekoulutusdatan sensurointi ja suodattimien käyttö, jotka on suunniteltu estämään käyttäjien väärinkäyttöä).
Sen sijaan Text2Live sallii loppukäyttäjän poimia atlaksen ja muokata sitä yhdellä kertaa tarkkaa hallintaa tarjoavissa pikselipohjaisissa ympäristöissä, kuten Photoshopissa (ja ehkä vielä abstraktimmissa kuvansynteesirunkoissa, kuten NeRF), ennen kuin se syötetään takaisin oikein suunnattuun ympäristöön, joka ei kuitenkaan riipu 3D-estimaatiosta tai vanhoihin käytäntöihin nojaavista CGI-lähestymistavoista.
Lisäksi Text2Live on, tutkijoiden mukaan, ensimmäinen vertailukelpoinen kehys, joka saavuttaa maskauksen ja kompositoinnin täysin automaattisella tavalla.
Julkaistu ensimmäisen kerran 7. huhtikuuta 2022.





