
Modelos y plataformas de IA
Dentro de o3 y o4-mini de OpenAI: Desbloqueando nuevas posibilidades a través de la razonamiento multimodal y conjuntos de herramientas integrados

 Añade Unite.AI a tus fuentes preferidas en Google
El 16 de abril de 2025, OpenAI lanzó versiones mejoradas de sus modelos de razonamiento avanzado. Estos nuevos modelos, llamados o3 y o4-mini, ofrecen mejoras con respecto a sus predecesores, o1 y o3-mini, respectivamente. Los modelos más recientes ofrecen un rendimiento mejorado, nuevas características y una mayor accesibilidad. Este artículo explora los beneficios principales de o3 y o4-mini, describe sus capacidades principales y analiza cómo podrían influir en el futuro de las aplicaciones de inteligencia artificial. Pero antes de sumergirnos en lo que hace que o3 y o4-mini sean distintos, es importante entender cómo han evolucionado los modelos de OpenAI con el tiempo. Comencemos con una visión general breve de la evolución de OpenAI en el desarrollo de sistemas de lenguaje y razonamiento cada vez más potentes.
La evolución de los grandes modelos de lenguaje de OpenAI
El desarrollo de grandes modelos de lenguaje de OpenAI comenzó con GPT-2 y GPT-3, que llevaron a ChatGPT al uso mainstream debido a su capacidad para producir texto fluido y contextualmente preciso. Estos modelos se adoptaron ampliamente para tareas como la resumen, la traducción y la respuesta a preguntas. Sin embargo, a medida que los usuarios los aplicaban a escenarios más complejos, se hicieron evidentes sus limitaciones. Estos modelos a menudo luchaban con tareas que requerían un razonamiento profundo, coherencia lógica y resolución de problemas en varios pasos. Para abordar estos desafíos, OpenAI introdujo GPT-4, y cambió su enfoque hacia la mejora de las capacidades de razonamiento de sus modelos. Este cambio llevó al desarrollo de o1 y o3-mini. Ambos modelos utilizaron un método llamado chain-of-thought prompting, que les permitió generar respuestas más lógicas y precisas al razonar paso a paso. Mientras que o1 está diseñado para satisfacer necesidades de resolución de problemas avanzados, o3-mini está construido para ofrecer capacidades similares de manera más eficiente y rentable. Sobre esta base, OpenAI ha introducido ahora o3 y o4-mini, que mejoran aún más las capacidades de razonamiento de sus LLM. Estos modelos están diseñados para producir respuestas más precisas y bien consideradas, especialmente en campos técnicos como la programación, las matemáticas y el análisis científico—dominios donde la precisión lógica es crucial. En la siguiente sección, examinaremos cómo o3 y o4-mini mejoran a sus predecesores.
Avances clave en o3 y o4-mini
Capacidades de razonamiento mejoradas
Una de las mejoras clave en o3 y o4-mini es su capacidad de razonamiento mejorada para tareas complejas. A diferencia de los modelos anteriores que ofrecían respuestas rápidas, o3 y o4-mini toman más tiempo para procesar cada prompt. Este procesamiento adicional les permite razonar de manera más exhaustiva y producir respuestas más precisas, lo que conduce a mejores resultados en las pruebas. Por ejemplo, o3 supera a o1 en un 9% en LiveBench.ai, una prueba que evalúa el rendimiento en múltiples tareas complejas como la lógica, las matemáticas y el código. En el SWE-bench, que prueba el razonamiento en tareas de ingeniería de software, o3 logró una puntuación de 69.1%, superando incluso a modelos competitivos como Gemini 2.5 Pro, que obtuvo 63.8%. Mientras tanto, o4-mini obtuvo un 68.1% en la misma prueba, ofreciendo casi la misma profundidad de razonamiento a un costo mucho menor.
Integración multimodal: Pensar con imágenes
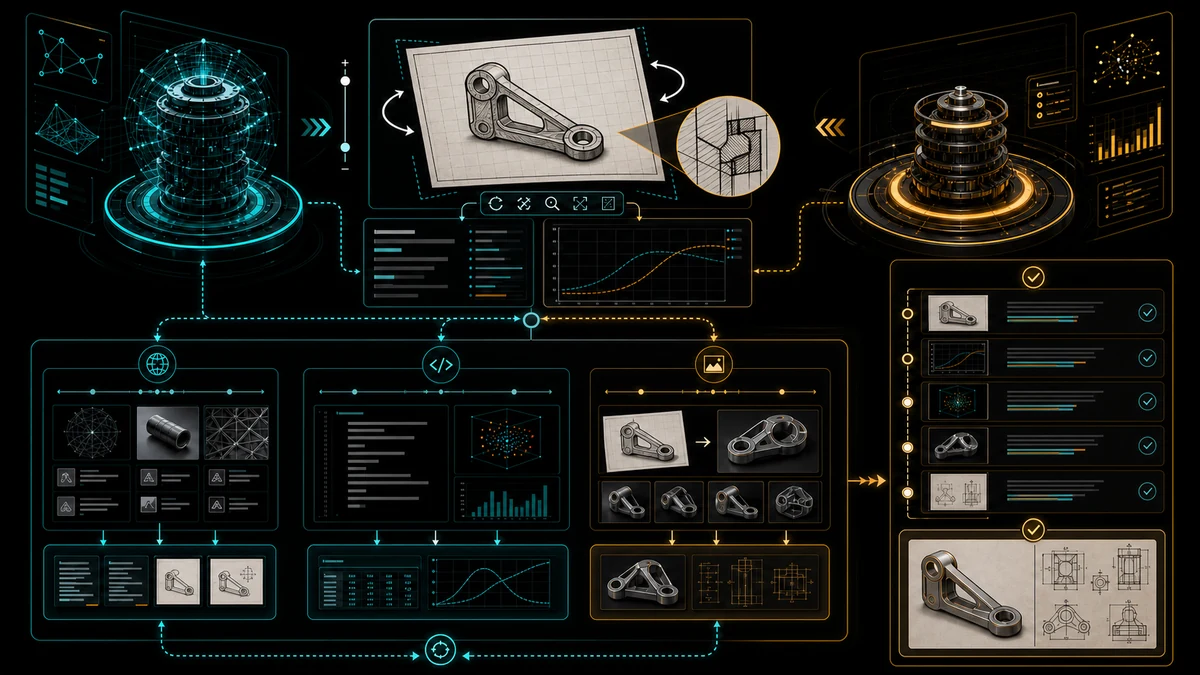
Una de las características más innovadoras de o3 y o4-mini es su capacidad para “pensar con imágenes”. Esto significa que no solo pueden procesar información textual, sino que también pueden integrar datos visuales directamente en su proceso de razonamiento. Pueden entender y analizar imágenes, incluso si son de baja calidad—como notas manuscritas, bocetos o diagramas. Por ejemplo, un usuario podría subir un diagrama de un sistema complejo, y el modelo podría analizarlo, identificar posibles problemas o incluso sugerir mejoras. Esta capacidad cierra la brecha entre los datos textuales y visuales, permitiendo interacciones más intuitivas y exhaustivas con la inteligencia artificial. Ambos modelos pueden realizar acciones como acercar detalles o rotar imágenes para entenderlas mejor. Este razonamiento multimodal es un avance significativo sobre los predecesores como o1, que eran principalmente basados en texto. Abre nuevas posibilidades para aplicaciones en campos como la educación, donde los recursos visuales son cruciales, y la investigación, donde los diagramas y gráficos son a menudo centrales para la comprensión.
Uso avanzado de herramientas
o3 y o4-mini son los primeros modelos de OpenAI en utilizar todas las herramientas disponibles en ChatGPT simultáneamente. Estas herramientas incluyen:
- Navegación web: Permitiendo a los modelos obtener la información más reciente para consultas sensibles al tiempo.
- Ejecución de código Python: Permitiéndoles realizar cálculos complejos o análisis de datos.
- Procesamiento y generación de imágenes: Mejorando su capacidad para trabajar con datos visuales.
Al emplear estas herramientas, o3 y o4-mini pueden resolver problemas complejos y multietapa de manera más efectiva. Por ejemplo, si un usuario hace una pregunta que requiere datos actuales, el modelo puede realizar una búsqueda en la web para obtener la información más reciente. De manera similar, para tareas que involucran análisis de datos, puede ejecutar código Python para procesar los datos. Esta integración es un paso significativo hacia agentes de inteligencia artificial más autónomos que puedan manejar una gama más amplia de tareas sin intervención humana. La introducción de Codex CLI, un agente de codificación ligero y de código abierto que funciona con o3 y o4-mini, aumenta aún más su utilidad para los desarrolladores.
Implicaciones y nuevas posibilidades
El lanzamiento de o3 y o4-mini tiene implicaciones generalizadas en various industrias:
- Educación: Estos modelos pueden asistir a estudiantes y maestros proporcionando explicaciones detalladas y recursos visuales, haciendo que el aprendizaje sea más interactivo y efectivo. Por ejemplo, un estudiante podría subir un boceto de un problema de matemáticas, y el modelo podría proporcionar una solución paso a paso.
- Investigación: Pueden acelerar el descubrimiento analizando conjuntos de datos complejos, generando hipótesis e interpretando datos visuales como gráficos y diagramas, lo cual es invaluable para campos como la física o la biología.
- Industria: Pueden optimizar procesos, mejorar la toma de decisiones y mejorar las interacciones con los clientes al manejar tanto consultas textuales como visuales, como analizar diseños de productos o solucionar problemas técnicos.
- Creatividad y medios: Los autores pueden usar estos modelos para convertir esquemas de capítulos en storyboards simples. Los músicos pueden emparejar visuales con una melodía. Los editores de cine reciben sugerencias de ritmo. Los arquitectos convierten planos de pisos manuscritos en planos detallados 3D que incluyen notas estructurales y de sostenibilidad.
- Accesibilidad e inclusión: Para usuarios ciegos, los modelos describen imágenes con detalle. Para usuarios sordos, convierten diagramas en secuencias visuales o texto con subtítulos. Su traducción de palabras y visuales ayuda a cerrar brechas lingüísticas y culturales.
- Hacia agentes autónomos: Debido a que los modelos pueden navegar por la web, ejecutar código y procesar imágenes en un flujo de trabajo, forman la base para agentes autónomos. Los desarrolladores describen una característica; el modelo escribe, prueba y despliega el código. Los trabajadores del conocimiento pueden delegar la recopilación de datos, el análisis, la visualización y la redacción de informes a un solo asistente de inteligencia artificial.
Limitaciones y qué sigue
A pesar de estos avances, o3 y o4-mini todavía tienen un corte de conocimiento de agosto de 2023, lo que limita su capacidad para responder a los eventos o tecnologías más recientes a menos que se suplemente con navegación web. Las iteraciones futuras probablemente abordarán esta brecha mejorando la ingesta de datos en tiempo real.
También podemos esperar un progreso adicional en agentes de inteligencia artificial autónomos—sistemas que pueden planificar, razonar, actuar y aprender continuamente con una supervisión mínima. La integración de OpenAI de herramientas, modelos de razonamiento y acceso a datos en tiempo real señala que nos estamos acercando a tales sistemas.
En resumen
Los nuevos modelos de OpenAI, o3 y o4-mini, ofrecen mejoras en el razonamiento, la comprensión multimodal y la integración de herramientas. Son más precisos, versátiles y útiles en una amplia gama de tareas, desde analizar datos complejos y generar código hasta interpretar imágenes. Estos avances tienen el potencial de mejorar significativamente la productividad y acelerar la innovación en diversas industrias.





