
Μοντέλα και πλατφόρμες AI
Το πρόβλημα του μαύρου κουτιού στα LLM: Προκλήσεις και αναδυόμενες λύσεις

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Η μηχανική μάθηση, ένα υποσύνολο της τεχνητής νοημοσύνης, περιλαμβάνει τρία συστατικά: αλγόριθμους, δεδομένα εκπαίδευσης και το μοντέλο που προκύπτει. Ένας αλγόριθμος, ουσιαστικά ένα σύνολο διαδικασιών, μαθαίνει να αναγνωρίζει μοτίβα από ένα μεγάλο σύνολο παραδειγμάτων (δεδομένα εκπαίδευσης). Το αποτέλεσμα αυτής της εκπαίδευσης είναι ένα μοντέλο μηχανικής μάθησης. Για παράδειγμα, ένας αλγόριθμος εκπαιδευμένος με εικόνες σκύλων θα οδηγήσει σε ένα μοντέλο ικανό να αναγνωρίζει σκύλους σε εικόνες.
Το Μαύρο Κουτί στη Μηχανική Μάθηση
Στη μηχανική μάθηση, οποιοδήποτε από τα τρία συστατικά – αλγόριθμος, δεδομένα εκπαίδευσης ή μοντέλο – μπορεί να είναι ένα μαύρο κουτί. Ενώ οι αλγόριθμοι είναι συχνά δημόσια γνωστοί, οι προγραμματιστές μπορεί να επιλέξουν να κρατήσουν το μοντέλο ή τα δεδομένα εκπαίδευσης μυστικά για να προστατεύσουν την πνευματική ιδιοκτησία. Αυτή η αδιαφάνεια καθιστά δύσκολο να κατανοηθεί η διαδικασία λήψης αποφάσεων του AI.
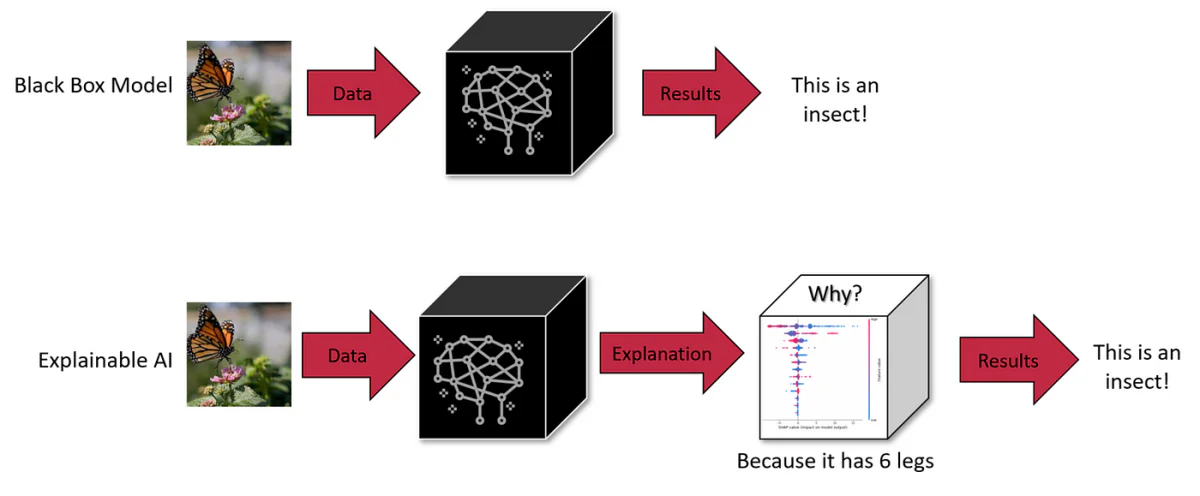
Τα μαύρα κουτιά του AI είναι συστήματα των οποίων οι εσωτερικές λειτουργίες παραμένουν αδιαφανείς ή αόρατες στους χρήστες. Οι χρήστες μπορούν να εισαγάγουν δεδομένα και να λαμβάνουν έξοδο, αλλά η λογική ή ο κώδικας που παράγει την έξοδο παραμένει κρυφός. Αυτό είναι ένα κοινό χαρακτηριστικό σε πολλά συστήματα AI, συμπεριλαμβανομένων των προηγμένων παραγωγικών μοντέλων όπως το ChatGPT και το DALL-E 3.
Οι LLM όπως το GPT-4 παρουσιάζουν μια σημαντική πρόκληση: οι εσωτερικές λειτουργίες τους είναι σε μεγάλο βαθμό αδιαφανείς, καθιστώντας τα “μαύρα κουτιά”. Αυτή η αδιαφάνεια δεν είναι μόνο ένα τεχνικό πρόβλημα, αλλά και ένα πραγματικό πρόβλημα ασφάλειας και ηθικής. Για παράδειγμα, αν δεν μπορούμε να κατανοήσουμε πώς αυτά τα συστήματα φτάνουν σε συμπεράσματα, μπορούμε να τους εμπιστευθούμε σε κρίσιμες περιοχές όπως οι ιατρικές διαγνώσεις ή οι οικονομικές αξιολογήσεις;


Η Κλίμακα και η Πολυπλοκότητα των LLM
Η κλίμακα αυτών των μοντέλων προστίθεται στην πολυπλοκότητά τους. Πάρτε, για παράδειγμα, το GPT-3, με τα 175 δισεκατομμύρια παραμέτρους του, και τα νεότερα μοντέλα με τρισεκατομμύρια. Κάθε παράμετρος αλληλεπιδρά με πολύπλοκους τρόπους μέσα στο νευρωνικό δίκτυο, συνεισφέροντας σε αναδυόμενες ικανότητες που δεν προβλέπονται με την εξέταση των μεμονωμένων συστατικών μόνο. Αυτή η κλίμακα και πολυπλοκότητα καθιστά σχεδόν αδύνατο να κατανοηθεί πλήρως η εσωτερική λογική τους, δημιουργώντας ένα εμπόδιο στη διάγνωση των προκαταλήψεων ή των ανεπιθύμητων συμπεριφορών σε αυτά τα μοντέλα.
Η Συμβιβαστική Λύση: Κλίμακα vs. Ερμηνευσιμότητα
Η μείωση της κλίμακας των LLM θα μπορούσε να βελτιώσει την ερμηνευσιμότητα, αλλά με το κόστος των προηγμένων ικανοτήτων τους. Η κλίμακα είναι αυτό που επιτρέπει τις συμπεριφορές που τα μικρότερα μοντέλα δεν μπορούν να επιτύχουν. Αυτό παρουσιάζει μια εγγενή συμβιβαστική λύση μεταξύ κλίμακας, ικανότητας και ερμηνευσιμότητας.
Επίδραση του Προβλήματος του Μαύρου Κουτιού των LLM
1. Ελαττωματική Λήψη Αποφάσεων
Η αδιαφάνεια στη διαδικασία λήψης αποφάσεων των LLM όπως το GPT-3 ή το BERT μπορεί να οδηγήσει σε μη ανιχνευμένες προκαταλήψεις και σφάλματα. Σε τομείς όπως η υγεία ή η ποινική δικαιοσύνη, όπου οι αποφάσεις έχουν μακροπρόθεσμες συνέπειες, η αδυναμία να ελεγχθούν τα LLM για ηθική και λογική ακρίβεια είναι μια σημαντική ανησυχία. Για παράδειγμα, ένα ιατρικό LLM που βασίζεται σε παλιά ή προκατειλημμένα δεδομένα μπορεί να κάνει βλαβερές συστάσεις. Παρόμοια, τα LLM στις διαδικασίες πρόσληψης μπορεί να διαιωνίσουν ακούσια έμφυλες προκαταλήψεις. Η φύση του μαύρου κουτιού όχι μόνο κρύβει ελαττώματα, αλλά μπορεί επίσης να τα ενισχύσει, απαιτώντας μια προληπτική προσέγγιση για την ενίσχυση της διαφάνειας.
2. Περιορισμένη Προσαρμοστικότητα σε Διαφορετικά Πλαίσια
Η έλλειψη εποπτείας στις εσωτερικές λειτουργίες των LLM περιορίζει την προσαρμοστικότητά τους. Για παράδειγμα, ένα LLM πρόσληψης μπορεί να είναι ανεπαρκές στην αξιολόγηση των υποψηφίων για έναν ρόλο που αξιολογεί τις πρακτικές ικανότητες πάνω από τις ακαδημαϊκές προϋποθέσεις, λόγω της αδυναμίας του να προσαρμόσει τα κριτήρια αξιολόγησής του. Παρόμοια, ένα ιατρικό LLM μπορεί να δυσκολευτεί με σπάνιες διαγνώσεις ασθενειών λόγω των ανισορροπιών στα δεδομένα. Αυτή η ακαμψία υπογραμμίζει την ανάγκη για διαφάνεια για να επαναρυθμίσει τα LLM για συγκεκριμένες εργασίες και πλαίσια.
3. Προκατάληψη και Κενά Γνώσης
Η επεξεργασία των LLM μεγάλων συνόλων δεδομένων εκπαίδευσης υπόκειται στους περιορισμούς που επιβάλλονται από τους αλγόριθμους και τις αρχιτεκτονικές των μοντέλων. Για παράδειγμα, ένα ιατρικό LLM μπορεί να δείξει δημογραφικές προκαταλήψεις εάν εκπαιδευτεί σε μη ισορροπημένα δεδομένα. Επίσης, η ικανότητα ενός LLM σε εξειδικευμένα θέματα μπορεί να είναι παραπλανητική, οδηγώντας σε υπερβολικά βέβαιες, λανθασμένες εξόδους. Η αντιμετώπιση αυτών των προκαταλήψεων και κενών γνώσης απαιτεί περισσότερο από το να προστεθούν περισσότερα δεδομένα· απαιτεί μια εξέταση των μηχανισμών επεξεργασίας του μοντέλου.
4. Νομική και Ηθική Ευθύνη
Η αδιαφάνεια των LLM δημιουργεί μια νομική γκρίζα ζώνη σχετικά με την ευθύνη για οποιαδήποτε ζημία που προκαλείται από τις αποφάσεις τους. Αν ένα LLM σε ιατρικό περιβάλλον παρέχει ελαττωματικές συμβουλές που οδηγούν σε ζημία του ασθενούς, ο καθορισμός της ευθύνης γίνεται δύσκολος λόγω της αδιαφάνειας του μοντέλου. Αυτή η νομική αβεβαιότητα δημιουργεί κινδύνους για οντότητες που αναπτύσσουν LLM σε ευαίσθητες περιοχές, υπογραμμίζοντας την ανάγκη για σαφή διακυβέρνηση και διαφάνεια.
5. Θέματα Εμπιστοσύνης σε Ευαίσθητες Εφαρμογές
Για τα LLM που χρησιμοποιούνται σε κρίσιμες περιοχές όπως η υγεία και η οικονομία, η έλλειψη διαφάνειας υπονομεύει την αξιοπιστία τους. Οι χρήστες και οι ρυθμιστές πρέπει να διασφαλίσουν ότι αυτά τα μοντέλα δεν κρύβουν προκαταλήψεις ή δεν λαμβάνουν αποφάσεις με βάση άδικα κριτήρια. Η επαλήθευση της απουσίας προκαταλήψεων στα LLM απαιτεί μια κατανόηση των διαδικασιών λήψης αποφάσεων τους, υπογραμμίζοντας τη σημασία της ερμηνευσιμότητας για την ηθική ανάπτυξη.
6. Κίνδυνοι με Προσωπικά Δεδομένα
Τα LLM απαιτούν εκτενή δεδομένα εκπαίδευσης, τα οποία μπορεί να περιλαμβάνουν ευαίσθητες προσωπικές πληροφορίες. Η αδιαφάνεια των μοντέλων αυτών δημιουργεί ανησυχίες σχετικά με τον τρόπο με τον οποίο αυτά τα δεδομένα επεξεργάζονται και χρησιμοποιούνται. Για παράδειγμα, ένα ιατρικό LLM που εκπαιδεύεται σε ιατρικά αρχεία ασθενών δημιουργεί ερωτήματα σχετικά με την προστασία των δεδομένων και τη χρήση τους. Η διασφάλιση ότι τα προσωπικά δεδομένα δεν χρησιμοποιούνται λανθασμένα ή δεν εκμεταλλεύονται απαιτεί διαφανείς διαδικασίες επεξεργασίας δεδομένων μέσα σε αυτά τα μοντέλα.
Αναδυόμενες Λύσεις για Ερμηνευσιμότητα
Για να αντιμετωπίσουν αυτές τις προκλήσεις, αναπτύσσονται νέες τεχνικές. Αυτές περιλαμβάνουν μεθόδους προσέγγισης αντιπαραθετικών περιπτώσεων. Η πρώτη μέθοδος περιλαμβάνει την προώθηση ενός LLM να αλλάξει μια συγκεκριμένη έννοια κειμένου ενώ διατηρεί άλλες ιδέες σταθερές. Αυτή η προσέγγιση, αν και αποτελεσματική, είναι απαιτητική σε πόρους κατά την εξαγωγή συμπερασμάτων.
Η δεύτερη προσέγγιση περιλαμβάνει τη δημιουργία ενός αφιερωμένου χώρου ενσωμάτωσης που καθοδηγείται από ένα LLM κατά την εκπαίδευση. Αυτός ο χώρος ευθυγραμμίζεται με ένα αιτιολογικό γράφο και βοηθά στην αναγνώριση αντιστοιχίσεων που προσεγγίζουν αντιπαραθετικές περιπτώσεις. Αυτή η μέθοδος απαιτεί λιγότερους πόρους κατά τον χρόνο δοκιμής και έχει αποδειχθεί ότι εξηγεί αποτελεσματικά τις προβλέψεις του μοντέλου, ακόμη και σε LLM με δισεκατομμύρια παραμέτρους.
Αυτές οι προσεγγίσεις υπογραμμίζουν τη σημασία των αιτιολογικών εξηγήσεων στα συστήματα NLP για να διασφαλίσουν την ασφάλεια και να καθιερώσουν την εμπιστοσύνη. Οι αντιπαραθετικές προσεγγίσεις επιτρέπουν να φανταστούμε πώς θα άλλαζε ένα κείμενο αν μια συγκεκριμένη έννοια στη διαδικασία παραγωγής του ήταν διαφορετική. Αυτό βοηθά στην πρακτική εκτίμηση των αιτιακών επιδράσεων εννοιών υψηλού επιπέδου στα μοντέλα NLP.
Βαθιά Εισαγωγή: Μέθοδοι Εξηγήσεων και Αιτιολογία στις LLM
Εργαλεία Εξετάσεων και Σημαντικότητας Χαρακτηριστικών
Η εξέταση είναι μια τεχνική που χρησιμοποιείται για να αποκρυπτογραφηθεί τι εσωτερικές αναπαραστάσεις σε μοντέλα κωδικοποιούν. Μπορεί να είναι είτε επιβλεπόμενη είτε ανεπιβλεπόμενη και έχει ως στόχο να καθορίσει εάν συγκεκριμένες έννοιες κωδικοποιούνται σε συγκεκριμένα σημεία του δικτύου. Αν και αποτελεσματική μέχρι ένα σημείο, οι εξετάσεις δεν παρέχουν αιτιολογικές εξηγήσεις, όπως υπογραμμίζεται από τους Geiger et al. (2021).
Τα εργαλεία σημαντικότητας χαρακτηριστικών, μια άλλη μορφή μεθόδου εξήγησης, επικεντρώνονται συχνά στις χαρακτηριστικά εισόδου, αν και μερικές μέθοδοι που βασίζονται στο gradient επεκτείνουν αυτήν την ανάλυση στις κρυφές καταστάσεις. Ένα παράδειγμα είναι η μέθοδος Ολοκληρωμένων Gradient, η οποία προσφέρει μια αιτιολογική ερμηνεία εξετάζοντας τις εισόδους αναφοράς (αντιπαραθετικές, CF). Παρά την χρησιμότητά τους, αυτές οι μέθοδοι ακόμη δυσκολεύονται να συνδέσουν τις αναλύσεις τους με πραγματικές έννοιες πέρα από τις απλές ιδιότητες εισαγωγής.
Μέθοδοι Βασισμένες σε Παρέμβαση
Οι μέθοδοι βασισμένες σε παρέμβαση περιλαμβάνουν την τροποποίηση εισαγωγών ή εσωτερικών αναπαραστάσεων για να μελετήσουν τις επιπτώσεις στη συμπεριφορά του μοντέλου. Αυτές οι μέθοδοι μπορούν να δημιουργήσουν αντιπαραθετικές καταστάσεις για να εκτιμήσουν αιτιολογικές επιπτώσεις, αλλά συχνά παράγουν απίστευτες εισαγωγές ή καταστάσεις δικτύου, εκτός εάν ελεγχθούν προσεκτικά. Το Αιτιακό Υποκατάστατο Μοντέλο (CPM), εμπνευσμένο από την έννοια του S-learner, είναι μια νέα προσέγγιση σε αυτόν τον χώρο, μιμούμενη τη συμπεριφορά του εξηγημένου μοντέλου υπό αντιπαραθετικές εισόδους. Ωστόσο, η ανάγκη για έναν ξεχωριστό επεξηγητή για κάθε μοντέλο είναι ένας σημαντικός περιορισμός.
Προσέγγιση Αντιπαραθετικών Περιπτώσεων
Οι αντιπαραθετικές περιπτώσεις χρησιμοποιούνται ευρέως στη μηχανική μάθηση για την επέκταση δεδομένων, που περιλαμβάνει διαταραχές σε διάφορους παράγοντες ή ετικέτες. Αυτές μπορούν να δημιουργηθούν μέσω χειροκίνητης επεξεργασίας, ευρετικής αντικατάστασης λέξεων-κλειδιών ή αυτόματης ανασυγγραφής κειμένου. Αν και η χειροκίνητη επεξεργασία είναι ακριβής, είναι επίσης πόρων-εντατική. Οι μέθοδοι που βασίζονται σε λέξεις-κλειδιά έχουν τους περιορισμούς τους, και οι γεννητικές προσεγγίσεις προσφέρουν μια ισορροπία μεταξύ ευφράδειας και κάλυψης.
Πιστές Εξηγήσεις
Η πιστότητα στις εξηγήσεις αναφέρεται στην ακριβή απεικόνιση της υποκείμενης λογικής του μοντέλου. Δεν υπάρχει καθολικά αποδεκτός ορισμός της πιστότητας, οδηγώντας στην χαρακτηριστική της μέσω διαφόρων μετρήσεων όπως Ευαισθησία, Συνέπεια, Συμφωνία Σημαντικότητας Χαρακτηριστικών, Ανθεκτικότητας και Δυνατότητας Προσομοίωσης. Οι περισσότερες από αυτές τις μέθοδοι επικεντρώνονται στις εξηγήσεις επιπέδου χαρακτηριστικών και συχνά συγχέουν συσχέτιση με αιτιολογία. Η δουλειά μας έχει ως στόχο να παρέχει εξηγήσεις υψηλού επιπέδου εννοιών, αξιοποιώντας τη βιβλιογραφία της αιτιολογίας για να προτείνει ένα διαισθητικό κριτήριο: Πιστότητα Διάταξης (Order-Faithfulness).
Έχουμε εισαχθεί στις εγγενείς πολυπλοκότητες των LLM, κατανοώντας τη φύση του ‘μαύρου κουτιού’ και τις σημαντικές προκλήσεις που θέτει. Από τους κινδύνους της ελαττωματικής λήψης αποφάσεων σε ευαίσθητες περιοχές όπως η υγεία και η οικονομία, μέχρι τα ηθικά διλήμματα που περιβάλλουν τις προκαταλήψεις και την αξιοπιστία, η ανάγκη για διαφάνεια στις LLM δεν ήταν ποτέ πιο εμφανής.
Το μέλλον των LLM και η ενσωμάτωσή τους στις καθημερινές μας ζωές και τις κρίσιμες διαδικασίες λήψης αποφάσεων εξαρτάται από την ικανότητά μας να κάνουμε αυτά τα μοντέλα όχι μόνο πιο προηγμένα, αλλά και πιο κατανοητά και υπεύθυνα. Η επιδίωξη της εξηγησιμότητας και της ερμηνευσιμότητας δεν είναι μόνο μια τεχνική προσπάθεια, αλλά και ένα θεμελιώδες στοιχείο της κατασκευής εμπιστοσύνης στα συστήματα AI. Όσο τα LLM γίνονται πιο ενσωματωμένα στην κοινωνία, η ζήτηση για διαφάνεια θα αυξηθεί, όχι μόνο από τους επαγγελματίες του AI, αλλά και από κάθε χρήστη που αλληλεπιδρά με αυτά τα συστήματα.


