
Μοντέλα και πλατφόρμες AI
TensorRT-LLM: Πλήρης οδηγός βελτιστοποίησης της εκτέλεσης μεγάλων γλωσσικών μοντέλων

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
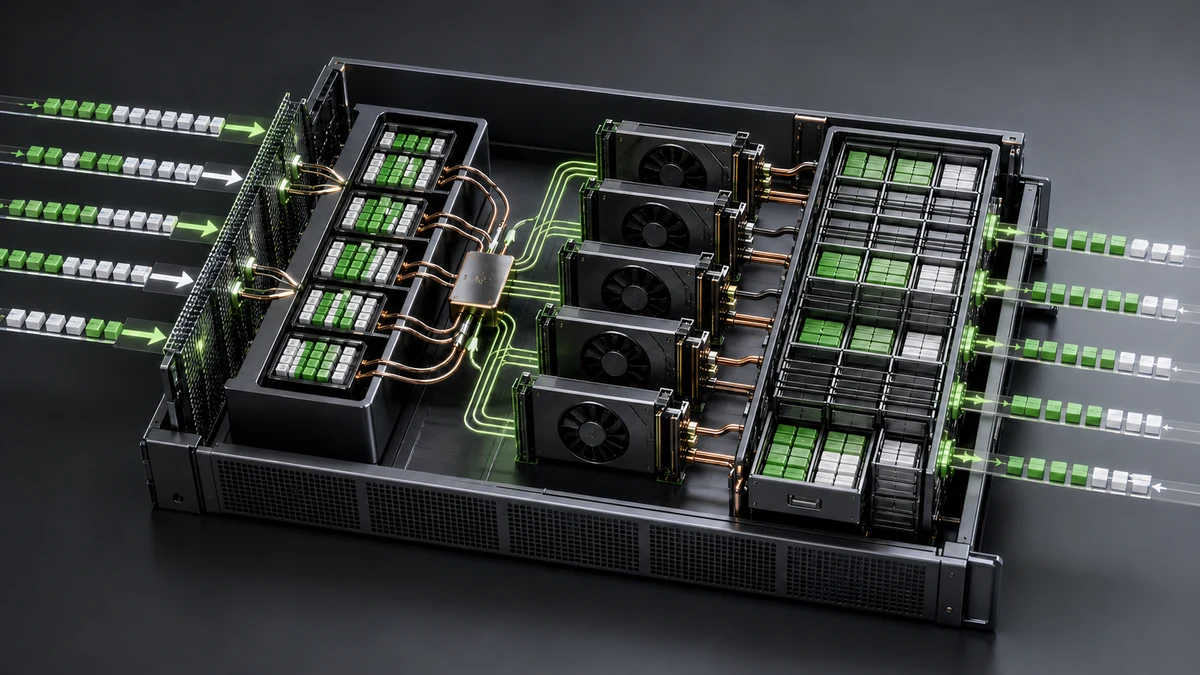
Καθώς αυξάνεται η ζήτηση για μεγάλα γλωσσικά μοντέλα (LLM), η γρήγορη, αποδοτική και επεκτάσιμη εκτέλεσή τους γίνεται όλο και σημαντικότερη. Το TensorRT-LLM της NVIDIA (NVDA ) αντιμετωπίζει αυτή την πρόκληση με ισχυρά εργαλεία και βελτιστοποιήσεις ειδικά σχεδιασμένα για την εξαγωγή συμπερασμάτων με LLM. Προσφέρει κβαντοποίηση, συγχώνευση πυρήνων, δυναμική ομαδοποίηση αιτημάτων κατά την εκτέλεση και υποστήριξη πολλών GPU. Αυτές οι δυνατότητες επιτρέπουν ταχύτητες έως και οκτώ φορές μεγαλύτερες από παραδοσιακές μεθόδους που βασίζονται σε CPU, αλλάζοντας τον τρόπο ανάπτυξης των LLM σε περιβάλλοντα παραγωγής.
Ο οδηγός εξετάζει την αρχιτεκτονική, τα βασικά χαρακτηριστικά και πρακτικά παραδείγματα ανάπτυξης μοντέλων με TensorRT-LLM. Απευθύνεται σε μηχανικούς AI, προγραμματιστές και ερευνητές που θέλουν να βελτιστοποιήσουν την εκτέλεση LLM σε GPU της NVIDIA.
Επιτάχυνση της εκτέλεσης LLM με TensorRT-LLM
Το TensorRT-LLM προσφέρει σημαντικές βελτιώσεις στην απόδοση. Σύμφωνα με δοκιμές της NVIDIA, οι εφαρμογές που βασίζονται στο TensorRT επιτυγχάνουν ταχύτητα έως και οκτώ φορές μεγαλύτερη από πλατφόρμες που χρησιμοποιούν μόνο CPU. Αυτό είναι ιδιαίτερα σημαντικό για εφαρμογές πραγματικού χρόνου, όπως chatbot, συστήματα συστάσεων και αυτόνομα συστήματα που απαιτούν γρήγορη απόκριση.
Πώς λειτουργεί
Το TensorRT-LLM βελτιστοποιεί τα νευρωνικά δίκτυα κατά την ανάπτυξή τους με τεχνικές όπως:
- Κβαντοποίηση: Μειώνει την αριθμητική ακρίβεια των βαρών και των ενεργοποιήσεων, περιορίζοντας το μέγεθος του μοντέλου και επιταχύνοντας την εκτέλεση.
- Συγχώνευση επιπέδων και τανυστών: Συνδυάζει πράξεις όπως οι συναρτήσεις ενεργοποίησης και οι πολλαπλασιασμοί πινάκων σε μία πράξη.
- Ρύθμιση πυρήνων: Επιλέγει τους καταλληλότερους πυρήνες CUDA για τους υπολογισμούς στη GPU, μειώνοντας τον χρόνο εκτέλεσης.
Οι βελτιστοποιήσεις αυτές επιτρέπουν αποδοτική λειτουργία σε πλατφόρμες από μεγάλα κέντρα δεδομένων έως ενσωματωμένα συστήματα.
Βελτιστοποίηση της απόδοσης με TensorRT
Το TensorRT βασίζεται στο μοντέλο παράλληλου προγραμματισμού CUDA της NVIDIA και προσφέρει εξειδικευμένες βελτιστοποιήσεις για τις GPU της. Η κβαντοποίηση, η ρύθμιση πυρήνων και η συγχώνευση πράξεων τανυστών επιτρέπουν στα LLM να λειτουργούν με ελάχιστη καθυστέρηση.
Στις αποτελεσματικότερες τεχνικές περιλαμβάνονται:
- Κβαντοποίηση: Μειώνει την αριθμητική ακρίβεια των παραμέτρων, διατηρώντας υψηλή ακρίβεια αποτελεσμάτων και επιταχύνοντας την εκτέλεση.
- Συγχώνευση τανυστών: Συνδυάζει πολλές πράξεις σε έναν πυρήνα CUDA, μειώνοντας την επιβάρυνση μνήμης και αυξάνοντας τον ρυθμό επεξεργασίας.
- Αυτόματη ρύθμιση πυρήνων: Επιλέγει αυτόματα τον καλύτερο πυρήνα για κάθε πράξη στη συγκεκριμένη GPU.
Έτσι βελτιώνεται η απόδοση εργασιών βαθιάς μάθησης, όπως η επεξεργασία φυσικής γλώσσας, τα συστήματα συστάσεων και η ανάλυση βίντεο σε πραγματικό χρόνο.
Επιτάχυνση φόρτων εργασίας AI
Το TensorRT χρησιμοποιεί μορφές μειωμένης αριθμητικής ακρίβειας, όπως INT8 και FP16, για να επιταχύνει την εκτέλεση χωρίς μεγάλη απώλεια ακρίβειας αποτελεσμάτων. Αυτό είναι ιδιαίτερα χρήσιμο όπου η χαμηλή καθυστέρηση είναι κρίσιμη.
Οι βελτιστοποιήσεις INT8 και FP16 είναι ιδιαίτερα αποτελεσματικές σε:
- Ροές βίντεο: Εργασίες όπως η ανίχνευση αντικειμένων ωφελούνται από τον μειωμένο χρόνο επεξεργασίας καρέ.
- Συστήματα συστάσεων: Η ταχύτερη επεξεργασία μεγάλων όγκων δεδομένων χρηστών επιτρέπει εξατομίκευση σε πραγματικό χρόνο και σε μεγάλη κλίμακα.
- Επεξεργασία φυσικής γλώσσας: Η παραγωγή κειμένου, η μετάφραση και η σύνοψη επιταχύνονται, ώστε να υποστηρίζουν εφαρμογές πραγματικού χρόνου.
Ανάπτυξη, εκτέλεση και κλιμάκωση με NVIDIA Triton
Μετά τη βελτιστοποίηση με TensorRT-LLM, μπορείτε να αναπτύξετε, να εκτελέσετε και να κλιμακώσετε το μοντέλο με τον NVIDIA Triton Inference Server. Το Triton είναι λογισμικό ανοικτού κώδικα που υποστηρίζει δυναμική ομαδοποίηση αιτημάτων, συνδυασμούς μοντέλων και υψηλό ρυθμό επεξεργασίας. Παρέχει ευέλικτο περιβάλλον διαχείρισης μοντέλων AI σε μεγάλη κλίμακα.
Τα βασικά χαρακτηριστικά του περιλαμβάνουν:
- Ταυτόχρονη εκτέλεση μοντέλων: Εκτελεί πολλά μοντέλα μαζί, μεγιστοποιώντας την αξιοποίηση της GPU.
- Δυναμική ομαδοποίηση: Συνδυάζει πολλά αιτήματα σε μία παρτίδα για χαμηλότερη καθυστέρηση και υψηλότερο ρυθμό επεξεργασίας.
- Είσοδοι συνεχούς ροής ήχου και βίντεο: Υποστηρίζει εφαρμογές όπως η ανάλυση ζωντανού βίντεο και η μετατροπή ομιλίας σε κείμενο.
Το Triton αποτελεί έτσι χρήσιμο εργαλείο για την αποδοτική και επεκτάσιμη λειτουργία βελτιστοποιημένων μοντέλων σε περιβάλλοντα παραγωγής.
Βασικά χαρακτηριστικά του TensorRT-LLM
Python API ανοικτού κώδικα
Το TensorRT-LLM διαθέτει αρθρωτό Python API ανοικτού κώδικα που απλοποιεί τον ορισμό, τη βελτιστοποίηση και την εκτέλεση LLM. Οι προγραμματιστές μπορούν να δημιουργούν προσαρμοσμένα μοντέλα ή να τροποποιούν έτοιμα, χωρίς να απαιτείται βαθιά γνώση της CUDA ή των πλαισίων βαθιάς μάθησης.
In-Flight Batching και Paged Attention
Το In-Flight Batching βελτιστοποιεί την παραγωγή κειμένου επεξεργαζόμενο ταυτόχρονα πολλά αιτήματα. Η δυναμική ομαδοποίηση ακολουθιών μειώνει τον χρόνο αναμονής και βελτιώνει την αξιοποίηση της GPU.
Το Paged Attention περιορίζει τη χρήση μνήμης ακόμη και με μεγάλες ακολουθίες εισόδου. Αντί να δεσμεύει συνεχόμενη μνήμη για όλα τα token, τη χωρίζει σε «σελίδες» που μπορούν να επαναχρησιμοποιούνται δυναμικά, μειώνοντας τον κατακερματισμό και βελτιώνοντας την αποδοτικότητα.
Υποστήριξη πολλών GPU και κόμβων
Για μεγαλύτερα μοντέλα ή απαιτητικότερους φόρτους, το TensorRT-LLM υποστηρίζει εκτέλεση σε πολλές GPU και πολλούς κόμβους. Οι υπολογισμοί κατανέμονται μεταξύ τους, αυξάνοντας τον ρυθμό επεξεργασίας και μειώνοντας τον συνολικό χρόνο εκτέλεσης.
Υποστήριξη FP8
Το FP8, μορφή κινητής υποδιαστολής οκτώ bit, επιτρέπει στο TensorRT-LLM να αξιοποιεί τις GPU H100 της NVIDIA μετατρέποντας τα βάρη των μοντέλων σε αυτή τη μορφή. Έτσι μειώνεται η κατανάλωση μνήμης και επιταχύνονται οι υπολογισμοί, ιδιαίτερα σε μεγάλες εγκαταστάσεις.
Αρχιτεκτονική και στοιχεία του TensorRT-LLM
Η κατανόηση της αρχιτεκτονικής βοηθά στην καλύτερη αξιοποίηση των δυνατοτήτων του. Τα βασικά στοιχεία είναι:
Ορισμός μοντέλου
Το Python API επιτρέπει τον ορισμό LLM και κατασκευάζει μια αναπαράσταση γράφου του μοντέλου. Έτσι διευκολύνεται η διαχείριση των σύνθετων επιπέδων αρχιτεκτονικών όπως οι GPT και BERT.
Σύνδεση βαρών
Πριν από τη μεταγλώττιση, τα βάρη ή οι παράμετροι πρέπει να συνδεθούν με το δίκτυο. Ενσωματώνονται έτσι στη μηχανή TensorRT για γρήγορη και αποδοτική εκτέλεση. Υποστηρίζεται επίσης ενημέρωση βαρών μετά τη μεταγλώττιση, κάτι χρήσιμο για μοντέλα που χρειάζονται συχνές αλλαγές.
Αντιστοίχιση μοτίβων και συγχώνευση
Η συγχώνευση πράξεων συνδυάζει, για παράδειγμα, πολλαπλασιασμούς πινάκων και συναρτήσεις ενεργοποίησης σε έναν πυρήνα CUDA. Έτσι μειώνονται η επιβάρυνση από την εκκίνηση πολλών πυρήνων και οι μεταφορές μνήμης, επιταχύνοντας την εκτέλεση.
Πρόσθετα
Οι προγραμματιστές μπορούν να επεκτείνουν το TensorRT με πρόσθετα: προσαρμοσμένους πυρήνες για συγκεκριμένες εργασίες, όπως η βελτιστοποίηση της προσοχής πολλών κεφαλών. Το Flash-Attention, για παράδειγμα, βελτιώνει σημαντικά την απόδοση των επιπέδων προσοχής στα LLM.
Μετρήσεις απόδοσης
Το TensorRT-LLM παρουσιάζει σημαντικές βελτιώσεις σε διαφορετικές GPU. Ο παρακάτω πίνακας συγκρίνει την ταχύτητα εκτέλεσης, σε token ανά δευτερόλεπτο:
| Μοντέλο | Αριθμητική ακρίβεια | Είσοδος/Έξοδος | H100 (80GB) | A100 (80GB) | L40S FP8 |
|---|---|---|---|---|---|
| GPTJ 6B | FP8 | 128/128 | 34,955 | 11,206 | 6,998 |
| GPTJ 6B | FP8 | 2048/128 | 2,800 | 1,354 | 747 |
| LLaMA v2 7B | FP8 | 128/128 | 16,985 | 10,725 | 6,121 |
| LLaMA v3 8B | FP8 | 128/128 | 16,708 | 12,085 | 8,273 |
Οι μετρήσεις δείχνουν σημαντική βελτίωση, ιδιαίτερα για μεγαλύτερες ακολουθίες.
Πρακτικός οδηγός εγκατάστασης και μεταγλώττισης
Βήμα 1: Δημιουργία περιβάλλοντος container
Το TensorRT-LLM παρέχει εικόνες Docker για ένα ελεγχόμενο περιβάλλον μεταγλώττισης και εκτέλεσης μοντέλων.
docker build --pull \
--target devel \
--file docker/Dockerfile.multi \
--tag tensorrt_llm/devel:latest .
Βήμα 2: Εκτέλεση του container
Εκτελέστε το container ανάπτυξης με πρόσβαση στις GPU της NVIDIA:
docker run --rm -it \
--ipc=host --ulimit memlock=-1 --ulimit stack=67108864 --gpus=all \
--volume ${PWD}:/code/tensorrt_llm \
--workdir /code/tensorrt_llm \
tensorrt_llm/devel:latest
Βήμα 3: Μεταγλώττιση από τον πηγαίο κώδικα
Μέσα στο container, μεταγλωττίστε το TensorRT-LLM με τις ακόλουθες εντολές:
python3 ./scripts/build_wheel.py --trt_root /usr/local/tensorrt
pip install ./build/tensorrt_llm*.whl
Η επιλογή αυτή είναι ιδιαίτερα χρήσιμη για την αποφυγή προβλημάτων συμβατότητας εξαρτήσεων Python ή για ενσωμάτωση C++ σε συστήματα παραγωγής. Μετά τη μεταγλώττιση, οι βιβλιοθήκες του περιβάλλοντος εκτέλεσης C++ βρίσκονται στον κατάλογο cpp/build/tensorrt_llm, έτοιμες για ενσωμάτωση στις εφαρμογές σας.
Βήμα 4: Σύνδεση των βιβλιοθηκών C++
Βεβαιωθείτε ότι οι διαδρομές συμπερίληψης του έργου σας δείχνουν στο cpp/include, όπου βρίσκονται τα σταθερά και υποστηριζόμενα αρχεία κεφαλίδων API. Οι βιβλιοθήκες TensorRT-LLM συνδέονται κατά τη μεταγλώττιση του έργου C++.
Για παράδειγμα, η διαμόρφωση CMake μπορεί να περιλαμβάνει:
include_directories(${TENSORRT_LLM_PATH}/cpp/include)
link_directories(${TENSORRT_LLM_PATH}/cpp/build/tensorrt_llm)
target_link_libraries(your_project tensorrt_llm)
Η ενσωμάτωση αυτή επιτρέπει την αξιοποίηση των βελτιστοποιήσεων σε προσαρμοσμένα έργα C++, ακόμη και σε περιβάλλοντα χαμηλού επιπέδου ή υψηλών επιδόσεων.
Προηγμένα χαρακτηριστικά
Το TensorRT-LLM διαθέτει και προηγμένες δυνατότητες για εγκαταστάσεις LLM μεγάλης κλίμακας:
1. In-Flight Batching
Η παραδοσιακή ομαδοποίηση περιμένει να συγκεντρωθεί ολόκληρη η παρτίδα πριν αρχίσει η επεξεργασία, προκαλώντας καθυστερήσεις. Το In-Flight Batching διαχειρίζεται δυναμικά την εκτέλεση των αιτημάτων μέσα στην παρτίδα, ενώ εξακολουθούν να συλλέγονται άλλα. Έτσι περιορίζει τον χρόνο αδράνειας και αξιοποιεί καλύτερα τη GPU.
Αυτό είναι ιδιαίτερα πολύτιμο σε chatbot και φωνητικούς βοηθούς, όπου ο χρόνος απόκρισης είναι κρίσιμος.
2. Paged Attention
Το Paged Attention βελτιστοποιεί τη μνήμη για μεγάλες ακολουθίες εισόδου. Αντί για συνεχόμενη μνήμη για όλα τα token, χωρίζει τα δεδομένα της κρυφής μνήμης κλειδιών και τιμών σε σελίδες. Αυτές δεσμεύονται και αποδεσμεύονται δυναμικά, περιορίζοντας τον κατακερματισμό και την επιβάρυνση μνήμης.
Είναι ιδιαίτερα σημαντικό για μεγάλες ακολουθίες σε μοντέλα παραγωγής κειμένου, όπως τα GPT και LLaMA.
3. Προσαρμοσμένα πρόσθετα
Τα προσαρμοσμένα πρόσθετα επιτρέπουν συγκεκριμένες βελτιστοποιήσεις ή πράξεις που δεν καλύπτει η βασική βιβλιοθήκη TensorRT. Το Flash-Attention είναι γνωστό παράδειγμα πυρήνα που βελτιστοποιεί τα επίπεδα προσοχής πολλών κεφαλών σε Transformer, επιταχύνοντας ένα από τα πιο απαιτητικά υπολογιστικά στοιχεία των LLM.
Για να ενσωματώσετε ένα πρόσθετο, μπορείτε να γράψετε έναν προσαρμοσμένο πυρήνα CUDA και να τον καταχωρίσετε στο TensorRT. Θα καλείται κατά την εκτέλεση του μοντέλου για στοχευμένες βελτιώσεις απόδοσης.
4. Αριθμητική ακρίβεια FP8 στην NVIDIA H100
Το TensorRT-LLM αξιοποιεί την αρχιτεκτονική H100 Hopper αποθηκεύοντας βάρη και ενεργοποιήσεις σε μορφή κινητής υποδιαστολής οκτώ bit. Αυτό μειώνει τη μνήμη και επιταχύνει τους υπολογισμούς χωρίς μεγάλη απώλεια ακρίβειας αποτελεσμάτων. Τα μοντέλα μεταγλωττίζονται αυτόματα ώστε να χρησιμοποιούν βελτιστοποιημένους πυρήνες FP8.
Έτσι υποστηρίζονται μεγάλες εγκαταστάσεις με υψηλές απαιτήσεις απόδοσης και ενεργειακής αποδοτικότητας.
Παράδειγμα ανάπτυξης με Triton Inference Server
Ο Triton Inference Server της NVIDIA προσφέρει μια ισχυρή πλατφόρμα διαχείρισης μοντέλων σε περιβάλλον παραγωγής. Ακολουθεί παράδειγμα ανάπτυξης ενός μοντέλου βελτιστοποιημένου με TensorRT-LLM.
Βήμα 1: Δημιουργία αποθετηρίου μοντέλων
Δημιουργήστε ένα αποθετήριο όπου θα αποθηκεύονται τα αρχεία μοντέλων. Για ένα μεταγλωττισμένο GPT2, η δομή μπορεί να δημιουργηθεί ως εξής:
mkdir -p model_repository/gpt2/1
cp ./trt_engine/gpt2_fp16.engine model_repository/gpt2/1/
Βήμα 2: Δημιουργία αρχείου ρυθμίσεων Triton
Στον κατάλογο model_repository/gpt2/, δημιουργήστε το config.pbtxt που καθορίζει πώς φορτώνεται και εκτελείται το μοντέλο. Μια βασική διαμόρφωση είναι:
name: "gpt2"
platform: "tensorrt_llm"
max_batch_size: 8

<p>input [
{
name: "input_ids"
data_type: TYPE_INT32
dims: [-1]
}
]</p>

<p>output [
{
name: "logits"
data_type: TYPE_FP32
dims: [-1, -1]
}
]</p>
Βήμα 3: Εκκίνηση του διακομιστή Triton
Χρησιμοποιήστε την ακόλουθη εντολή Docker για εκκίνηση με το αποθετήριο μοντέλων:
docker run --rm --gpus all \
-v $(pwd)/model_repository:/models \
nvcr.io/nvidia/tritonserver:23.05-py3 \
tritonserver --model-repository=/models
Βήμα 4: Αποστολή αιτημάτων εκτέλεσης
Όταν λειτουργεί ο διακομιστής, μπορείτε να στείλετε αιτήματα μέσω HTTP ή gRPC. Για παράδειγμα, με curl:
curl -X POST http://localhost:8000/v2/models/gpt2/infer -d '{
"inputs": [
{"name": "input_ids", "shape": [1, 128], "datatype": "INT32", "data": [[101, 234, 1243]]}
]
}'
Το Triton επεξεργάζεται το αίτημα με τη μηχανή TensorRT-LLM και επιστρέφει τις τιμές logits.
Βέλτιστες πρακτικές
Για καλύτερα αποτελέσματα, ακολουθήστε ορθές πρακτικές τόσο στη βελτιστοποίηση όσο και στην ανάπτυξη:
1. Ανάλυση απόδοσης πριν από τη βελτιστοποίηση
Πριν εφαρμόσετε κβαντοποίηση ή συγχώνευση πυρήνων, χρησιμοποιήστε εργαλεία όπως τα Nsight Systems και TensorRT Profiler για να εντοπίσετε τα σημεία συμφόρησης. Έτσι μπορείτε να στοχεύσετε συγκεκριμένες περιοχές με αποτελεσματικότερες βελτιώσεις.
2. Μεικτή αριθμητική ακρίβεια
Ο συνδυασμός FP16 και FP32 μπορεί να επιταχύνει σημαντικά την εκτέλεση χωρίς μεγάλη απώλεια ακρίβειας αποτελεσμάτων. Για ισορροπία ταχύτητας και ακρίβειας, εξετάστε το FP8 όπου υποστηρίζεται, ιδιαίτερα στις GPU H100.
3. Paged Attention για μεγάλες ακολουθίες
Σε εργασίες όπως η σύνοψη εγγράφων ή οι συνομιλίες πολλών γύρων, ενεργοποιήστε το Paged Attention για βελτιστοποίηση της μνήμης και αποφυγή σφαλμάτων εξάντλησής της.
4. Ρύθμιση παραλληλισμού σε πολλές GPU
Προσαρμόστε τον παραλληλισμό τανυστών και τον παραλληλισμό διοχέτευσης στον συγκεκριμένο φόρτο εργασίας. Η σωστή διαμόρφωση κατανέμει ομοιόμορφα το υπολογιστικό φορτίο και μπορεί να βελτιώσει σημαντικά την απόδοση.
Συμπέρασμα
Το TensorRT-LLM αλλάζει τον τρόπο βελτιστοποίησης και ανάπτυξης μεγάλων γλωσσικών μοντέλων. Με κβαντοποίηση, συγχώνευση πράξεων, FP8 και υποστήριξη πολλών GPU, επιτρέπει ταχύτερη και αποδοτικότερη λειτουργία στις GPU της NVIDIA. Προσφέρει εργαλεία για εφαρμογές συνομιλίας πραγματικού χρόνου, συστήματα συστάσεων και μοντέλα μεγάλης κλίμακας.
Ο οδηγός κάλυψε την εγκατάσταση, τη βελτιστοποίηση με το Python API, την ανάπτυξη στο Triton και τις βέλτιστες πρακτικές. Με αυτές τις δυνατότητες μπορείτε να επιταχύνετε φόρτους AI, να μειώσετε την καθυστέρηση και να προσφέρετε επεκτάσιμες λύσεις LLM σε περιβάλλοντα παραγωγής.
Για περισσότερες πληροφορίες, συμβουλευτείτε την τεκμηρίωση του TensorRT-LLM και την τεκμηρίωση του Triton Inference Server.



