

Μοντέλα και πλατφόρμες AI
SEER: Μια επανάσταση στα αυτοεπιβλεπόμενα μοντέλα υπολογιστικής όρασης;

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤο μοντέλο SEER του Facebook μαθαίνει από ένα δισεκατομμύριο τυχαίες εικόνες του…
Δείτε περισσότερα
- Το μοντέλο SEER του Facebook μαθαίνει από ένα δισεκατομμύριο τυχαίες εικόνες του διαδικτύου χωρίς ετικέτες ή επιμέλεια.
- Η αυτο-επιβλεπόμενη μάθηση, όπως το SEER, παρακάμπτει την δαπανηρή και κοπιαστική ανάγκη για σχολιασμένα δεδομένα.
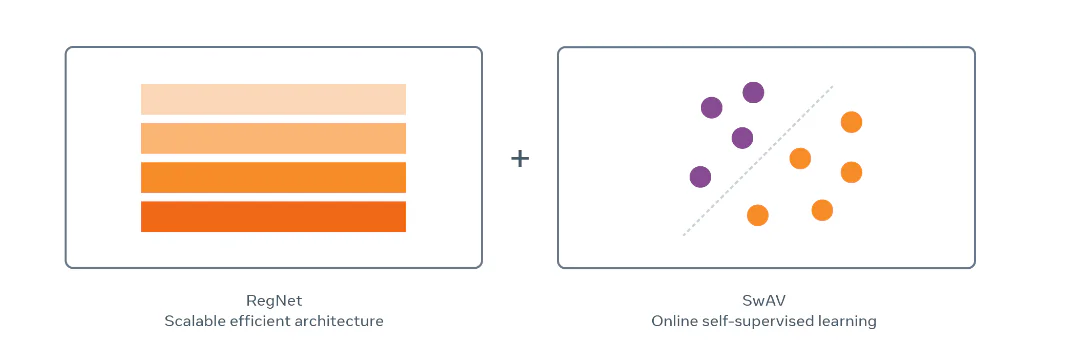
- Το μοντέλο χρησιμοποιεί την αρχιτεκτονική RegNetY και την ομαδοποίηση SwAV για να επιτύχει κλίμακα και αποδοτικότητα.
Την τελευταία δεκαετία, η τεχνητή νοημοσύνη (AI) και η μηχανική μάθηση (ML) έχουν σημειώσει τεράστια πρόοδο. Σήμερα είναι πιο ακριβείς, αποδοτικές και ικανές από ποτέ. Τα σύγχρονα μοντέλα AI και ML αναγνωρίζουν με ευκολία και ακρίβεια αντικείμενα σε εικόνες ή αρχεία βίντεο. Επιπλέον, μπορούν να παράγουν κείμενο και ομιλία που προσεγγίζουν τις ανθρώπινες ικανότητες.
Τα σημερινά μοντέλα AI και ML βασίζονται σε μεγάλο βαθμό στην εκπαίδευση με σύνολα δεδομένων που φέρουν ετικέτες. Έτσι μαθαίνουν να ερμηνεύουν αποσπάσματα κειμένου, να αναγνωρίζουν αντικείμενα σε εικόνες ή καρέ βίντεο και να εκτελούν πολλές άλλες εργασίες.
Παρά τις δυνατότητές τους, τα μοντέλα AI και ML δεν είναι τέλεια. Οι επιστήμονες εργάζονται για την ανάπτυξη μοντέλων που μπορούν να μαθαίνουν από τις πληροφορίες που λαμβάνουν, χωρίς να εξαρτώνται απαραίτητα από δεδομένα με ετικέτες ή επισημάνσεις. Η προσέγγιση αυτή ονομάζεται αυτοεπιβλεπόμενη μάθηση και αποτελεί έναν από τους πιο αποδοτικούς τρόπους ανάπτυξης μοντέλων ML και AI με «κοινή λογική» ή βασικές γνώσεις, ώστε να επιλύουν προβλήματα που ξεπερνούν τις δυνατότητες των σημερινών μοντέλων AI.
Η αυτοεπιβλεπόμενη μάθηση έχει ήδη αποδώσει αποτελέσματα στην επεξεργασία φυσικής γλώσσας. Έχει επιτρέψει στους προγραμματιστές να εκπαιδεύουν μεγάλα μοντέλα που διαχειρίζονται τεράστιο όγκο δεδομένων και έχει οδηγήσει σε σημαντικές εξελίξεις στην εξαγωγή συμπερασμάτων φυσικής γλώσσας, τη μηχανική μετάφραση και την απάντηση σε ερωτήσεις.
Το μοντέλο SEER της Facebook (META ) AI αποσκοπεί στην αξιοποίηση των δυνατοτήτων της αυτοεπιβλεπόμενης μάθησης στην υπολογιστική όραση. Το SEER, από το SElf SupERvised είναι ένα αυτοεπιβλεπόμενο μοντέλο υπολογιστικής όρασης με περισσότερες από ένα δισεκατομμύριο παραμέτρους. Μπορεί να ανακαλύπτει μοτίβα και να μαθαίνει ακόμη και από μια τυχαία συλλογή διαδικτυακών εικόνων χωρίς κατάλληλες επισημάνσεις ή ετικέτες.
Η ανάγκη για αυτοεπιβλεπόμενη μάθηση στην υπολογιστική όραση
Η επισήμανση δεδομένων, δηλαδή η προσθήκη ετικετών, αποτελεί στάδιο προεπεξεργασίας κατά την ανάπτυξη μοντέλων μηχανικής μάθησης και τεχνητής νοημοσύνης. Η διαδικασία εξετάζει ακατέργαστα δεδομένα, όπως εικόνες ή καρέ βίντεο, και προσθέτει ετικέτες που προσδιορίζουν το πλαίσιό τους για το μοντέλο. Οι ετικέτες αυτές βοηθούν το μοντέλο να κάνει ακριβείς προβλέψεις.
Μία από τις μεγαλύτερες προκλήσεις για τους προγραμματιστές μοντέλων υπολογιστικής όρασης είναι η εύρεση επισημασμένων δεδομένων υψηλής ποιότητας. Η υπολογιστική όραση βασίζεται σήμερα σε αυτά τα σύνολα δεδομένων με ετικέτες ή επισημάνσεις, ώστε τα μοντέλα να μαθαίνουν τα μοτίβα που τους επιτρέπουν να αναγνωρίζουν αντικείμενα στις εικόνες.
Η επισήμανση δεδομένων και η χρήση της στα μοντέλα υπολογιστικής όρασης δημιουργούν τις ακόλουθες προκλήσεις:
Διατήρηση σταθερής ποιότητας των συνόλων δεδομένων
Ίσως το μεγαλύτερο εμπόδιο για τους προγραμματιστές είναι η σταθερή πρόσβαση σε σύνολα δεδομένων υψηλής ποιότητας. Τα δεδομένα με σωστές ετικέτες και καθαρές εικόνες οδηγούν σε καλύτερη μάθηση και ακριβέστερα μοντέλα. Ωστόσο, η συνεχής εξασφάλιση τέτοιων δεδομένων έχει τις δικές της δυσκολίες.
Διαχείριση του ανθρώπινου δυναμικού
Η επισήμανση δεδομένων συχνά δημιουργεί ζητήματα διαχείρισης ανθρώπινου δυναμικού. Απαιτούνται πολλοί εργαζόμενοι για την επεξεργασία και επισήμανση μεγάλων όγκων αδόμητων δεδομένων χωρίς ετικέτες, με παράλληλη διασφάλιση της ποιότητας. Γι’ αυτό οι προγραμματιστές πρέπει να εξισορροπούν ποιότητα και ποσότητα.
Οικονομικοί περιορισμοί
Οι οικονομικοί περιορισμοί που συνοδεύουν την επισήμανση δεδομένων αποτελούν συχνά σημαντικό εμπόδιο. Το κόστος επισήμανσης αντιστοιχεί συνήθως σε μεγάλο ποσοστό του συνολικού κόστους ενός έργου.
Όπως φαίνεται, η επισήμανση δεδομένων αποτελεί σοβαρό εμπόδιο για την ανάπτυξη προηγμένων μοντέλων υπολογιστικής όρασης, ιδιαίτερα σύνθετων μοντέλων που χρειάζονται μεγάλο όγκο δεδομένων εκπαίδευσης. Γι’ αυτό ο κλάδος χρειάζεται την αυτοεπιβλεπόμενη μάθηση, ώστε να αναπτύσσει σύνθετα και προηγμένα μοντέλα ικανά να εκτελούν εργασίες πέρα από τις δυνατότητες των σημερινών μοντέλων.
Υπάρχουν ήδη πολλά αυτοεπιβλεπόμενα μοντέλα που αποδίδουν καλά σε ελεγχόμενο περιβάλλον, κυρίως στο σύνολο δεδομένων ImageNet. Παρά τα καλά αποτελέσματα, δεν ικανοποιούν τη βασική προϋπόθεση της αυτοεπιβλεπόμενης μάθησης στην υπολογιστική όραση: να μαθαίνουν από οποιοδήποτε μη περιορισμένο σύνολο δεδομένων ή από τυχαίες εικόνες, και όχι μόνο από ένα σαφώς καθορισμένο σύνολο δεδομένων. Όταν εφαρμόζεται σωστά, η αυτοεπιβλεπόμενη μάθηση μπορεί να συμβάλει στην ανάπτυξη ακριβέστερων και ικανότερων μοντέλων υπολογιστικής όρασης, τα οποία είναι παράλληλα οικονομικά αποδοτικά και βιώσιμα.
Το μοντέλο SEER ή SElf-supERvised: εισαγωγή
Οι πρόσφατες τάσεις στον κλάδο AI και ML δείχνουν ότι οι προσεγγίσεις προεκπαίδευσης, όπως η ημιεπιβλεπόμενη, η ασθενώς επιβλεπόμενη και η αυτοεπιβλεπόμενη μάθηση, μπορούν να βελτιώσουν σημαντικά την απόδοση των περισσότερων μοντέλων βαθιάς μάθησης σε επακόλουθες εργασίες.
Δύο βασικοί παράγοντες έχουν συμβάλει σημαντικά στη βελτίωση της απόδοσης αυτών των μοντέλων βαθιάς μάθησης.
Προεκπαίδευση σε τεράστια σύνολα δεδομένων
Η προεκπαίδευση σε τεράστια σύνολα δεδομένων συνήθως βελτιώνει την ακρίβεια και την απόδοση, επειδή εκθέτει το μοντέλο σε μεγάλη ποικιλία δεδομένων. Έτσι το μοντέλο κατανοεί καλύτερα τα μοτίβα τους και αποδίδει καλύτερα σε πραγματικές συνθήκες.
Ορισμένα από τα μοντέλα με την καλύτερη απόδοση, όπως τα GPT-3 και Wav2vec 2.0, εκπαιδεύονται σε τεράστια σύνολα δεδομένων. Το γλωσσικό μοντέλο GPT-3 χρησιμοποιεί ένα σύνολο προεκπαίδευσης με περισσότερες από 300 δισεκατομμύρια λέξεις, ενώ το μοντέλο αναγνώρισης ομιλίας Wav2vec 2.0 χρησιμοποιεί σύνολο δεδομένων με περισσότερες από 53 χιλιάδες ώρες ηχητικών δεδομένων.
Μοντέλα μεγάλης χωρητικότητας
Τα μοντέλα με περισσότερες παραμέτρους συχνά δίνουν ακριβέστερα αποτελέσματα, επειδή μπορούν να εστιάζουν στα χρήσιμα στοιχεία των δεδομένων και όχι στις παρεμβολές ή στον θόρυβο.
Στο παρελθόν, οι προγραμματιστές επιχείρησαν να εκπαιδεύσουν αυτοεπιβλεπόμενα μοντέλα σε δεδομένα χωρίς ετικέτες και χωρίς επιμέλεια, αλλά χρησιμοποιούσαν μικρότερα σύνολα με μόλις μερικά εκατομμύρια εικόνες. Μπορούν όμως τα αυτοεπιβλεπόμενα μοντέλα να επιτύχουν υψηλή ακρίβεια όταν εκπαιδεύονται σε μεγάλο όγκο δεδομένων χωρίς ετικέτες και χωρίς επιμέλεια;Αυτό ακριβώς το ερώτημα επιχειρεί να απαντήσει το SEER.
Το μοντέλο SEER είναι ένα πλαίσιο βαθιάς μάθησης που επιδιώκει να αξιοποιεί διαδικτυακές εικόνες ανεξάρτητα από επιμελημένα σύνολα δεδομένων ή ετικέτες. Το πλαίσιο SEER επιτρέπει στους προγραμματιστές να εκπαιδεύουν μεγάλα και σύνθετα μοντέλα ML σε τυχαία δεδομένα χωρίς επίβλεψη. Το μοντέλο αναλύει τα δεδομένα και μαθαίνει μόνο του τα μοτίβα ή τις πληροφορίες, χωρίς πρόσθετη χειροκίνητη παρέμβαση.
Ο τελικός στόχος του SEER είναι να συμβάλει στην ανάπτυξη στρατηγικών προεκπαίδευσης που αξιοποιούν μη επιμελημένα δεδομένα για κορυφαία απόδοση στη μεταφορά μάθησης. Επιπλέον, το μοντέλο SEER επιδιώκει τη δημιουργία συστημάτων που μαθαίνουν συνεχώς, με αυτοεπίβλεψη, από μια αδιάκοπη ροή δεδομένων.
Το πλαίσιο SEER εκπαιδεύει μοντέλα μεγάλης χωρητικότητας σε δισεκατομμύρια τυχαίες εικόνες χωρίς περιορισμούς, οι οποίες προέρχονται από το διαδίκτυο. Τα μοντέλα δεν χρησιμοποιούν μεταδεδομένα ή επισημάνσεις εικόνων για την εκπαίδευση ή το φιλτράρισμα των δεδομένων. Η αυτοεπιβλεπόμενη μάθηση έχει δείξει σημαντικές δυνατότητες: η εκπαίδευση σε μη επιμελημένα δεδομένα έχει δώσει καλύτερα αποτελέσματα σε επακόλουθες εργασίες από ό,τι τα μοντέλα που έχουν προεκπαιδευτεί με επίβλεψη.
Πλαίσιο SEER και RegNet: Ποια είναι η σύνδεση;
Η ανάλυση του SEER επικεντρώνεται στην αρχιτεκτονική RegNet με περισσότερες από 700 εκατομμύρια παραμέτρους. Η αρχιτεκτονική εξυπηρετεί τον στόχο της αυτοεπιβλεπόμενης μάθησης σε μη επιμελημένα δεδομένα για δύο βασικούς λόγους:
- Προσφέρει ιδανική ισορροπία ανάμεσα στην επίδοση και την αποδοτικότητα.
- Είναι ιδιαίτερα ευέλικτη και μπορεί να κλιμακωθεί σε διαφορετικούς αριθμούς παραμέτρων.

Πλαίσιο SEER: Προηγούμενη έρευνα από διαφορετικούς τομείς
Το πλαίσιο SEER διερευνά τα όρια της εκπαίδευσης μεγάλων αρχιτεκτονικών σε μη επιμελημένα σύνολα δεδομένων ή δεδομένα χωρίς ετικέτες, μέσω αυτοεπιβλεπόμενης μάθησης. Αντλεί έμπνευση από προηγούμενη έρευνα στον τομέα.
Μη επιβλεπόμενη προεκπαίδευση οπτικών χαρακτηριστικών
Η αυτοεπιβλεπόμενη μάθηση εφαρμόζεται εδώ και καιρό στην υπολογιστική όραση με μεθόδους που χρησιμοποιούν αυτοκωδικοποιητές, διάκριση σε επίπεδο στιγμιοτύπου ή ομαδοποίηση. Πρόσφατα, οι μέθοδοι αντιπαραθετικής μάθησης έδειξαν ότι η μη επιβλεπόμενη προεκπαίδευση μπορεί να δώσει καλύτερα αποτελέσματα σε επακόλουθες εργασίες από μια επιβλεπόμενη προσέγγιση.
Το βασικό συμπέρασμα από τη μη επιβλεπόμενη μάθηση οπτικών χαρακτηριστικών είναι ότι εφόσον η εκπαίδευση γίνεται σε φιλτραρισμένα δεδομένα, δεν απαιτούνται ετικέτες επίβλεψης. Το SEER διερευνά αν μπορεί να μάθει ακριβείς αναπαραστάσεις όταν μεγάλες αρχιτεκτονικές εκπαιδεύονται σε τεράστιο όγκο τυχαίων, μη επιμελημένων εικόνων χωρίς ετικέτες.
Μάθηση οπτικών χαρακτηριστικών σε μεγάλη κλίμακα
Προηγούμενα μοντέλα ωφελήθηκαν από την προεκπαίδευση σε μεγάλα σύνολα δεδομένων με ετικέτες, χρησιμοποιώντας ασθενώς επιβλεπόμενη, επιβλεπόμενη ή ημιεπιβλεπόμενη μάθηση σε εκατομμύρια φιλτραρισμένες εικόνες. Οι αναλύσεις έδειξαν επίσης ότι η προεκπαίδευση σε δισεκατομμύρια εικόνες συχνά δίνει καλύτερη ακρίβεια από την εκπαίδευση του μοντέλου από την αρχή.
Η εκπαίδευση σε μεγάλη κλίμακα βασίζεται συνήθως σε βήματα φιλτραρίσματος, ώστε οι εικόνες να αντιστοιχούν στις έννοιες-στόχους. Το φιλτράρισμα χρησιμοποιεί είτε προβλέψεις ενός προεκπαιδευμένου ταξινομητή είτε hashtag που συχνά αντιστοιχούν στα σύνολα συνωνύμων των κατηγοριών του ImageNet. Το SEER λειτουργεί διαφορετικά: επιδιώκει να μαθαίνει χαρακτηριστικά από οποιαδήποτε τυχαία εικόνα. Επομένως, τα δεδομένα εκπαίδευσής του δεν επιλέγονται ώστε να αντιστοιχούν σε ένα προκαθορισμένο σύνολο χαρακτηριστικών ή εννοιών.
Κλιμάκωση αρχιτεκτονικών για την αναγνώριση εικόνων
Η εκπαίδευση μεγάλων αρχιτεκτονικών συνήθως βελτιώνει την ποιότητα των οπτικών χαρακτηριστικών που προκύπτουν. Σε μεγάλα σύνολα δεδομένων απαιτείται επαρκής χωρητικότητα, επειδή ένα περιορισμένο μοντέλο συχνά παρουσιάζει υποπροσαρμογή. Αυτό είναι ακόμη σημαντικότερο στην αντιπαραθετική μάθηση: το μοντέλο πρέπει να διακρίνει τα επιμέρους στιγμιότυπα του συνόλου δεδομένων, ώστε να μάθει καλύτερες οπτικές αναπαραστάσεις.
Στην αναγνώριση εικόνων, όμως, η κλιμάκωση μιας αρχιτεκτονικής απαιτεί περισσότερα από την αλλαγή του βάθους και του πλάτους της. Για την αποδοτική ανάπτυξη μοντέλων μεγαλύτερης χωρητικότητας χρειάζεται εκτενής μελέτη. Το SEER αναδεικνύει τα οφέλη της οικογένειας RegNet για την εφαρμογή αυτοεπιβλεπόμενης μάθησης σε μεγάλη κλίμακα.
SEER: Μέθοδοι και επιμέρους στοιχεία
Το πλαίσιο SEER χρησιμοποιεί διάφορες μεθόδους και στοιχεία για την προεκπαίδευση του μοντέλου στη μάθηση οπτικών αναπαραστάσεων. Μεταξύ των βασικών επιλογών του είναι τα RegNet και SwAV. Ας δούμε συνοπτικά τις μεθόδους και τα στοιχεία που χρησιμοποιεί το πλαίσιο SEER.
Αυτοεπιβλεπόμενη προεκπαίδευση με SwAV
Το πλαίσιο SEER προεκπαιδεύεται με το SwAV, μια διαδικτυακή προσέγγιση αυτοεπιβλεπόμενης μάθησης. Το SwAV είναι μια μέθοδος διαδικτυακής ομαδοποίησης για την εκπαίδευση συνελικτικών νευρωνικών δικτύων χωρίς επισημάνσεις. Μαθαίνει μια ενσωμάτωση που δίνει συνεπείς αναθέσεις σε ομάδες για διαφορετικές όψεις της ίδιας εικόνας. Στη συνέχεια, το σύστημα μαθαίνει σημασιολογικές αναπαραστάσεις εντοπίζοντας ομάδες που παραμένουν αναλλοίωτες στους μετασχηματισμούς επαύξησης δεδομένων.
Στην πράξη, το SwAV συγκρίνει τα χαρακτηριστικά διαφορετικών όψεων μιας εικόνας χρησιμοποιώντας τις ανεξάρτητες αναθέσεις τους σε ομάδες. Αν οι αναθέσεις αποτυπώνουν ίδια ή παρόμοια χαρακτηριστικά, μπορεί να προβλεφθεί η ανάθεση μιας όψης από τα χαρακτηριστικά μιας άλλης.
Το SEER θεωρεί ένα σύνολο K ομάδων, καθεμία από τις οποίες συνδέεται με ένα εκπαιδεύσιμο d-διάστατο διάνυσμα vk. Για μια παρτίδα B εικόνων, κάθε εικόνα i μετασχηματίζεται σε δύο διαφορετικές όψεις: xi1 , και xi2. Οι όψεις μετατρέπονται σε χαρακτηριστικά με ένα συνελικτικό δίκτυο, παράγοντας δύο σύνολα χαρακτηριστικών: (f11, …, fB2), και (f12, … , fB2). Κάθε σύνολο χαρακτηριστικών ανατίθεται ανεξάρτητα στα πρωτότυπα των ομάδων με τη βοήθεια ενός επιλυτή βέλτιστης μεταφοράς (Optimal Transport).
Ο επιλυτής βέλτιστης μεταφοράς διασφαλίζει ότι τα χαρακτηριστικά κατανέμονται ισόρροπα στις ομάδες, αποφεύγοντας τετριμμένες λύσεις όπου όλες οι αναπαραστάσεις αντιστοιχίζονται σε ένα μόνο πρωτότυπο. Οι αναθέσεις που προκύπτουν ανταλλάσσονται μεταξύ των δύο συνόλων: η ανάθεση ομάδας yi1 της προβολής xi1 χρειάζεται να προβλεφθεί χρησιμοποιώντας την αναπαράσταση χαρακτηριστικών fi2 της προβολής xi2, και αντίστροφα.
Τα βάρη των πρωτοτύπων και το συνελικτικό δίκτυο εκπαιδεύονται ώστε να ελαχιστοποιούν την απώλεια για όλα τα παραδείγματα. Η απώλεια πρόβλεψης ομάδας l είναι ουσιαστικά η διασταυρούμενη εντροπία ανάμεσα στη softmax του εσωτερικού γινομένου του f και στην ανάθεση ομάδας.

RegNetY: Οικογένεια μοντέλων με αποδοτική κλιμάκωση
Η κλιμάκωση της χωρητικότητας των μοντέλων και του όγκου δεδομένων απαιτεί αρχιτεκτονικές αποδοτικές τόσο ως προς τη μνήμη όσο και ως προς τον χρόνο εκτέλεσης. Η οικογένεια μοντέλων RegNet σχεδιάστηκε ειδικά γι’ αυτόν τον σκοπό.
Η οικογένεια αρχιτεκτονικών RegNet ορίζεται από έναν χώρο σχεδιασμού συνελικτικών δικτύων με τέσσερα στάδια. Κάθε στάδιο περιλαμβάνει μια σειρά όμοιων μπλοκ σταθερής δομής, κυρίως υπολειμματικών μπλοκ τύπου bottleneck.
Το πλαίσιο SEER επικεντρώνεται στην αρχιτεκτονική RegNetY, προσθέτοντας έναν μηχανισμό Squeeze-and-Excitation στην τυπική αρχιτεκτονική RegNet για να βελτιώσει την απόδοσή της. Το RegNetY διαθέτει επίσης πέντε παραμέτρους που διευκολύνουν την αναζήτηση αποδοτικών διαμορφώσεων με σταθερό αριθμό FLOPs και εύλογες απαιτήσεις πόρων. Το SEER επιδιώκει καλύτερα αποτελέσματα εφαρμόζοντας την αρχιτεκτονική RegNetY απευθείας στην αυτοεπιβλεπόμενη προεκπαίδευση.
Η αρχιτεκτονική RegNetY 256GF:Το SEER επικεντρώνεται κυρίως στην αρχιτεκτονική RegNetY 256GF. Οι παράμετροί της ακολουθούν τον κανόνα κλιμάκωσης της οικογένειας RegNet και περιγράφονται παρακάτω.

Η αρχιτεκτονική RegNetY 256GF έχει τέσσερα στάδια, με πλάτη (528, 1056, 2904, 7392) και βάθη (2, 7, 17, 1), και συνολικά περισσότερες από 696 εκατομμύρια παραμέτρους. Κατά την εκπαίδευση σε 512 GPU NVIDIA V100 των 32 GB, κάθε επανάληψη διαρκεί περίπου 6.125 ms για παρτίδα 8.704 εικόνων. Η εκπαίδευση σε περισσότερες από ένα δισεκατομμύριο εικόνες, με παρτίδες 8.704 εικόνων και περισσότερες από 512 GPU, απαιτεί 114.890 επαναλήψεις και διαρκεί περίπου οκτώ ημέρες.
Βελτιστοποίηση και εκπαίδευση σε μεγάλη κλίμακα
Το SEER προτείνει διάφορες προσαρμογές για την εφαρμογή μεθόδων αυτοεπιβλεπόμενης μάθησης σε μεγάλη κλίμακα. Αυτές περιλαμβάνουν:
- Προγραμματισμό του ρυθμού μάθησης.
- Μείωση της κατανάλωσης μνήμης ανά GPU.
- Βελτιστοποίηση της ταχύτητας εκπαίδευσης.
- Δεδομένα προεκπαίδευσης μεγάλης κλίμακας.
Ας εξετάσουμε συνοπτικά αυτά τα σημεία.
Προγραμματισμός του ρυθμού μάθησης
Το SEER εξετάζει δύο προγράμματα ρυθμού μάθησης: το πρόγραμμα ρυθμού μάθησης με συνημιτονοειδή μεταβολή και το πρόγραμμα σταθερού ρυθμού μάθησης.
Το συνημιτονοειδές πρόγραμμα χρησιμοποιείται για δίκαιη σύγκριση διαφορετικών μοντέλων, καθώς προσαρμόζεται στον αριθμό ενημερώσεων. Ωστόσο, δεν προσαρμόζεται εύκολα στην εκπαίδευση μεγάλης κλίμακας: αποδίδει διαφορετικό βάρος στις εικόνες ανάλογα με το πότε εμφανίζονται στην εκπαίδευση και βασίζεται στον πλήρη αριθμό ενημερώσεων για τον προγραμματισμό.
Το πρόγραμμα σταθερού ρυθμού μάθησης διατηρεί τον ρυθμό αμετάβλητο μέχρι να πάψει να μειώνεται η απώλεια και στη συνέχεια τον διαιρεί διά δύο. Η ανάλυση δείχνει ότι αυτή η προσέγγιση αποδίδει καλύτερα, επειδή προσφέρει μεγαλύτερη ευελιξία στην εκπαίδευση. Ωστόσο, επειδή το SEER εκπαιδεύεται μόνο σε ένα δισεκατομμύριο εικόνες, χρησιμοποιεί το συνημιτονοειδές πρόγραμμα για το μεγαλύτερο μοντέλο του, το RegNet 256GF.
Μείωση της κατανάλωσης μνήμης ανά GPU
Το μοντέλο μειώνει τις απαιτήσεις μνήμης κατά την εκπαίδευση χρησιμοποιώντας μεικτή ακρίβεια και gradient checkpointing. Αξιοποιεί το επίπεδο βελτιστοποίησης O1 της βιβλιοθήκης NVIDIA Apex για πράξεις όπως οι συνελίξεις και οι πολλαπλασιασμοί μητρών GEMM με κινητή υποδιαστολή 16 bit. Χρησιμοποιεί επίσης την υλοποίηση gradient checkpointing του PyTorch, η οποία εξοικονομεί μνήμη με αντάλλαγμα πρόσθετους υπολογισμούς.
Επιπλέον, απορρίπτει τις ενδιάμεσες ενεργοποιήσεις της εμπρόσθιας διάδοσης και τις υπολογίζει ξανά κατά την οπισθοδιάδοση.
Βελτιστοποίηση της ταχύτητας εκπαίδευσης
Η μεικτή ακρίβεια έχει επιπλέον οφέλη πέρα από την εξοικονόμηση μνήμης. Οι επιταχυντές αξιοποιούν το μικρότερο μέγεθος της FP16 σε σύγκριση με την FP32 για να αυξήσουν τη διεκπεραιωτική ικανότητα. Έτσι επιταχύνεται η εκπαίδευση, καθώς περιορίζεται η συμφόρηση στο εύρος ζώνης της μνήμης.
Το SEER συγχρονίζει επίσης το επίπεδο BatchNorm στις GPU δημιουργώντας ομάδες διεργασιών, αντί να χρησιμοποιεί καθολικό συγχρονισμό, ο οποίος συνήθως απαιτεί περισσότερο χρόνο. Τέλος, ο φορτωτής δεδομένων του SEER προανακτά περισσότερες παρτίδες εκπαίδευσης, επιτυγχάνοντας μεγαλύτερη ροή δεδομένων από τον φορτωτή του PyTorch.
Δεδομένα προεκπαίδευσης μεγάλης κλίμακας
Το SEER χρησιμοποιεί περισσότερες από ένα δισεκατομμύριο εικόνες στην προεκπαίδευση και έναν φορτωτή δεδομένων που δειγματοληπτεί τυχαίες εικόνες απευθείας από το διαδίκτυο και το Instagram. Επειδή η εκπαίδευση γίνεται με πραγματικές, μη επιμελημένες εικόνες και διαδικτυακά, δεν εφαρμόζει προεπεξεργασία ούτε διαδικασίες όπως αφαίρεση διπλοτύπων ή φιλτράρισμα hashtag.
Το σύνολο δεδομένων δεν είναι στατικό: οι εικόνες ανανεώνονται κάθε τρεις μήνες. Η ανανέωση, ωστόσο, δεν επηρεάζει την απόδοση του μοντέλου.
Υλοποίηση του μοντέλου SEER
Το SEER προεκπαιδεύει ένα RegNetY 256GF με SwAV, χρησιμοποιώντας έξι περικοπές ανά εικόνα, με αναλύσεις 2×224 και 4×96. Κατά την προεκπαίδευση χρησιμοποιεί ένα πολυστρωματικό perceptron (MLP) τριών επιπέδων, με κεφαλές προβολής διαστάσεων 10444×8192, 8192×8192 και 8192×256.
Αντί για επίπεδα BatchNorm στην κεφαλή, το SEER χρησιμοποιεί 16 χιλιάδες πρωτότυπα, με τη θερμοκρασία t να ορίζεται σε 0,1. Η παράμετρος κανονικοποίησης Sinkhorn ορίζεται σε 0,05 και εκτελούνται δέκα επαναλήψεις του αλγορίθμου. Το μοντέλο συγχρονίζει επίσης τα στατιστικά BatchNorm μεταξύ των GPU, δημιουργώντας πολλές ομάδες διεργασιών μεγέθους 64.
Επιπλέον, χρησιμοποιεί τον βελτιστοποιητή LARS (Layer-wise Adaptive Rate Scaling), συντελεστή απόσβεσης βαρών 10-5, αποθήκευση σημείων ελέγχου ενεργοποιήσεων και βελτιστοποίηση μεικτής ακρίβειας O1. Εκπαιδεύεται με στοχαστική κάθοδο κλίσης και παρτίδες 8.192 τυχαίων εικόνων, κατανεμημένων σε 512 GPU NVIDIA, δηλαδή 16 εικόνες ανά GPU.
Ο ρυθμός μάθησης αυξάνεται γραμμικά από 0,15 σε 9,6 στις πρώτες 8 χιλιάδες ενημερώσεις εκπαίδευσης. Μετά την προθέρμανση, ακολουθεί συνημιτονοειδές πρόγραμμα που μειώνεται μέχρι την τελική τιμή 0,0096. Συνολικά, το SEER εκπαιδεύεται σε περισσότερες από ένα δισεκατομμύριο εικόνες, μέσα σε 122 χιλιάδες επαναλήψεις.
Πλαίσιο SEER: Αποτελέσματα
Η ποιότητα των χαρακτηριστικών που προκύπτουν από την αυτοεπιβλεπόμενη προεκπαίδευση μελετάται σε διάφορα σύνολα αναφοράς και επακόλουθες εργασίες. Εξετάζεται επίσης η μάθηση από λίγα παραδείγματα, όπου υπάρχει περιορισμένη πρόσβαση στις εικόνες και στις ετικέτες τους για αυτές τις εργασίες.
Λεπτομερής προσαρμογή μεγάλων προεκπαιδευμένων μοντέλων
Η ποιότητα των μοντέλων που προεκπαιδεύτηκαν σε τυχαία δεδομένα αξιολογείται μέσω μεταφοράς τους στο σύνολο αναφοράς ImageNet για ταξινόμηση αντικειμένων. Τα αποτελέσματα της λεπτομερούς προσαρμογής εξετάζονται με τις παρακάτω ρυθμίσεις.
Πειραματικές ρυθμίσεις
Προεκπαιδεύονται έξι αρχιτεκτονικές RegNet διαφορετικής χωρητικότητας, οι RegNetY- {8,16,32,64,128,256}GF, σε περισσότερες από ένα δισεκατομμύριο τυχαίες, δημόσια διαθέσιμες εικόνες του Instagram με SwAV. Στη συνέχεια, τα μοντέλα προσαρμόζονται για ταξινόμηση εικόνων στο ImageNet, το οποίο διαθέτει περισσότερες από 1,28 εκατομμύρια εικόνες εκπαίδευσης με κατάλληλες ετικέτες και ένα τυπικό σύνολο επικύρωσης με περισσότερες από 50 χιλιάδες εικόνες.
Εφαρμόζονται οι ίδιες τεχνικές επαύξησης δεδομένων με το SwAV και γίνεται λεπτομερής προσαρμογή για 35 εποχές με τον βελτιστοποιητή στοχαστικής καθόδου κλίσης (SGD), μέγεθος παρτίδας 256 και ρυθμό μάθησης 0,0125, ο οποίος μειώνεται κατά δέκα φορές μετά τις 30 εποχές. Η ορμή είναι 0,9 και ο συντελεστής απόσβεσης βαρών 10-4. Αναφέρεται η ακρίβεια top-1 στο σύνολο επικύρωσης, χρησιμοποιώντας κεντρική περικοπή 224×224.
Σύγκριση με άλλες προσεγγίσεις αυτοεπιβλεπόμενης προεκπαίδευσης
Ο παρακάτω πίνακας συγκρίνει το μεγαλύτερο προεκπαιδευμένο μοντέλο, το RegNetY-256GF, με υπάρχοντα μοντέλα αυτοεπιβλεπόμενης προεκπαίδευσης.

Το SEER επιτυγχάνει ακρίβεια top-1 84,2% στο ImageNet, ξεπερνώντας κατά 1% το SimCLRv2, το καλύτερο υπάρχον προεκπαιδευμένο μοντέλο της σύγκρισης.
Το παρακάτω σχήμα συγκρίνει επίσης το πλαίσιο SEER με μοντέλα διαφορετικής χωρητικότητας. Ανεξάρτητα από τη χωρητικότητα, ο συνδυασμός RegNet και SwAV δίνει ακριβή αποτελέσματα στην προεκπαίδευση.

Το SEER προεκπαιδεύεται σε μη επιμελημένες, τυχαίες εικόνες, χρησιμοποιώντας αρχιτεκτονική RegNet και την αυτοεπιβλεπόμενη μέθοδο SwAV. Συγκρίνεται με τα SimCLRv2 και ViT, τα οποία έχουν διαφορετικές αρχιτεκτονικές δικτύου. Στη συνέχεια γίνεται λεπτομερής προσαρμογή στο ImageNet και αναφέρεται η ακρίβεια top-1.
Επίδραση της χωρητικότητας του μοντέλου
Η χωρητικότητα επηρεάζει σημαντικά την απόδοση της προεκπαίδευσης. Το παρακάτω σχήμα συγκρίνει αυτή την επίδραση με την αντίστοιχη επίδραση στην εκπαίδευση από την αρχή.

Η ακρίβεια top-1 των προεκπαιδευμένων μοντέλων είναι υψηλότερη από εκείνη των μοντέλων που εκπαιδεύονται από την αρχή, και η διαφορά μεγαλώνει όσο αυξάνονται οι παράμετροι. Η μεγαλύτερη χωρητικότητα ωφελεί και τις δύο περιπτώσεις, αλλά το όφελος είναι εντονότερο στα προεκπαιδευμένα μοντέλα με μεγάλο αριθμό παραμέτρων.
Μια πιθανή αιτία υπερπροσαρμογής κατά την εκπαίδευση από την αρχή στο ImageNet είναι το μικρό μέγεθος του συνόλου δεδομένων.
Μάθηση από λίγα παραδείγματα
Η μάθηση από λίγα παραδείγματα αξιολογεί την απόδοση του SEER όταν χρησιμοποιείται μόνο ένα μέρος των συνολικών δεδομένων για τις επακόλουθες εργασίες.
Πειραματικές ρυθμίσεις
Το πλαίσιο SEER χρησιμοποιεί δύο σύνολα δεδομένων για μάθηση από λίγα παραδείγματα: τα Places205 και ImageNet. Κατά τη μεταφορά μάθησης, θεωρείται ότι το μοντέλο έχει περιορισμένη πρόσβαση τόσο στις εικόνες όσο και στις ετικέτες τους. Αυτό διαφέρει από τις συνήθεις ρυθμίσεις αυτοεπιβλεπόμενης μάθησης, όπου το μοντέλο βλέπει ολόκληρο το σύνολο δεδομένων και περιορίζεται μόνο η πρόσβαση στις ετικέτες.
Αποτελέσματα στο σύνολο δεδομένων Places205
Το παρακάτω σχήμα δείχνει την επίδραση της προεκπαίδευσης όταν χρησιμοποιούνται διαφορετικά τμήματα του συνόλου δεδομένων Places205.

Η προσέγγιση συγκρίνεται με επιβλεπόμενη προεκπαίδευση στο ImageNet, χρησιμοποιώντας την ίδια αρχιτεκτονική RegNetY-128GF. Παρατηρείται σταθερό κέρδος περίπου 2,5% στην ακρίβεια top-1, ανεξάρτητα από το ποσοστό των δεδομένων που διατίθεται για λεπτομερή προσαρμογή στο Places205.
Η διαφορά ανάμεσα στην επιβλεπόμενη και την αυτοεπιβλεπόμενη προεκπαίδευση μπορεί να εξηγηθεί από τη φύση των δεδομένων. Τα χαρακτηριστικά που μαθαίνονται από τυχαίες εικόνες πραγματικών συνθηκών μπορεί να είναι καταλληλότερα για ταξινόμηση σκηνών. Επιπλέον, η ανομοιόμορφη κατανομή των υποκείμενων εννοιών μπορεί να αποτελεί πλεονέκτημα για την προεκπαίδευση σε ένα μη ισορροπημένο σύνολο όπως το Places205.
Αποτελέσματα στο ImageNet

Ο παραπάνω πίνακας συγκρίνει το SEER με προσεγγίσεις αυτοεπιβλεπόμενης προεκπαίδευσης και ημιεπιβλεπόμενης μάθησης από λίγα παραδείγματα.
Όλες οι άλλες μέθοδοι χρησιμοποιούν και τις 1,2 εκατομμύρια εικόνες του ImageNet στην προεκπαίδευση, περιορίζοντας μόνο την πρόσβαση στις ετικέτες. Αντίθετα, η προσέγγιση του SEER επιτρέπει στο μοντέλο να βλέπει μόνο το 1–10% των εικόνων του συνόλου δεδομένων.
Οι άλλες προσεγγίσεις ωφελούνται σημαντικά επειδή τα δίκτυά τους έχουν δει περισσότερες εικόνες από την ίδια κατανομή κατά την προεκπαίδευση. Ωστόσο, παρότι το SEER βλέπει μόνο το 1–10% του ImageNet, επιτυγχάνει ακρίβεια top-1 περίπου 80%, λίγο χαμηλότερη από εκείνη των προσεγγίσεων του παραπάνω πίνακα.
Επίδραση της χωρητικότητας του μοντέλου
Το παρακάτω σχήμα εξετάζει την επίδραση της χωρητικότητας στη μάθηση από λίγα παραδείγματα, χρησιμοποιώντας το 1%, το 10% και το 100% του ImageNet.

Η αύξηση της χωρητικότητας μπορεί να βελτιώσει την ακρίβεια όταν περιορίζεται η πρόσβαση τόσο στις εικόνες όσο και στις ετικέτες του συνόλου δεδομένων.
Μεταφορά σε άλλα σύνολα αναφοράς
Για περαιτέρω αξιολόγηση του SEER, τα προεκπαιδευμένα χαρακτηριστικά μεταφέρονται σε άλλες επακόλουθες εργασίες.
Γραμμική αξιολόγηση της ταξινόμησης εικόνων

Ο παραπάνω πίνακας συγκρίνει τα χαρακτηριστικά του προεκπαιδευμένου RegNetY-256GF του SEER με εκείνα του RegNetY128-GF που προεκπαιδεύτηκε στο ImageNet, με την ίδια αρχιτεκτονική και με ή χωρίς επίβλεψη. Για την αξιολόγηση της ποιότητας των χαρακτηριστικών, τα βάρη παγώνουν και εκπαιδεύεται ένας γραμμικός ταξινομητής πάνω στα χαρακτηριστικά, χρησιμοποιώντας τα δεδομένα εκπαίδευσης των επακόλουθων εργασιών. Τα σύνολα αναφοράς είναι τα Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) και Pascal VOC (VOC).
Ανίχνευση και τμηματοποίηση
Το παρακάτω σχήμα συγκρίνει και αξιολογεί τα προεκπαιδευμένα χαρακτηριστικά σε εργασίες ανίχνευσης και τμηματοποίησης.

Το SEER εκπαιδεύει ένα μοντέλο Mask-RCNN στο σύνολο αναφοράς COCO, χρησιμοποιώντας ως βασικά στοιχεία τα προεκπαιδευμένα RegNetY-64GF και RegNetY-128GF. Και για τις δύο αρχιτεκτονικές και τις επακόλουθες εργασίες, η αυτοεπιβλεπόμενη προεκπαίδευση του SEER ξεπερνά την επιβλεπόμενη εκπαίδευση κατά 1,5 έως 2 μονάδες AP.
Σύγκριση με ασθενώς επιβλεπόμενη προεκπαίδευση
Οι περισσότερες διαδικτυακές εικόνες συνοδεύονται από μεταπεριγραφή, εναλλακτικό κείμενο, περιγραφές ή γεωγραφική θέση, στοιχεία χρήσιμα στην προεκπαίδευση. Προηγούμενη έρευνα έχει δείξει ότι η πρόβλεψη ενός επιμελημένου ή επισημασμένου συνόλου hashtag μπορεί να βελτιώσει την ποιότητα των οπτικών χαρακτηριστικών. Ωστόσο, η προσέγγιση απαιτεί φιλτράρισμα εικόνων και αποδίδει καλύτερα όταν υπάρχουν μεταδεδομένα κειμένου.
Το παρακάτω σχήμα συγκρίνει την προεκπαίδευση της αρχιτεκτονικής ResNetXt101-32dx8d σε τυχαίες εικόνες με την εκπαίδευση της ίδιας αρχιτεκτονικής σε επισημασμένες εικόνες με hashtag και μεταδεδομένα, αναφέροντας την ακρίβεια top-1 και για τις δύο περιπτώσεις.

Παρότι το SEER δεν χρησιμοποιεί μεταδεδομένα στην προεκπαίδευση, η ακρίβειά του είναι συγκρίσιμη με εκείνη των μοντέλων που τα χρησιμοποιούν.
Μελέτες αφαίρεσης συνιστωσών
Μια μελέτη αφαίρεσης συνιστωσών εξετάζει την επίδραση ενός συγκεκριμένου στοιχείου στη συνολική απόδοση. Το στοιχείο αφαιρείται πλήρως και αξιολογείται η λειτουργία του μοντέλου χωρίς αυτό. Έτσι οι προγραμματιστές αποκτούν μια εικόνα της συμβολής του συγκεκριμένου στοιχείου.
Επίδραση της αρχιτεκτονικής του μοντέλου
Η αρχιτεκτονική επηρεάζει σημαντικά την απόδοση, ιδιαίτερα όταν το μοντέλο κλιμακώνεται ή αλλάζουν οι προδιαγραφές των δεδομένων προεκπαίδευσης.
Το παρακάτω σχήμα εξετάζει πώς η αλλαγή αρχιτεκτονικής επηρεάζει την ποιότητα των προεκπαιδευμένων χαρακτηριστικών, μέσω γραμμικής αξιολόγησης στο ImageNet. Τα χαρακτηριστικά μπορούν να εξεταστούν απευθείας, επειδή η αξιολόγηση δεν ευνοεί τα μοντέλα που επιτυγχάνουν υψηλή ακρίβεια όταν εκπαιδεύονται από την αρχή στο ImageNet.

Στις αρχιτεκτονικές ResNeXt και ResNet, τα χαρακτηριστικά του προτελευταίου επιπέδου αποδίδουν καλύτερα με τις συγκεκριμένες ρυθμίσεις. Η αρχιτεκτονική RegNet, από την άλλη, ξεπερνά τις υπόλοιπες.
Συνολικά, η αύξηση της χωρητικότητας βελτιώνει την ποιότητα των χαρακτηριστικών, με λογαριθμικό κέρδος στην απόδοση.
Κλιμάκωση των δεδομένων προεκπαίδευσης
Η εκπαίδευση σε μεγαλύτερο σύνολο δεδομένων μπορεί να βελτιώσει την ποιότητα των οπτικών χαρακτηριστικών για δύο βασικούς λόγους: περισσότερες μοναδικές εικόνες και περισσότερες παράμετροι. Ας δούμε πώς επηρεάζουν την απόδοση.
Αύξηση του αριθμού μοναδικών εικόνων

Το παραπάνω σχήμα συγκρίνει τις αρχιτεκτονικές RegNet8 και RegNet16 με τον ίδιο αριθμό παραμέτρων, αλλά διαφορετικό αριθμό μοναδικών εικόνων εκπαίδευσης. Το SEER εκπαιδεύει τα μοντέλα με ενημερώσεις που αντιστοιχούν σε μία εποχή για ένα δισεκατομμύριο εικόνες ή σε 32 εποχές για 32 μοναδικές εικόνες, χρησιμοποιώντας πρόγραμμα ρυθμού μάθησης μισού συνημιτονοειδούς κύματος.
Για καλή απόδοση, ο αριθμός μοναδικών εικόνων που δέχεται το μοντέλο πρέπει ιδανικά να είναι μεγαλύτερος. Στη συγκεκριμένη περίπτωση, το μοντέλο αποδίδει καλά όταν εκπαιδεύεται σε περισσότερες μοναδικές εικόνες από όσες περιλαμβάνει το ImageNet.
Περισσότερες παράμετροι
Το παρακάτω σχήμα παρουσιάζει την απόδοση κατά την εκπαίδευση σε ένα δισεκατομμύριο εικόνες με αρχιτεκτονική RegNet-128GF. Η απόδοση αυξάνεται σταθερά όσο αυξάνονται οι παράμετροι.

Αυτοεπιβλεπόμενη υπολογιστική όραση στον πραγματικό κόσμο
Μέχρι τώρα εξετάσαμε θεωρητικά την αυτοεπιβλεπόμενη μάθηση και το SEER στην υπολογιστική όραση. Ας δούμε τώρα πώς λειτουργούν σε πραγματικές συνθήκες και γιατί το SEER αποτελεί μια κατεύθυνση για το μέλλον της αυτοεπιβλεπόμενης υπολογιστικής όρασης.
Το SEER συναγωνίζεται τις εξελίξεις στην επεξεργασία φυσικής γλώσσας, όπου κορυφαία μοντέλα χρησιμοποιούν τρισεκατομμύρια δεδομένα και παραμέτρους μαζί με τρισεκατομμύρια λέξεις στην προεκπαίδευση. Η απόδοση σε επακόλουθες εργασίες γενικά βελτιώνεται όσο αυξάνονται τα δεδομένα εκπαίδευσης, και το ίδιο ισχύει για την υπολογιστική όραση.
Ωστόσο, η αυτοεπιβλεπόμενη μάθηση στη φυσική γλώσσα διαφέρει από την αντίστοιχη προσέγγιση στην υπολογιστική όραση. Στο κείμενο οι σημασιολογικές έννοιες συνήθως χωρίζονται σε διακριτές λέξεις, ενώ στις εικόνες το μοντέλο πρέπει να αποφασίσει ποιο εικονοστοιχείο αντιστοιχεί σε κάθε έννοια.
Οι εικόνες παρουσιάζουν διαφορετικές όψεις και, ακόμη κι αν απεικονίζουν το ίδιο αντικείμενο, το εννοιολογικό πλαίσιο μπορεί να διαφέρει σημαντικά. Σε ένα σύνολο εικόνων με γάτες, για παράδειγμα, η γάτα μπορεί να στέκεται ακίνητη σε μια εικόνα και να παίζει με μια μπάλα σε άλλη. Γι’ αυτό το μοντέλο πρέπει να δει πολλές εικόνες, ώστε να κατανοήσει τις διαφορές γύρω από την ίδια έννοια.
Για να κλιμακωθεί ένα μοντέλο και να επεξεργάζεται αποδοτικά σύνθετα δεδομένα εικόνων υψηλής διάστασης, χρειάζονται δύο στοιχεία:
- Ένα συνελικτικό νευρωνικό δίκτυο (CNN) αρκετά μεγάλο ώστε να αποτυπώνει και να μαθαίνει οπτικές έννοιες από ένα τεράστιο σύνολο εικόνων.
- Ένας αλγόριθμος που μαθαίνει μοτίβα από μεγάλο όγκο εικόνων χωρίς ετικέτες, επισημάνσεις ή μεταδεδομένα.
Το SEER επιδιώκει να εφαρμόσει αυτά τα στοιχεία στην υπολογιστική όραση. Αξιοποιεί τις εξελίξεις του SwAV, ενός πλαισίου αυτοεπιβλεπόμενης μάθησης που χρησιμοποιεί διαδικτυακή ομαδοποίηση για να συνδέει εικόνες με παρόμοιες οπτικές έννοιες και να εντοπίζει καλύτερα μοτίβα μέσα από αυτές τις ομοιότητες.
Με την αρχιτεκτονική SwAV, το SEER κάνει την αυτοεπιβλεπόμενη μάθηση στην υπολογιστική όραση αποδοτικότερη και μπορεί να μειώσει τον χρόνο εκπαίδευσης έως και έξι φορές.
Η εκπαίδευση σε περισσότερες από ένα δισεκατομμύριο εικόνες απαιτεί αρχιτεκτονική αποδοτική όχι μόνο ως προς τον χρόνο εκτέλεσης και τη μνήμη, αλλά και ως προς την ακρίβεια. Εδώ αξιοποιούνται τα RegNet: συνελικτικά δίκτυα που μπορούν να κλιμακωθούν σε τρισεκατομμύρια παραμέτρους και να βελτιστοποιηθούν σύμφωνα με τους περιορισμούς μνήμης και χρόνου εκτέλεσης.
Συμπέρασμα: Ένα αυτοεπιβλεπόμενο μέλλον
Η αυτοεπιβλεπόμενη μάθηση βρίσκεται εδώ και καιρό στο επίκεντρο του κλάδου AI και ML, επειδή επιτρέπει στα μοντέλα να μαθαίνουν απευθείας από μεγάλο όγκο τυχαία διαθέσιμων διαδικτυακών δεδομένων. Έτσι δεν εξαρτώνται από προσεκτικά επιμελημένα σύνολα με ετικέτες, δημιουργημένα αποκλειστικά για την εκπαίδευσή τους.
Η αυτοεπιβλεπόμενη μάθηση είναι σημαντική για το μέλλον της AI και ML. Μπορεί να επιτρέψει στους προγραμματιστές να δημιουργούν μοντέλα που προσαρμόζονται καλά σε πραγματικές συνθήκες και εξυπηρετούν πολλούς σκοπούς αντί για έναν μόνο. Το SEER αποτελεί ορόσημο στην εφαρμογή της στην υπολογιστική όραση.
Το SEER κάνει ένα πρώτο βήμα προς τον μετασχηματισμό της υπολογιστικής όρασης και τη μείωση της εξάρτησης από δεδομένα με ετικέτες. Επιδιώκει να καταργήσει την ανάγκη επισήμανσης, επιτρέποντας στους προγραμματιστές να αξιοποιούν μεγάλο όγκο διαφορετικών δεδομένων. Αυτό είναι ιδιαίτερα χρήσιμο σε τομείς με περιορισμένες εικόνες ή μεταδεδομένα, όπως η ιατρική.
Η κατάργηση της χειροκίνητης επισήμανσης θα επιτρέψει επίσης ταχύτερη ανάπτυξη και διάθεση μοντέλων, ώστε οι προγραμματιστές να ανταποκρίνονται γρηγορότερα και με μεγαλύτερη ακρίβεια σε καταστάσεις που μεταβάλλονται ταχύτατα.


