
Η γωνία του Anderson
Το μοντέλο διάχυσης eDiffi της NVIDIA επιτρέπει τη ζωγραφική με λέξεις και πολλά ακόμη

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
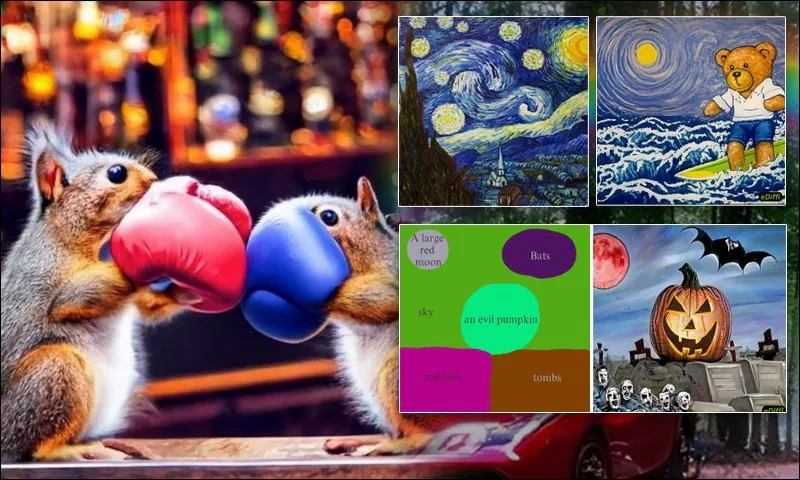
Βασικά σημείαΤο eDiffi της NVIDIA χρησιμοποιεί ένα σύνολο εξειδικευμένων αποθορυβοποιητών για…
Δείτε περισσότερα
- Το eDiffi της NVIDIA χρησιμοποιεί ένα σύνολο εξειδικευμένων αποθορυβοποιητών για ανώτερο έλεγχο από κείμενο σε εικόνα.
- Το μοντέλο ενσωματώνει κωδικοποιητές T5 και CLIP για να βελτιώσει τη λεπτομέρεια και τη συνολική σύνθεση.
- Το eDiffi επιτρέπει τη ζωγραφική με λέξεις αντιστοιχίζοντας χρώματα σε στοιχεία της προτροπής για ακριβή διάταξη.
Η προσπάθεια να δημιουργηθούν ακριβείς συνθέσεις με παραγωγικά μοντέλα εικόνας λανθάνουσας διάχυσης, όπως η Stable Diffusion, μπορεί να είναι σαν το να προσπαθείς να κατευθύνεις μια αγέλη γατιών. Η ίδια φανταστική και ερμηνευτική δύναμη που επιτρέπει στο σύστημα να δημιουργήσει εξαιρετικές λεπτομέρειες και να ανακαλέσει εξαιρετικές εικόνες από σχετικά απλές προτροπές κειμένου είναι επίσης δύσκολο να απενεργοποιηθεί όταν ψάχνεις για έλεγχο επιπέδου Photoshop πάνω σε μια παραγόμενη εικόνα.
Τώρα, μια νέα προσέγγιση από την NVIDIA (NVDA ), με τίτλο ensemble diffusion for images (eDiffi), χρησιμοποιεί ένα μείγμα πολλαπλών μεθόδων ενσωμάτωσης και ερμηνευτικών μεθόδων (αντί για την ίδια μέθοδο σε όλο το pipeline) για να επιτρέψει ένα πολύ υψηλότερο επίπεδο ελέγχου πάνω στο παραγόμενο περιεχόμενο. Στο παρακάτω παράδειγμα, βλέπουμε έναν χρήστη που ζωγραφίζει στοιχεία όπου κάθε χρώμα αντιπροσωπεύει μια λέξη από μια προτροπή κειμένου:
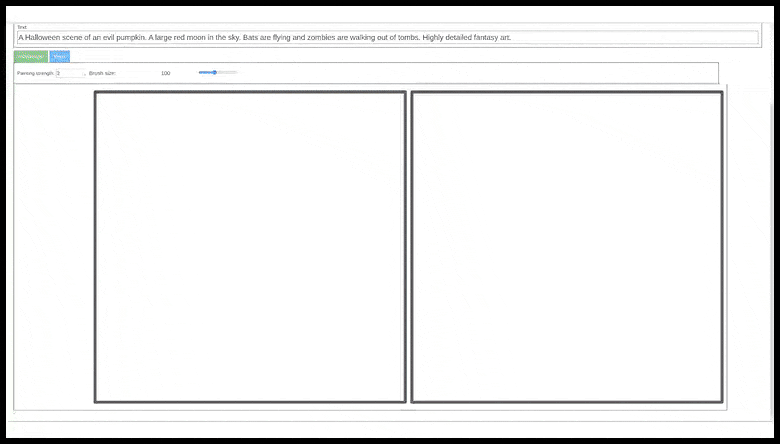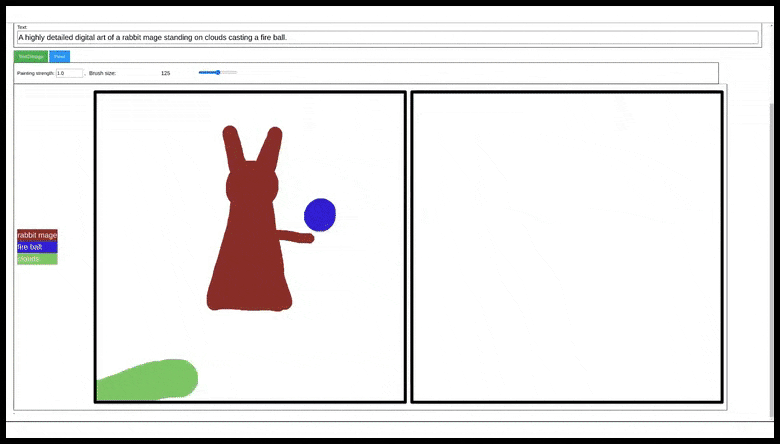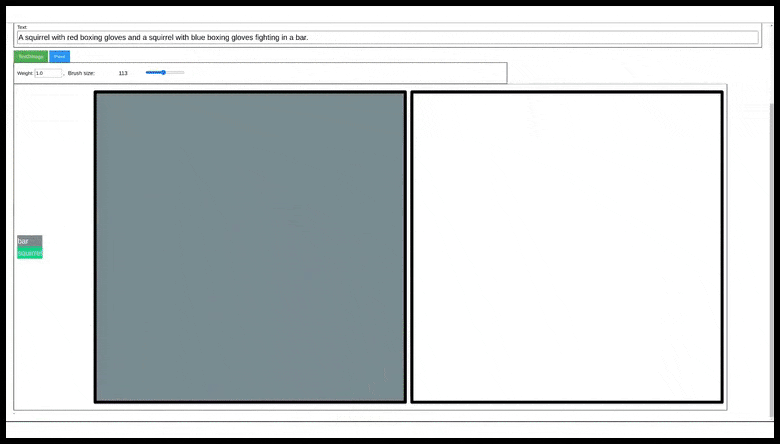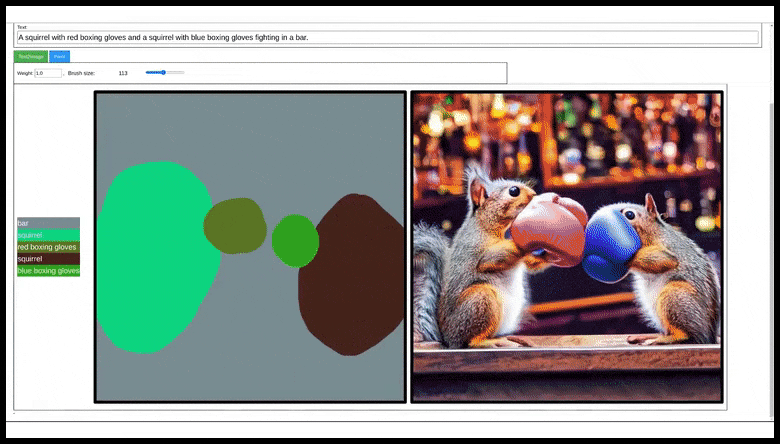
‘Ζωγραφική με λέξεις’ είναι μια από τις δύο καινούργιες ικανότητες στο μοντέλο διασποράς eDiffi της NVIDIA. Κάθε χρωματισμένο χρώμα αντιπροσωπεύει μια λέξη από την προτροπή (βλέπετε να εμφανίζονται αριστερά κατά τη διάρκεια της παραγωγής), και η περιοχή του χρώματος που εφαρμόζεται θα αποτελείται μόνο από αυτό το στοιχείο. Δείτε το επίσημο βίντεο για περισσότερα παραδείγματα και καλύτερη ανάλυση στο https://www.youtube.com/watch?v=k6cOx9YjHJc
Επιδραστικά, αυτό είναι ‘ζωγραφική με μάσκες’, και αντιστρέφει το παράδειγμα inpainting στη Stable Diffusion, η οποία βασίζεται στην επιδιόρθωση ελαττωματικών ή μη ικανοποιητικών εικόνων, ή την επέκταση εικόνων που θα μπορούσαν να ήταν της επιθυμητής μεγέθους από την αρχή.
Εδώ, αντίθετα, τα περιθώρια του ζωγραφισμένου χρώματος αντιπροσωπεύουν τα επιτρεπόμενα προσεγγιστικά όρια ενός μοναδικού στοιχείου από μία και μόνο έννοια, επιτρέποντας στον χρήστη να ορίσει το τελικό μέγεθος του καμβά από την αρχή, και στη συνέχεια να προσθέσει στοιχεία διακριτά.

Παραδείγματα από το νέο έγγραφο. Πηγή: https://arxiv.org/pdf/2211.01324.pdf
Οι ποικίλες μέθοδοι που χρησιμοποιούνται στο eDiffi σημαίνουν επίσης ότι το σύστημα κάνει μια πολύ καλύτερη δουλειά στην ένταξη κάθε στοιχείου σε μακρές και λεπτομερείς προτροπές, ενώ η Stable Diffusion και το DALL-E 2 της OpenAI τείνουν να προτιμούν ορισμένα μέρη της προτροπής, ανάλογα με το πόσο νωρίς εμφανίζονται οι λέξεις-στόχοι στην προτροπή, ή σε άλλα παράγοντες, όπως η πιθανή δυσκολία στην αποσύνδεση των διαφόρων στοιχείων που απαιτούνται για μια πλήρη αλλά συνολική (σε σχέση με την προτροπή κειμένου) σύνθεση:

Από το έγγραφο: το eDiffi είναι ικανό να επαναλαμβάνει πιο διεξοδικά τη διαδικασία μέχρι το μέγιστο δυνατό αριθμό στοιχείων να έχουν αποδοθεί. Αν και τα βελτιωμένα αποτελέσματα για το eDiffi (δεξιά στήλη) έχουν επιλεγεί ευνοϊκά, όπως και οι εικόνες σύγκρισης από τη Stable Diffusion και το DALL-E 2.
Επιπλέον, η χρήση ενός αφιερωμένου T5 κωδικοποιητή κειμένου-σε-κειμένο σημαίνει ότι το eDiffi είναι ικανό να αποδίδει κατανοητό αγγλικό κείμενο, είτε αφηρημένα ζητημένο από μια προτροπή (π.χ. η εικόνα περιέχει κάποιο κείμενο [x]) είτε ρητά ζητημένο (π.χ. η φανέλα λέει ‘Nvidia Rocks’):

Αφιερωμένη επεξεργασία κειμένου-σε-κειμένο στο eDiffi σημαίνει ότι το κείμενο μπορεί να αποδοθεί αυτούσιο στις εικόνες, αντί να τρέχεται μόνο μέσα από ένα στρώμα ερμηνείας κειμένου-σε-εικόνα που σπάει την έξοδο.
Ένα ακόμη πλεονέκτημα στο νέο πλαίσιο είναι ότι είναι δυνατό να παρέχεται μία μόνο εικόνα ως προτροπή στυλ, αντί να χρειάζεται να εκπαιδεύσετε ένα μοντέλο DreamBooth ή μια ενσωμάτωση κειμένου σε πολλαπλά παραδείγματα ενός είδους ή στυλ.

Μεταφορά στυλ μπορεί να εφαρμοστεί από μια αναφορά εικόνας σε μια προτροπή κειμένου-σε-εικόνα, ή ακόμη και μια εικόνα-σε-εικόνα προτροπή.
Το νέο έγγραφο έχει τίτλο eDiffi: Text-to-Image Diffusion Models with an Ensemble of Expert Denoisers, και
Ο Κωδικοποιητής T5
Η χρήση του Google’s Text-to-Text Transfer Transformer (T5) είναι το κρίσιμο στοιχείο στις βελτιωμένες αποδόσεις που εμφανίζονται στο eDiffi. Η μέση διαδικασία διασποράς εικόνας κεντρώνεται στην σύνδεση μεταξύ εκπαιδευμένων εικόνων και των λεζαντών που τις συνόδευαν όταν αποσπάστηκαν από το διαδίκτυο (ή αλλιώς χειροκίνητα προσαρμοσμένες αργότερα, αν και αυτό είναι μια ακριβή και επομένως σπάνια παρέμβαση).

Από το έγγραφο του Ιουλίου 2020 για το T5 – μετασχηματισμοί κειμένου, οι οποίοι μπορούν να βοηθήσουν τη γενετική διαδικασία εικόνας στο eDiffi (και, πιθανώς, άλλα μοντέλα λανθάνουσας διάχυσης). Πηγή: https://arxiv.org/pdf/1910.10683.pdf
Με την επαναδιατύπωση του πηγαίου κειμένου και την εκτέλεση του T5, μπορούν να ληφθούν πιο ακριβείς συνδέσεις και αναπαραστάσεις από αυτές που εκπαιδεύτηκαν αρχικά στο μοντέλο, σχεδόν σαν χειροκίνητη επισήμανση εκ των υστέρων με μεγαλύτερη ειδικότητα και εφαρμογή στις προδιαγραφές της ζητούμενης προτροπής κειμένου.
Οι συγγραφείς εξηγούν:
‘Στις περισσότερες υπάρχουσες εργασίες για τα μοντέλα διασποράς, το μοντέλο αφαίρεσης θορύβου είναι κοινό σε όλα τα επίπεδα θορύβου, και η χρονική δυναμική αντιπροσωπεύεται χρησιμοποιώντας μια απλή εμβύθωση χρόνου που τροφοδοτείται στο μοντέλο αφαίρεσης θορύβου μέσω ενός δικτύου MLP. Υποστηρίζουμε ότι η σύνθετη χρονική δυναμική της διαδικασίας διάχυσης με αφαίρεση θορύβου μπορεί να μην μάθει αποτελεσματικά από τα δεδομένα χρησιμοποιώντας ένα κοινό μοντέλο με περιορισμένη ικανότητα.
‘Αντίθετα, προτείνουμε να αυξήσουμε την ικανότητα του μοντέλου θορύβου εισάγοντας ένα σύνολο ειδικών μοντέλων αφαίρεσης θορύβου. Κάθε ειδικό μοντέλο αφαίρεσης θορύβου είναι ένα μοντέλο αφαίρεσης θορύβου που ειδικεύεται σε μια συγκεκριμένη περιοχή επιπέδων θορύβου. Αυτό μας επιτρέπει να αυξήσουμε την ικανότητα του μοντέλου χωρίς να επιβραδύνουμε την δειγματοληψία, επειδή η υπολογιστική πολυπλοκότητα της αξιολόγησης [του επεξεργασμένου στοιχείου] σε κάθε επίπεδο θορύβου παραμένει η ίδια.’

Εννοιολογική αρχιτεκτονική για το eDiffi.
Τα υπάρχοντα CLIP ενότητες κωδικοποίησης που περιλαμβάνονται στο DALL-E 2 και τη Stable Diffusion είναι επίσης ικανά να βρουν εναλλακτικές ερμηνείες εικόνας για κείμενο που σχετίζεται με την είσοδο του χρήστη. Ωστόσο, αυτά εκπαιδεύονται σε παρόμοια πληροφορίες με το αρχικό μοντέλο και δεν χρησιμοποιούνται ως ξεχωριστό στρώμα ερμηνείας στη διαδικασία όπως το T5 στο eDiffi.
Οι συγγραφείς δηλώνουν ότι το eDiffi είναι η πρώτη φορά που τόσο ένα T5 όσο και ένα CLIP κωδικοποιητής έχουν ενσωματωθεί σε μία ενιαία διαδικασία:
’Καθώς αυτοί οι κωδικοποιητές εκπαιδεύτηκαν με διαφορετικούς στόχους, οι εμβύθωσές τους ευνοούν τη διαμόρφωση διαφορετικών εικόνων με την ίδια είσοδο κειμένου. Ενώ οι εμβύθωσεις κειμένου CLIP βοηθούν στην καθορισμό του συνολικού στυλ των γενετικών εικόνων, οι εξαγωγές τους τείνουν να λείπουν των λεπτομερειών στο κείμενο.
’Αντίθετα, οι εικόνες που γεννιούνται μόνο με ενσωματώσεις κειμένου T5 αντανακλούν καλύτερα τα ατομικά αντικείμενα που περιγράφονται στο κείμενο, αλλά το συνολικό στυλ τους είναι λιγότερο ακριβές. Η χρήση τους από κοινού παράγει τα καλύτερα αποτελέσματα γεννήσεως εικόνας στο μοντέλο μας.’
Διακόπτοντας και Αυξάνοντας τη Διαδικασία Διασποράς
Το έγγραφο σημειώνει ότι ένα τυπικό μοντέλο διασποράς εικόνας θα αρχίσει το ταξίδι από τον καθαρό θόρυβο σε μια εικόνα βασισμένο αποκλειστικά στο κείμενο στις πρώτες φάσεις της παραγωγής.
Όταν ο θόρυβος εξελίσσεται σε κάποιο είδος χονδρής διάταξης που αντιπροσωπεύει την περιγραφή στο κείμενο, η πλευρά καθοδηγούμενη από το κείμενο της διαδικασίας ουσιαστικά εξαφανίζεται, και το υπόλοιπο της διαδικασίας μετατοπίζεται προς την αύξηση των οπτικών χαρακτηριστικών.
Αυτό σημαίνει ότι οποιοδήποτε στοιχείο που δεν αποκαλύφθηκε στην αρχική φάση της ερμηνείας θορύβου με καθοδήγηση κειμένου είναι δύσκολο να εισαχθεί στην εικόνα αργότερα, επειδή οι δύο διαδικασίες (κειμένου-σε-διάταξη και διάταξης-σε-εικόνα) έχουν σχετικά λίγη επικάλυψη, και η βασική διάταξη είναι αρκετά αλληλένδετη μέχρι να φτάσει στη διαδικασία αύξησης εικόνας.

Από το έγγραφο: οι χάρτες προσοχής των διαφόρων μερών της διαδικασίας καθώς η διαδικασία θορύβου-σε-εικόνα ωριμάζει. Μπορούμε να δούμε την απότομη πτώση της επιρροής του CLIP στην εικόνα στη χαμηλότερη σειρά, ενώ το T5 συνεχίζει να επηρεάζει την εικόνα πολύ περισσότερο στη διαδικασία απόδοσης.
Επαγγελματικές δυνατότητες
Τα παραδείγματα στη σελίδα του έργου και το βίντεο στο YouTube επικεντρώνονται σε φιλικές για το κοινό γεννήσεις εικόνων. Όπως συνήθως, η έρευνα της NVIDIA υποβαθμίζει τις δυνατότητες της πιο πρόσφατης καινοτομίας της να βελτιώσει τις φωτορεαλιστικές ή VFX διαδικασίες, καθώς και την δυνατότητά της να βελτιώσει τις εικόνες deepfake και βίντεο.
Στα παραδείγματα, ένας αρχάριος ή ερασιτέχνης χρήστης ζωγραφίζει χονδρικά περιγράμματα για την τοποθέτηση του συγκεκριμένου στοιχείου, ενώ σε μια πιο συστηματική VFX διαδικασία, θα ήταν δυνατό να χρησιμοποιηθεί το eDiffi για να ερμηνεύσει πολλαπλά καρέ ενός βίντεο στοιχείου χρησιμοποιώντας κείμενο-σε-εικόνα, όπου τα περιγράμματα είναι πολύ ακριβή και βασίζονται, για παράδειγμα, σε φιγούρες όπου το φόντο έχει αφαιρεθεί μέσω πράσινου οθόνης ή αλγορίθμων.

Η Runway ML προσφέρει ήδη AI-βασισμένη rotoscoping. Σε αυτό το παράδειγμα, η ‘πράσινη οθόνη’ γύρω από το αντικείμενο αντιπροσωπεύει το στρώμα αλφα, ενώ η εξαγωγή έχει επιτευχθεί μέσω μηχανικής μάθησης και όχι αλγορίθμων αφαίρεσης πραγματικού φόντου πράσινου οθόνης. Πηγή: https://twitter.com/runwayml/status/1330978385028374529
Χρησιμοποιώντας ένα εκπαιδευμένο DreamBooth χαρακτήρα και μια εικόνα-σε-εικόνα διαδικασία με το eDiffi, είναι πιθανό να αρχίσει να λύνει ένα από τα προβλήματα οποιουδήποτε μοντέλου διασποράς: τη χρονική σταθερότητα. Σε τέτοια περίπτωση, και τα περιθώρια της επιβαλλόμενης εικόνας και το περιεχόμενο της εικόνας θα ‘παρατηρούνται’ ενάντια στον καμβά του χρήστη, με χρονική συνέχεια του αποδοθέντος περιεχομένου (π.χ. μετατρέποντας έναν πραγματικό ασκούμενο του Tai Chi σε ρομπότ) που παρέχεται από τη χρήση ενός κλειδωμένου μοντέλου DreamBooth που έχει απομνημονεύσει τα δεδομένα εκπαίδευσής του – κακό για την ερμηνευσιμότητα, αλλά μεγάλο για την αναπαραγωγιμότητα, την πιστότητα και τη συνέχεια.
Μέθοδος, Δεδομένα και Δοκιμές
Το έγγραφο αναφέρει ότι το μοντέλο eDiffi εκπαιδεύτηκε σε ‘μια συλλογή δημόσιων και ιδιωτικών συνόλων δεδομένων’, που φιλτράρονται έντονα από ένα προ-εκπαιδευμένο μοντέλο CLIP, για να αφαιρεθούν εικόνες που πιθανότατα θα μειώσουν το γενικό αισθητικό σκορ της έξοδου. Το τελικό φιλτραρισμένο σύνολο εικόνας αποτελείται από ‘περίπου ένα δισεκατομμύριο’ ζευγάρια κειμένου-εικόνας. Η μέγεθος των εκπαιδευμένων εικόνων περιγράφεται ως με ‘τη μικρότερη πλευρά μεγαλύτερη από 64 pixels’.
Πολλά μοντέλα εκπαιδεύτηκαν για τη διαδικασία, με τα βασικά και τα μοντέλα υπερ-ανάλυσης εκπαιδευμένα με τον βελτιστοποιητή AdamW σε μια ταχύτητα μάθησης 0,0001, με συντελεστή απομείωσης βαρών 0,01, και σε ένα επιβλητικό μέγεθος παρτίδας 2048.
Το βασικό μοντέλο εκπαιδεύτηκε σε 256 NVIDIA A100 GPUs, και τα δύο μοντέλα υπερ-ανάλυσης σε 128 NVIDIA A100 GPUs για κάθε μοντέλο.
Το σύστημα βασίστηκε στη δική της Imaginaire βιβλιοθήκη PyTorch της NVIDIA. COCO και Visual Genome datasets χρησιμοποιήθηκαν για αξιολόγηση, αν και δεν συμπεριλήφθηκαν στα τελικά μοντέλα, με MS-COCO την ειδική παραλλαγή που χρησιμοποιήθηκε για δοκιμές. Τα αντίπαλα συστήματα που δοκιμάστηκαν ήταν GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion, και τα δύο συστήματα σύνθεσης εικόνας της Google, Imagen και Parti.
Σύμφωνα με παρόμοια προηγούμενη εργασία, zero-shot FID-30K χρησιμοποιήθηκε ως μετρική αξιολόγησης. Υπό FID-30K, 30.000 λεζάντες εξάγονται τυχαία από το σύνολο επικύρωσης COCO (π.χ. όχι τις εικόνες ή το κείμενο που χρησιμοποιήθηκαν στην εκπαίδευση), τα οποία στη συνέχεια χρησιμοποιήθηκαν ως προτροπές κειμένου για τη σύνθεση εικόνων.
Η απόσταση Frechet Inception (FID) μεταξύ των γενετικών και των πραγματικών εικόνων υπολογίστηκε, μαζί με την καταγραφή του σκορ CLIP για τις γενετικές εικόνες.

Αποτελέσματα από τις δοκιμές zero-shot FID ενάντια στις τρέχουσες προσεγγίσεις αιχμής στο σύνολο επικύρωσης COCO 2014, με χαμηλότερα αποτελέσματα καλύτερα.
Στα αποτελέσματα, το eDiffi ήταν σε θέση να πάρει το χαμηλότερο (καλύτερο) σκορ σε zero-shot FID ακόμη και ενάντια σε συστήματα με πολύ περισσότερους παραμέτρους, όπως τα 20 δισεκατομμύρια παραμέτρους του Parti, σε σύγκριση με τα 9,1 δισεκατομμύρια παραμέτρους στο μοντέλο eDiffi με τις υψηλότερες προδιαγραφές που εκπαιδεύτηκε για τις δοκιμές.
Συμπέρασμα
Το eDiffi της NVIDIA αντιπροσωπεύει μια ευπρεπή εναλλακτική λύση στο να προσθέτει ολοένα και περισσότερα δεδομένα και πολυπλοκότητα στα υπάρχοντα συστήματα, χρησιμοποιώντας αντί γι’ αυτό μια πιο έξυπνη και πολυεπίπεδη προσέγγιση σε ορισμένα από τα πιο δύσκολα εμπόδια που σχετίζονται με την εμπλοκή και την μη επεξεργάσιμη διαδικασία διασποράς γενετικών εικόνων.
Υπάρχει ήδη συζήτηση στα subreddit και Discord της Stable Diffusion για την ενσωμάτωση του κώδικα του eDiffi, ή αλλιώς την εκ νέου υλοποίηση των αρχών πίσω του σε μια ξεχωριστή υλοποίηση. Η νέα διαδικασία, ωστόσο, είναι τόσο ριζικά διαφορετική, που θα αποτελούσε μια ολόκληρη αλλαγή της έκδοσης για την SD, απορρίπτοντας μέρος της συμβατότητας με προηγούμενες εκδόσεις, αν και προσφέροντας τη δυνατότητα να βελτιωθούν σημαντικά τα επίπεδα ελέγχου πάνω στις τελικές συνθετικές εικόνες, χωρίς να θυσιάζουν τις καταπληκτικές φανταστικές δυνάμεις της διασποράς.
Πρώτη δημοσίευση: 3 Νοεμβρίου 2022.


