
Μοντέλα και πλατφόρμες AI
EchoSpeech: Επανάσταση στην Επικοινωνία με Τεχνολογία Αναγνώρισης Σιωπηλού Λόγου

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
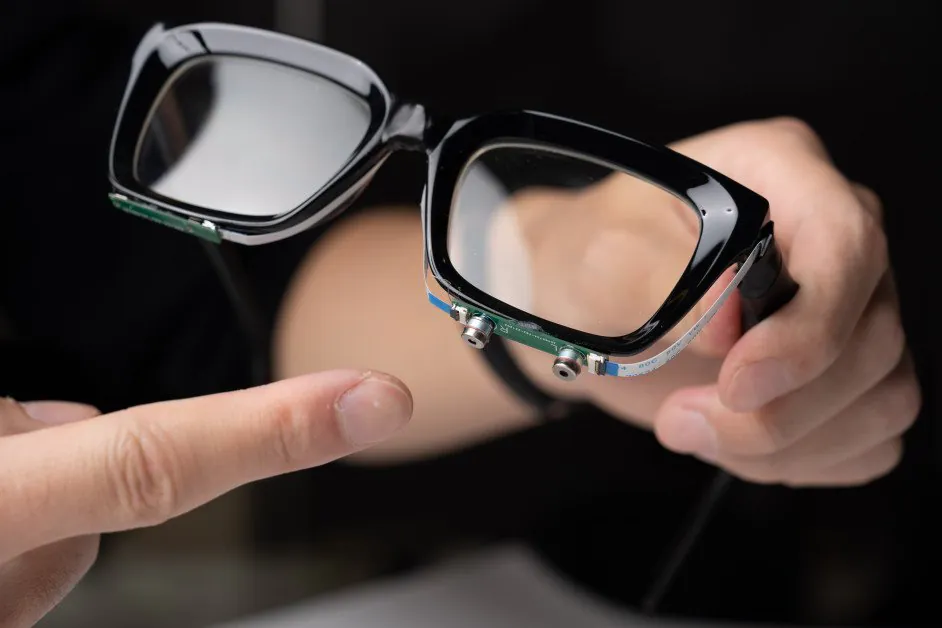
Ερευνητές στο Πανεπιστήμιο Κορνέλ έχουν αναπτύξει το EchoSpeech, μια διεπαφή αναγνώρισης σιωπηλού λόγου που χρησιμοποιεί ακουστική ανίχνευση και τεχνητή νοημοσύνη για τη συνεχή αναγνώριση μέχρι 31 μη προφορικών εντολών με βάση τις κινήσεις των χειλιών και του στόματος. Αυτή η διεπαφή χαμηλής ισχύος και φορητή μπορεί να λειτουργήσει σε ένα smartphone και απαιτεί μόνο λίγα λεπτά δεδομένων εκπαίδευσης του χρήστη για την αναγνώριση εντολών.
Ο Ruidong Zhang, διδακτορικός φοιτητής πληροφορικής, είναι ο κύριος συγγραφέας του “EchoSpeech: Συνεχής Αναγνώριση Σιωπηλού Λόγου σε Ελάχιστα Παρεμβατικά Γυαλιά με Ακουστική Ανίχνευση,” το οποίο θα παρουσιαστεί στη Διάσκεψη της Ένωσης για την Επιστήμη των Υπολογιστών για Ανθρώπινους Παράγοντες σε Συστήματα Υπολογιστών (CHI) αυτό το μήνα στο Αμβούργο, Γερμανία.
«Για άτομα που δεν μπορούν να προφορίσουν ήχους, αυτή η τεχνολογία σιωπηλού λόγου θα μπορούσε να είναι μια εξαιρετική είσοδος για έναν συνθέτη φωνής. Θα μπορούσε να δώσει στους ασθενείς την φωνή τους πίσω», είπε ο Zhang, υπογραμμίζοντας τις πιθανές εφαρμογές της τεχνολογίας με περαιτέρω ανάπτυξη.
Πρακτικές Εφαρμογές και Πλεονεκτήματα Ιδιωτικότητας
Στην τρέχουσα μορφή της, το EchoSpeech θα μπορούσε να χρησιμοποιηθεί για επικοινωνία με άλλους μέσω smartphone σε περιβάλλοντα όπου η ομιλία είναι άβολη ή ανεπιθύμητη, όπως σε θορυβώδη εστιατόρια ή ήσυχες βιβλιοθήκες. Η διεπαφή σιωπηλού λόγου μπορεί επίσης να συνδυαστεί με μια γραφίδα και να χρησιμοποιηθεί με λογισμικό σχεδίασης όπως το CAD, μειώνοντας σημαντικά την ανάγκη για πληκτρολόγιο και ποντίκι.
Εξοπλισμένα με μικρόφωνα και ηχεία μικρότερα από τις γόμες μολυβιών, τα γυαλιά EchoSpeech λειτουργούν ως φορητό σύστημα sonar με τεχνητή νοημοσύνη, στέλνοντας και λαμβάνοντας ήχους στο πρόσωπο και ανιχνεύοντας κινήσεις του στόματος. Ένας αλγόριθμος βαθιάς μάθησης αναλύει αυτά τα προφίλ ηχών σε πραγματικό χρόνο με ακρίβεια περίπου 95%.
«Μεταφέρουμε το sonar στο σώμα», είπε ο Cheng Zhang, επίκουρος καθηγητής πληροφορικής και διευθυντής του Εργαστηρίου Έξυπνων Υπολογιστικών Διεπαφών για Μελλοντικές Αλληλεπιδράσεις (SciFi) του Κορνέλ.
Η υφιστάμενη τεχνολογία αναγνώρισης σιωπηλού λόγου συνήθως βασίζεται σε ένα περιορισμένο σύνολο προκαθορισμένων εντολών και απαιτεί από τον χρήστη να κοιτάζει προς μια κάμερα ή να τη φοράει. Ο Cheng Zhang εξήγησε ότι αυτό δεν είναι ούτε πρακτικό ούτε εφικτό και επίσης δημιουργεί σοβαρές ανησυχίες για την ιδιωτικότητα τόσο για τον χρήστη όσο και για εκείνους με τους οποίους αλληλεπιδρά.
Η τεχνολογία ακουστικής ανίχνευσης του EchoSpeech εξαλείφει την ανάγκη για φορητές βιντεοκαμερές. Επιπλέον, καθώς τα δεδομένα ήχου είναι μικρότερα από τα δεδομένα εικόνας ή βίντεο, απαιτούν λιγότερο εύρος ζώνης για επεξεργασία και μπορούν να μεταδοθούν σε ένα smartphone μέσω Bluetooth σε πραγματικό χρόνο, σύμφωνα με τον François Guimbretière, καθηγητή πληροφορικής.
«Και επειδή τα δεδομένα επεξεργάζονται τοπικά στο smartphone σας αντί να ανεβαίνουν στο cloud», είπε, «πληροφορίες ευαίσθητες στην ιδιωτικότητα ποτέ δεν αφήνουν τον έλεγχό σας».



