
Μοντέλα και πλατφόρμες AI
DIRFA Μετατρέπει Τα Ηχητικά Κλιπ Σε Ψευδοπραγματικά Ψηφιακά Πρόσωπα

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
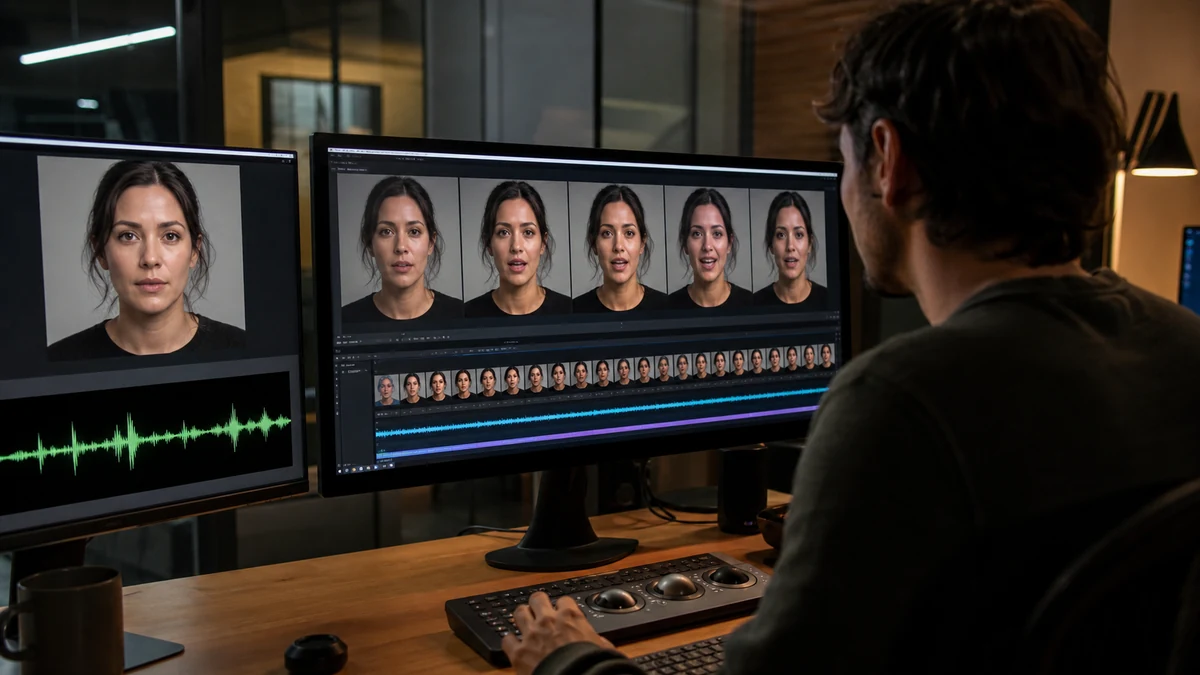
Σε ένα εξαιρετικό βήμα προς τα εμπρός για την τεχνητή νοημοσύνη και την πολυμεσική επικοινωνία, μια ομάδα ερευνητών στο Πανεπιστήμιο Nanyang της Σιγκαπούρης (NTU Singapore) έχει παρουσιάσει ένα καινοτόμο πρόγραμμα υπολογιστή με το όνομα DIRFA (Πολυμορφικές και Πραγματιστικές Προσώπων Animations).
Αυτή η τεχνολογία βασισμένη σε AI αποδεικνύει μια εκπληκτική ικανότητα: μετατρέπει ένα απλό ηχητικό κλιπ και μια στατική φωτογραφία προσώπου σε πραγματιστικά, 3D)animated βίντεο. Τα βίντεο εκθέτουν όχι μόνο ακριβή συγχρονισμό χειλιών με το ηχητικό, αλλά και μια πλούσια ποικιλία από εκφράσεις προσώπου και φυσικές κινήσεις κεφαλής,推οντας τα όρια της ψηφιακής δημιουργίας μέσων.
Ανάπτυξη του DIRFA
Η βασική λειτουργικότητα του DIRFA βρίσκεται στο προηγμένο αλγόριθμο που συνδυάζει μερικά ηχητικά δεδομένα με φωτογραφικές εικόνες για να παράγει τριδιάστατα βίντεο. Αναλύοντας μερικά τα προφίλ ομιλίας και τους τόνους στο ηχητικό, το DIRFA προβλέπει και αναπαράγει αντίστοιχες εκφράσεις προσώπου και κινήσεις κεφαλής. Αυτό σημαίνει ότι το αποτέλεσμα του βίντεο απεικονίζει τον ομιλητή με υψηλό βαθμό πραγματικότητας, με τις κινήσεις του προσώπου να συγχρονίζονται απόλυτα με τις νюανς των λεγόμενων του.
Η ανάπτυξη του DIRFA σηματοδοτεί μια σημαντική βελτίωση σε σχέση με τις προηγούμενες τεχνολογίες σε αυτόν τον χώρο, οι οποίες συχνά έπασχαν από τις сложότητες των διαφόρων στάσεων και εκφράσεων.
Οι παραδοσιακές μεθόδους συχνά έπασχαν από δυσκολίες στην ακριβή αναπαραγωγή των υποtilities των ανθρώπινων συναισθημάτων ή είχαν περιορισμένες δυνατότητες στην αντιμετώπιση διαφορετικών στάσεων κεφαλής. Το DIRFA, ωστόσο, excels στην καταγραφή ενός ευρέος φάσματος συναισθηματικών νυάνσεων και μπορεί να προσαρμοστεί σε διάφορες προσανατολίσεις κεφαλής, προσφέροντας ένα πολύ πιο ευέλικτο και πραγματιστικό αποτέλεσμα.
Αυτή η πρόοδος δεν είναι μόνο ένα βήμα προς τα εμπρός στην τεχνολογία AI, αλλά ανοίγει επίσης νέους ορίζοντες στην façon με την οποία μπορούμε να αλληλεπιδράσουμε και να χρησιμοποιήσουμε τα ψηφιακά μέσα, προσφέροντας μια ματιά σε ένα μέλλον όπου η ψηφιακή επικοινωνία λαμβάνει μια πιο προσωπική και εκφραστική φύση.
Εκπαίδευση και Τεχνολογία Πίσω από το DIRFA
Η ικανότητα του DIRFA να αναπαράγει ανθρώπινα πρόσωπα με τέτοια ακρίβεια είναι αποτέλεσμα ενός εκτεταμένου προγράμματος εκπαίδευσης. Η ομάδα στο NTU Singapore εκπαίδευσε το πρόγραμμα σε ένα τεράστιο σύνολο δεδομένων – πάνω από 1 εκατομμύριο ηχητικά βίντεο από το VoxCeleb2 Dataset.
Αυτό το σύνολο δεδομένων περιλαμβάνει μια ποικιλία από εκφράσεις προσώπου, κινήσεις κεφαλής και προφίλ ομιλίας από πάνω από 6.000 άτομα. Εκθέτοντας το DIRFA σε τέτοιο ένα τεράστιο και ποικιλόμορφο σύνολο ηχητικών δεδομένων, το πρόγραμμα έμαθε να αναγνωρίζει και να αναπαράγει τις λεπτές νυάνσεις που χαρακτηρίζουν τις ανθρώπινες εκφράσεις και την ομιλία.
Ο Αναπληρωτής Καθηγητής Lu Shijian, ο συγγραφέας της μελέτης, και ο Δρ. Wu Rongliang, ο πρώτος συγγραφέας, έχουν μοιραστεί πολύτιμες πληροφορίες σχετικά με τη σημασία του έργου τους.
“Η επίδραση της μελέτης μας θα μπορούσε να είναι βαθιά και μακροπρόθεσμη, καθώς επαναπροσδιορίζει τον χώρο της πολυμεσικής επικοινωνίας, επιτρέποντας τη δημιουργία εξαιρετικά πραγματιστικών βίντεο ατόμων που ομιλούν, συνδυάζοντας τεχνικές όπως η τεχνητή νοημοσύνη και η μηχανική μάθηση”, είπε ο Αναπληρωτής Καθηγητής Lu. “Το πρόγραμμα μας επίσης βασίζεται σε προηγούμενες μελέτες και αντιπροσωπεύει μια πρόοδο στην τεχνολογία, καθώς τα βίντεο που δημιουργούνται με το πρόγραμμα μας είναι πλήρη με ακριβείς κινήσεις χειλιών, ζωηρές εκφράσεις προσώπου και φυσικές κινήσεις κεφαλής, χρησιμοποιώντας μόνο τις ηχητικές ηχογραφήσεις και στατικές εικόνες.”
Ο Δρ. Wu Rongliang πρόσθεσε, “Η ομιλία εκθέτει μια ποικιλία από παραλλαγές. Τα άτομα προφέρονται τα ίδια λόγια διαφορετικά σε διάφορες περιπτώσεις, περιλαμβάνοντας παραλλαγές στη διάρκεια, την αμplitude, τον τόνο και άλλα. Επιπλέον, πέρα από το γλωσσικό περιεχόμενο, η ομιλία μεταφέρει πλούσια πληροφορίες σχετικά με την συναισθηματική κατάσταση και τα χαρακτηριστικά του ομιλητή, όπως το φύλο, η ηλικία, η εθνικότητα και ακόμη και τα χαρακτηριστικά της προσωπικότητας. Η προσέγγισή μας αντιπροσωπεύει μια πρωτοποριακή προσπάθεια στην ενίσχυση της απόδοσης από την οπτική της εκμάθησης αναπαράστασης ήχου στην τεχνητή νοημοσύνη και τη μηχανική μάθηση.”

Σύγκριση του DIRFA με τις πιο προηγμένες προσεγγίσεις για την δημιουργία ομιλίας με πρόσωπο που οδηγείται από ήχο. (NTU Singapore)
Πιθανές Εφαρμογές
Μια από τις πιο υποσχόμενες εφαρμογές του DIRFA είναι στον τομέα της υγείας, ιδιαίτερα στην ανάπτυξη εξελιγμένων εικονικών βοηθών και chatbots. Με την ικανότητά του να δημιουργεί πραγματιστικές και ανταποκρικτικές εκφράσεις προσώπου, το DIRFA θα μπορούσε να βελτιώσει σημαντικά την εμπειρία του χρήστη στις ψηφιακές πλατφόρμες υγείας, καθιστώντας τις αλληλεπιδράσεις πιο προσωπικές και ελκυστικές. Αυτή η τεχνολογία θα μπορούσε να είναι καθοριστική στην παροχή συναισθηματικής άνεσης και προσωπικής φροντίδας μέσω εικονικών μέσων, ένα κρίσιμο στοιχείο που συχνά λείπει στις τρέχουσες ψηφιακές λύσεις υγείας.
Το DIRFA έχει επίσης τεράστια δυνατότητα στη βοήθεια ατόμων με προβλήματα ομιλίας ή εκφράσεων προσώπου. Για εκείνους που αντιμετωπίζουν προκλήσεις στην ομιλία ή στις εκφράσεις προσώπου, το DIRFA θα μπορούσε να χρησιμεύσει ως ένα ισχυρό εργαλείο, επιτρέποντάς τους να εκφράσουν τις σκέψεις και τα συναισθήματά τους μέσω εκφραστικών अवταράκων ή ψηφιακών αναπαραστάσεων. Μπορεί να ενισχύσει την ικανότητά τους να επικοινωνούν αποτελεσματικά, γέμισαν το χάσμα μεταξύ των προθέσεών τους και των εκφράσεων. Παρέχοντας einen ψηφιακό μέσο εκφράσεων, το DIRFA θα μπορούσε να παίξει einen κρίσιμο ρόλο στην ενδυνάμωση αυτών των ατόμων, προσφέροντάς τους μια νέα οδό να αλληλεπιδράσουν και να εκφραστούν στον ψηφιακό κόσμο.
Προκλήσεις και Μελλοντικές Κατευθύνσεις
Η δημιουργία ψευδοπραγματικών εκφράσεων προσώπου μόνο από ηχητικά δεδομένα παρουσιάζει μια σύνθετη πρόκληση στον χώρο της τεχνητής νοημοσύνης και της πολυμεσικής επικοινωνίας. Η τρέχουσα επιτυχία του DIRFA σε αυτόν τον τομέα είναι αξιοσημείωτη, ωστόσο οι λεπτομέρειες των ανθρώπινων εκφράσεων σημαίνουν ότι υπάρχει πάντα χώρος για βελτίωση. Κάθε άτομο έχει einen μοναδικό προφίλ ομιλίας, και οι εκφράσεις του προσώπου possono να ποικίλλουν δραματικά ακόμη και με την ίδια ηχητική είσοδο. Η καταγραφή αυτής της ποικιλίας και λεπτότητας παραμένει eine κρίσιμη πρόκληση για την ομάδα του DIRFA.
Ο Δρ. Wu αναγνωρίζει ορισμένες περιορισμοί στην τρέχουσα έκδοση του DIRFA. Συγκεκριμένα, η διεπαφή του προγράμματος και το βαθμό ελέγχου που προσφέρει για τις εξόδους εκφράσεων χρειάζονται βελτίωση. Για παράδειγμα, η αδυναμία να điều chỉnh συγκεκριμένες εκφράσεις, όπως η αλλαγή ενός γρύλου σε ένα χαμόγελο, είναι ένα περιορισμό που στοχεύουν να ξεπεράσουν. Η αντιμετώπιση αυτών των περιορισμών είναι κρίσιμη για την επέκταση της εφαρμογής και της προσιτότητας του DIRFA.
Προβλέποντας το μέλλον, η ομάδα του NTU σχεδιάζει να ενισχύσει το DIRFA με ένα πιο ποικιλόμορφο σύνολο δεδομένων, που περιλαμβάνει einen ευρύτερο φάσμα από εκφράσεις προσώπου και ηχητικά κλιπ. Αυτή η επέκταση αναμένεται να βελτιώσει περαιτέρω την ακρίβεια και την πραγματικότητα των εκφράσεων προσώπου που παράγονται από το DIRFA, καθιστώντας τις πιο ευέλικτες και προσαρμόσιμες σε διάφορες εφαρμογές.
Η Επίδραση και το Πιθανό του DIRFA
Το DIRFA, με την πρωτοποριακή προσέγγισή του στην σύνθεση πραγματιστικών εκφράσεων προσώπου από ήχο, είναι έτοιμο να επαναπροσδιορίσει τον χώρο της πολυμεσικής επικοινωνίας. Αυτή η τεχνολογία推ίζει τα όρια της ψηφιακής αλληλεπίδρασης, θολώνοντας τα σύνορα μεταξύ του ψηφιακού και του φυσικού κόσμου. Επιτρέποντας τη δημιουργία ακριβών, ψευδοπραγματικών ψηφιακών αναπαραστάσεων, το DIRFA βελτιώνει την ποιότητα και την αυθεντικότητα της ψηφιακής επικοινωνίας.
Το μέλλον των τεχνολογιών όπως το DIRFA στην ενίσχυση της ψηφιακής επικοινωνίας και αναπαράστασης είναι τεράστιο και ενθουσιαστικό. Όσο αυτές οι τεχνολογίες συνεχίζουν να εξελίσσονται, υποσχέονται να προσφέρουν πιο εύκολες, προσωπικές και εκφραστικές τρόπους αλληλεπίδρασης στον ψηφιακό χώρο.
Μπορείτε να βρείτε τη δημοσιευμένη μελέτη εδώ.


