
Η γωνία του Anderson
Ανίχνευση βιντεοκλήσεων deepfake μέσω του φωτισμού της οθόνης

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
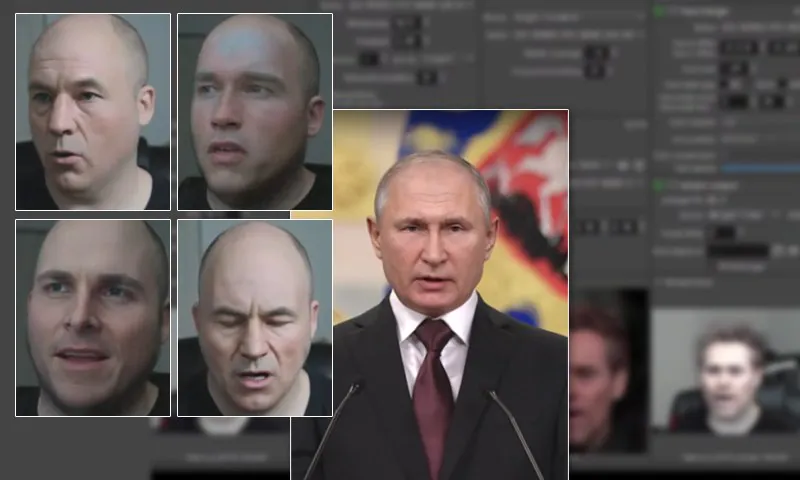
Βασικά σημείαΗ ενεργή φωταγώγηση με αλλαγές απομονωμένης φωτεινότητας αποφεύγει την αυτόματη έκθεση…
Δείτε περισσότερα
- Η ενεργή φωταγώγηση με αλλαγές απομονωμένης φωτεινότητας αποφεύγει την αυτόματη έκθεση και την αντιστάθμιση λευκής ισορροπίας της κάμερας web.
- Το σύστημα ανιχνεύει την καθυστέρηση deepfake μετρώντας μια χρονική μετατόπιση 1-4 καρέ μεταξύ της απόχρωσης της οθόνης και της απόχρωσης του προσώπου.
- Μελλοντικά συστήματα θα μπορούσαν να επεκτείνουν την ανίχνευση πέρα από το πρόσωπο στον λαιμό και το φόντο για πλουσιότερη ανάλυση τρισδιάστατου φωτισμού.
Μια νέα συνεργασία μεταξύ ενός ερευνητή από την Εθνική Υπηρεσία Ασφαλείας (NSA) των Ηνωμένων Πολιτειών και του Πανεπιστημίου της Καλιφόρνιας στο Μπέρκλεϊ προσφέρει μια νέα μέθοδο για την ανίχνευση περιεχομένου deepfake σε ζωντανές βιντεοκλήσεις – παρατηρώντας την επίδραση του φωτισμού της οθόνης στην εμφάνιση του ατόμου στο άλλο άκρο της βίντεο κλήσης.
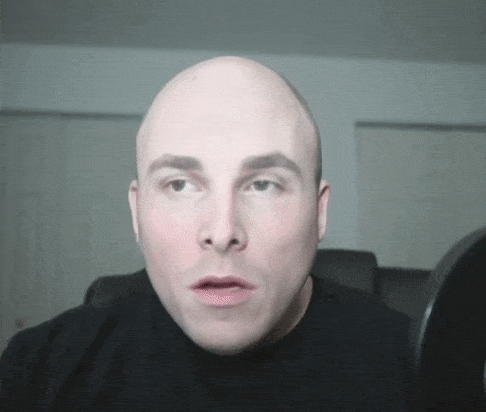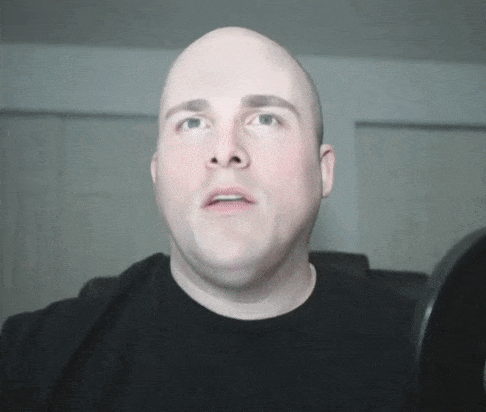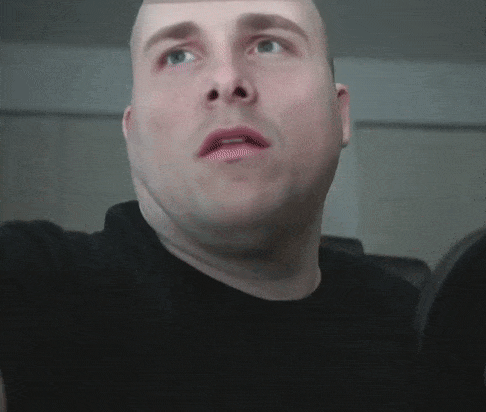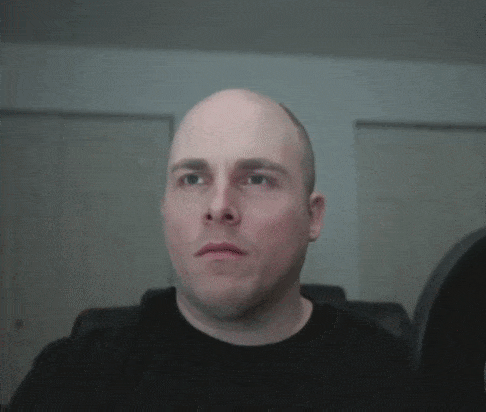
Ο χρήστης DeepFaceLive Druuzil Tech & Games δοκιμάζει το δικό του μοντέλο Christian Bale DeepFaceLab σε μια ζωντανή συνεδρία με τους οπαδούς του, ενώ οι πηγές φωτισμού αλλάζουν. Πηγή: https://www.youtube.com/watch?v=XPQLDnogLKA
Το σύστημα λειτουργεί τοποθετώντας ένα γραφικό στοιχείο στην οθόνη του χρήστη που αλλάζει μια στενή περιοχή του χρώματος του γρηγορότερα από ό,τι ένα τυπικό σύστημα deepfake μπορεί να ανταποκριθεί – ακόμη και αν, όπως η εφαρμογή ροής deepfake σε πραγματικό χρόνο DeepFaceLive (εικονίζεται παραπάνω), έχει κάποια ικανότητα διατήρησης ζωντανού χρωματικού μετασχηματισμού και συνυπολογισμού του περιβάλλοντος φωτισμού.
Η ομοιόμορφη εικόνα χρώματος που εμφανίζεται στην οθόνη του ατόμου στο άλλο άκρο (δηλαδή του πιθανότατα deepfake απατεώνα) κυκλοφορεί μέσα από μια περιορισμένη ποικιλία αλλαγών χρωμάτων που έχουν σχεδιαστεί για να μην ενεργοποιούν την αυτόματη λευκή ισορροπία της webcam και άλλα ειδικά προσαρμοσμένα συστήματα αντιστάθμισης φωτισμού, τα οποία θα υπονόμευαν τη μέθοδο.

Από το έγγραφο, μια εικονογράφηση της αλλαγής των συνθηκών φωτισμού από την οθόνη μπροστά σε ένα χρήστη, η οποία λειτουργεί αποτελεσματικά ως διάχυτη ‘επιφανειακή πηγή φωτός’. Πηγή: https://farid.berkeley.edu/downloads/publications/cvpr22a.pdf
Η θεωρία πίσω από την προσέγγιση είναι ότι τα ζωντανά συστήματα deepfake δεν μπορούν να ανταποκριθούν εγκαίρως στις αλλαγές που απεικονίζονται στην γραφική εικόνα στην οθόνη, αυξάνοντας την ‘καθυστέρηση’ του εφέ deepfake σε ορισμένα μέρη του φάσματος χρωμάτων, αποκαλύπτοντας την παρουσία του.
Για να μπορέσουν να μετρήσουν με ακρίβεια το αντανακλώμενο φωτισμό της οθόνης, το σύστημα πρέπει να λάβει υπόψη και να αποκλείσει την επίδραση του γενικού περιβαλλοντικού φωτισμού που δεν σχετίζεται με το φωτισμό της οθόνης. Τότε είναι σε θέση να διακρίνει ελλείψεις στη μέτρηση του ενεργού φωτισμού και του χρωματικού τόνου του προσώπου των χρηστών, αντιπροσωπεύοντας μια χρονική μετατόπιση 1-4 καρέ διαφορά μεταξύ κάθε:

Ορίζοντας τις αλλαγές χρωμάτων στην γραφική εικόνα ‘ανιχνευτή’ και διασφαλίζοντας ότι η webcam του χρήστη δεν προκαλείται να αυτο-ρυθμίσει τις ρυθμίσεις καταγραφής με υπερβολική αλλαγή φωτισμού οθόνης, οι ερευνητές μπόρεσαν να διακρίνουν μια χαρακτηριστική καθυστέρηση στο σύστημα deepfake προσαρμογής στις αλλαγές φωτισμού.
Το έγγραφο καταλήγει:
‘Λόγω της λογικής εμπιστοσύνης που τοποθετούμε στις ζωντανές βίντεο κλήσεις και της αυξανόμενης πανταχού παρούσας των βίντεο κλήσεων στις προσωπικές και επαγγελματικές μας ζωές, προτείνουμε ότι οι τεχνικές για την αυθεντικοποίηση βίντεο (και ήχου) κλήσεων θα αυξήσουν μόνο την σημασία τους.’
Η μελέτη έχει τον τίτλο Ανίχνευση βίντεο deepfake σε πραγματικό χρόνο χρησιμοποιώντας ενεργό φωτισμό και προέρχεται από την Candice R. Gerstner, ερευνήτρια εφαρμοσμένων μαθηματικών στο Υπουργείο Άμυνας των ΗΠΑ, και τον καθηγητή Hany Farid του Μπέρκλεϊ.
Διάβρωση της εμπιστοσύνης
Το πεδίο της έρευνας κατά των deepfakes έχει μετατοπιστεί σημαντικά τους τελευταίους έξι μήνες, μακριά από την γενική ανίχνευση deepfake (δηλαδή στόχευση σε προεγγεγραμμένα βίντεο και πορνογραφικό περιεχόμενο) και προς την ανίχνευση ‘ζωντανού’, ως απάντηση σε μια αυξανόμενο κύμα περιστατικών χρήσης deepfake σε βίντεο συνεδρίες και στην πρόσφατη προειδοποίηση του FBI σχετικά με την αυξανόμενη χρήση τέτοιων τεχνολογιών σε αιτήσεις για τηλεεργασία.
Ακόμη και όπου μια βίντεο κλήση δεν αποδεικνύεται ότι έχει deepfake, οι αυξημένες ευκαιρίες για AI-ωθούμενους βίντεο απατεώνες αρχίζουν να προκαλούν παράνοια.
Η νέα μελέτη αναφέρει:
‘Η δημιουργία πραγματικού χρόνου deep fakes [παρουσιάζει] μοναδικές απειλές λόγω του γενικού αισθήματος εμπιστοσύνης που περιβάλλει μια ζωντανή βίντεο ή τηλεφωνική κλήση, και της πρόκλησης της ανίχνευσης deep fakes σε πραγματικό χρόνο, καθώς μια κλήση αναπτύσσεται.’
Η ερευνητική κοινότητα έχει ήδη θέσει ως στόχο να βρει αμετάβλητες ενδείξεις περιεχομένου deepfake που δεν μπορούν να αντισταθμιστούν εύκολα. Αν και τα μέσα ενημέρωσης έχουν χαρακτηρίσει συνήθως αυτόν τον στόχο ως τεχνολογικό πόλεμο μεταξύ ερευνητών ασφαλείας και προγραμματιστές deepfake, οι περισσότερες ανατροπές των πρώτων προσεγγίσεων (όπως ανάλυση βλεφαρισμού, διακρίβωση στάσης κεφαλής και ανάλυση συμπεριφοράς) συνέβησαν απλώς επειδή οι προγραμματιστές και οι χρήστες προσπάθησαν να κάνουν πιο ρεαλιστικά deepfakes γενικά, και όχι συγκεκριμένα για να αντιμετωπίσουν την τελευταία ‘ενδειξη’ που αναγνωρίστηκε από την κοινότητα ασφαλείας.
Φωτισμός σε ζωντανό βίντεο deepfake
Η ανίχνευση deepfakes σε ζωντανά περιβάλλοντα βίντεο φέρει το βάρος του συνυπολογισμού κακών συνδέσεων βίντεο, οι οποίες είναι πολύ συχνές σε σενάρια τηλεδιάσκεψης. Ακόμη και χωρίς ένα μεσολαβικό στρώμα deepfake, το περιεχόμενο βίντεο μπορεί να υπόκειται σε lag τύπου NASA, artefacts απόδοσης και άλλους τύπους υποβάθμισης σε ήχο και βίντεο. Αυτά μπορούν να κρύψουν τις άκρες σε μια ζωντανή αρχιτεκτονική deepfaking, και σε βίντεο και ήχους deepfakes.
Οι συγγραφείς της νέας μεθόδου βελτιώνουν τα αποτελέσματα και τις μεθόδους που παρουσιάζονται σε μια δημοσίευση του 2020 από το Κέντρο για τον Υπολογισμό Δικτύων στο Temple University στη Φιλαδέλφεια.

Από το έγγραφο του 2020, μπορούμε να παρατηρήσουμε την αλλαγή του ‘γεμισμένου’ φωτισμού προσώπου καθώς το περιεχόμενο της οθόνης του χρήστη αλλάζει. Πηγή: https://cis.temple.edu/~jiewu/research/publications/Publication_files/FakeFace__ICDCS_2020.pdf
Η διαφορά στην νέα εργασία είναι ότι λαμβάνει υπόψη τον τρόπο με τον οποίο οι webcams ανταποκρίνονται στις αλλαγές φωτισμού. Οι συγγραφείς εξηγούν:
‘Επειδή όλες οι σύγχρονες webcams ρυθμίζουν αυτόματα την έκθεση, ο τύπος υψηλής έντασης ενεργού φωτισμού [που χρησιμοποιείται στην προηγούμενη εργασία] είναι πιθανό να προκαλέσει την αυτόματη έκθεση της κάμερας, η οποία με τη σειρά της θα υπονόμευε την καταγεγραμμένη εμφάνιση του προσώπου. Για να αποφευχθεί αυτό, χρησιμοποιούμε ενεργό φωτισμό που αποτελείται από μια ισοφωτική αλλαγή χρώματος.
‘Ενώ αυτό αποφεύγει την αυτόματη έκθεση της κάμερας, θα μπορούσε να προκαλέσει την λευκή ισορροπία της κάμερας, η οποία με τη σειρά της θα υπονόμευε την καταγεγραμμένη εμφάνιση του προσώπου. Για να αποφευχθεί αυτό, λειτουργούμε σε ένα χρωματικό εύρος που έχουμε εμπειρικά καθορίσει ότι δεν προκαλεί λευκή ισορροπία.’
Για αυτήν την πρωτοβουλία, οι συγγραφείς εξέτασαν επίσης παρόμοιες προηγούμενες προσπάθειες, όπως το LiveScreen, το οποίο επιβάλλει ένα μη εύκολο να ανιχνευθεί μοτίβο φωτισμού στην οθόνη του τελικού χρήστη σε μια προσπάθεια να αποκαλύψει περιεχόμενο deepfake.
Αν και αυτό το σύστημα πέτυχε ποσοστό ακρίβειας 94,8%, οι ερευνητές καταλήγουν στο συμπέρασμα ότι η λεπτότητα των μοτίβων φωτισμού θα έκανε μια τέτοια κρυφή προσέγγιση δύσκολο να εφαρμοστεί σε φωτισμένα περιβάλλοντα, και αντίθετα προτείνουν ότι το δικό τους σύστημα, ή ένα που μοιάζει με αυτό, θα μπορούσε να ενσωματωθεί φανερά και από προεπιλογή σε δημοφιλές λογισμικό τηλεδιάσκεψης:
‘Η προτεινόμενη μας παρέμβαση θα μπορούσε να πραγματοποιηθεί είτε από έναν συμμετέχοντα στην κλήση που απλώς μοιράζεται την οθόνη του και εμφανίζει το χρονικά μεταβαλλόμενο μοτίβο, είτε, ιδανικά, θα μπορούσε να ενσωματωθεί απευθείας στο λογισμικό τηλεδιάσκεψης.’
Δοκιμές
Οι συγγραφείς χρησιμοποίησαν έναν συνδυασμό συνθετικών και πραγματικών υποκειμένων για να δοκιμάσουν τον βασισμένο στο Dlib ανιχνευτή deepfake. Για το συνθετικό σενάριο, χρησιμοποίησαν Mitsuba, έναν μηχανισμό άμεσης και αντίστροφης απόδοσης εικόνας από την Ελβετική Ομοσπονδιακή Πολυτεχνική Σχολή της Λωζάννης.

Δείγματα από το συνθετικό σύνολο δεδομένων, με ποικίλες αποχρώσεις δέρματος, μεγέθη πηγής φωτός, ένταση περιβάλλοντος φωτισμού και απόσταση από την κάμερα.
Η σκηνή που απεικονίζεται περιλαμβάνει ένα παραμετρικό CGI κεφάλι που έχει καταγραφεί από μια εικονική κάμερα με 90° οπτικό πεδίο. Τα κεφάλια έχουν Lambertian ανακλαστικότητα και ουδέτερους τόνους δέρματος, και βρίσκονται 2 πόδια μπροστά από την εικονική κάμερα.
Για να δοκιμάσουν το πλαίσιο σε μια σειρά από πιθανές ρυθμίσεις, οι ερευνητές έτρεξαν μια σειρά δοκιμών, μεταβάλλοντας διαφορετικά στοιχεία διαδοχικά. Τα στοιχεία που άλλαξαν περιελάμβαναν απόχρωση δέρματος, απόσταση και μέγεθος πηγής φωτός.
Οι συγγραφείς σχολιάζουν:
‘Σε προσομοίωση, με τις διάφορες υποθέσεις μας ικανοποιημένες, η προτεινόμενη τεχνική μας είναι πολύ ανθεκτική σε μια ευρεία ποικιλία ρυθμίσεων εικόνας.’
Για το σενάριο του πραγματικού κόσμου, οι ερευνητές χρησιμοποίησαν 15 εθελοντές με ποικίλες αποχρώσεις δέρματος, σε διαφορετικά περιβάλλοντα. Κάθε ένας υποβλήθηκε σε δύο κύκλους της περιορισμένης αλλαγής χρώματος, υπό συνθήκες όπου μια ταχύτητα ανανέωσης οθόνης 30Hz συγχρονίστηκε με την κάμερα, που σημαίνει ότι ο ενεργός φωτισμός θα διαρκούσε μόνο για ένα δευτερόλεπτο κάθε φορά. Τα αποτελέσματα ήταν γενικά συγκρίσιμα με τις συνθετικές δοκιμές, αν και οι συσχετίσεις αυξήθηκαν σημαντικά με μεγαλύτερες τιμές φωτισμού.
Μελλοντικές κατευθύνσεις
Το σύστημα, οι ερευνητές παραδέχονται, δεν λαμβάνει υπόψη τις συνηθισμένες αποκρύψεις του προσώπου, όπως αφέλειες, γυαλιά ή γενειάδα. Ωστόσο, σημειώνουν ότι η μάσκα αυτού του είδους μπορεί να προστεθεί σε μεταγενέστερα συστήματα (μέσω ετικετών και επακόλουθης σημασιολογικής κατάτμησης), τα οποία θα μπορούσαν να εκπαιδευτούν για να λαμβάνουν τιμές αποκλειστικά από περιοχές δέρματος στο στόχο.
Οι συγγραφείς επίσης προτείνουν ότι ένα παρόμοιο πρότυπο θα μπορούσε να χρησιμοποιηθεί για την ανίχνευση ηχητικών κλήσεων deepfake, και ότι ο ήχος ανίχνευσης που απαιτείται θα μπορούσε να παιχθεί σε μια συχνότητα εκτός του φυσιολογικού ανθρώπινου ακουστικού εύρους.
Πιθανότατα το πιο ενδιαφέρον είναι ότι οι ερευνητές επίσης προτείνουν ότι η επέκταση της περιοχής αξιολόγησης πέρα από το πρόσωπο σε ένα πληρέστερο σύστημα λήψης εικόνας θα μπορούσε να βελτιώσει σημαντικά την πιθανότητα ανίχνευσης deepfake*:
‘Μια πιο σύνθετη 3-D εκτίμηση φωτισμού θα παρείχε πιθανότατα ένα πλουσιότερο μοντέλο εμφάνισης, το οποίο θα ήταν ακόμη πιο δύσκολο για έναν απατεώνα να παραβιάσει. Ενώ εστιάσαμε μόνο στο πρόσωπο, η οθόνη του υπολογιστή φωτίζει επίσης το λαιμό, τον άνω κορμό και το περιβάλλον υπόβαθρο, από τα οποία θα μπορούσαν να μετρηθούν παρόμοιες μετρήσεις.
‘Αυτές οι πρόσθετες μετρήσεις θα ανάγκαζαν τον απατεώνα να λάβει υπόψη ολόκληρη την 3-D σκηνή, όχι μόνο το πρόσωπο.’
* Η μετατροπή των εσωτερικών παραπομπών των συγγραφέων σε υπερσυνδέσμους.
Πρώτη δημοσίευση 6ης Ιουλίου 2022.


