
Τα καλύτερα
10 Καλύτερα Εργαλεία AI Web Scraping (Σεπτέμβριος 2026)

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Η Unite.AI μπορεί να λαμβάνει αμοιβή όταν χρησιμοποιείτε συνδέσμους προς προϊόντα που αξιολογούμε. Αυτό δεν επηρεάζει τις συντακτικές μας αξιολογήσεις. Διαβάστε τη γνωστοποίηση συνεργατών.
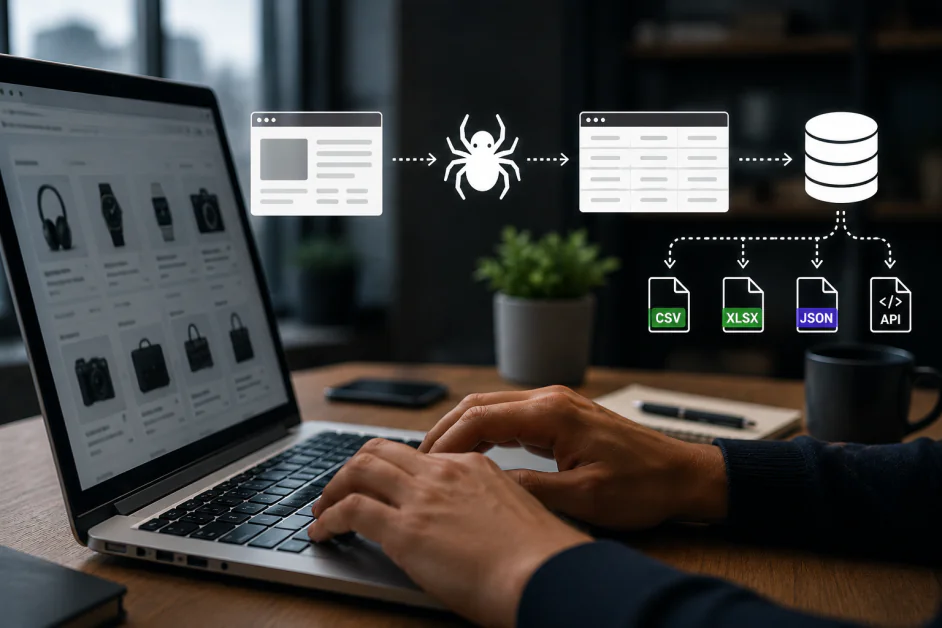
Τα εργαλεία AI web scraping δεν είναι πλέον μόνο αναλυτές σελίδων. Οι καλύτερες πλατφόρμες τώρα βοηθούν τις ομάδες να συλλέγουν δημόσια δεδομένα ιστού, να μετατρέπουν ακατάστατες σελίδες σε δομημένα σύνολα δεδομένων, να τροφοδοτούν συστήματα δημιουργίας με ενίσχυση ανάκτησης, να παρακολουθούν αγορές και να παρέχουν αξιόπιστο web context σε AI agents.
Αυτή η μεταβολή είναι σημαντική επειδή η εξαγωγή δεδομένων έχει γίνει πιο πολύτιμη και πιο δύσκολη. Οι σύγχρονες ιστοσελίδες είναι δυναμικές, προσωποποιημένες, βαριά προγραμματισμένες και συχνά προστατευμένες από συστήματα κατά της κατάχρησης. Ένα χρήσιμο εργαλείο εξαγωγής πρέπει να κάνει περισσότερα από το απλό λήψη HTML. Πρέπει να διαχειρίζεται την απόδοση, τη λογική εξαγωγής, τον προγραμματισμό, την ποιότητα δεδομένων, τη συμμόρφωση και τη μεταβίβαση στα συστήματα όπου τα δεδομένα χρησιμοποιούνται πραγματικά.
Η σωστή επιλογή εξαρτάται από την εργασία. Ορισμένες ομάδες χρειάζονται υποδομή επιχειρηματικού επιπέδου για μεγάλα προγράμματα δημόσιων δεδομένων. Άλλες χρειάζονται Markdown έτοιμο για LLM, ρομπότ χωρίς κώδικα για επαναλαμβανόμενη έρευνα, πλατφόρμα προγραμματιστών για αυτοματισμό προγράμματος περιήγησης ή εξειδικευμένο API αποτελεσμάτων αναζήτησης. Τα εργαλεία παρακάτω καλύπτουν αυτές τις διαφορετικές προσεγγίσεις.
Η ομάδα μας αξιολόγησε ανεξάρτητα κάθε λύση σε αυτόν τον οδηγό, αξιολογώντας τις δυνατότητες, τα πρακτικά πλεονεκτήματα, τους περιορισμούς και την καταλληλότητα για τις περιπτώσεις χρήσης που αντικατοπτρίζονται στις κατατάξεις μας.
Καλύτερα Εργαλεία AI Web Scraping – Σύγκριση
| Εργαλείο AI | Καλύτερο για | Κύριες Δυνάμεις |
|---|---|---|
| Bright Data | Εταιρική εξαγωγή δεδομένων ιστού, υποδομή proxy και pipelines δεδομένων AI | Scraper APIs, Browser API, Scraper Studio, Web Unlocker, υποδομή proxy, σύνολα δεδομένων, RAG workflows |
| Firecrawl | Μετατροπή ιστοσελίδων σε καθαρό περιεχόμενο έτοιμο για LLM για εφαρμογές AI | Scrape, crawl, search, map, monitor, Markdown, δομημένο JSON, αλληλεπίδραση προγράμματος περιήγησης, API, MCP, ανοιχτού κώδικα |
| Apify | Προγραμματιστές που δημιουργούν επεκτάσιμα scrapers, αυτοματισμούς προγράμματος περιήγησης και data agents | Actor marketplace, Crawlee, Playwright, Puppeteer, Selenium, προγραμματισμός, proxies, σύνολα δεδομένων, APIs, ενσωματώσεις MCP |
| Browse AI | Web scraping χωρίς κώδικα, παρακολούθηση ιστοσελίδων και επαναλαμβανόμενη συλλογή επιχειρηματικών δεδομένων | AI ρομπότ, εκπαίδευση point-and-click, παρακολούθηση ιστοσελίδων, προγραμματισμένη εξαγωγή, προ-χτισμένα ρομπότ, ενσωματώσεις |
| SearchAPI | Δεδομένα SERP και μηχανών αναζήτησης σε πραγματικό χρόνο για AI, SEO και ερευνητικές ροές εργασίας | Google, Google Maps, Bing, YouTube, δεδομένα αγορών και ειδήσεων, δομημένο JSON, γεω-στόχευση, περιστροφή proxy, επαναπροσπάθειες, MCP |
| ScrapingBee | API scraping φιλικό προς προγραμματιστές με εξαγωγή AI και απόδοση JavaScript | Εξαγωγή φυσικής γλώσσας, δομημένο JSON, Markdown, σενάρια JavaScript, περιστροφή proxy, στιγμιότυπα οθόνης, ειδικά APIs, CLI, MCP |
| Octoparse | Οπτικό scraping χωρίς κώδικα δυναμικών ιστοσελίδων και επαναλαμβανόμενων εργασιών cloud | Οπτικό εργαλείο δημιουργίας ροής εργασίας, αυτόματη ανίχνευση AI, εξαγωγή cloud, πρότυπα, περιστροφή IP, προγραμματισμός, εξαγωγές, APIs |
| Oxylabs | Εταιρικά APIs scraping, AI grounding και δύσκολες δημόσιες ιστοσελίδες | Web Scraper API, AI Studio, Headless Browser, Web Unblocker, Fast Search API, δομημένα δεδομένα, γεω-στόχευση |
| Diffbot | Αυτόματη ταξινόμηση σελίδων, εξαγωγή οντοτήτων και πρόσβαση στο Knowledge Graph | Extract API, Crawl API, Knowledge Graph, εμπλουτισμός οντοτήτων, επεξεργασία φυσικής γλώσσας, υπολογιστική όραση, δομημένα σύνολα δεδομένων |
| ScrapeGraphAI | Εξαγωγή φυσικής γλώσσας με δομημένο JSON και ενσωματώσεις πλαισίων AI | Εξαγωγή βάσει prompt, σχήματα JSON, crawling, παρακολούθηση, απόδοση JavaScript, SDKs, CLI, MCP, ενσωματώσεις LangChain και CrewAI |
Πώς να Επιλέξετε ένα Εργαλείο AI Web Scraping
Ξεκινήστε με τον τύπο του προβλήματος δεδομένων ιστού που έχετε. Αν ο στόχος είναι η τροφοδοσία ενός προϊόντος AI με καθαρό web context, δώστε προτεραιότητα σε Markdown, δομημένο JSON, ελέγχους crawling και έξοδο φιλική για retrieval. Αν ο στόχος είναι επαναλαμβανόμενη επιχειρηματική έρευνα, ένα ρομπότ χωρίς κώδικα ή οπτικό εργαλείο ροής εργασίας μπορεί να είναι ταχύτερο. Αν ο στόχος είναι μαζική συλλογή δημόσιων δεδομένων, ψάξτε για βάθος υποδομής: rendering, queues, έλεγχο proxy, unlocking, παρακολούθηση και αξιόπιστη παράδοση.
Η δεύτερη ερώτηση είναι ποιος θα συντηρεί τη ροή εργασίας. Μια ομάδα μάρκετινγκ που παρακολουθεί σελίδες ανταγωνιστών χρειάζεται πολύ διαφορετικό προϊόν από μια ομάδα μηχανικών που χτίζει pipeline δεδομένων. Τα καλά συστήματα scraping κάνουν την εξαγωγή επαναλαμβανόμενη, αλλά δεν αφαιρούν την ανάγκη για επικύρωση. Οι ιστοσελίδες αλλάζουν, τα πεδία παραμορφώνονται, και η εξαγωγή με AI μπορεί να φαίνεται σίγουρη ακόμη και όταν η σελίδα είναι ασαφής. Η καλύτερη ρύθμιση είναι αυτή που ταιριάζει στις τεχνικές δεξιότητες της ομάδας, στη διαδικασία ελέγχου και στις υποχρεώσεις συμμόρφωσης.
10 Καλύτερα Εργαλεία AI Web Scraping
1. Bright Data
Το Bright Data είναι η πιο ισχυρή επιλογή όταν η συλλογή δεδομένων ιστού αποτελεί βασικό επιχειρηματικό σύστημα και όχι παράπλευρο έργο. Συνδυάζει scraper APIs, υποδομή προγράμματος περιήγησης, διαχείριση proxy, τεχνολογία unlocking και προ-δημιουργημένα σύνολα δεδομένων, ώστε οι ομάδες να συλλέγουν δημόσια δεδομένα ιστού σε σοβαρή κλίμακα χωρίς να ενώνουν κάθε στρώση μόνοι τους.
Η πλατφόρμα είναι ιδιαίτερα χρήσιμη για εταιρείες που χτίζουν market intelligence, παρακολούθηση ecommerce, έρευνα αναζήτησης, σύνολα δεδομένων εκπαίδευσης AI, pipelines RAG ή ανταγωνιστικά προϊόντα δεδομένων. Το Bright Data δίνει στις τεχνικές ομάδες αρκετό έλεγχο για να χτίσουν σύνθετες ροές εργασίας, ενώ προσφέρει και διαχειριζόμενες διαδρομές για ομάδες που θέλουν δομημένα δεδομένα χωρίς να διατηρούν ευαίσθητη υποδομή scraping.
Αυτή η ευρύτητα αποτελεί επίσης το κριτήριο αγοράς. Το Bright Data έχει νόημα όταν ένας οργανισμός μπορεί να αναθέσει ιδιοκτησία σε engineering ή data‑operations, να ορίσει εγκεκριμένους στόχους και να παρακολουθεί την ποιότητα και το κόστος με την πάροδο του χρόνου. Μικρότερες ομάδες με λίστα εύκολων ιστοτόπων μπορεί να εξυπηρετηθούν καλύτερα από ελαφρύτερο API ή υπηρεσία χωρίς κώδικα, ενώ τα ρυθμιζόμενα προγράμματα πρέπει να ευθυγραμμίζουν τις πολιτικές συλλογής με νομική και ιδιωτική ανασκόπηση.
Πλεονεκτήματα και Μειονεκτήματα
- Η πιο ευρεία κάλυψη υποδομής σε αυτή τη λίστα
- Ισχυρή προσαρμογή για ιστοσελίδες υψηλού όγκου και δύσκολες δημόσιες ιστοσελίδες
- Προ‑δημιουργημένα scrapers και σύνολα δεδομένων μειώνουν το χρόνο ανάπτυξης
- Χρήσιμο για pipelines δεδομένων AI, έρευνα αναζήτησης και παρακολούθηση ecommerce
- Περισσότερη υποδομή από ό,τι χρειάζονται μικρά περιστασιακά έργα
- Οι ομάδες εξακολουθούν να χρειάζονται σαφή διακυβέρνηση δεδομένων και κανόνες στόχων ιστοτόπων
- Προηγμένες περιπτώσεις χρήσης απαιτούν τεχνική ρύθμιση και παρακολούθηση
2. Firecrawl
Το Firecrawl έχει σχεδιαστεί για την εποχή AI του web scraping. Αντί να αναγκάζει τους προγραμματιστές να καθαρίζουν ακατέργαστο HTML, να διαχειρίζονται rendering σελίδας και να κανονικοποιούν ακατάστατο περιεχόμενο με το χέρι, μετατρέπει τις ιστοσελίδες σε καθαρό Markdown ή δομημένα δεδομένα που μπορούν να τροφοδοτήσουν agents, συστήματα retrieval, εργαλεία έρευνας και ροές εργασίας προϊόντων.
Η απήχηση είναι η απλότητα στο επίπεδο εφαρμογής. Οι προγραμματιστές μπορούν να εξάγουν μια σελίδα, να crawλάρουν έναν ιστότοπο, να αναζητούν στον ιστό, να χαρτογραφούν URLs, να παρακολουθούν αλλαγές ή να ζητούν δομημένη έξοδο με πολύ λιγότερο plumbing από ένα παραδοσιακό stack scraper. Το Firecrawl ταιριάζει ιδιαίτερα όταν το τελικό προϊόν είναι AI assistant, knowledge base, ερευνητική ροή ή σύστημα RAG.
Οι ομάδες πρέπει να αντιμετωπίζουν το Firecrawl ως στρώση απόκτησης περιεχομένου παρά ως ολόκληρη πλατφόρμα δεδομένων. Η παραγωγική χρήση απαιτεί ακόμη καθορισμό πηγών, απο-διπλοεγγραφή, κανόνες φρεσκάδας, επικύρωση σχήματος και παρακολούθηση όταν οι ιστότοποι αλλάζουν. Η αξία του είναι υψηλότερη όταν οι προγραμματιστές θέλουν ένα συνοπτικό API και δυνατότητα self‑hosting, αλλά δεν χρειάζονται τον ευρύ έλεγχο proxy ή τα διαχειριζόμενα σύνολα δεδομένων που προσφέρουν οι προμηθευτές υποδομής επιχειρήσεων.
Πλεονεκτήματα και Μειονεκτήματα
- Άριστη προσαρμογή για AI εφαρμογές που χρειάζονται καθαρό web context
- Το Markdown και η δομημένη έξοδο μειώνουν τον downstream καθαρισμό
- Χρήσιμο API για scrape, crawl, search, map και monitor ροές εργασίας
- Η επιλογή ανοιχτού κώδικα δίνει στις τεχνικές ομάδες περισσότερη ευελιξία ανάπτυξης
- Δεν είναι πλήρες proxy ή πλατφόρμα υποδομής δεδομένων επιχειρήσεων
- Η σύνθετη εξαγωγή εξακολουθεί να ωφελείται από σχεδίαση σχήματος και επικύρωση
- Οι ομάδες με αυστηρές απαιτήσεις συμμόρφωσης πρέπει να ελέγξουν προσεκτικά τις επιλογές deployment και retention
3. Apify
Το Apify είναι μια ισχυρή επιλογή για ομάδες που θέλουν τόσο μια πλατφόρμα προγραμματιστών όσο και μια μεγάλη αγορά έτοιμων εργαλείων αυτοματισμού ιστού. Το μοντέλο Actor του επιτρέπει τη συσκευασία scrapers, αυτοματισμών προγράμματος περιήγησης και ροών δεδομένων ως επαναχρησιμοποιήσιμες cloud εργασίες που μπορούν να προγραμματιστούν, να κληθούν μέσω API, να συνδεθούν με αποθηκευτικό χώρο και να μοιραστούν σε όλη την ομάδα.
Οι προγραμματιστές λαμβάνουν μια πρακτική διαδρομή από πρωτότυπο σε παραγωγή. Μπορούν να χτίσουν με Crawlee, Playwright, Puppeteer, Selenium ή υπάρχοντες Actors, έπειτα να χρησιμοποιήσουν το Apify για εκτέλεση, queues, proxies, datasets, webhooks και ενσωματώσεις. Αυτό το καθιστά ιδιαίτερα χρήσιμο για ομάδες που χρειάζονται επαναλαμβανόμενες εργασίες δεδομένων αντί για μονόπλευρη εξαγωγή σελίδας.
Η ευελιξία του Apify είναι δύναμη και ευθύνη. Οι ομάδες πρέπει να επιλέγουν αξιόπιστους Actors, να ελέγχουν εκδόσεις, να παρακολουθούν εκτελέσεις και να προϋπολογίζουν υπολογιστική ισχύ, proxy και αποθηκευτικό χώρο καθώς αυξάνονται τα φορτία. Είναι ιδανικό για προγραμματιστές που θέλουν επαναχρησιμοποιήσιμα δομικά στοιχεία και cloud operations σε ένα μέρος· οι περιστασιακοί χρήστες μπορεί να βρουν ένα εργαλείο scraper πιο γρήγορο στην εκμάθηση.
Πλεονεκτήματα και Μειονεκτήματα
- Μεγάλη αγορά έτοιμων Actors για κοινά στόχους
- Ισχυρά εργαλεία προγραμματιστών για προσαρμοσμένο scraping και αυτοματισμό προγράμματος περιήγησης
- Καλή προσαρμογή για προγραμματισμένες, επαναλαμβανόμενες ροές συλλογής δεδομένων
- Η υποστήριξη Crawlee δίνει στις τεχνικές ομάδες μια ευέλικτη βάση ανοιχτού κώδικα
- Η ποιότητα στην αγορά διαφέρει ανά Actor και περίπτωση χρήσης
- Οι προσαρμοσμένες εργασίες απαιτούν συντήρηση όταν οι ιστοσελίδες αλλάζουν
- Οι μη‑τεχνικοί χρήστες μπορεί να προτιμήσουν ένα πιο απλό οπτικό scraper
4. Browse AI
Το Browse AI είναι ιδανικό για επιχειρηματικές ομάδες που χρειάζονται δεδομένα ιστού αλλά δεν θέλουν να χτίσουν scrapers. Οι χρήστες εκπαιδεύουν ένα ρομπότ δείχνοντάς του τι να συλλέξει, έπειτα τρέχουν το ρομπότ κατ’ απαίτηση ή προγραμματισμένα. Αυτό το κάνει χρήσιμο για παρακολούθηση ανταγωνιστών, παρακολούθηση καταχωρήσεων, συλλογή leads, παρακολούθηση αποθεμάτων ή μετατροπή επαναλαμβανόμενης έρευνας σε επαναλαμβανόμενη ροή εργασίας.
Η δύναμή του είναι η προσβασιμότητα. Το Browse AI δίνει σε λειτουργίες, μάρκετινγκ, προσλήψεις, ecommerce και ερευνητικές ομάδες έναν πρακτικό τρόπο συλλογής δομημένων δεδομένων από ιστοσελίδες χωρίς να ζητάει από το engineering να συντηρεί κάθε selector. Δεν προσπαθεί να είναι η πιο βαθειά πλατφόρμα προγραμματιστών· προσπαθεί να κάνει τη συλλογή δεδομένων επαναλαμβανόμενη προσιτή.
Το Browse AI λειτουργεί καλύτερα όταν η στόχευση της ροής εργασίας μπορεί να επιδειχθεί σαφώς και να ελεγχθεί από άνθρωπο. Οι χρήστες πρέπει να δοκιμάσουν σελιδοποίηση, βήματα σύνδεσης, κενές καταστάσεις και αλλαγές layout πριν εξαρτηθούν από αυτοματισμό για αποφάσεις. Είναι μια ισχυρή επιλογή για τμηματικά έργα, αλλά τα προγράμματα που οδηγούνται από engineering μπορεί να χρειάζονται πιο λεπτομερή έλεγχο επαναπροσπάθειας, συμβάσεων δεδομένων και deployment.
Πλεονεκτήματα και Μειονεκτήματα
- Ισχυρή εμπειρία χωρίς κώδικα για επιχειρηματικούς χρήστες
- Καλή προσαρμογή για επαναλαμβανόμενη παρακολούθηση και ροές εργασίας τύπου spreadsheet
- Η εκπαίδευση ρομπότ point‑and‑click είναι πιο εύκολη από την εγκατάσταση βάσει selectors
- Χρήσιμο για ομάδες που χρειάζονται web data χωρίς υποστήριξη engineering
- Λιγότερο ευέλικτο από πλατφόρμες προσανατολισμένες σε προγραμματιστές για σύνθετη λογική
- Τα ρομπότ μπορεί να χρειαστούν προσαρμογή όταν οι στόχοι σελίδες αλλάζουν σημαντικά
- Μεγάλα ή πολύ προσαρμοσμένα προγράμματα μπορεί να ξεπεράσουν την προσέγγιση χωρίς κώδικα
5. SearchAPI
Το SearchAPI είναι μια εξειδικευμένη υπηρεσία scraping για ομάδες που χρειάζονται τρέχοντα αποτελέσματα μηχανών αναζήτησης ως δομημένα δεδομένα αντί για ακατέργαστες σελίδες αποτελεσμάτων. Ένα ενιαίο API μπορεί να επιστρέψει οργανικές συνδέσεις, διαφημίσεις, ειδήσεις, καταχωρήσεις χάρτη, αποτελέσματα αγορών, knowledge panels, ερωτήσεις People Also Ask, AI‑γενόμενα χαρακτηριστικά αναζήτησης και άλλους τύπους αποτελεσμάτων σε JSON, ανάλογα με την επιλεγμένη μηχανή.
Η πλατφόρμα είναι ιδιαίτερα χρήσιμη για παρακολούθηση SEO, ανάλυση τοπικής αναζήτησης, έρευνα αγοράς, intelligence προϊόντων και AI agents που χρειάζονται πραγματικό χρόνο search context. Το SearchAPI διαχειρίζεται rendering προγράμματος περιήγησης, περιστροφή proxy, επαναπροσπάθειες και διαχείριση CAPTCHA πίσω από το αίτημα, ενώ οι παράμετροι τοπικοποίησης υποστηρίζουν χώρα, γλώσσα, τοποθεσία και ερωτήματα ειδικά για συσκευές. Οι τεκμηριωμένες μηχανές του εκτείνονται πέρα από τα τυπικά αποτελέσματα Google σε πηγές όπως Google Maps, Bing, YouTube, ειδήσεις και εμπειρίες αναζήτησης εμπορίου.
Το SearchAPI προσφέρει επίσης έναν MCP server για σύνδεση υποστηριζόμενων AI assistants και περιβαλλόντων ανάπτυξης με τα εργαλεία αναζήτησής του. Η ανταλλαγή είναι εξειδικευμένη: αυτό είναι ένα ισχυρό επίπεδο δεδομένων αναζήτησης, όχι ένας γενικός crawler για εξαγωγή αυθαίρετων πεδίων από οποιονδήποτε ιστότοπο. Οι αγοραστές πρέπει επίσης να μοντελοποιούν προσεκτικά τη χρήση, επειδή τα πλάνα είναι βασισμένα σε credits, η απόδοση διαφέρει ανά επίπεδο, και τα πλουσιότερα surfaces αναζήτησης απαιτούν ακόμη ελέγχους σχήματος όταν τα layout upstream αλλάζουν.
Πλεονεκτήματα και Μειονεκτήματα
- Επιστρέφει δομημένα δεδομένα SERP σε πραγματικό χρόνο χωρίς να απαιτεί συντήρηση scrapers ή υποδομής proxy
- Υποστηρίζει κύριες μηχανές αναζήτησης, χάρτες, βίντεο, ειδήσεις, αγορές και άλλες εξειδικευμένες μηχανές αποτελεσμάτων
- Έλεγχοι τοποθεσίας, γλώσσας, χώρας και συσκευής εξυπηρετούν παρακολούθηση θέσεων και έρευνα αγοράς
- Η πρόσβαση μέσω API και MCP καθιστά τα δεδομένα αναζήτησης πρακτικά για εφαρμογές και AI agents
- Επικεντρώνεται σε δεδομένα αποτελεσμάτων μηχανών αναζήτησης αντί για αυθαίρετο crawling ιστοτόπων
- Τα πλάνα βασισμένα σε credits και τα όρια απόδοσης απαιτούν πρόβλεψη για υψηλού όγκου φορτία
- Οι εφαρμογές πρέπει να επικυρώνουν πεδία καθώς οι μηχανές αναζήτησης αλλάζουν τα layout των αποτελεσμάτων
6. ScrapingBee
Το ScrapingBee είναι ένα API φιλικό προς προγραμματιστές για ομάδες που θέλουν να συλλέγουν και να δομούν δεδομένα ιστού χωρίς να διαχειρίζονται headless browsers ή υποδομή proxy. Συνδυάζει rendering JavaScript, περιστροφή proxy, στιγμιότυπα οθόνης, εξαγωγή CSS/XPath και ένα AI extraction layer που μετατρέπει αιτήματα φυσικής γλώσσας και κανόνες πεδίου σε δομημένο JSON.
Η πλατφόρμα είναι ιδιαίτερα χρήσιμη όταν οι προγραμματιστές θέλουν ένα ενιαίο endpoint για απλές σελίδες και διαδραστικούς ιστότοπους. Σενάρια JavaScript μπορούν να κάνουν κλικ, κύλιση, πληκτρολόγηση ή αναμονή πριν την εξαγωγή, ενώ η έξοδος σε Markdown, τα ειδικά APIs, το CLI και οι ενσωματώσεις MCP βοηθούν το scraped περιεχόμενο να μεταφερθεί σε analytics, αυτοματισμούς και AI ροές εργασίας. Το ScrapingBee είναι πιο απλό στην υιοθέτηση από ένα πλήρες stack scraping, αν και η κατανάλωση credits μπορεί να ποικίλει με premium proxies, rendering και AI χαρακτηριστικά.
Το ScrapingBee ταιριάζει καλύτερα όταν οι μηχανικοί θέλουν μια διαχειριζόμενη στρώση αιτήσεων ενώ διατηρούν την ορχήστρωση και την ποιότητα δεδομένων στην δική τους εφαρμογή. Οι ομάδες πρέπει να ορίσουν κανόνες επαναπροσπάθειας, σχήματα, όρια crawling και επικύρωση για εργασίες πολλαπλών σελίδων αντί να θεωρούν κάθε επιτυχημένη HTTP απάντηση ως αξιόπιστα δεδομένα. Ένας οπτικός desktop scraper θα είναι πιο εύκολος για μη‑τεχνικούς χρήστες, αλλά οι API ομάδες κερδίζουν άμεσο έλεγχο ενσωμάτωσης και deployment.
Πλεονεκτήματα και Μειονεκτήματα
- Η εξαγωγή AI φυσικής γλώσσας μπορεί να επιστρέψει δομημένο JSON χωρίς χειροκίνητους selectors
- Το rendering JavaScript και οι σεναριακές ενέργειες χειρίζονται πολλές δυναμικές ροές σελίδων
- Η περιστροφή proxy, τα στιγμιότυπα οθόνης, η έξοδος Markdown και τα ειδικά APIs διατίθενται μέσω μιας υπηρεσίας
- Το CLI, MCP και οι ενσωματώσεις αυτοματισμού ταιριάζουν σε ροές εργασίας προγραμματιστών και agents
- Η χρήση credits αυξάνεται όταν τα αιτήματα προσθέτουν AI extraction, premium proxies ή rendering JavaScript
- Είναι προϊόν με προτεραιότητα στο API, όχι οπτικό desktop scraper
- Σύνθετα multi‑page crawls απαιτούν ακόμη ορχήστρωση και ελέγχους ποιότητας
7. Octoparse
Το Octoparse είναι ένα ώριμο εργαλείο scraping χωρίς κώδικα για χρήστες που προτιμούν οπτική ροή εργασίας αντί για προγραμματιστικό πλαίσιο. Μπορεί να εντοπίσει δεδομένα σελίδας, να καθοδηγήσει τους χρήστες στα βήματα εξαγωγής και να τρέξει εργασίες scraping στο cloud, καθιστώντας το χρήσιμο για επαναλαμβανόμενη συλλογή από e‑commerce sites, directories, listings, σελίδες αναζήτησης και άλλες δομημένες πηγές ιστού.
Η πλατφόρμα είναι πιο ισχυρή όταν μια ομάδα χρειάζεται περισσότερο έλεγχο ροής εργασίας από ένα γρήγορο browser‑extension scraper, αλλά θέλει να αποφύγει το γράψιμο κώδικα. Πρότυπα, προγραμματισμός, cloud extraction, αυτόματες εξαγωγές και υποστήριξη δυναμικών σελίδων κάνουν το Octoparse ένα πρακτικό μεσολαβητή μεταξύ απλών no‑code εργαλείων και πλατφορμών scraping με ηγεσία engineering.
Το οπτικό μοντέλο του απαιτεί προσεκτικό σχεδιασμό ροής εργασίας. Οι ομάδες πρέπει να δοκιμάσουν σελιδοποίηση, απεριόριστο scroll, καταστάσεις σύνδεσης, διπλότυπα αρχεία και κλάδους σφαλμάτων πριν εξαρτηθούν από προγραμματισμένες εργασίες. Το Octoparse ταιριάζει καλά σε αναλυτές και χρήστες λειτουργιών που μπορούν να διαχειριστούν αυτούς τους ελέγχους, ενώ οι προγραμματιστές που χτίζουν στενά versioned pipelines μπορεί να προτιμήσουν API ή code‑first framework με πιο ισχυρό source control και αυτοματοποιημένες δοκιμές.
Πλεονεκτήματα και Μειονεκτήματα
- Οπτικό εργαλείο δημιουργίας ροής εργασίας δίνει στους χρήστες περισσότερο έλεγχο από τα απλά one‑click εργαλεία
- Η εξαγωγή cloud βοηθά επαναλαμβανόμενες εργασίες να τρέχουν χωρίς τοπικό μηχάνημα
- Τα πρότυπα μειώνουν το χρόνο ρύθμισης για κοινές ιστοσελίδες και τύπους δεδομένων
- Καλή προσαρμογή για ομάδες λειτουργιών που χρειάζονται επαναλαμβανόμενα δομημένα σύνολα δεδομένων
- Ο σχεδιασμός ροής εργασίας μπορεί να πάρει χρόνο σε πολύπλοκες ιστοσελίδες
- Λιγότερο φυσικό για ομάδες προγραμματιστών που προτιμούν pipelines code‑first
- Απαιτείται συνεχής παρακολούθηση όταν οι στόχοι ιστοτόπων αλλάζουν
8. Oxylabs
Το Oxylabs είναι μια ισχυρή επιλογή για ομάδες που χρειάζονται αξιόπιστη πρόσβαση σε δημόσια δεδομένα ιστού σε κλίμακα και δεν θέλουν να διαχειρίζονται περιστροφή proxy, rendering και στρώματα anti‑blocking μόνοι τους. Το Web Scraper API του έχει σχεδιαστεί για τη συλλογή δομημένων δημόσιων δεδομένων από ευρύ φάσμα στόχων, διαχειριζόμενο μεγάλο μέρος της υποδομής scraping στο παρασκήνιο.
Η εταιρεία έχει επίσης ενισχύσει τις AI data workflows με AI Studio, Fast Search API, αυτοματισμό προγράμματος περιήγησης και περιπτώσεις χρήσης προσανατολισμένες στο grounding. Αυτό το καθιστά σχετικό για οργανισμούς που χτίζουν συστήματα market intelligence, παρακολούθηση αναζητήσεων, pipelines grounding μοντέλων, σύνολα δεδομένων ecommerce και ροές εργασίας agents που χρειάζονται φρέσκο web context.
Το Oxylabs είναι πιο ελκυστικό όταν η αξιοπιστία, η δυσκολία στόχου ή η γεωγραφική εμβέλεια δικαιολογούν μια υπηρεσία επιχειρηματικού επιπέδου. Οι αγοραστές πρέπει να χαρτογραφήσουν στόχους, απαιτήσεις εξόδου, χρόνους απόκρισης και ιδιοκτησία συμμόρφωσης πριν επιλέξουν μια διαμόρφωση προϊόντος. Μικρότερα έργα μπορεί να μην χρησιμοποιούν όλο το βάθος υποδομής της πλατφόρμας, ενώ μεγάλα προγράμματα εξακολουθούν να χρειάζονται ανεξάρτητη παρακολούθηση ποιότητας επειδή η επιτυχής συλλογή δεν εγγυάται ακριβή κανονικοποίηση.
Πλεονεκτήματα και Μειονεκτήματα
- Ισχυρή υποδομή scraping επιπέδου επιχειρήσεων
- Χρήσιμο για pipelines δημόσιων δεδομένων που χρειάζονται κλίμακα και αξιοπιστία
- Το AI Studio και το Fast Search API υποστηρίζουν ροές εργασίας agents και grounding
- Καλή προσαρμογή για δύσκολες δυναμικές ιστοσελίδες και γεω‑στόχευση
- Κατάλληλο κυρίως για ομάδες με ορισμένες τεχνικές και απαιτήσεις συμμόρφωσης
- Μπορεί να είναι περισσότερο υποδομή από ό,τι απαιτούν μικρά no‑code έργα
- Οι προηγμένες ροές εργασίας απαιτούν προσεκτική επιλογή στόχων και επικύρωση
9. Diffbot
Το Diffbot διαφέρει από τα περισσότερα εργαλεία web scraping επειδή εστιάζει στην κατανόηση σελίδων και οντοτήτων, όχι μόνο στη συλλογή πεδίων. Η τεχνολογία εξαγωγής του ταξινομεί σελίδες, αναγνωρίζει δομημένες οντότητες και συνδέει τα web data με ένα ευρύτερο Knowledge Graph, κάτι που είναι χρήσιμο όταν ο στόχος είναι εμπλουτισμένες, κανονικοποιημένες πληροφορίες αντί για ακατέργαστες γραμμές scraped.
Αυτό καθιστά το Diffbot ιδιαίτερα σχετικό για ομάδες που εργάζονται σε entity intelligence, δεδομένα εταιρειών και ατόμων, έρευνα αγοράς, knowledge graphs, παρακολούθηση μέσων και AI συστήματα που χρειάζονται δομημένα γεγονότα από το ανοιχτό web. Δεν είναι ένας γρήγορος point‑and‑click scraper, αλλά ένα web‑scale extraction και knowledge layer.
Η κύρια ερώτηση αγοράς είναι αν το μοντέλο δεδομένων του Diffbot ταιριάζει με τις οντότητες και τις σχέσεις που απαιτεί το έργο. Όταν ταιριάζει, οι ομάδες μπορούν να αποφύγουν την κατασκευή page‑specific parsers και pipelines εμπλουτισμού από το μηδέν. Όταν δεν ταιριάζει, ένας συμβατικός scraper μπορεί να προσφέρει πιο άμεσο έλεγχο. Η αξιολόγηση πρέπει να περιλαμβάνει αντιπροσωπευτικές σελίδες, κάλυψη πεδίων, συχνότητα ενημέρωσης, επίλυση οντοτήτων και πώς θα διατηρηθεί η προέλευση downstream.
Πλεονεκτήματα και Μειονεκτήματα
- Ισχυρή αυτόματη εξαγωγή και κατανόηση οντοτήτων
- Η πρόσβαση στο Knowledge Graph προσθέτει context πέρα από μια μόνο σελίδα
- Χρήσιμο για εμπλουτισμό, έρευνα και δομημένα workflows intelligence
- Καλή προσαρμογή όταν οι κανονικοποιημένες οντότητες έχουν μεγαλύτερη σημασία από ακατέργαστους πίνακες σελίδας
- Λιγότερο διαισθητικό για απλό scraping τύπου spreadsheet
- Τα καλύτερα αποτελέσματα εξαρτώνται από το αν τα μοντέλα Diffbot ταιριάζουν στον τύπο περιεχομένου στόχου
- Οι ομάδες πρέπει να κατανοήσουν το Knowledge Graph και το μοντέλο API για να αξιοποιήσουν πλήρως την αξία
10. ScrapeGraphAI
Το ScrapeGraphAI έχει σχεδιαστεί για χρήστες που θέλουν να περιγράψουν τα δεδομένα που χρειάζονται με απλή γλώσσα και να λαμβάνουν δομημένη έξοδο. Αντί να γράφουν selectors για κάθε πεδίο, οι ομάδες μπορούν να δώσουν ένα URL, να ορίσουν τις επιθυμητές πληροφορίες και να χρησιμοποιήσουν AI‑assisted extraction για να επιστρέψουν καθαρό JSON για εφαρμογές, ερευνητικές ροές εργασίας ή agents.
Είναι κατάλληλο για προγραμματιστές που χτίζουν AI workflows γύρω από web data, ειδικά όταν η εργασία εξαγωγής αλλάζει συχνά ή χρειάζεται να συνδεθεί με πλαίσια όπως LangChain, CrewAI, SDKs, εργαλεία γραμμής εντολών ή περιβάλλοντα με MCP. Το κύριο πλεονέκτημα είναι η ευελιξία: η λογική εξαγωγής μπορεί να καθοδηγείται από prompt αντί να είναι πλήρως δεμένη σε εύθραυστους selectors σελίδας.
Αυτή η ευελιξία καθιστά την επικύρωση ιδιαίτερα σημαντική. Οι ομάδες πρέπει να ορίσουν σχήματα, συμπεριφορά επαναπροσπάθειας, πεδία απόδειξης και κανόνες δειγματοληπτικής ανασκόπησης πριν την παραγωγική χρήση, επειδή μια πειστική απάντηση δεν είναι απαραίτητα πλήρης εξαγωγή. Το ScrapeGraphAI είναι ελκυστικό για πειράματα και προσαρμοστικές ροές εργασίας, ενώ σταθερές εργασίες υψηλού όγκου μπορεί ακόμη να επωφεληθούν από deterministic selectors ή μια υβριδική προσέγγιση που χρησιμοποιεί AI μόνο όπου η δομή της σελίδας διαφέρει.
Πλεονεκτήματα και Μειονεκτήματα
- Η εξαγωγή φυσικής γλώσσας είναι χρήσιμη για μεταβαλλόμενες ή εξερευνητικές εργασίες
- Η έξοδος δομημένου JSON ταιριάζει σε AI εφαρμογές και ροές αυτοματισμού
- Οι ενσωματώσεις προγραμματιστών υποστηρίζουν περιπτώσεις χρήσης agents και orchestration
- Χρήσιμο όταν η συντήρηση selectors θα επιβραδύνει την πειραματική φάση
- Η εξαγωγή AI πρέπει να επικυρώνεται πριν την παραγωγική χρήση
- Ο σχεδιασμός prompt και τα σχήματα επηρεάζουν τη συνέπεια της εξόδου
- Λιγότερο κατάλληλο για ομάδες που χρειάζονται καθαρά οπτικό no‑code workflow
Συχνές Ερωτήσεις
Τι κάνει ένα εργαλείο web scraping AI‑powered;
Τα AI‑powered scrapers συνήθως βοηθούν σε ένα ή περισσότερα από τα τέσσερα καθήκοντα: αναγνώριση πεδίων σε σελίδα, μετατροπή περιεχομένου σε δομημένα δεδομένα, έλεγχο προγράμματος περιήγησης μέσω εντολών φυσικής γλώσσας ή προετοιμασία του scraped περιεχομένου για συστήματα AI. Τα καλύτερα εργαλεία εξακολουθούν να απαιτούν σαφή prompts, σχήματα, επικύρωση και κανόνες για το τι δεδομένα πρέπει να συλλεχθούν.
Ποια είναι η διαφορά μεταξύ scraping και αυτοματισμού προγράμματος περιήγησης;
Το scraping επικεντρώνεται στην εξαγωγή δεδομένων από σελίδες. Ο αυτοματισμός προγράμματος περιήγησης ελέγχει ένα πρόγραμμα περιήγησης για κλικ, κύλιση, είσοδο, συμπλήρωση φορμών, αναμονή δυναμικού περιεχομένου ή προχωρήσει μέσα από πολλαπλά βήματα. Πολλά σύγχρονα εργαλεία συνδυάζουν και τα δύο, αλλά η διάκριση είναι σημαντική: μια στατική λίστα προϊόντων είναι εργασία scraping, ενώ μια ροή που απαιτεί πλοήγηση και αλληλεπίδραση μπορεί να χρειάζεται αυτοματισμό προγράμματος περιήγησης.
Ποια μορφή εξόδου είναι η καλύτερη για σύστημα RAG;
Τα συστήματα Retrieval‑Augmented Generation λειτουργούν καλύτερα με καθαρό κείμενο, Markdown, δομημένο JSON, μεταδεδομένα και σταθερά URLs πηγής. Ο στόχος δεν είναι μόνο η συλλογή περιεχομένου αλλά η διατήρηση αρκετής δομής για chunking, ανάκτηση, παραπομπή και ελέγχους ποιότητας. Το ακατέργαστο HTML μπορεί να είναι χρήσιμο, αλλά συχνά δημιουργεί επιπλέον δουλειά καθαρισμού πριν τα δεδομένα γίνουν χρήσιμα για εφαρμογή AI.
Μπορούν τα AI scrapers να χειριστούν ιστοσελίδες JavaScript;
Πολλά μπορούν, αλλά η ποιότητα εξαρτάται από το προϊόν. Κάποια εργαλεία renderάρουν σελίδες σε πρόγραμμα περιήγησης, κάποια χρησιμοποιούν υποδομή headless browser, ενώ άλλα βασίζονται στην εξαγωγή μετά τη φόρτωση της σελίδας. Η υποστήριξη JavaScript είναι σημαντική για e‑commerce, marketplaces, κοινωνικές πλατφόρμες, dashboards και σύγχρονα web apps όπου τα χρήσιμα δεδομένα εμφανίζονται μετά την αρχική απόκριση της σελίδας.
Είναι τα no‑code scrapers κατάλληλα για μεγάλα έργα;
Τα no‑code scrapers μπορούν να είναι εξαιρετικά για επαναλαμβανόμενες επιχειρηματικές ροές, παρακολούθηση ανταγωνιστών, έρευνα leads και εργασίες λειτουργίας. Μεγαλύτερα προγράμματα μπορεί τελικά να χρειαστούν APIs, queues, παρακολούθηση, υποδομή proxy, version control, επικύρωση δεδομένων και ιδιοκτησία engineering. Τα καλύτερα no‑code εργαλεία είναι ισχυρότερα όταν η ροή εργασίας είναι σαφής και η ομάδα θέλει ταχύτητα χωρίς να χτίσει προσαρμοσμένο scraper.
Είναι νόμιμο το web scraping;
Η νομοθεσία περί web scraping εξαρτάται από τη δικαιοδοσία, τον ιστότοπο-στόχο, τον τύπο δεδομένων, τη μέθοδο πρόσβασης και τον τρόπο χρήσης των δεδομένων. Η συλλογή δημόσιων δεδομένων ιστού μπορεί ακόμη να εγείρει ζητήματα συμβατικότητας, ιδιωτικότητας, πνευματικής ιδιοκτησίας, κυβερνοασφάλειας και πολιτικής πλατφόρμας. Οι ομάδες πρέπει να εξετάσουν τους ισχύοντες νόμους, το robots.txt και τους όρους χρήσης, τις εσωτερικές πολιτικές συμμόρφωσης και την ευαισθησία των δεδομένων πριν ξεκινήσουν ένα πρόγραμμα scraping.
Πρέπει να επικυρώνονται τα AI‑γενόμενα αποτελέσματα εξαγωγής;
Ναι. Η AI μπορεί να κάνει το scraping πιο ευέλικτο, αλλά μπορεί επίσης να διαβάσει λανθασμένα σελίδες, να συγχωνεύσει πεδία, να παραβλέψει κρυφό context ή να επιστρέψει ασυνεπείς δομές όταν τα layout αλλάζουν. Οι παραγωγικές ροές εργασίας πρέπει να περιλαμβάνουν ελέγχους σχήματος, δειγματοληπτικές ανασκοπήσεις, ειδοποιήσεις αλλαγής, διαχείριση σφαλμάτων και ανθρώπινη ανασκόπηση για ευαίσθητες αποφάσεις.
Τελικές Σκέψεις για τα Εργαλεία AI Web Scraping
Bright Data είναι η ισχυρότερη συνολική επιλογή για ομάδες που χρειάζονται σοβαρή υποδομή και μεγάλα προγράμματα δημόσιων δεδομένων. Firecrawl ταιριάζει τέλεια για AI εφαρμογές που χρειάζονται web context έτοιμο για LLM, ενώ Apify προσφέρει στους προγραμματιστές μια ευέλικτη πλατφόρμα για προσαρμοσμένα scrapers, Actors και αυτοματισμό προγράμματος περιήγησης.
Για επιχειρηματικές ομάδες, Browse AI και Octoparse κάνουν τη συλλογή δεδομένων πιο προσιτή χωρίς να απαιτείται κάθε ροή εργασίας να γίνει έργο engineering. ScrapingBee είναι ένα ισχυρό API φιλικό προς προγραμματιστές για εξαγωγή φυσικής γλώσσας, rendering JavaScript και δομημένη έξοδο χωρίς τη συντήρηση browser και υποδομής proxy.
SearchAPI ξεχωρίζει όταν η απαίτηση είναι φρέσκο, δομημένο δεδομένο μηχανής αναζήτησης για SEO, έρευνα ή AI agents αντί για αυθαίρετο crawling ιστοτόπων. Oxylabs είναι η καλύτερη επιλογή για enterprise APIs scraping και δύσκολες δημόσιες ιστοσελίδες, Diffbot είναι ελκυστικό όταν η εξαγωγή οντοτήτων και το Knowledge Graph context έχουν σημασία, και ScrapeGraphAI είναι μια ευέλικτη επιλογή εξαγωγής βάσει prompt για AI workflows.




