Μοντέλα και πλατφόρμες AI
AudioSep: Διαχωρίστε Οποιονδήποτε Ήχο Περιγράφετε

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤο AudioSep είναι ένα βασικό μοντέλο που διαχωρίζει ήχους χρησιμοποιώντας ερωτήματα…
Δείτε περισσότερα
- Το AudioSep είναι ένα βασικό μοντέλο που διαχωρίζει ήχους χρησιμοποιώντας ερωτήματα φυσικής γλώσσας σε ανοιχτούς τομείς.
- Το μοντέλο αξιοποιεί μεγάλης κλίμακας πολυτροπικά σύνολα δεδομένων για να ξεπεράσει τους περιορισμούς σχολιασμένων δεδομένων των προηγούμενων πλαισίων LASS.
- Η αρχιτεκτονική του συνδυάζει έναν παγωμένο κωδικοποιητή κειμένου CLIP ή CLAP με έναν πυρήνα διαχωρισμού ResUNet για απόδοση χωρίς προηγούμενη εκπαίδευση (zero-shot).
Το LASS, δηλαδή ο Διαχωρισμός Ηχητικών Πηγών με Γλωσσικά Ερωτήματα, είναι το νέο παράδειγμα για το CASA ή την Υπολογιστική Ακουστική Ανάλυση Σκηνής που στοχεύει στον διαχωρισμό ενός επιθυμητού ήχου από ένα δεδομένο μείγμα ήχου χρησιμοποιώντας ένα ερώτημα φυσικής γλώσσας που παρέχει μια φυσική αλλά κλιμακώσιμη διεπαφή για ψηφιακές ηχητικές εργασίες και εφαρμογές. Αν και τα πλαίσια LASS έχουν προοδεύσει σημαντικά τα τελευταία χρόνια σε όρους επίτευξης επιθυμητής απόδοσης σε συγκεκριμένες ηχητικές πηγές όπως μουσικά όργανα, δεν είναι σε θέση να διαχωρίσουν τον στόχο ήχου σε ανοιχτό πεδίο.
AudioSep, είναι ένα θεμελιώδες μοντέλο που στοχεύει να επιλύσει τους τρέχοντες περιορισμούς των πλαισίων LASS ενεργοποιώντας τον διαχωρισμό του επιθυμητού ήχου χρησιμοποιώντας ερωτήματα φυσικής γλώσσας. Οι προγραμματιστές του πλαισίου AudioSep έχουν εκπαιδεύσει το μοντέλο εκτενώς σε ένα ευρύ φάσμα μεγάλης κλίμακας πολυτροπικών συνόλων δεδομένων και έχουν αξιολογήσει την απόδοση του πλαισίου σε ένα ευρύ φάσμα ηχητικών εργασιών συμπεριλαμβανομένων του διαχωρισμού μουσικών οργάνων, του διαχωρισμού ηχητικών συμβάντων και της βελτίωσης της ομιλίας μεταξύ πολλών άλλων. Η αρχική απόδοση του AudioSep ικανοποιεί τις δοκιμές αναφοράς καθώς παρουσιάζει εντυπωσιακές ικανότητες μάθησης χωρίς παραδείγματα (zero-shot) και παρέχει ισχυρή απόδοση διαχωρισμού ήχου.
Σε αυτό το άρθρο, θα κάνουμε μια πιο λεπτομερή εμβάθυνση στη λειτουργία του πλαισίου AudioSep καθώς θα αξιολογήσουμε την αρχιτεκτονική του μοντέλου, τα σύνολα δεδομένων που χρησιμοποιούνται για την εκπαίδευση και την αξιολόγηση, και τις βασικές έννοιες που εμπλέκονται στη λειτουργία του μοντέλου AudioSep. Έτσι, ας ξεκινήσουμε με μια βασική εισαγωγή στο πλαίσιο CASA.
CASA, USS, QSS, LASS Πλαίσια: Η Βάση για το AudioSep
Το CASA, δηλαδή η Υπολογιστική Ανάλυση Ακουστικής Σκηνής, είναι ένα πλαίσιο που χρησιμοποιείται από προγραμματιστές για να σχεδιάσουν συστήματα ακουστικής που έχουν την ικανότητα να αντιλαμβάνονται σύνθετα ηχητικά περιβάλλοντα με τρόπο παρόμοιο με τον τρόπο που οι άνθρωποι αντιλαμβάνονται τον ήχο χρησιμοποιώντας τα ακουστικά συστήματα. Ο διαχωρισμός ήχου, με ειδική έμφαση στον διαχωρισμό του επιθυμητού ήχου, είναι μια θεμελιώδους σημασίας περιοχή έρευνας εντός του πλαισίου CASA, και στοχεύει να λύσει το «πρόβλημα του κοκτέιλ πάρτι» ή τον διαχωρισμό πραγματικών ηχητικών εγγραφών από ατομικές ηχητικές εγγραφές ή αρχεία. Η σημασία του διαχωρισμού ήχου μπορεί να αποδοθεί κυρίως στις ευρείες εφαρμογές του, συμπεριλαμβανομένων του διαχωρισμού μουσικών πηγών, του διαχωρισμού ηχητικών πηγών, της βελτίωσης της ομιλίας, της ταυτοποίησης στόχου ήχου, και πολλά άλλα.
Η πλειονότητα των εργασιών για τον διαχωρισμό ήχου που έχουν γίνει στο παρελθόν περιστρέφεται κυρίως γύρω από τον διαχωρισμό ενός ή περισσοτέρων ηχητικών πηγών όπως ο διαχωρισμός μουσικής ή ο διαχωρισμός ομιλίας. Ένα νέο μοντέλο με το όνομα USS ή Καθολικός Διαχωρισμός Ήχου στοχεύει στον διαχωρισμό αυθαίρετων ήχων σε πραγματικά ηχητικά αρχεία. Ωστόσο, είναι μια προκλητική και περιοριστική εργασία να διαχωρίσετε κάθε ηχητική πηγή από ένα μείγμα ήχου κυρίως λόγω του ευρέος φάσματος διαφορετικών ηχητικών πηγών που υπάρχουν στον κόσμο, το οποίο είναι ο κύριος λόγος για τον οποίο η μέθοδος USS δεν είναι εφικτή για πραγματικές εφαρμογές που λειτουργούν σε πραγματικό χρόνο.
Μια εφικτή εναλλακτική λύση για τη μέθοδο USS είναι η QSS ή η μέθοδος Διαχωρισμού Ήχου βάσει Ερωτημάτων που στοχεύει στον διαχωρισμό μιας μεμονωμένης ή επιθυμητής ηχητικής πηγής από το μείγμα ήχου με βάση ένα συγκεκριμένο σύνολο ερωτημάτων. Χάρη σε αυτό, το πλαίσιο QSS επιτρέπει στους προγραμματιστές και τους χρήστες να εξάγουν τις επιθυμητές πηγές ήχου από το μείγμα με βάση τις απαιτήσεις τους, καθιστώντας τη μέθοδο QSS μια πιο πρακτική λύση για ψηφιακές εφαρμογές του πραγματικού κόσμου όπως η επεξεργασία πολυμέσων ή η επεξεργασία ήχου.
Επιπλέον, οι προγραμματιστές έχουν πρόσφατα προτείνει μια επέκταση του πλαισίου QSS, το LASS ή το πλαίσιο Διαχωρισμού Ηχητικών Πηγών με Γλωσσικά Ερωτήματα που στοχεύει στον διαχωρισμό αυθαίρετων πηγών ήχου από ένα μείγμα ήχου χρησιμοποιώντας φυσικές περιγραφές του επιθυμητού ήχου. Καθώς το πλαίσιο LASS επιτρέπει στους χρήστες να εξάγουν τις πηγές ήχου χρησιμοποιώντας ένα σύνολο οδηγιών φυσικής γλώσσας, μπορεί να γίνει ένα ισχυρό εργαλείο με ευρείες εφαρμογές σε ψηφιακές ηχητικές εφαρμογές. Σε σύγκριση με παραδοσιακές μεθόδους που χρησιμοποιούν ηχητικά ή οπτικά ερωτήματα, η χρήση οδηγιών φυσικής γλώσσας για τον διαχωρισμό ήχου προσφέρει έναν μεγαλύτερο βαθμό ευελιξίας και καθιστά την απόκτηση ερωτηματικών πληροφοριών πολύ πιο εύκολη και βολική. Επιπλέον, σε σύγκριση με μεθόδους διαχωρισμού ήχου που βασίζονται σε προκαθορισμένα σύνολα οδηγιών ή ερωτημάτων, το πλαίσιο LASS δεν περιορίζει τον αριθμό των εισαγόμενων ερωτημάτων και έχει την ευελιξία να γενικευθεί σε ανοιχτό τομέα χωρίς προβλήματα.
Αρχικά, το πλαίσιο LASS βασίζεται σε επιβλεπόμενη εκπαίδευση, στην οποία το μοντέλο εκπαιδεύεται σε ένα σύνολο επισημασμένων ζευγών ήχου και κειμένου. Ωστόσο, το κύριο πρόβλημα με αυτήν την προσέγγιση είναι η περιορισμένη διαθεσιμότητα δεδομένων ήχου και κειμένου με επισημάνσεις. Για να μειώσει την εξάρτηση του πλαισίου LASS από επισημασμένα δεδομένα ήχου και κειμένου, τα μοντέλα εκπαιδεύονται χρησιμοποιώντας την πολυτροπική επιβλεπόμενη εκπαίδευση προσέγγιση. Ο κύριος στόχος πίσω από τη χρήση μιας πολυτροπικής επιβλεπόμενης εκπαίδευσης είναι να χρησιμοποιηθούν μοντέλα αντιπαραθετικής προεκπαίδευσης όπως το CLIP ή το Contrastive Language Image Pre Training μοντέλο ως ο κωδικοποιητής ερωτήματος για το πλαίσιο. Καθώς το μοντέλο CLIP έχει την ικανότητα να ευθυγραμμίσει διανυσματικές αναπαραστάσεις κειμένου με άλλους τύπους δεδομένων όπως ήχος ή όραση, επιτρέπει στους προγραμματιστές να εκπαιδεύσουν τα μοντέλα LASS χρησιμοποιώντας τύπους δεδομένων που διατίθενται σε αφθονία και να εκτελούν συμπερασμό με κειμενικά δεδομένα σε συνθήκες zero-shot. Τα τρέχοντα πλαίσια LASS ωστόσο χρησιμοποιούν μικρής κλίμακας σύνολα δεδομένων για την εκπαίδευση, και οι εφαρμογές του πλαισίου LASS σε εκατοντάδες πιθανές περιοχές είναι ακόμη να εξερευνηθούν.
Για να επιλύσει τους τρέχοντες περιορισμούς που αντιμετωπίζουν τα πλαίσια LASS, οι προγραμματιστές έχουν εισαγάγει το AudioSep, ένα θεμελιώδες μοντέλο που στοχεύει στον διαχωρισμό ήχου από ένα μείγμα ήχου χρησιμοποιώντας φυσικές περιγραφές. Ο τρέχων στόχος για το AudioSep είναι να αναπτύξει ένα προ-εκπαιδευμένο μοντέλο διαχωρισμού ήχου που να εκμεταλλεύεται τα υπάρχοντα μεγάλα πολυτροπικά σύνολα δεδομένων για να ενεργοποιήσει την γενίκευση των μοντέλων LASS σε ανοιχτό τομέα. Για να συνοψίσουμε, το μοντέλο AudioSep είναι: «Ένα θεμελιώδες μοντέλο για τον καθολικό διαχωρισμό ήχου σε ανοιχτό τομέα χρησιμοποιώντας ερωτήματα φυσικής γλώσσας ή περιγραφές εκπαιδευμένο σε μεγάλα πολυτροπικά σύνολα δεδομένων».
AudioSep: Κύρια Στοιχεία & Αρχιτεκτονική
Η αρχιτεκτονική του πλαισίου AudioSep αποτελείται από δύο κύρια στοιχεία: έναν κωδικοποιητή κειμένου και ένα μοντέλο διαχωρισμού.
Ο Κωδικοποιητής Κειμένου
Το πλαίσιο AudioSep χρησιμοποιεί έναν κωδικοποιητή κειμένου του μοντέλου CLIP ή του Contrastive Language Image Pre Training μοντέλου ή του CLAP ή του Contrastive Language Audio Pre Training μοντέλου για να εξάγει διανυσματικές αναπαραστάσεις κειμένου από ένα ερώτημα φυσικής γλώσσας. Το εισερχόμενο κειμενικό ερώτημα αποτελείται από μια σειρά «N» token που στη συνέχεια επεξεργάζεται από τον κωδικοποιητή κειμένου για να εξαγάγει τις διανυσματικές αναπαραστάσεις κειμένου για το δεδομένο εισερχόμενο γλωσσικό ερώτημα. Ο κωδικοποιητής κειμένου χρησιμοποιεί μια στοίβα από μπλοκ μετασχηματιστών για να κωδικοποιήσει τα εισαγόμενα κειμενικά token, και οι εξοδοτικές αναπαραστάσεις συλλέγονται μετά την διέλευση από τα στρώματα μετασχηματιστών που οδηγεί στην ανάπτυξη μιας D-διαστάσεων διανυσματικής αναπαράστασης με σταθερό μήκος όπου D αντιστοιχεί στις διαστάσεις του μοντέλου CLAP ή CLIP, ενώ ο κωδικοποιητής κειμένου είναι παγωμένος κατά την περίοδο εκπαίδευσης.
Το μοντέλο CLIP είναι προ-εκπαιδευμένο σε ένα μεγάλο σύνολο δεδομένων εικόνας-κειμένου ζευγαριών χρησιμοποιώντας αντιπαραθετική μάθηση, η οποία είναι ο κύριος λόγος για τον οποίο ο κωδικοποιητής κειμένου του μοντέλου CLIP μαθαίνει να χαρτογραφεί κειμενικές περιγραφές στον σημασιολογικό χώρο που είναι επίσης κοινός με τις οπτικές αναπαραστάσεις. Το πλεονέκτημα που το AudioSep αποκτά με τη χρήση του κωδικοποιητή κειμένου του CLIP είναι ότι μπορεί τώρα να κλιμακωθεί ή να εκπαιδεύσει το μοντέλο LASS από μη επισημασμένα ηχητικά-οπτικά δεδομένα χρησιμοποιώντας τις διανυσματικές οπτικές αναπαραστάσεις ως εναλλακτική, επιτρέποντας την εκπαίδευση των μοντέλων LASS χωρίς την ανάγκη επισημασμένα δεδομένα ήχου και κειμένου.
Το μοντέλο CLAP λειτουργεί παρόμοια με το μοντέλο CLIP και χρησιμοποιεί αντικειμενικό στόχο αντιπαραθετικής μάθησης χρησιμοποιώντας έναν κωδικοποιητή κειμένου και έναν κωδικοποιητή ήχου για να συνδέσει ήχο και γλώσσα, φέρνοντας κειμενικές και ηχητικές περιγραφές σε έναν ηχητικό-κειμενικό λανθάνοντα χώρο μαζί.
Μοντέλο Διαχωρισμού
Το πλαίσιο AudioSep χρησιμοποιεί ένα μοντέλο ResUNet που τροφοδοτείται με ένα μείγμα ηχητικών κλιπ ως τον πυρήνα διαχωρισμού για το πλαίσιο. Το πλαίσιο λειτουργεί εφαρμόζοντας έναν STFT, δηλαδή έναν μετασχηματισμό Fourier βραχέος χρόνου στην κυματική μορφή για να εξαγάγει ένα σύνθετο φασματόγραμμα, το φασματόγραμμα μεγέθους, και την Φάση του X. Το μοντέλο στη συνέχεια ακολουθεί την ίδια ρύθμιση και κατασκευάζει ένα δίκτυο κωδικοποιητή-αποκωδικοποιητή για να επεξεργαστεί το φασματόγραμμα μεγέθους.
Το δίκτυο κωδικοποιητή-αποκωδικοποιητή ResUNet αποτελείται από 6 υπολειμματικά μπλοκ, 6 μπλοκ αποκωδικοποιητή και 4 μπλοκ στενωπού. Σε κάθε μπλοκ κωδικοποιητή, 4 υπολειμματικά συνελικτικά μπλοκ υποδειγματοληπτούν το φασματογράφημα σε χαρακτηριστικά στενωπού. Αντίστοιχα, τα μπλοκ αποκωδικοποιητή χρησιμοποιούν 4 υπολειμματικά αποσυνελικτικά μπλοκ για να υπερδειγματοληπτήσουν τα χαρακτηριστικά και να ανακτήσουν τα στοιχεία διαχωρισμού. Κάθε μπλοκ κωδικοποιητή συνδέεται με το αντίστοιχο μπλοκ αποκωδικοποιητή μέσω σύνδεσης παράκαμψης στο ίδιο επίπεδο υποδειγματοληψίας ή υπερδειγματοληψίας. Κάθε υπολειμματικό μπλοκ περιλαμβάνει 2 στρώματα ενεργοποίησης Leaky-ReLU, 2 στρώματα κανονικοποίησης παρτίδας και 2 στρώματα CNN, καθώς και μια πρόσθετη υπολειμματική σύνδεση ανάμεσα στην είσοδο και την έξοδό του. Το ResUNet λαμβάνει το σύνθετο φασματογράφημα X και παράγει μάσκα μέτρου M και υπόλοιπο φάσης, με εξάρτηση από τις διανυσματικές αναπαραστάσεις κειμένου που ελέγχουν την κλιμάκωση του μέτρου και την περιστροφή της φάσης. Το διαχωρισμένο σύνθετο φασματογράφημα προκύπτει πολλαπλασιάζοντας την προβλεπόμενη μάσκα μέτρου και το υπόλοιπο φάσης με τον STFT του μείγματος.

Στο πλαίσιο του, το AudioSep χρησιμοποιεί ένα στρώμα FiLm, δηλαδή γραμμικής διαμόρφωσης ανά χαρακτηριστικό για να συνδέσει το μοντέλο διαχωρισμού και τον κωδικοποιητή κειμένου μετά την ανάπτυξη των συνελικτικών μπλοκ στο ResUNet.
Εκπαίδευση και Απώλεια
Κατά την εκπαίδευση του μοντέλου AudioSep, οι προγραμματιστές χρησιμοποιούν τη μέθοδο επαύξησης της ηχητικής έντασης, και εκπαιδεύουν το πλαίσιο AudioSep από άκρο σε άκρο χρησιμοποιώντας μια συνάρτηση απώλειας L1 μεταξύ της πραγματικής και της προβλεπόμενης κυματικής μορφής.
Συνόλα Δεδομένων και Δοκιμές αναφοράς
Όπως αναφέρθηκε σε προηγούμενες ενότητες, το AudioSep είναι ένα θεμελιώδες μοντέλο που στοχεύει να επιλύσει την τρέχουσα εξάρτηση των μοντέλων LASS από επισημασμένα δεδομένα ήχου και κειμένου. Το μοντέλο AudioSep εκπαιδεύεται σε ένα ευρύ φάσμα συνόλων δεδομένων για να του παρέχει πολυμεσικές εκπαιδευτικές ικανότητες, και εδώ είναι μια λεπτομερής περιγραφή του συνόλου δεδομένων και των δοκιμές αναφοράς που χρησιμοποιούνται από τους προγραμματιστές για να εκπαιδεύσουν το πλαίσιο AudioSep.
AudioSet
Το AudioSet είναι ένα με ασθενείς ετικέτες μεγάλο σύνολο δεδομένων ήχου που αποτελείται από πάνω από 2 εκατομμύρια 10-δευτερόλεπτων ηχητικών κλιπ που εξάγονται άμεσα από το YouTube. Κάθε ηχητικό κλιπ στο σύνολο δεδομένων AudioSet κατηγοριοποιείται από την απουσία ή την παρουσία ηχητικών κλάσεων χωρίς τις συγκεκριμένες λεπτομέρειες του χρόνου των ηχητικών συμβάντων. Το σύνολο δεδομένων AudioSet έχει πάνω από 500 διαφορετικές ηχητικές κλάσεις, συμπεριλαμβανομένων φυσικών ήχων, ανθρώπινων ήχων, οχημάτων ήχων, και πολλά άλλα.
VGGSound
Το σύνολο δεδομένων VGGSound είναι ένα μεγάλο σύνολο δεδομένων οπτικών-ήχου που, όπως και το AudioSet, έχει εξαχθεί άμεσα από το YouTube, και περιέχει πάνω από 200.000 βίντεο κλιπ, κάθε ένα από τα οποία έχει διάρκεια 10 δευτερολέπτων. Το σύνολο δεδομένων VGGSound κατηγοριοποιείται σε πάνω από 300 ηχητικές κλάσεις, συμπεριλαμβανομένων ανθρώπινων ήχων, φυσικών ήχων, πουλιών ήχων, και πολλά άλλα. Η χρήση του συνόλου δεδομένων VGGSound εξασφαλίζει ότι το αντικείμενο που παράγει τον στόχο ήχο είναι επίσης περιγραφικό στην αντίστοιχο οπτικό απόσπασμα.
AudioCaps
Το AudioCaps είναι το μεγαλύτερο δημόσιο σύνολο δεδομένων ηχητικών περιγραφών και αποτελείται από πάνω από 50.000 10-δευτερόλεπτων ηχητικών κλιπ που εξάγονται από το σύνολο δεδομένων AudioSet. Τα δεδομένα στο AudioCaps διαιρούνται σε τρεις κατηγορίες: δεδομένα εκπαίδευσης, δεδομένα δοκιμής, και δεδομένα επαλήθευσης, και τα ηχητικά κλιπ είναι επισημασμένα από ανθρώπους με περιγραφές σε φυσική γλώσσα χρησιμοποιώντας την πλατφόρμα Amazon Mechanical Turk. Είναι αξιοσημείωτο ότι κάθε ηχητικό κλιπ στο σύνολο δεδομένων εκπαίδευσης έχει μια μόνο ετικέτα, ενώ τα δεδομένα δοκιμής και επαλήθευσης έχουν από 5 πραγματικές ετικέτες.
ClothoV2
Το ClothoV2 είναι ένα σύνολο δεδομένων ηχητικών περιγραφών που αποτελείται από κλιπ που εξάγονται από την πλατφόρμα FreeSound, και όπως και το AudioCaps, κάθε ηχητικό κλιπ είναι επισημασμένο από ανθρώπους με περιγραφές σε φυσική γλώσσα χρησιμοποιώντας την πλατφόρμα Amazon Mechanical Turk.
WavCaps
Όπως και το AudioSet, το WavCaps είναι ένα με ασθενείς ετικέτες μεγάλο σύνολο δεδομένων ήχου που αποτελείται από πάνω από 400.000 ηχητικά κλιπ με περιγραφές, και συνολικό χρόνο εκτέλεσης που προσεγγίζει τις 7568 ώρες εκπαίδευσης. Τα ηχητικά κλιπ στο σύνολο δεδομένων WavCaps εξάγονται από ένα ευρύ φάσμα ηχητικών πηγών, συμπεριλαμβανομένων των BBC Sound Effects, AudioSet, FreeSound, SoundBible, και πολλά άλλα.

Λεπτομέρειες Εκπαίδευσης
Κατά την περίοδο εκπαίδευσης, το μοντέλο AudioSep δειγματοληπτεί τυχαία δύο ηχητικά τμήματα από δύο διαφορετικά ηχητικά κλιπ από το σύνολο δεδομένων εκπαίδευσης, και στη συνέχεια τα αναμιγνύει για να δημιουργήσει ένα μείγμα εκπαίδευσης όπου το μήκος κάθε ηχογραφικού τμήματος είναι περίπου 5 δευτερόλεπτα. Το μοντέλο στη συνέχεια εξάγει το σύνθετο φασματόγραμμα από το σήμα κυματικής μορφής χρησιμοποιώντας ένα παράθυρο Hann μεγέθους 1024 με ένα βήμα μετατόπισης μεγέθους 320.
Το μοντέλο στη συνέχεια χρησιμοποιεί τον κωδικοποιητή κειμένου του μοντέλου CLIP/CLAP για να εξαγάγει τις διανυσματικές αναπαραστάσεις κειμένου με κειμενική επιτήρηση ως την προεπιλεγμένη ρύθμιση για το AudioSep. Για το μοντέλο διαχωρισμού, το πλαίσιο AudioSep χρησιμοποιεί ένα στρώμα ResUNet που αποτελείται από 30 στρώματα, 6 κωδικοποιητές blocks, και 6 αποκωδικοποιητές blocks που μοιάζουν με την αρχιτεκτονική που ακολουθείται στο καθολικό μοντέλο διαχωρισμού ήχου. Επιπλέον, κάθε κωδικοποιητής block έχει δύο συνελικτικά στρώματα με έναν πυρήνα μεγέθους 3×3 με τον αριθμό των εξοδοτικών χαρακτηριστικών των κωδικοποιητών blocks να είναι 32, 64, 128, 256, 512, και 1024 αντίστοιχα. Οι αποκωδικοποιητές blocks μοιράζονται συμμετρία με τους κωδικοποιητές blocks, και οι προγραμματιστές εφαρμόζουν τον βελτιστοποιητή Adam για να εκπαιδεύσουν το μοντέλο AudioSep με μια παρτίδα μεγέθους 96.
Αποτελέσματα Αξιολόγησης
Σε Δεδομένα Εκπαίδευσης
Το ακόλουθο σχήμα συγκρίνει την απόδοση του πλαισίου AudioSep σε δεδομένα εκπαίδευσης κατά την περίοδο εκπαίδευσης, συμπεριλαμβανομένων των δεδομένων εκπαίδευσης. Το παρακάτω σχήμα αντιπροσωπεύει τα αποτελέσματα αξιολόγησης του πλαισίου AudioSep όταν συγκρίνεται με τα βασικά συστήματα, συμπεριλαμβανομένων των μοντέλων Βελτίωσης Ομιλίας, LASS, και CLIP. Το μοντέλο AudioSep με τον κωδικοποιητή κειμένου CLIP αντιπροσωπεύεται ως AudioSep-CLIP, ενώ το μοντέλο AudioSep με τον κωδικοποιητή κειμένου CLAP αντιπροσωπεύεται ως AudioSep-CLAP.

Όπως φαίνεται στο σχήμα, το πλαίσιο AudioSep παρουσιάζει καλή απόδοση όταν χρησιμοποιεί ηχητικές περιγραφές ή κειμενικές ετικέτες ως εισαγόμενα ερωτήματα, και τα αποτελέσματα δείχνουν την υπεροχή της απόδοσης του πλαισίου AudioSep όταν συγκρίνεται με τα προηγούμενα μοντέλα LASS και ηχητικά-ερωτημένα μοντέλα διαχωρισμού ήχου.
Σε Άγνωστα Δεδομένα
Για να αξιολογήσει την απόδοση του AudioSep σε συνθήκες zero-shot, οι προγραμματιστές συνέχισαν να αξιολογούν την απόδοση σε άγνωστα δεδομένα, και το πλαίσιο AudioSep παρουσιάζει εντυπωσιακή απόδοση διαχωρισμού σε συνθήκες zero-shot, και τα αποτελέσματα εμφανίζονται στο σχήμα παρακάτω.

Επιπλέον, η εικόνα παρακάτω δείχνει τα αποτελέσματα της αξιολόγησης του μοντέλου AudioSep σε σχέση με το Voicebank-Demand speech enhancement.

Η αξιολόγηση του πλαισίου AudioSep δείχνει μια ισχυρή και επιθυμητή απόδοση σε άγνωστα δεδομένα σε συνθήκες zero-shot, και έτσι ανοίγει τον δρόμο για την εκτέλεση εργασιών ήχου σε νέες κατανομές δεδομένων.
Οπτικοποίηση Αποτελεσμάτων Διαχωρισμού
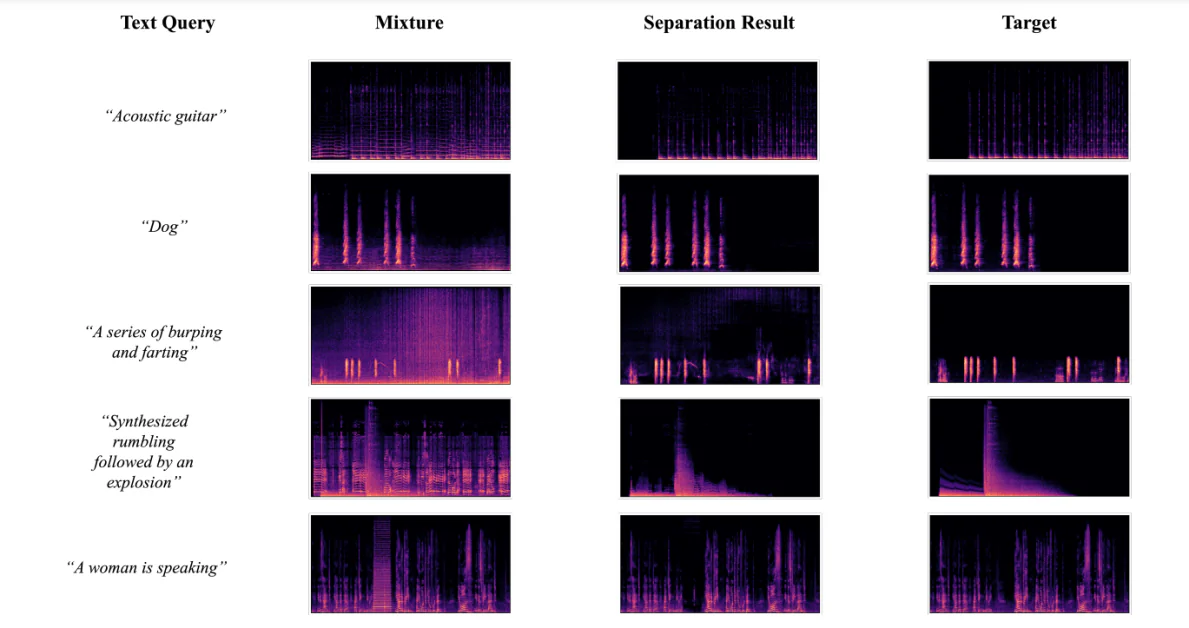
Το παρακάτω σχήμα δείχνει τα αποτελέσματα που λαμβάνονται όταν οι προγραμματιστές χρησιμοποίησαν το πλαίσιο AudioSep-CLAP για να οπτικοποιήσουν τα φασματόγραμμα για τις πραγματικές πηγές ήχου, και τα μείγματα και διαχωρισμένα ηχητικά κλιπ χρησιμοποιώντας κειμενικές ερωτήσεις διαφορετικών ήχων. Τα αποτελέσματα επέτρεψαν στους προγραμματιστές να παρατηρήσουν ότι το μοτίβο του φασματογράμματος της διαχωρισμένης πηγής μοιάζει με την πηγή αναφοράς (ground truth), που υποστηρίζει περαιτέρω τα αντικειμενικά αποτελέσματα που λαμβάνονται κατά τη διάρκεια των πειραμάτων.
Σύγκριση Κειμενικών Ερωτημάτων
Οι προγραμματιστές αξιολογούν την απόδοση του AudioSep-CLAP και του AudioSep-CLIP στο AudioCaps Mini, και οι προγραμματιστές χρησιμοποιούν τις ετικέτες συμβάντων AudioSet, τις περιγραφές AudioCaps, και τις εκ νέου επισημασμένες περιγραφές σε φυσική γλώσσα για να εξετάσουν τις επιδράσεις των διαφορετικών ερωτημάτων, και το παρακάτω σχήμα δείχνει ένα παράδειγμα του AudioCaps Mini σε δράση.

Συμπέρασμα
AudioSep είναι ένα θεμελιώδες μοντέλο που αναπτύχθηκε με τον στόχο να είναι ένα ανοιχτό τομέα καθολικό μοντέλο διαχωρισμού ήχου που χρησιμοποιεί περιγραφές σε φυσική γλώσσα για τον διαχωρισμό ήχου. Όπως παρατηρήθηκε κατά την αξιολόγηση, το πλαίσιο AudioSep είναι ικανό να εκτελεί μάθηση χωρίς παραδείγματα (zero-shot) και μη επιβλεπόμενη μάθηση ομαλά χρησιμοποιώντας ηχητικές περιγραφές ή κειμενικές ετικέτες ως ερωτήματα. Τα αποτελέσματα και η απόδοση αξιολόγησης του AudioSep δείχνουν μια ισχυρή απόδοση που υπερβαίνει τα τρέχοντα μοντέλα διαχωρισμού ήχου όπως το LASS, και μπορεί να είναι αρκετά ικανό για να επιλύσει τους τρέχοντες περιορισμούς των δημοφιλών μοντέλων διαχωρισμού ήχου.