AGI og fremtidens AI
Hvad er Turing-testen, og hvorfor er den vigtig?

 Føj Unite.AI til dine foretrukne kilder på Google
Turing-testen opstod ud fra Alan Turings 1950‑artikel “Computing Machinery and Intelligence.” I stedet for at forsøge at definere tanke foreslog Turing et efterligningsspil: en menneskelig efterforsker udveksler skrevne beskeder med usete deltagere og bedømmer, hvem der er menneske, og hvem der er maskine.
Testen forbliver indflydelsesrig, fordi den omsætter et abstrakt filosofisk spørgsmål til en observerbar interaktion. Den er dog også begrænset: at fremstå som menneske i en samtale er ikke det samme som at være sandfærdig, vidende, sikker, bevidst eller generelt intelligent.
Vigtige pointer
- Turings oprindelige efterligningsspil er en tekstbaseret adfærdstest, ikke en tjekliste over interne kognitive egenskaber.
- Resultaterne afhænger af evaluator, prompt, varighed, deltagerinstruktioner og scoringsregel.
- En model kan efterligne menneskelig samtale, mens den hallucinerer fakta eller fejler på simple robusthedstests.
- Moderne evaluering kræver opgavemålinger, modstandstest, menneskelig gennemgang og risikospesifik evidens ud over samtale.
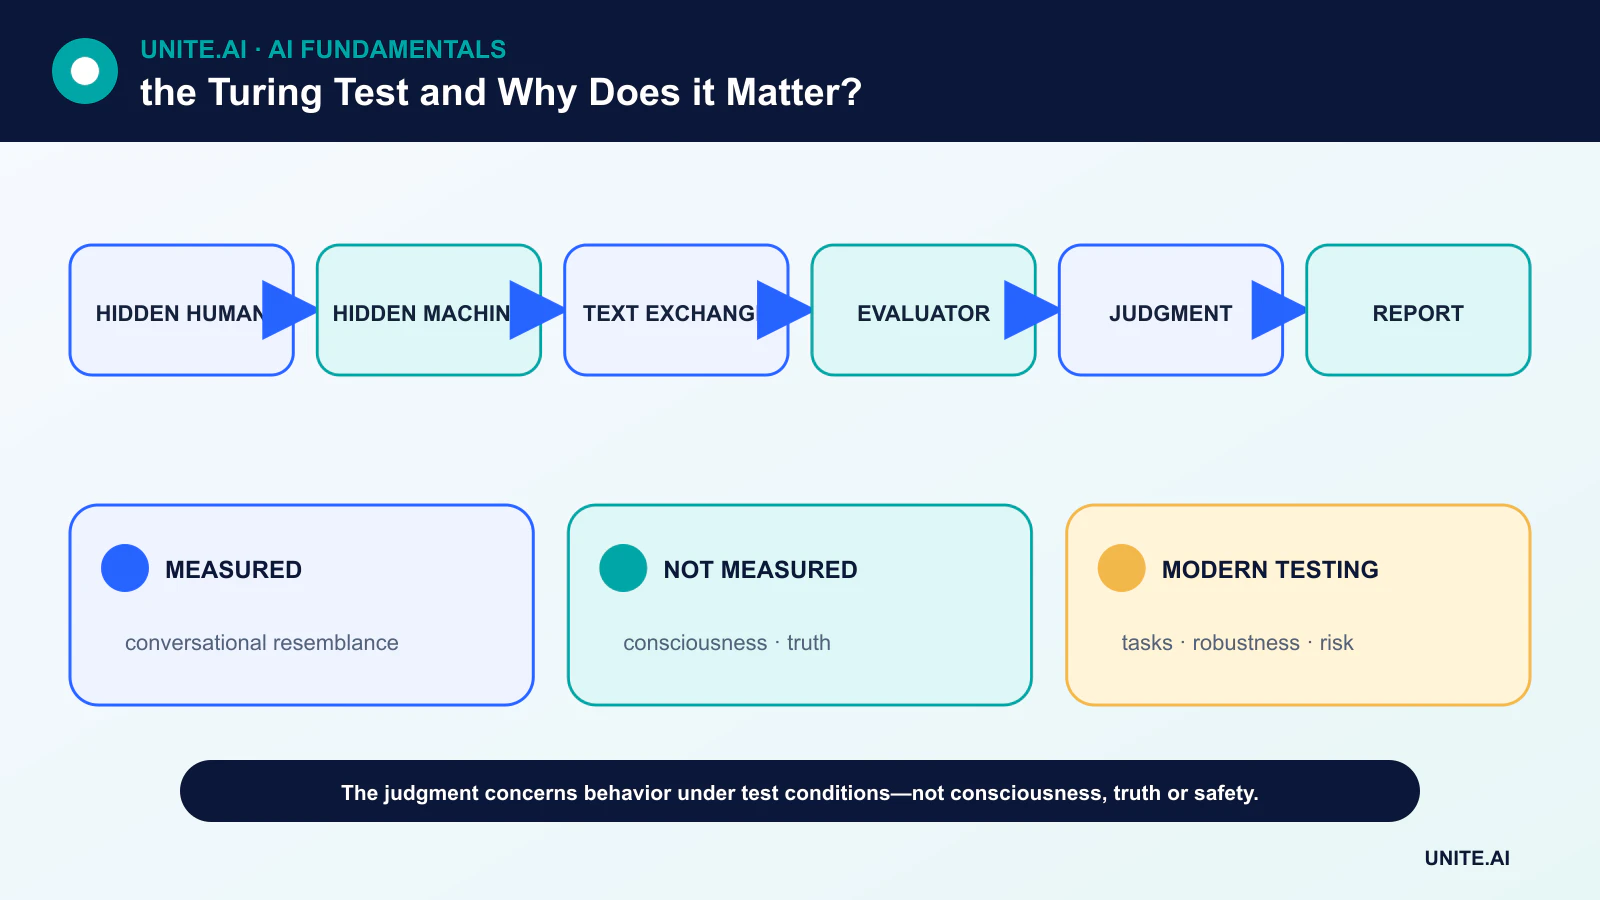
Turings efterligningsspil
I den oprindelige opsætning kommunikerede en efterforsker på afstand, så stemme og udseende ikke afslørede identiteten. Turing spurgte, om en maskine kunne klare spillet så godt, at en evaluator pålideligt ikke kunne skelne den fra en person.
Denne operationelle ramme undgik behovet for at fastlægge én definition af tænkning. Den hævdede ikke, at enhver overbevisende udveksling beviser intelligens, og den specificerede heller ikke en universel beståelsesgrænse, der gælder for senere chatbot‑demonstrationer.
Hvad et resultat faktisk måler
Et forsøg måler adfærdsmæssig uadskillelighed under definerede betingelser. Korte samtaler, uerfarne dommere eller prompts valgt af systemets udvikler kan gøre opgaven lettere. En grundig rapport bør afsløre udvælgelsen af transskripter, antallet og baggrunden for dommerne, sammenligningsmennesker, tidsgrænsen og den statistiske metode.
Et system kan også udnytte forventninger: undvigende svar, humor, typografiske fejl og rollespil kan fremstå som menneskelige uden at demonstrere pålidelig ræsonnement. Omvendt kan et usædvanligt formelt menneskeligt svar blive fejlagtigt klassificeret som maskin‑genereret.
Hvad Turing-testen ikke fastslår
Testen måler ikke direkte bevidsthed, subjektiv oplevelse, faktuel nøjagtighed, kausal forståelse eller moralsk handleevne. Den afslører ikke træningsdata, modelarkitektur eller fejlsituationer uden for samtalen. Den siger heller ikke meget om ikke‑lingvistisk intelligens såsom fysisk manipulation.
Moderne sprogmodeller er bygget med transformer‑neuronale netværk og dyb læring, men deres flydende output kan stadig genereres ud fra indlært statistisk struktur snarere end en verificeret verdensmodel.
Hvordan moderne AI-evaluering udvider spørgsmålet
Nutidig evaluering bruger hold‑out‑opgavesæt, kalibreret usikkerhed, robusthedstests, red‑team‑angreb, faktuel kontrol og studier af menneskelige præferencer. En tekstklassifikations-metrik kan teste en defineret adfærd, mens scenariebaseret evaluering kan teste, om et system følger politik under pres.
Intet enkelt benchmark fanger alle implementeringer. Testforurening kan oppuste scorer, og statiske benchmarks fremmer overtilpasning. Evaluering bør gentages, efterhånden som modeller, data, prompts, værktøjer og brugergrupper ændrer sig.
Hvorfor testen stadig er vigtig
Turing-testen forudså en central lektie i AI-evaluering: vurder observerbar kapacitet i stedet for at stole på påstande om en intern essens. Den tvinger os også til at spørge, hvilke menneskelige adfærd der tæller som bevis, og hvordan et eksperimentelt setup former en konklusion.
Dens bedste moderne anvendelse er som en historisk og konceptuel baseline. At bestå et efterligningsspil kan være interessant, men beslutninger om implementering kræver beviser knyttet til den faktiske opgave, de berørte brugere og forudsigelige skader.
Hvad Turing-testen måler
Alan Turings efterligningsspil spurgte, om en efterforsker, der kommunikerer via tekst, pålideligt kunne skelne en maskine fra en person. Det omformulerede en abstrakt debat om, hvorvidt maskiner tænker, til et observerbart samtaleeksperiment. Testen afhænger af deltagere, varighed, protokol, emner og bedømmelsesregel; der findes ingen enkelt universel score. At bestå betyder at producere menneskelignende svar under den opsætning. Den måler ikke direkte faktuel nøjagtighed, ræsonnement, bevidsthed, autonomi, perception, embodiment, pålidelighed eller gavnlig adfærd i den virkelige verden.
Menneskelig efterligning kan belønne undvigelse, persona, fejl, humor eller manipulation. En dommer kan forveksle et menneske med en maskine eller blive påvirket af forventninger, sprog og kulturel kontekst. Korte samtaler muliggør tricks, der fejler ved længerevarende interaktion. Omvendt kan et meget nyttigt system til matematik, oversættelse eller proteinmodellering fejle, fordi det ikke foregiver at være menneske. Testen måler derfor en social og sproglig evne, formet af evaluator, ikke en fuldstændig rangordning af intelligens.
Moderne sprogmodeller og stærkere evaluering
Store sprogmodeller kan opretholde flydende dialog ved at forudsige sekvenser ud fra bred træningsdata og efterfølgende finjustering, men flydende sprog er svag evidens for sandhed eller forståelse. Memoriserede mønstre, værktøjstilgang, skjult prompting, latenstid og sampling‑indstillinger påvirker resultaterne. Kontrollerede evalueringer bør afsløre model og protokol, forhindre informationslækage, inkludere modstandsspørgsmål og domænespørgsmål samt bedømme usikkerhed og kildehenvisning. En demonstration udvalgt fra succesfulde samtaler kan ikke estimere pålidelighed på tværs af brugens fordeling.
Moderne evaluering er multidimensionel: opgave‑nøjagtighed, kalibrering, robusthed, langtid‑konsistens, sikkerhed, bias, privatliv, sikkerhed, effektivitet og menneskelige resultater. Adfærdstests bør suppleres med proces‑evidens, red‑team‑angreb, reproducerbare benchmarks og real‑world overvågning. Benchmarks kan saturere eller indgå i træningsdata, så private og opdaterede testsæt er nødvendige. For systemer, der handler, skal værktøjstilladelser, genopretning og konsekvenser evalueres separat fra samtalekvalitet.
Hvorfor testen stadig er vigtig
Turing-testen forbliver historisk vigtig, fordi den fokuserer på adfærd og vanskeligheden ved at definere intelligens. Den rejser også vedvarende spørgsmål om antropomorfisme og bedrag. Grænseflader bør identificere syntetiske agenter i stedet for at betragte fejlagtig identitet som succes, især i kritiske sammenhænge. Brug testen som et filosofisk perspektiv og en samtale‑evaluering, ikke som en certificering af generel intelligens eller personlighed. Det væsentlige spørgsmål ved implementering er, hvad systemet pålideligt kan gøre, under hvilke beviser og begrænsninger, og hvem der er ansvarlig, når det fejler.
Arbejdseksempel: en kontrolleret samtale‑evaluering
Evaluatører sammenligner mennesker og flere AI‑systemer i tekst‑samtaler med fast varighed, emner, sprog og blinde identiteter. Dommere registrerer, om de tror, hver deltager er menneske, og scorer også faktualitet, konsistens, hjælpsomhed, usikkerhed og manipulation. Flere dommere og samtaler estimerer variation, og protokollen forhindrer modeludviklere i at vælge gunstige transskripter. Menneskelig fejlkategorisering giver et nødvendigt grundlag for at fortolke resultatet.
Et system, der narmer dommere men opfinder fakta, erklæres ikke som generelt intelligent, mens en tydeligt afsløret specialistmodel kan være meget nyttig, selvom den fejler i efterligningen. Resultaterne indeholder prompt, model, sampler, værktøjstilgang og dommerkendetegn. Eksperimentet er indrammet som en test af menneskelignende samtale. Implementeringsbeslutninger bruger separate beviser for opgavekorrekthed, sikkerhed, privatliv og genopretning, og grænsefladen identificerer agenten i stedet for at gøre bedrag til produktmål.
Implementerings‑evidens og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versionsstyret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlagtige eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne evidens fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre inputkvalitet, output‑adfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter real‑world evidens efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genopretning, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Har nogen AI definitivt bestået Turing-testen?
Der findes ingen enkelt officiel testmyndighed eller universelt accepteret protokol. Offentlige demonstrationer bruger forskellige regler, så påstande om at have “bestået” er ikke direkte sammenlignelige.
Beviser det, at et system fejler i testen, at det er uintelligent?
Nej. Et specialiseret system kan være meget kapabelt uden at efterligne en menneskelig samtalestil.
Primære referencer