Grundlæggende AI
Hvad er Emotion AI (affektiv computing), og hvorfor er det vigtigt?

 Føj Unite.AI til dine foretrukne kilder på Google
Emotion AI, ofte kaldet affektiv computing, anvender beregning på signaler, der er forbundet med affekt, såsom sprog, vokal prosodi, ansigtsbevægelser, kropsholdning, fysiologi eller interaktionsmønstre. Et system kan klassificere en etiket, estimere dimensioner såsom valens og arousal, eller tilpasse en brugerflade.
Resultatet er en inferens – ikke en direkte aflæsning af en indre følelsesmæssig tilstand. Udtryk varierer efter person, kultur, kontekst, helbred og situation, så det samme observerbare signal kan understøtte flere forklaringer. Anvendelser med høje risici kræver stærke beviser, samtykke og juridisk gennemgang.
Nøglepointer
- Definér det observerbare mål præcist; følelse, udtryk, sentiment, stress og engagement er ikke udskiftelige.
- Valider på den tiltænkte population og miljø, ikke kun på et udvalgt benchmark.
- Foretræk assistance og brugerkontrol frem for skjult overvågning eller konsekvensfuld automatiseret bedømmelse.
- Dokumentér usikkerhed, datarettigheder, opbevaring, undergruppepræstationer og en vej til at anfægte beslutninger.
Signal og modelmål
Tekstmodeller kan estimere udtrykt sentiment; lydmodeller bruger timing, tonehøjde og energi; visionsmodeller analyserer bevægelser; fysiologiske systemer kan anvende hjertefrekvens eller hudkonduktans. Multimodale systemer kombinerer signaler, men flere sensorer giver ikke automatisk en mere sand etiket.
En etiket som ‘frustreret’ afhænger af annoteringsinstruktioner og kontekst. Sentimentanalyse af ord er snævrere end at inferere en persons følelsesmæssige tilstand, og ingen af delene bør forveksles med klinisk vurdering.
Hvorfor kontekst og usikkerhed dominerer
Folk maskerer, overdriver eller udtrykker følelser forskelligt. Handicap, sprog, belysning, mikrofonkvalitet og sociale normer kan ændre observerede signaler. Laboratoriedatasæt repræsenterer muligvis ikke et callcenter, klasseværelse, køretøj eller klinik.
Evaluer kalibrering, afholdelse, fejl per gruppe, tvær‑domeneydeevne og alternativer. Forvirringsmatricer hjælper med at vise, hvilke etiketter der forveksles, men en kvalitativ gennemgang er nødvendig for at forstå hvorfor.
Nyttige og risikable anvendelser
Brugerstyrede applikationer kan understøtte tilgængelighed, reflekterende journalisering, adaptiv træning eller en sikkerhedsadvarsel. Disse anvendelser bør tydeligt angive, hvad der måles, tillade korrektion og undgå at overvurdere sikkerhed.
Ansættelse, uddannelse, forsikring, politiarbejde og sundhedsbeslutninger medfører meget højere risici. EU’s AI‑forordning forbyder visse emotion‑genkendelsesbrug på arbejdspladser og i uddannelse, med specificerede undtagelser, og klassificerer andre anvendelser efter risiko. Kravene varierer efter jurisdiktion og ændrer sig over tid.
Ansvarlig implementering
Spørg om opgaven overhovedet har brug for en følelsesinferens. Anvend dataminimering, eksplicit formål, kort opbevaring, sikkerhed, uafhængig test, brugerinformation og menneskelig gennemgang. Undgå at opbygge sekundære profiler fra signaler indsamlet til et andet formål.
Anvend forklarlig AI-praksis uden at antyde, at et saliencymap beviser en følelse. Kommuniker usikkerhed i klar sprogbrug og tilbyd en meningsfuld måde at fravælge eller udfordre et konsekvent resultat.
Hvordan affekt repræsenteres
Kategoriske modeller forudsiger etiketter som glæde, vrede, frygt, tristhed eller neutral. Dimensionelle modeller estimerer kontinuerlige værdier såsom valens, arousal og dominans. Vurderingsmodeller beskriver, hvordan en person evaluerer en begivenhed. Disse repræsentationer er teorier og målevalg, ikke udskiftelige sandheder.
Annotationer kan komme fra personen, der oplever begivenheden, en observatør, en kliniker eller et eksperimentelt protokol. Selvvurdering har introspektive og erindringsbegrænsninger; observatøretskift infererer tilstand ud fra adfærd; fysiologiske målinger afspejler arousal og mange ikke‑følelsesmæssige processer. Et datasæt bør angive, hvis perspektiv etiketten repræsenterer.
Temporal modellering er vigtig, fordi affekt udfolder sig over tid. Ramme‑niveau ansigtsetiketter kan overreagere på kortvarige bevægelser, mens et gennemsnit på udtalelses‑niveau kan skjule ændringer. Vindueslængde, synkronisering på tværs af sensorer, manglende kanaler og taler‑baselines påvirker resultatet.
Modellering af pipelines efter modalitet
Vision‑pipelines opdager og justerer ansigter eller kroppe, udtrækker rammer eller landemærker og klassificerer derefter rumlige og temporale funktioner. Tilsløring, kameravinkel, kompression, hudtone, briller, ansigtsforskelle og bevidste udtryk kan ændre ydeevnen. Ansigts‑aktionsenheder beskriver bevægelse mere direkte end en påstået følelse og kan være det sikrere mål.
Audio‑pipelines adskiller tale, normaliserer niveauet og modellerer spektrale, prosodiske og temporale mønstre. En hævet tonehøjde kan indikere begejstring, stress, et spørgsmål eller talerens vane. Tekst‑pipelines indfanger udtrykt evaluering og kontekst, men mister tone, medmindre de kombineres med lyd. Multimodal fusion kan forekomme på funktions‑, beslutnings‑ eller kryds‑opmærksomhedslag.
Personalisering kan kalibrere til en enkeltpersons baseline, men det kræver mere data og skaber en sensitiv langsigtet profil. Systemer bør foretrække lokal eller kortvarig tilpasning, hvor det er muligt, og skal undgå at bruge én persons data til at lave urelaterede inferenser uden et gyldigt formål.
Evaluering, menneskelige faktorer og sikkerhedsforanstaltninger
Tilfældig opdeling af rammer fra den samme video mellem træning og test skaber lækage. Hold personer, sessioner, enheder, steder og tidsperioder tilbage i henhold til den tiltænkte påstand. Rapporter makro‑metrikker, så almindelige klasser ikke skjuler fejl på sjældne tilstande, og inkluder en afholdelses‑option for tvetydig input.
Brugerundersøgelser bør måle, om tilpasning faktisk hjælper. En grænseflade, der ændrer tone baseret på en forkert inferens, kan føles påtrængende eller nedladende. Lad brugerne rette systemet, vælge graden af tilpasning og se den funktionelle grund til et svar uden at blive tildelt en definitiv følelsesmæssig etiket.
Høj‑risiko implementering kræver en konsekvensvurdering, juridisk gennemgang, sikkerhed og et forbud mod sekundære anvendelser. Gem rå video eller biometrik kun når nødvendigt, begræns adgang og definer sletning. Brug ikke følelsesscorer som eneste bevis for bedrag, præstation, kompetence, intention eller mental sundhed.
Evaluering af en emotion‑AI‑use case før implementering
Start med at definere den påståede konstruktion: ansigtsbevægelser, vokal prosodi, selvrapporteret følelse, observeret adfærd eller en klinisk tilstand er ikke udskiftelige. Identificér den beslutning, der vil bruge outputtet, og om et mindre påtrængende signal kan tjene den. Et system, der tilpasser spillets sværhedsgrad til eksplicit frustration‑feedback, har en anden evidens‑ og risikoprofil end et, der infererer medarbejderens ærlighed fra et webcam.
Validering kræver repræsentative personer, kulturer, sprog, enheder, kontekster og optagelsesforhold, med en sandhedsværdi passende til påstanden. Sammenlign med simple baselines og rapportér usikkerhed, undergruppefejl, inter‑rater uenighed og ydeevne uden for laboratoriet. Konverter ikke en probabilistisk score til en kategorisk erklæring om, hvad en person føler. Giv brugerne mulighed for korrektion, fravalg og en ikke‑biometrisk vej, hvor det er muligt.
Forbyd konsekvensfulde beslutninger, der udelukkende baseres på infereret følelse, især inden for ansættelse, uddannelse, forsikring, politiarbejde, sundhedspleje og adgang til tjenester. Minimér opbevaring af rå lyd og video, isolér biometriske identifikatorer og kontroller sekundær brug. Dokumentationen bør forklare træningskontekst, tiltænkt brug, ugyldige anvendelser og kendte forstyrrende faktorer såsom handicap, maskering, stress, kultur eller medicin. Emotion AI er et målekrav, der kræver beviser, ikke et magisk vindue ind i den indre oplevelse.
Praktisk implementerings‑tjekliste
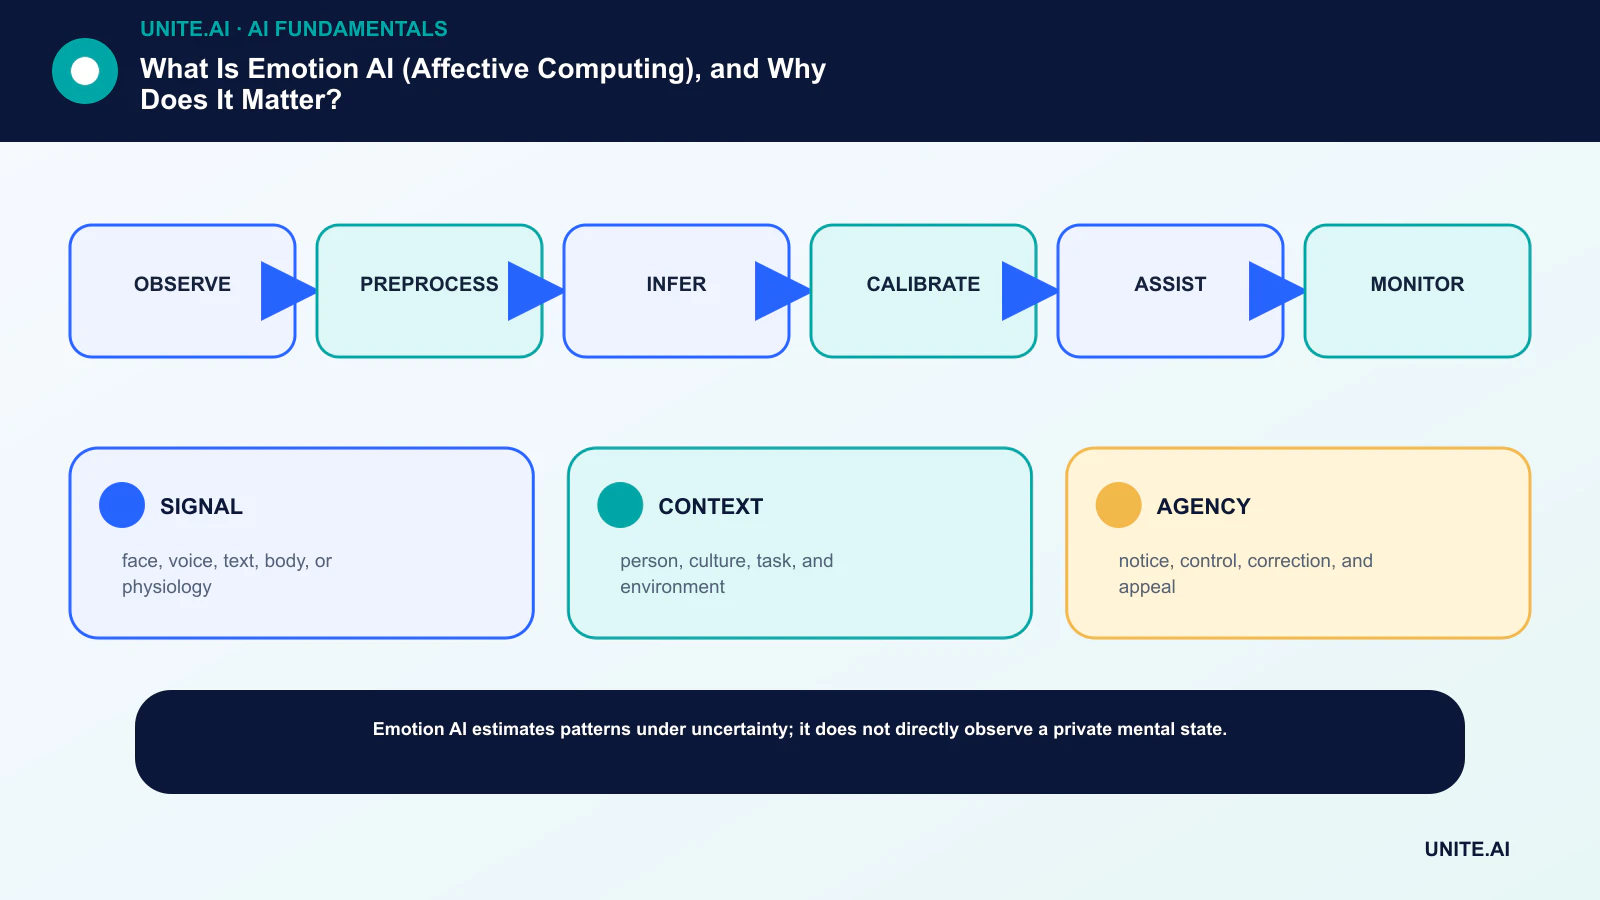
Omform konceptet til en afgrænset, testbar arbejdsproces: observer → forbehandle → inferer → kalibrer → assister → monitorér. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér monitorering, rollback og gennemgang, før omfanget udvides. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsebetingelser, afhængighedsfejl og misbrug; bevar beviserne og de uafklarede risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, fordi en teknisk vellykket pilot ikke garanterer pålidelig ydeevne i større skala.
- SIGNAL: ansigt, stemme, tekst, krop eller fysiologi.
- KONTEKST: person, kultur, opgave og miljø.
- AGENCY: meddelelse, kontrol, korrektion og appel.
Ofte stillede spørgsmål
Kan AI læse følelser fra et ansigt præcist?
Den kan forudsige datasæt‑etiketter ud fra ansigtsbevægelser, men disse bevægelser bestemmer ikke entydigt en indre følelse. Nøjagtigheden afhænger stærkt af kontekst, population, etiketter og måledesign.
Er emotion AI lovligt?
Det afhænger af brugen, data, personer og jurisdiktion. Nogle kontekster er forbudte eller højrisiko. Organisationer har brug for aktuel juridisk rådgivning, ikke en generisk teknisk tjekliste.
Primære referencer