
Grundlæggende AI
Hvad er visuelle sprogmodeller (VLM’er)? Sådan forbinder AI billeder og ord
Vision-language-modeller forbinder visuelle egenskaber med sprog, så et system kan beskrive, sammenligne, hente eller ræsonnere om billeder ved hjælp af ord. Denne guide forklarer mekanismen, afvejningerne, evalueringen og de kontrolforanstaltninger, der er vigtige i praksis.

 Føj Unite.AI til dine foretrukne kilder på Google
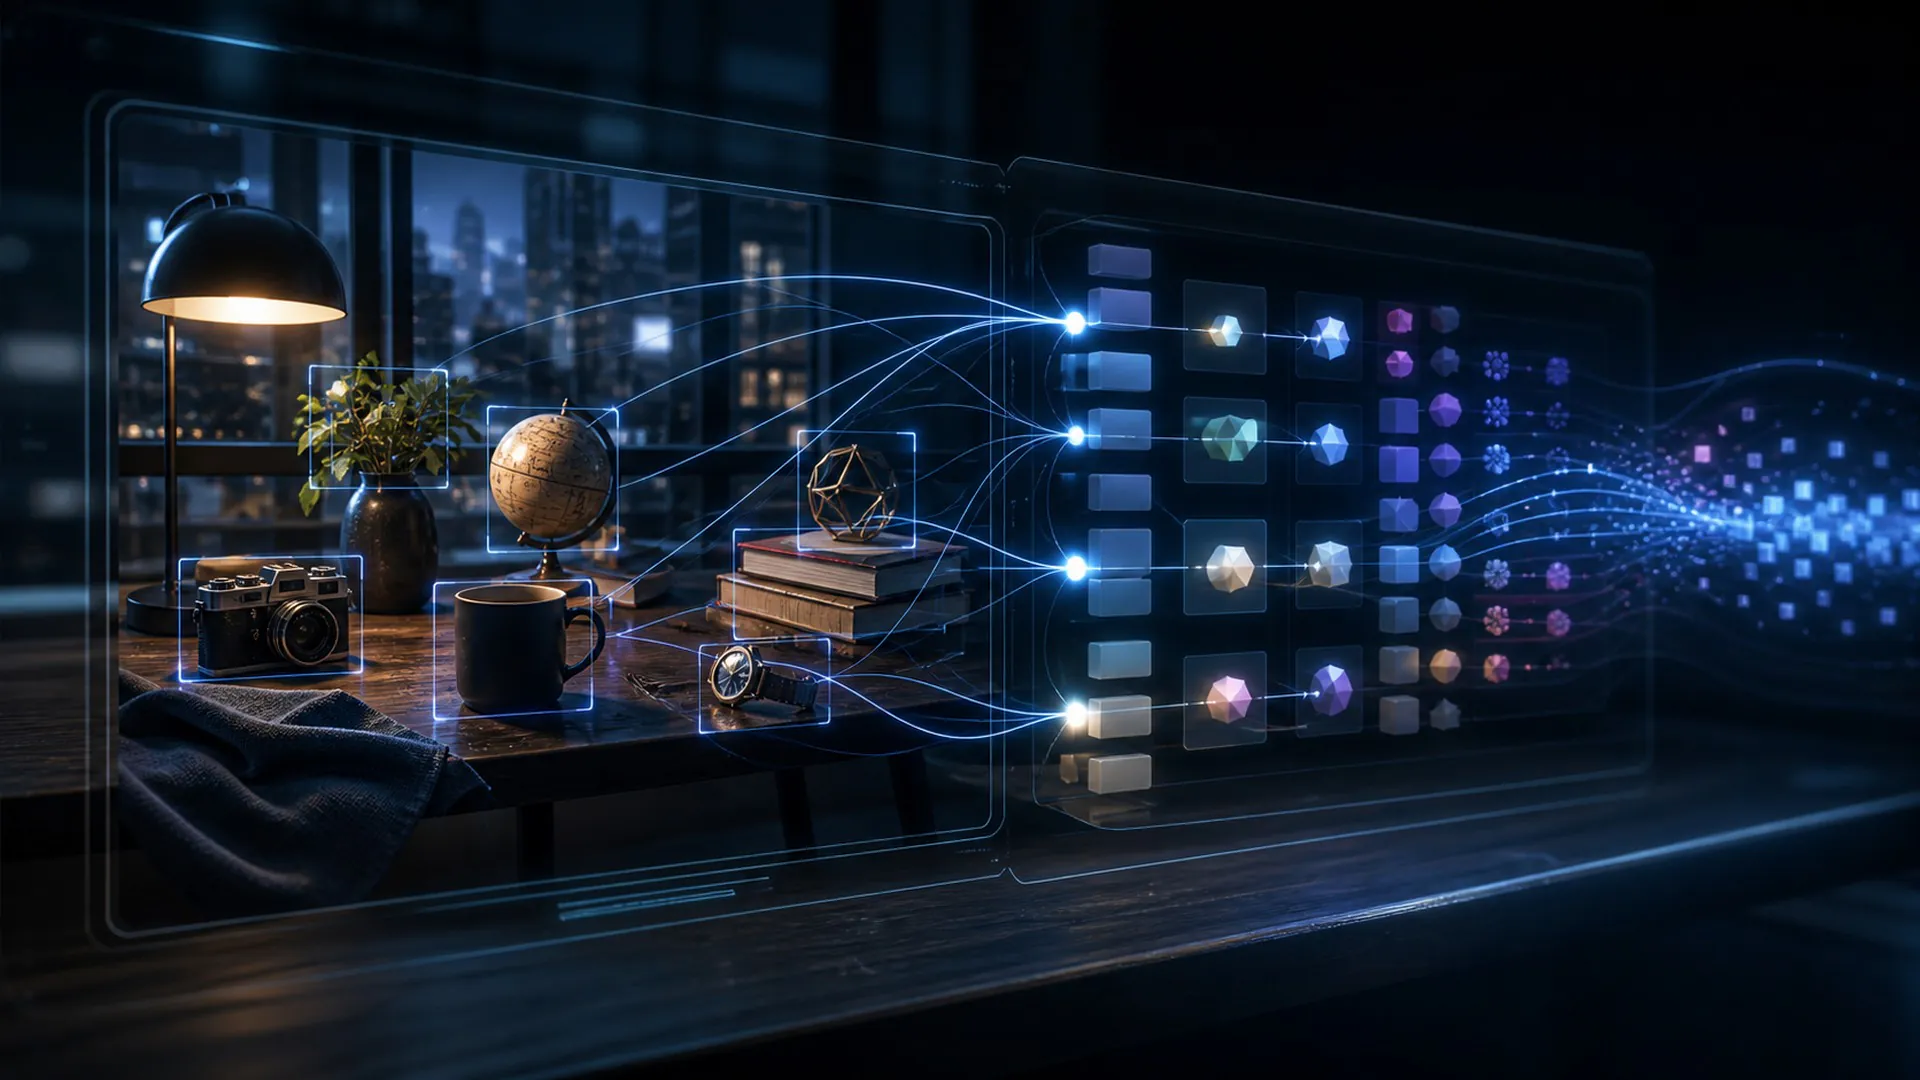
Visuelle sprogmodeller forbinder visuelle træk med sprog, så et system kan beskrive, sammenligne, hente oplysninger om eller ræsonnere om billeder ved hjælp af ord.
Visuelle sprogmodeller fortjener en præcis forklaring, fordi betegnelsen peger på et bestemt informationsflow, et bestemt valg af træningsmetode, en bestemt mekanisme under kørsel eller en bestemt grænse for styring og ansvar. Hvis man behandler den som et synonym for »avanceret AI«, bliver påstande umulige at efterprøve. Denne guide følger begrebet fra input og forudsætninger til det observerbare resultat og undersøger derefter den genvej, der lettest forveksles med det.
Visuelle sprogmodeller: definition, afgrænsning og formål
Visuelle sprogmodeller forbinder visuelle træk med sprog, så et system kan beskrive, sammenligne, hente oplysninger om eller ræsonnere om billeder ved hjælp af ord. Definitionen indebærer tre praktiske forpligtelser: Der skal være et identificerbart input, en transformation eller beslutning, der er karakteristisk for visuelle sprogmodeller, og et resultat, der kan evalueres i forhold til et angivet mål. Mangler et af disse elementer, beskriver betegnelsen måske en ambition snarere end en implementeret mekanisme.
Multimodale systemer skal tilpasse signaler med forskellig opløsning, timing, støj og tvetydighed til hinanden. Et ord kan henvise til et lille område af et billede, og en lydhændelse kan indtræffe før det videobillede, der forklarer den. For visuelle sprogmodeller er dette systemperspektiv vigtigt, fordi ydeevnen kan afhænge af de omgivende data, grænseflader, hardware, tilladelser og mennesker, selv når den underliggende model er uændret. En nyttig forklaring skelner derfor mellem modellens indlærte adfærd og det produkt, der afgør, hvornår, hvor og med hvilken myndighed denne adfærd anvendes.
Den nærmeste vildledende genvej er computervision, der forudsiger en fast etiket uden åbent sprog. Den kan have et synligt træk til fælles med visuelle sprogmodeller, men ændrer årsagssammenhængen: Det kræver andre beviser at fastslå, om den lykkes, andre ressourcer vil dominere omkostningerne, og andre kontroller vil forhindre skade. Afgrænsningen handler derfor om funktion i praksis, ikke om terminologi.
En driftsmodel i fem trin for visuelle sprogmodeller
Diagrammet er et kompakt årsagskort over visuelle sprogmodeller, ikke en påstand om, at alle implementeringer består af fem softwarekomponenter. Nogle systemer kombinerer trin, mens andre gentager dem i en løkke. Kortet er stadig nyttigt, fordi det kræver, at hver ændring i information eller myndighed har en ansvarlig, et input, et output og en test.
1. Opdel eller kod billedet til visuelle tokens: Input og forudsætninger i visuelle sprogmodeller
På dette trin i visuelle sprogmodeller skal systemet opdele eller kode billedet til visuelle tokens. Det nyttige spørgsmål er ikke blot, om denne operation finder sted, men også hvilke oplysninger den bruger, hvilken tilstand den ændrer, og hvilke beviser der viser, at ændringen var gyldig. En kontrollant bør kunne skelne operationen fra computervision, der forudsiger en fast etiket uden åbent sprog, og genskabe resultatet under de samme angivne betingelser.
Overdragelsen til dette trin i visuelle sprogmodeller begynder med det angivne mål og bør ende med et resultat, der kan danne grundlag for kodning af den tilhørende tekst. Registrér usikkerhed, fravalgte alternativer, ressourceforbrug og enhver menneskelig eller softwarebaseret kontrol ved grænsefladen. Det er i dette spor, teams kan opdage, om flydende beskrivelser kan nævne objekter eller relationer, der faktisk ikke er synlige, før den samme svaghed fører til et betydningsfuldt resultat.
2. Kod den tilhørende tekst: Repræsentation eller beslutning i visuelle sprogmodeller
På dette trin i visuelle sprogmodeller skal systemet kode den tilhørende tekst. Det nyttige spørgsmål er ikke blot, om denne operation finder sted, men også hvilke oplysninger den bruger, hvilken tilstand den ændrer, og hvilke beviser der viser, at ændringen var gyldig. En kontrollant bør kunne skelne operationen fra computervision, der forudsiger en fast etiket uden åbent sprog, og genskabe resultatet under de samme angivne betingelser.
Overgangen til dette trin i vision-language-modeller begynder med at opdele eller indkode billedet som visuelle tokens og bør ende med et resultat, der kan bruges til at forbinde de to repræsentationer. Registrér usikkerhed, fravalgte alternativer, ressourceforbrug og enhver menneskelig eller softwaremæssig kontrol, der anvendes ved denne grænse. Det er ved at følge dette forløb, at teams kan opdage, om flydende beskrivelser nævner objekter eller relationer, der faktisk ikke er synlige, før den samme svaghed påvirker et resultat med alvorlige konsekvenser.
3. Forbind de to repræsentationer: Den karakteristiske transformation i vision-language-modeller
På dette trin i vision-language-modeller skal systemet forbinde de to repræsentationer. Det nyttige spørgsmål er ikke blot, om denne operation finder sted, men også hvilke oplysninger den bruger, hvilken tilstand den ændrer, og hvilke belæg der viser, at ændringen var gyldig. En reviewer bør kunne skelne operationen fra computervision, der forudsiger en fast etiket uden åbent sprog, og kunne genskabe resultatet under de samme angivne betingelser.
Overgangen til dette trin i vision-language-modeller begynder med at indkode den tilhørende tekst og bør ende med et resultat, der kan bruges til at rette opmærksomheden mod områder og fraser. Registrér usikkerhed, fravalgte alternativer, ressourceforbrug og enhver menneskelig eller softwaremæssig kontrol, der anvendes ved denne grænse. Det er ved at følge dette forløb, at teams kan opdage, om flydende beskrivelser nævner objekter eller relationer, der faktisk ikke er synlige, før den samme svaghed påvirker et resultat med alvorlige konsekvenser.
4. Ret opmærksomheden mod områder og fraser: Begrænsning og verifikationsgrænse i vision-language-modeller
På dette trin i vision-language-modeller skal systemet rette opmærksomheden mod områder og fraser. Det nyttige spørgsmål er ikke blot, om denne operation finder sted, men også hvilke oplysninger den bruger, hvilken tilstand den ændrer, og hvilke belæg der viser, at ændringen var gyldig. En reviewer bør kunne skelne operationen fra computervision, der forudsiger en fast etiket uden åbent sprog, og kunne genskabe resultatet under de samme angivne betingelser.
Overgangen til dette trin i vision-language-modeller begynder med at forbinde de to repræsentationer og bør ende med et resultat, der kan bruges til at afkode et forankret svar eller en handling. Registrér usikkerhed, fravalgte alternativer, ressourceforbrug og enhver menneskelig eller softwaremæssig kontrol, der anvendes ved denne grænse. Det er ved at følge dette forløb, at teams kan opdage, om flydende beskrivelser nævner objekter eller relationer, der faktisk ikke er synlige, før den samme svaghed påvirker et resultat med alvorlige konsekvenser.
5. Afkod et forankret svar eller en handling: Output, feedback og stopregel i vision-language-modeller
På dette trin i vision-language-modeller skal systemet afkode et forankret svar eller en handling. Det nyttige spørgsmål er ikke blot, om denne operation finder sted, men også hvilke oplysninger den bruger, hvilken tilstand den ændrer, og hvilke belæg der viser, at ændringen var gyldig. En reviewer bør kunne skelne operationen fra computervision, der forudsiger en fast etiket uden åbent sprog, og kunne genskabe resultatet under de samme angivne betingelser.
Overgangen til dette trin i vision-language-modeller begynder med at rette opmærksomheden mod områder og fraser og bør ende med et resultat, der kan bruges til overvågning eller en endelig beslutning. Registrér usikkerhed, fravalgte alternativer, ressourceforbrug og enhver menneskelig eller softwaremæssig kontrol, der anvendes ved denne grænse. Det er ved at følge dette forløb, at teams kan opdage, om flydende beskrivelser nævner objekter eller relationer, der faktisk ikke er synlige, før den samme svaghed påvirker et resultat med alvorlige konsekvenser.
Læs kortet over vision-language-modeller fremad for at forstå produktionen og baglæns for at diagnosticere fejl. En fremadrettet analyse undersøger, hvordan hvert trin leverer input til det næste. En baglæns analyse tager udgangspunkt i et forkert, langsomt, dyrt eller usikkert resultat og sporer, hvilken tidligere antagelse der gjorde det muligt. Det er ofte den baglæns gennemgang, der afslører, at den afgørende fejl opstod, før modellen producerede noget som helst.
Et gennemarbejdet eksempel på vision-language-modeller
En VLM kan analysere et skærmbillede af et dashboard og forklare, hvilket diagram der understøtter en skriftlig påstand.
Dette eksempel er informativt, fordi vision-language-modeller kan vurderes ud fra observerbare input, mellemliggende tilstande og et resultat frem for gennem en poleret demonstration. En grundig test ville opstille almindelige, vanskelige og bevidst vildledende tilfælde inden for dette scenarie, bevare en baseline uden teknikken og registrere både den gennemsnitlige ydeevne og alvoren af de enkelte fejl.
Ændr én antagelse i eksemplet med vision-language-modeller, og gentag analysen. Fjern et nødvendigt input, indfør et modstridende signal, begræns beregningskapaciteten, ændr brugergruppen, eller tving systemet til at afstå fra at svare. En mekanisme, der kun lykkes i én nøje tilrettelagt demonstration, har ikke vist, at den kan generaliseres til driftsmiljøet.
Vision-language-modeller over for den mest almindelige genvej
Vision-language-modeller reduceres ofte til computervision, der forudsiger en fast etiket uden åbent sprog. Denne reduktion fjerner netop den grænse, der definerer begrebet. Det kan få købere til at sammenligne produkter, der ikke er sammenlignelige, forskere til at overdrive, hvad et eksperiment viser, og operatører til at overvåge det forkerte signal efter implementeringen.
| Vinkel | Praktisk svar |
|---|---|
| Definition | Syns- og sprogmodeller forbinder visuelle træk med sprog, så et system kan beskrive, sammenligne og hente billeder eller ræsonnere om dem ved hjælp af ord. |
| Misforståelse | computersyn, der forudsiger en fast etiket uden åbent sprog. |
| Risiko | Flydende beskrivelser kan nævne objekter eller relationer, som faktisk ikke er synlige. |
Sammenligningen bør også angive analyseenheden. En artikel om syns- og sprogmodeller kan fokusere på en model eller algoritme, mens en tjeneste i drift også omfatter informationssøgning, dirigering, caching, politikker, identitet, brugergrænseflader og overvågning. To produkter kan bruge den samme overordnede betegnelse, men implementere forskellige dele af denne stak. Spørg, hvilken komponent der udfører den definerende transformation, og hvilke andre komponenter der er nødvendige for det rapporterede resultat.
Hvorfor syns- og sprogmodeller er vigtige i nutidens AI-systemer
Syns- og sprogmodeller er vigtige nu, fordi AI-systemer får større kontekster, flere modaliteter, mere beregningskraft under afvikling, bredere adgang til værktøjer og tættere forbindelser til organisatoriske beslutninger. Under sådanne forhold kan det, der tidligere virkede som en forskningsdetalje, få betydning for svartid, sikkerhed, tilgængelighed, miljøomkostninger, produktkvalitet eller juridisk ansvar.
Det relevante mål er ikke, om syns- og sprogmodeller kan levere ét imponerende resultat. Spørgsmålet er, om teknikken forbedrer et vigtigt resultat under repræsentative forhold og gør det mere effektivt end en enklere baseline. Rapportér fordelinger, fejlkategorier, latenstid i den langsomme ende, ressourceforbrug og berørte undergrupper i stedet for at sammenfatte alle resultater i ét gennemsnit.
Evalueringen bør isolere hver modalitet, teste modstridende input og kontrollere, om modellen er forankret i tid eller rum. Et flydende svar på tværs af modaliteter er ikke bevis for, at modellen rettede opmærksomheden mod det rigtige signal. Når denne disciplin anvendes specifikt på syns- og sprogmodeller, bliver dokumentationen overførbar: Et andet team kan vurdere, om den påståede forbedring sandsynligvis holder med en anden model, et andet sprog, en anden hardwareplatform, et andet datasæt, en anden brugergruppe eller en anden risikotolerance.
Fordele ved syns- og sprogmodeller
Den stærkeste grund til at bruge syns- og sprogmodeller er, at de kan afhjælpe den tilsigtede flaskehals direkte. Afhængigt af implementeringen kan fordelen vise sig som bedre forankring, en mere troværdig repræsentation, bedre generalisering, lavere latenstid, mindre flytning af data i hukommelsen, tydeligere ansvarsplacering eller en sikrere grænse mellem et modeloplæg og en faktisk handling.
Fordele bør beskrives som beslutninger og målinger. »Mere intelligent« er ikke et acceptkriterium for syns- og sprogmodeller. Et brugbart mål kan for eksempel angive fejlprocenten i vanskelige tilfælde, genopretning efter modstridende evidens, omkostninger ved en bestemt trafikpercentil, tid til menneskelig kontrol, kalibrering eller procentdelen af handlinger, der holdes inden for en fastlagt myndighedsgrænse.
Fejltilstanden, der definerer syns- og sprogmodeller
Den centrale begrænsning er, at flydende beskrivelser kan nævne objekter eller relationer, som faktisk ikke er synlige. Denne fejl er ikke noget, man først bør føje til listen, når udviklingen er afsluttet. Den bør fra begyndelsen præge dataindsamling, arkitektur, tilladelser, evaluering, frigivelseskriterier og overvågning af syns- og sprogmodeller.
En kontrolforanstaltning for vision-language-modeller er kun nyttig, hvis den griber ind, før der indtræffer en omkostningsfuld eller irreversibel konsekvens. Identificér det tidligste observerbare tegn på fejlen, fastsæt en tærskel eller regel, udpeg en ansvarlig ejer, og afprøv genopretningen. Afhængigt af anvendelsen kan genopretning betyde, at systemet afstår fra at svare, skifter til et enklere system, indhenter yderligere evidens, eskalerer sagen til en person, ruller en model tilbage eller helt standser en handling.
En evalueringsplan for vision-language-modeller
Begynd evalueringen af vision-language-modeller med at formulere den beslutning, som evidensen skal understøtte. Fastlæg målgruppen for anvendelsen, konsekvensen af et forkert resultat, hvilke oplysninger der faktisk er tilgængelige på beslutningstidspunktet, og det enkleste troværdige alternativ. Det forhindrer, at et benchmark bliver målet i sig selv, blot fordi det er nemt at gennemføre.
Brug et uberørt testsæt til kontrollerede sammenligninger, og validér derefter vision-language-modeller i et trinvist driftsmiljø. Offlineevaluering gør varianterne sammenlignelige; skyggetilstand, canary-udrulninger, hastighedsbegrænsninger eller godkendelsesporte viser, hvordan virkelig trafik, feedbacksløjfer og mennesker ændrer adfærden. Udrulningsfasen bør have en udtrykkelig betingelse for at stoppe, i stedet for at antage, at enhver forbedring fortjener en fuld udrulning.
Versionsstyr de input, der skal til for at reproducere vision-language-modeller: kildedata, forbehandling, tokenizer eller encoder, modelvægte, konfiguration, prompt eller politik, søgeindeks, evalueringssæt, hardwareforudsætninger og kode til betjening af modellen, alt efter hvad der er relevant. Uden sporbarhed kan et team ikke afgøre, om et ændret resultat skyldes metoden, miljøet eller en ubemærket ændring i datapipelinen.
Spørg til sidst, hvilke resultater der ville modbevise påstanden om, at vision-language-modeller er nyttige. Hvis intet resultat kunne ændre beslutningen om at indføre dem, er evalueringen markedsføring. Forhåndsfastsatte accepttærskler og et bevaret bekræftelsessæt gør evalueringen til evidens.
Spørgsmål, du bør stille, før du indfører vision-language-modeller
- Mål: Hvilken målbar flaskehals skal vision-language-modeller løse?
- Mekanisme: Hvilket af de fem trin indeholder den særlige transformation?
- Udgangspunkt: Hvordan klarer modellen sig sammenlignet med computer vision, der forudsiger en fast etiket uden åbent sprog, eller med et andet enklere alternativ?
- Evidens: Hvilke almindelige, vanskelige og adversarielle tilfælde samt tilfælde fra undergrupper blev testet?
- Drift: Hvilke omkostninger til latenstid, hukommelse, computerkraft, energi, vedligeholdelse og gennemgang opstår i stor skala?
- Risiko: Hvordan vil teamet opdage, at flydende beskrivelser kan nævne objekter eller relationer, som faktisk ikke er synlige?
- Genopretning: Kan systemet afstå fra at svare, skifte til en alternativ løsning, rulle tilbage eller eskalere sagen, før der sker skade?
Primære kilder til studiet af vision-language-modeller
Autoritative udgangspunkter for den del af AI-stakken, der omgiver vision-language-modeller, omfatter CLIP-forskningsartiklen og den kropsliggjorte multimodale PaLM-E-model. Læs dem sammen med dokumentationen for den præcise model, det konkrete datasæt, hardwaren og den relevante jurisdiktion. En generel kilde kan beskrive mekanismen, men kun evidens fra den konkrete udrulning kan fastslå, om en bestemt implementering er egnet.
Det vigtigste at huske om vision-language-modeller
Vision-language-modeller er en afgrænset mekanisme i et større socioteknisk system. Deres værdi ligger i at forbedre et specifikt resultat under udtrykkeligt angivne betingelser, ikke i selve betegnelsen. Modellen med fem trin synliggør informationsstrømmen, sammenligningen viser, hvad den ikke er, og kontrolforløbet viser, hvor en ansvarlig operatør kan gribe ind.
Den praktiske regel for vision-language-modeller er at fastlægge målet, sammenligne med et troværdigt udgangspunkt, teste den vigtigste fejltype og bevare den evidens, der er nødvendig for at overvåge ændringer. Når disse elementer er på plads, bliver konceptet til et teknisk og styringsmæssigt valg, der kan evalueres. Uden dem er det blot et lovende navn knyttet til en ukendt driftsrisiko.


